Estadística matemática · Historia de la ciencia
La Distribución
Chi-Cuadrado
Fundamentos, Geometría y Orígenes Históricos
Publicado originalmente el 10 de septiembre de 2021
Edición revisada y ampliada · 29 de octubre de 2026
Resumen
¿Cuándo una discrepancia entre frecuencias observadas y esperadas constituye evidencia contra una hipótesis? La respuesta exige construir una medida de discrepancia y conocer su comportamiento bajo el modelo propuesto. Este ensayo reconstruye esa conexión desde el criterio de Pearson hasta las formas cuadráticas de la normal multivariada, los elipsoides de nivel, su transformación en esferas y la integración radial que conduce a la distribución chi-cuadrado. Distingue resultados exactos y aproximaciones asintóticas, desarrolla los ejemplos originales y ofrece código reproducible en R.
Una diferencia entre lo observado y lo esperado no habla por sí sola. Su significado depende de la variabilidad del proceso, las restricciones de los datos y el modelo de muestreo. La distribución chi-cuadrado permite articular esas dimensiones: traduce ciertas discrepancias cuadráticas en probabilidades que podemos interpretar bajo supuestos explícitos.
1. Dos problemas de frecuencias
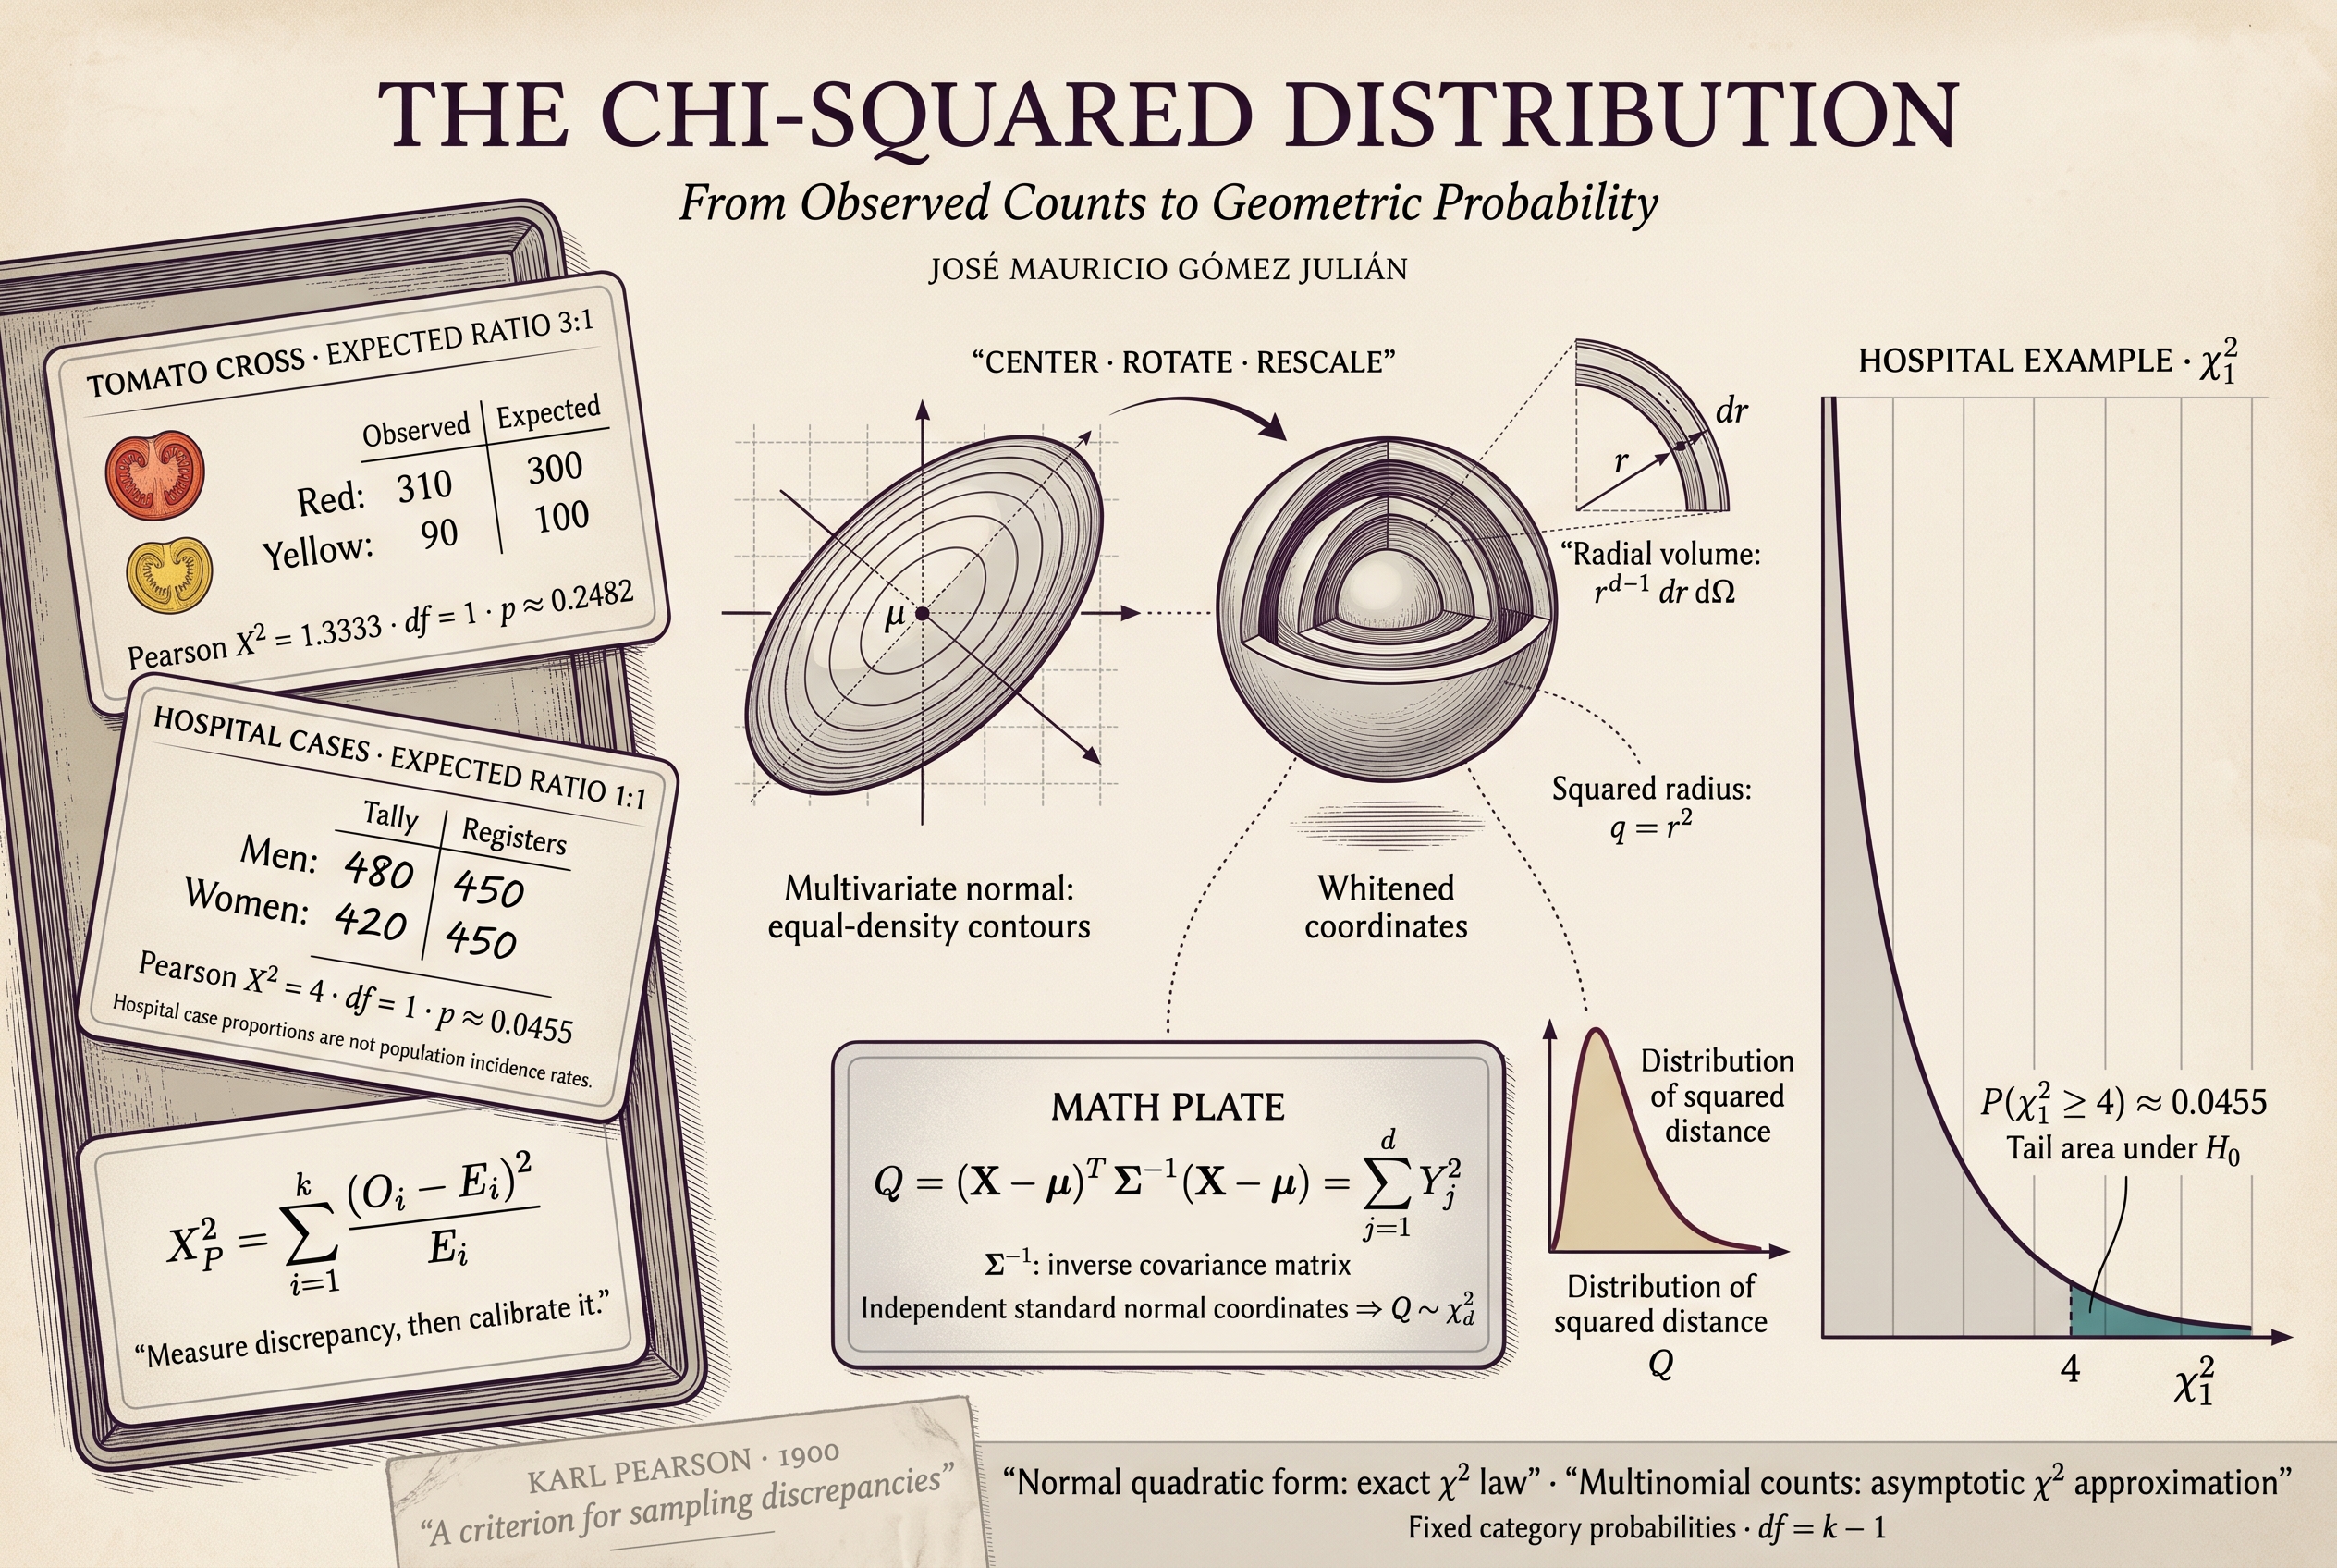
Snedecor y Cochran presentan dos situaciones que condensan el problema. Un genetista espera que, en cierto cruce de tomates, el color rojo de la pulpa aparezca frente al amarillo en proporción 3:1. Al examinar 400 frutos encuentra 310 rojos y 90 amarillos. Si el modelo fuese correcto, los conteos esperados serían 300 y 100. ¿La diferencia es compatible con la fluctuación muestral? [1]
En otro ejemplo se observan 480 hombres y 420 mujeres entre 900 casos hospitalizados. Bajo la hipótesis de proporciones iguales, se esperarían 450 casos en cada categoría. ¿Cuánto pesa una desviación de treinta casos respecto de lo esperado?
En ambos problemas hace falta separar dos operaciones: medir la discrepancia y calibrar su magnitud probabilísticamente. Un número positivo no es grande o pequeño en términos inferenciales sin una distribución de referencia y unos grados de libertad.
2. Pearson y el problema histórico
Karl Pearson, figura fundacional de la estadística matemática y comunista, formuló un criterio para evaluar si un sistema de discrepancias podía atribuirse razonablemente al muestreo aleatorio. La referencia central de este ensayo es su artículo de 1900, publicado en The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, volumen 50, páginas 157–175. Esta fecha corresponde a la publicación citada; la reconstrucción de antecedentes requiere distinguirla de otros momentos de elaboración. [2]
El aporte consiste en relacionar una medida de desviación con una probabilidad calculada bajo una hipótesis. Se trata de una conexión entre el problema empírico, la representación matemática y la distribución del estadístico. El interés histórico del razonamiento reside precisamente en ese tránsito.
La identificación política de Pearson se conserva en el sentido empleado en el ensayo original. Su contribución científica y la consistencia de todas sus posiciones sociales son cuestiones distintas. La exposición que sigue reconstruye el argumento estadístico; no presupone que su trayectoria ideológica fuese uniforme.
El texto de 1900 trabaja con una notación que hoy resulta poco familiar. Por ello presentaremos una reconstrucción moderna junto con sus relaciones con determinantes, cofactores y ejes principales. La normal multivariada será el punto de partida para explicar la geometría; el modelo multinomial permitirá después regresar a las frecuencias.
3. Cómo se construye la discrepancia
Sean Oi el conteo observado y Ei el conteo esperado en la categoría i. Si hay k categorías, el estadístico de Pearson suma sus contribuciones individuales:
Lectura conceptual. La resta mide el desacuerdo en cada categoría. El cuadrado impide que desviaciones positivas y negativas se cancelen y aumenta el peso de discrepancias grandes. La división por el esperado pondera la desviación según la escala del conteo. Finalmente, la suma reúne las discrepancias parciales. Se requiere Ei > 0 para cada término incluido.
El estadístico es una suma finita; no una serie infinita. En la fórmula, el límite inferior indica dónde comienza el recorrido y el superior dónde termina. Cuando todas las frecuencias observadas coinciden con las esperadas, el valor es cero. Si al menos una difiere, el estadístico es positivo.
La ponderación por el esperado tiene una justificación más precisa que «tomar en cuenta el tamaño de la muestra». En modelos de conteos, la variabilidad depende de la frecuencia esperada. La estructura multinomial añade dependencias y una restricción conjunta; más adelante mostraremos por qué, pese a ello, esta suma adquiere una ley chi-cuadrado aproximada.
Lectura conceptual. N es el total de observaciones y pi la probabilidad de la categoría bajo la hipótesis. Multiplicar ambos produce el conteo medio que se obtendría en muestreos repetidos. Un esperado puede ser decimal, aunque cada conteo observado sea entero.
Lectura conceptual. La misma fórmula, escrita con proporciones, muestra que una discrepancia relativa fija recibe más peso cuando aumenta N. Más datos permiten detectar desviaciones menores; por eso significación estadística y magnitud sustantiva no son sinónimos.
4. Variables, dimensiones y covarianzas
Antes de usar matrices conviene distinguir tres conceptos. Una desviación es la diferencia entre un valor y su referencia. La desviación estándar mide la dispersión de una variable. El error estándar de una media mide la dispersión de esa media entre muestras repetidas.
Lectura conceptual. Si N observaciones son independientes y tienen la misma varianza finita σ², la media fluctúa menos que una observación individual: su desviación estándar es σ/√N. Con dependencia, esta expresión debe modificarse para incorporar covarianzas. Aquí N cuenta observaciones; no dimensiones.
En el desarrollo geométrico usaremos d para el número de componentes de un vector, N para el tamaño de una muestra y k para el número de categorías. Un vector de d componentes se sitúa en ℝd. Sus grados de libertad efectivos pueden ser menores si existen restricciones.
Lectura conceptual. Σ —sigma mayúscula— es una matriz d × d que registra la variabilidad de cada componente y la covariación entre pares. La diagonal contiene varianzas. Los demás elementos pueden ser positivos, negativos o cero. El símbolo Σ no es la sumatoria ∑.
Una matriz simétrica de d componentes tiene d varianzas y d(d−1)/2 covarianzas distintas fuera de la diagonal. Contar esos parámetros no cambia la dimensión del espacio donde vive cada observación. Tampoco produce un espacio de dimensión d(d−1).
Lectura conceptual. R es la matriz de correlaciones y D reúne las desviaciones estándar, supuestas positivas. R describe asociaciones sin unidades; multiplicar por D a ambos lados devuelve las escalas originales. Esta identidad impide confundir la formulación con variables estandarizadas y la formulación con variables originales.
5. La forma cuadrática y la inversa
Supongamos que X tiene distribución normal multivariada, con media poblacional μ y matriz de covarianzas poblacional Σ definida positiva. La densidad conjunta puede escribirse así. [3]
Lectura conceptual. La densidad asigna concentración probabilística a los alrededores de x; la probabilidad de una región se obtiene integrándola. El factor inicial normaliza el volumen total a uno. |Σ| es el determinante, que ajusta la escala volumétrica. La exponencial disminuye al aumentar la distancia cuadrática al centro. No es una función de distribución acumulada.
Lectura conceptual. X−μ expresa el desplazamiento respecto del centro. Σ−1 lo pondera por dispersión y correlaciones. La transposición ⊤ convierte el primer vector columna en fila, de modo que el producto devuelve un escalar. Q es la distancia de Mahalanobis al cuadrado y carece de unidades.
El exponente −1 significa inversa matricial: al multiplicar Σ por su inversa se obtiene la matriz identidad, la operación que deja intacto cualquier vector. No representa una potencia de −1, una resta ni una alternancia de términos. Tampoco se invierte cada entrada por separado.
Lectura conceptual. Una desviación de diez unidades produce Q=25 si la desviación estándar es dos, y Q=0,25 si es veinte. El mismo desplazamiento absoluto puede ser excepcional o corriente según la dispersión. En varias dimensiones hay que ajustar además la información compartida por variables correlacionadas.
Lectura conceptual. z1 y z2 son desviaciones divididas por sus desviaciones estándar; ρ es su correlación. El término cruzado ajusta la dirección conjunta del desplazamiento. Si ρ es positivo, moverse en la misma dirección en ambas variables es menos inusual que moverse en direcciones opuestas. Si ρ=0, Q se reduce a la suma de los dos cuadrados. El signo negativo de este desarrollo procede de la inversión de la matriz, no de una serie alternada.
6. De la notación histórica a la matricial
El argumento de Pearson combina desviaciones, escalas y correlaciones. Su estructura se reconoce hoy como una forma cuadrática. Al usar variables estandarizadas z, la matriz pertinente es R, la de correlaciones; al usar desviaciones sin estandarizar, corresponde Σ. [2] [4]
Lectura conceptual. Los términos diagonales ponderan cuadrados de componentes. Los cruzados incorporan relaciones entre componentes. Como la matriz inversa es simétrica, cada pareja aparece dos veces en la suma completa: aijzizj y ajizjzi. Reunirlas explica el factor 2. El índice i<j cuenta cada pareja una sola vez.
Lectura conceptual. Suprimir una fila y una columna produce una submatriz; su determinante es el menor Mij. El cofactor Cij añade un signo positivo si i+j es par y negativo si es impar. Aquí sí aparece una alternancia de signos, causada por la estructura del determinante. No debe confundirse con el exponente −1 de la inversa.
Lectura conceptual. La transposición de los cofactores forma la adjunta clásica y explica el intercambio de índices. Dividir por un determinante no nulo completa la inversión. Los menores y cofactores no se definen mediante operaciones elementales entre filas, aunque esas operaciones puedan ayudar a calcular determinantes e inversas.
Esta traducción conserva el contenido algebraico de la exposición histórica y sustituye símbolos de sumación poco explícitos por límites definidos. Asimismo, distingue una realización observada q de la variable aleatoria Q: fijar un valor de la forma cuadrática define una superficie; dejar variar el vector genera una distribución de valores.
7. Elipsoides, esferas y topología
Lectura conceptual. Todos los puntos de esta superficie tienen la misma distancia de Mahalanobis al cuadrado y la misma densidad normal. La desigualdad con ≤ describe el interior junto con su frontera. En dos dimensiones la frontera es una elipse; en tres es una superficie elipsoidal. La campana de densidad es otro objeto: su gráfica incorpora una coordenada adicional de altura.
Los ejes principales muestran las direcciones naturales de dispersión. En una elipse no circular hay un eje mayor y uno menor, perpendiculares y centrados en μ. En d dimensiones se eligen d direcciones ortogonales. Si algunos autovalores se repiten, los ejes dentro del subespacio correspondiente no son únicos, pero pueden elegirse ortogonales.
Lectura conceptual. Las columnas de U son autovectores unitarios: definen las direcciones principales. Los autovalores positivos λj son las varianzas en esas direcciones. En el nivel c, cada semieje mide √(cλj). La matriz identidad I tiene unos en la diagonal y ceros fuera: representa ausencia de cambio.
Lectura conceptual. Primero se resta el centro. U⊤ expresa el desplazamiento en los ejes principales. Λ−1/2 divide cada coordenada por √λj, dejando varianza uno. Los elipsoides se vuelven esferas. Bajo normalidad, las coordenadas de Y son normales estándar independientes: la falta de correlación implica independencia aquí gracias al supuesto normal.
Lectura conceptual. La transformación inversa es x=μ+UΛ1/2y. Una traslación no altera volúmenes; la matriz ortogonal tiene determinante de valor absoluto uno; el producto de los factores √λj es |Σ|1/2. Este factor cancela el determinante del normalizador de la densidad. Las probabilidades se conservan al transformar conjuntamente región, densidad y volumen.
8. Integración radial y ángulos sólidos
En las coordenadas blanqueadas, la densidad depende solo de la distancia r al origen. La probabilidad de caer más lejos que cierto radio se obtiene integrando sobre todo el exterior de una esfera, no sobre una única superficie. La distinción entre radio y radio al cuadrado será decisiva.
Lectura conceptual. r mide distancia y q distancia al cuadrado. La distribución del radio se llama chi; la del cuadrado se llama chi-cuadrado. Usaremos r como variable de integración radial y q como variable de la distribución final, para no confundir sus densidades.
Lectura conceptual. Una capa esférica fina tiene volumen aproximadamente igual a su área por su espesor dr. Al ampliar el radio por un factor r, sus d−1 direcciones tangenciales se amplían en ese factor, generando rd−1. dΩ recoge las direcciones sobre la esfera unitaria Sd−1. Para d=2 aparece r dr dθ; para d=3 aparece r² dr dΩ. En d=1 hay dos direcciones, una por cada semieje.
En tres dimensiones, un ángulo sólido mide el área de la proyección radial de una región sobre la esfera unitaria; su unidad es el estereorradián. Toda la esfera abarca 4π estereorradianes. La cara de un cubo centrado en el origen abarca 2π/3: sus seis caras dividen simétricamente las direcciones del espacio. Esta es la construcción geométrica ilustrada en el documento original. En otras dimensiones hablamos de medida angular sobre la esfera unitaria. [6]
Lectura conceptual. El numerador acumula masa desde el radio observado hasta infinito; el denominador normaliza por la masa radial total. La integral angular y las constantes comunes se cancelan porque se incluyen todas las direcciones en ambos casos. La cancelación proviene de la simetría radial y la misma región angular, no de una igualdad de comportamientos asintóticos de autovectores.
Son integrales de volumen reducidas por coordenadas polares. No asignan probabilidad positiva a una única superficie de radio fijo: en este modelo continuo, esa superficie tiene probabilidad cero. La masa reside en regiones con espesor radial.
Lectura conceptual. Al cambiar la variable se cambia también la anchura de cada intervalo. El factor 1/(2√q) ajusta ese cambio. Multiplicarlo por rd−1 produce el exponente d/2−1. Este «menos uno» procede del jacobiano y de combinar potencias; tampoco expresa una serie alternada.
Lectura conceptual. Γ es una función que proporciona el normalizador de la densidad. Extiende el factorial: para enteros positivos m, Γ(m)=(m−1)!. Sustituir t=r²/2 en la integral radial total da 2d/2−1Γ(d/2). Así el cociente anterior se convierte en una probabilidad calculable y normalizada.
9. La ley chi-cuadrado y sus propiedades
Lectura conceptual. El término de potencia recoge la geometría de las capas y el cambio de variable; la exponencial recoge el descenso de la densidad normal con la distancia. El denominador hace que la integral sobre todos los valores positivos sea uno. Esta es una densidad unidimensional, aunque proviene de un problema de d dimensiones.
Escribimos Q ∼ χ²d: el símbolo ∼ significa «tiene distribución», mientras que = establece una igualdad entre objetos o expresiones. En esta derivación, d es un entero positivo porque cuenta coordenadas normales independientes. La familia gamma permite definir distribuciones χ² con cualquier número real positivo de grados de libertad. [7]
Lectura conceptual. Cada normal estándar al cuadrado aporta media uno y varianza dos. Al sumar d términos independientes se suman sus medias y varianzas. La equivalencia gamma especifica escala dos; en la parametrización por tasa, esa tasa es 1/2. Confundir tasa y escala cambia el modelo.
El soporte es [0,∞), aunque la fórmula se escribe para q>0. La densidad puede divergir al acercarse a cero cuando los grados de libertad son menores que dos, sin que eso cree una masa puntual en cero. Para d=2 es exponencial; al aumentar d se hace menos asimétrica. Una densidad puede exceder uno: lo que debe estar entre cero y uno es la probabilidad integrada.
Lectura conceptual. El valor p mide la probabilidad, bajo H₀ y los supuestos del modelo, de un estadístico al menos tan discrepante como el observado. La igualdad o desigualdad estricta en el extremo no modifica esta integral continua. No es la probabilidad de que H₀ sea verdadera, ni la probabilidad de que el resultado se deba al azar en un sentido absoluto.
10. Por qué funciona con conteos
El resultado normal anterior es exacto cuando se cumplen sus supuestos y se usan μ y Σ poblacionales. Los conteos de categorías no son normales exactos. Para vincularlos con χ² necesitamos el modelo multinomial y un argumento de límite.
Lectura conceptual. Cada observación independiente pertenece a una única categoría, las categorías son exhaustivas y las probabilidades permanecen constantes entre observaciones. Los conteos suman N. Aunque las observaciones individuales sean independientes, los conteos de diferentes categorías no lo son: si crece uno con total fijo, queda menos espacio para los demás.
Lectura conceptual. El total fijo induce dependencia negativa. Esto explica por qué sería incompleto justificar Pearson suponiendo que cada conteo tiene varianza exactamente igual al esperado y que todos son independientes. Esa idea es natural en un modelo de Poisson independiente, pero el multinomial exige incorporar la restricción del total.
Lectura conceptual. Una vez conocidas k−1 desviaciones, la restante queda determinada por el total. Por eso solo hay k−1 direcciones libres y la matriz conjunta de covarianzas es singular en el espacio completo. La geometría pertinente está en un subespacio de dimensión k−1.
Lectura conceptual. W designa el vector de residuos de Pearson. Dividir por √(Npi) produce residuos sin unidades. Como las probabilidades suman uno, s tiene longitud uno. La matriz I−ss⊤ elimina la dirección s y deja intactas las k−1 direcciones ortogonales a ella. Es una proyección de rango k−1; la identidad de covarianzas es exacta bajo el multinomial.
Con k fijo, probabilidades positivas fijas y N creciente, el teorema central del límite multinomial aproxima esos residuos por un vector normal en el subespacio libre. Elegida una base ortonormal de ese subespacio, aparecen k−1 coordenadas normales estándar independientes. La suma de sus cuadrados da el límite:
Lectura conceptual. La flecha expresa un límite distribucional al crecer N, no una igualdad exacta para cualquier muestra. Este es el puente entre la geometría normal y los conteos. La resta de uno procede de la restricción del total, no de una regla arbitraria.
Lectura conceptual. En problemas regulares de bondad de ajuste, estimar m parámetros identificables puede consumir m direcciones adicionales. La fórmula exige condiciones de estimación y regularidad, como máxima verosimilitud apropiada para los conteos agrupados. No basta restar parámetros mecánicamente: estimarlos a partir de datos sin agrupar y luego agrupar puede alterar la calibración. Las categorías estructuralmente imposibles también requieren un tratamiento específico. [9]
11. Los ejemplos originales, resueltos
11.1. Tomates: una proporción de 3:1
La hipótesis especifica probabilidades 0,75 y 0,25. Los 400 frutos se consideran observaciones independientes bajo el modelo; si hubiese agrupamiento por plantas o lotes habría que revisarlo.
| Categoría | O | E | O − E | (O − E)²/E |
|---|---|---|---|---|
| Pulpa roja | 310 | 300 | 10 | 0,333333 |
| Pulpa amarilla | 90 | 100 | −10 | 1,000000 |
| Total | 400 | 400 | 0 | 1,333333 |
Lectura conceptual. Las desviaciones absolutas son iguales, pero diez frutos pesan más en una categoría donde se esperaban cien que en otra donde se esperaban trescientos. Con un grado de libertad, la cola derecha aproximada es 0,2482. A un nivel α=0,05 no se rechaza la proporción 3:1; eso no demuestra que sea exactamente verdadera.
11.2. Casos hospitalarios: una proporción de 1:1
| Categoría | O | E | O − E | (O − E)²/E |
|---|---|---|---|---|
| Hombres | 480 | 450 | 30 | 2 |
| Mujeres | 420 | 450 | −30 | 2 |
| Total | 900 | 900 | 0 | 4 |
Lectura conceptual. Bajo igualdad de proporciones, las dos categorías aportan lo mismo. El valor 4 no se interpreta aisladamente: con un grado de libertad su cola derecha es aproximadamente 0,0455. Con α=0,05 se rechaza la igualdad de proporciones dentro del modelo; con α=0,01 no se rechaza. El nivel debe elegirse antes de mirar el resultado.
En el segundo ejemplo, la proporción observada de hombres es 480/900≈0,5333: una diferencia de unos 3,33 puntos porcentuales respecto de 0,5. El resultado permite ilustrar por qué una discrepancia relativamente pequeña puede alcanzar un umbral convencional. Su relevancia clínica o social requiere una pregunta sustantiva y datos adecuados.
12. Aplicaciones, condiciones y límites
Bondad de ajuste
Compara conteos con probabilidades especificadas. Las categorías deben definirse con una regla clara; si se agrupan datos continuos, la elección de intervalos afecta el resultado. Las probabilidades de cada intervalo deben calcularse con el modelo correspondiente. Si hay parámetros estimados, se debe justificar la distribución de referencia.
Independencia y homogeneidad
En una tabla de r filas y c columnas, la independencia plantea que las probabilidades conjuntas se factorizan en probabilidades marginales. La homogeneidad compara distribuciones categóricas entre poblaciones o grupos. Ambas pueden producir el mismo estadístico, aunque sus diseños muestrales difieran.
Lectura conceptual. Oi+ suma la fila i y O+j la columna j. Sus proporciones estiman las probabilidades marginales bajo independencia. La fórmula de grados de libertad descuenta las restricciones correspondientes, en la tabla completa ordinaria sin ceros estructurales ni otras restricciones.
La tabla de conteos contiene observados; los esperados se calculan bajo la hipótesis. En R, xtabs() construye la tabla observada y chisq.test(... )$expected proporciona la esperada. La independencia de las observaciones no se deduce de la independencia que el contraste intenta evaluar: es una condición del diseño.
Lectura conceptual. V resume magnitud de asociación en una tabla de contingencia usando el estadístico de Pearson sin corrección. No indica dirección ni causalidad; su interpretación depende de la estructura de la tabla y puede beneficiarse de correcciones de sesgo e intervalos. En una tabla 2 × 2 coincide con el valor absoluto de φ. Los residuos y proporciones muestran qué celdas explican la asociación.
Varianza de una población normal
La misma familia distribucional aparece en otro problema con supuestos distintos: la inferencia sobre una varianza normal.
Lectura conceptual. Para una muestra independiente de una población normal, S² se calcula usando N−1 en su denominador. Estimar la media consume una dirección. Bajo H₀: σ²=σ₀² se introduce σ₀² en T. Según la alternativa, el contraste puede usar cola izquierda, derecha o ambas; por tanto, no toda prueba basada en χ² es de cola derecha. [10]
Diagnóstico antes de calcular
- Unidad de observación: identificar qué se cuenta y si hay dependencia, pareamiento, agrupamiento o medidas repetidas.
- Conteos: usar frecuencias, no porcentajes sin su tamaño muestral. Frecuencias ponderadas de encuestas complejas pueden requerir ajustes de diseño como Rao–Scott.
- Categorías: deben ser excluyentes y exhaustivas según el modelo; los ceros estructurales no son simples ceros muestrales.
- Esperados: inspeccionar sus magnitudes y distribución entre celdas. «Todos al menos cinco» es una regla práctica conservadora, no un teorema universal ni una condición sobre los observados.
- Escasez: considerar un procedimiento exacto, una simulación compatible con la hipótesis o una reagrupación científicamente justificada. No reagrupar para obtener el resultado deseado.
- Reporte: acompañar el estadístico de grados de libertad, valor p, diseño, diagnóstico, proporciones y una medida de magnitud adecuada.
En tablas 2 × 2, la corrección de continuidad de Yates modifica la aproximación. R la aplica por defecto en ese caso al usar chisq.test(), pero no es un remedio universal para datos escasos. La prueba exacta de Fisher y los métodos de Monte Carlo responden a distribuciones de referencia específicas. En tablas, la simulación de chisq.test() condiciona en ambos márgenes, requiere márgenes positivos y omite Yates; no reproduce sin más cualquier diseño muestral. [11]
13. Reproducción y exploración en R
El código utiliza R base. RStudio puede servir como entorno de trabajo, pero las funciones pertenecen a R. No se necesitan archivos de datos externos. Las salidas numéricas indicadas arriba son aproximaciones deterministas; los experimentos de simulación ilustran la variabilidad y dependen de sus réplicas.
13.1. Cálculo manual y contraste automático
# Dos ejemplos originales: probabilidades fijadas por H0.
# No se han estimado parámetros de las probabilidades.
pearson_fijo <- function(observado, probabilidades) {
  stopifnot(is.numeric(observado), is.numeric(probabilidades),
            length(observado) == length(probabilidades),
            length(observado) >= 2L,
            all(is.finite(observado)), all(observado >= 0),
            all(observado == floor(observado)), sum(observado) > 0,
            all(is.finite(probabilidades)), all(probabilidades > 0),
            abs(sum(probabilidades) - 1) < 1e-10)
  esperado <- sum(observado) * probabilidades
  contribuciones <- (observado - esperado)^2 / esperado
  estadistico <- sum(contribuciones)
  gl <- length(observado) - 1L
  # Cola superior directa: evita restar de 1 una probabilidad cercana a 1.
  valor_p <- pchisq(estadistico, df = gl, lower.tail = FALSE)
  automatico <- chisq.test(observado, p = probabilidades)
  stopifnot(isTRUE(all.equal(estadistico,
                            unname(automatico$statistic))),
            isTRUE(all.equal(valor_p, automatico$p.value)))
  list(tabla = data.frame(observado, esperado, contribuciones),
       X2 = estadistico, gl = gl, p = valor_p,
       prueba = automatico)
}
tomates <- pearson_fijo(c(rojos = 310, amarillos = 90), c(0.75, 0.25))
hospital <- pearson_fijo(c(hombres = 480, mujeres = 420), c(0.5, 0.5))
tomates$tabla
c(X2 = tomates$X2, gl = tomates$gl, p = tomates$p)
# X2 = 1.333333333; gl = 1; p = 0.248213079
hospital$tabla
c(X2 = hospital$X2, gl = hospital$gl, p = hospital$p)
# X2 = 4; gl = 1; p = 0.045500264

# Alternativas binomiales exactas: no son la aproximación de Pearson.
binom.test(310, 400, p = 0.75)
binom.test(480, 900, p = 0.5)
pchisq() devuelve probabilidades acumuladas; lower.tail = FALSE solicita la cola superior. chisq.test(), al recibir un vector de conteos y probabilidades, realiza bondad de ajuste. La corrección correct concierne a tablas 2 × 2; no modifica estos contrastes vectoriales. Las comprobaciones comparan la suma manual con la función automática.
13.2. Tabla de contingencia ilustrativa
La siguiente tabla es un ejemplo añadido, construido para mostrar el procedimiento; no pertenece a los datos originales ni representa un estudio empírico.
tabla <- matrix(c(40, 20, 30, 50), nrow = 2, byrow = TRUE,
                dimnames = list(grupo = c("A", "B"),
                                respuesta = c("Si", "No")))
prueba <- chisq.test(tabla, correct = FALSE)
prueba
prueba$observed
prueba$expected
prueba$residuals  # (O - E) / sqrt(E)
prueba$stdres     # Ajustan por la varianza de cada residuo.

X2_manual <- sum((tabla - prueba$expected)^2 / prueba$expected)
gl_manual <- (nrow(tabla) - 1) * (ncol(tabla) - 1)
p_manual <- pchisq(X2_manual, df = gl_manual, lower.tail = FALSE)
V <- sqrt(X2_manual /
          (sum(tabla) * min(nrow(tabla) - 1, ncol(tabla) - 1)))
c(X2 = X2_manual, gl = gl_manual, p = p_manual, V = V)
stopifnot(isTRUE(all.equal(p_manual, prueba$p.value)))

# Comparación de procedimientos: explicitar el empleado.
chisq.test(tabla, correct = TRUE)  # Yates, solo 2 x 2.
fisher.test(tabla)                # Prueba exacta de Fisher.
set.seed(20261029)
chisq.test(tabla, simulate.p.value = TRUE, B = 99999)
Con B=99 999 réplicas, la resolución mínima del valor p simulado es 1/(B+1)=0,00001. Esa resolución no equivale a precisión: la estimación conserva error de Monte Carlo. Los residuos estandarizados ayudan a localizar discrepancias, pero evaluar muchas celdas requiere atender a multiplicidad y dependencia. [11]
13.3. De la normal a χ²: comprobar la geometría
set.seed(20261029)
B <- 50000L
d <- 3L
Sigma <- matrix(c(4, 1, 0.5,
                  1, 2, 0.2,
                  0.5, 0.2, 1), nrow = d, byrow = TRUE)
# chol devuelve C triangular superior con t(C) %*% C = Sigma.
C <- chol(Sigma)
Z <- matrix(rnorm(B * d), nrow = B, ncol = d)
X <- Z %*% C  # Cada fila tiene media cero y covarianza Sigma.
Q <- rowSums((X %*% solve(Sigma)) * X)
Q_estandar <- rowSums(Z^2)
stopifnot(max(abs(Q - Q_estandar)) < 1e-8)
c(media_empirica = mean(Q), media_teorica = d,
  varianza_empirica = var(Q), varianza_teorica = 2 * d)
hist(Q, breaks = 70, probability = TRUE,
     col = "#f5f0e8", border = "#d4c8b0",
     main = "Forma cuadratica normal y ley chi-cuadrado",
     xlab = "q")
curve(dchisq(x, df = d), add = TRUE, col = "#8b4513", lwd = 2)
# solve(Sigma) hace explícita la inversa para fines didácticos.
# En problemas grandes se prefieren factorizaciones y sistemas lineales.
La identidad entre los dos cálculos de Q se verifica hasta precisión numérica. En cambio, la media y la varianza empíricas solo se aproximan a sus valores teóricos porque la simulación tiene un número finito de réplicas.
13.4. De los conteos al límite asintótico
set.seed(20261029)
B <- 30000L
prob <- c(0.2, 0.3, 0.5)
gl <- length(prob) - 1L
umbral <- qchisq(0.95, df = gl)
explorar <- function(N) {
  O <- rmultinom(B, size = N, prob = prob)  # Una muestra por columna.
  E <- N * prob
  residuos <- sweep(O, 1, E, "-")
  contrib <- sweep(residuos^2, 1, E, "/")
  X2 <- colSums(contrib)
  c(N = N, minimo_esperado = min(E),
    media = mean(X2), rechazo_005 = mean(X2 > umbral),
    percentil_95 = unname(quantile(X2, 0.95)))
}
t(vapply(c(20L, 100L, 1000L), explorar, numeric(5)))
qchisq(0.95, df = gl)
# La media de X2 es k - 1 incluso a N finito bajo este modelo.
# Eso no hace exacta la distribución chi-cuadrado.
# El percentil y el rechazo permiten examinar la aproximación.

# Densidad, acumulada, cuantil y simulación son operaciones distintas:
dchisq(4, df = 1)                       # Altura de la densidad.
pchisq(4, df = 1, lower.tail = FALSE)  # Probabilidad de cola.
qchisq(0.95, df = 1)                    # Umbral del percentil 95.
rchisq(5, df = 1)                       # Cinco valores simulados.
La simulación evalúa el procedimiento bajo un modelo concreto; no garantiza su validez para otros diseños. Una aproximación puede mejorar con N y seguir mostrando fluctuaciones de Monte Carlo. La discreción de los conteos tampoco desaparece en una muestra finita.
14. Síntesis y glosario
La discrepancia se vuelve evidencia interpretable cuando se explicitan su escala, sus restricciones y la distribución que la calibra.
El recorrido comenzó con frecuencias observadas y esperadas. La normal multivariada permitió representar la discrepancia mediante una forma cuadrática, cuyos niveles son elipsoides. Centrar, orientar y reescalar produjo coordenadas normales estándar; integrar por capas radiales y elevar el radio al cuadrado condujo a la ley χ². El modelo multinomial devolvió el argumento al problema de los conteos y explicó el carácter asintótico del contraste de Pearson.
Esta conexión no convierte toda desviación cuadrática en chi-cuadrado, toda relación geométrica en equivalencia probabilística, ni todo resultado significativo en una conclusión causal. Su fuerza está en mostrar cómo los supuestos hacen posible el tránsito entre observación, estructura matemática e inferencia.
| Símbolo o concepto | Significado en el ensayo |
|---|---|
| N | Tamaño muestral o total de conteos. |
| d | Dimensión del vector normal no degenerado. |
| k | Número de categorías de una bondad de ajuste. |
| ν | Grados de libertad de la distribución de referencia. |
| Σ / ∑ | Matriz de covarianzas / operador de sumatoria. |
| Σ⁻¹ | Inversa matricial, existente bajo no singularidad. |
| R / W | Matriz de correlaciones / vector de residuos de Pearson. |
| Q / q | Variable cuadrática aleatoria / valor de esa variable. |
| X²P | Estadístico de Pearson para conteos. |
| χ²ν | Familia de distribuciones, indexada por grados de libertad. |
| r / q=r² | Radio / radio al cuadrado. |
| Densidad | Concentración cuya integral sobre una región da probabilidad. |
| Homocedasticidad | Constancia o igualdad de varianzas en el contexto de un modelo. |
| α / valor p | Nivel nominal del procedimiento / probabilidad de cola bajo la hipótesis. |
| Difeomorfismo | Biyección suave con inversa suave. |
15. Referencias y documento original
Las referencias originales se conservan como parte del recorrido intelectual. Las fuentes añadidas documentan la formulación moderna y las aplicaciones. La exposición matemática revisada es una reconstrucción explicativa; no una transcripción literal del artículo de 1900.
- Snedecor, G. W., y Cochran, W. G. (1967). Statistical Methods, 6.ª ed. Iowa State University Press. Véanse los ejemplos introductorios de las pp. 20–21 citados en el documento original.
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, serie 5, 50(302), 157–175. DOI y registro editorial.
- Penn State, STAT 505. Multivariate Normal Distribution. Normal multivariada, distancia de Mahalanobis y contornos elipsoidales. Material docente.
- Boyd, S. (2007). Symmetric matrices, quadratic forms, matrix norm, and SVD. EE263, Stanford University. Referencia docente del original. Archivo del curso 2007–2008. Véase también Lall, S., Symmetric matrices and quadratic forms, notas de EE263.
- Gómez Julián, J. M. (2021; publicado originalmente bajo el nombre Isadore Nabi). Hacia una interpretación dialéctica-materialista de la topología general: génesis histórica-teórica de la topología desde la geometría y la teoría de conjuntos. Ensayo del autor. Su función aquí es contextualizar la reflexión sobre equivalencias estructurales; las condiciones probabilísticas se justifican en el texto presente.
- Weisstein, E. W. Solid Angle. MathWorld, Wolfram Research. Referencia consultada en el original en 2021. Definición y ejemplo del cubo.
- R Core Team. The (non-central) Chi-Squared Distribution, documentación del paquete
stats. Densidad, probabilidades, cuantiles y simulación. - Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer. Referencia histórica añadida para situar la axiomatización de la probabilidad.
- NIST/SEMATECH. e-Handbook of Statistical Methods, §1.3.5.15, Chi-Square Goodness-of-Fit Test. Agrupación, estimación y grados de libertad.
- NIST/SEMATECH. e-Handbook of Statistical Methods, §1.3.5.8, Chi-Square Test for the Variance. Contraste sobre la varianza.
- R Core Team. Pearson’s Chi-squared Test for Count Data, documentación del paquete
stats. Comportamiento de chisq.test(), residuos y Monte Carlo. - Wikipedia. Elipse. Fuente geométrica citada en el original, consultada allí en 2021. Entrada de referencia. Se conserva su trazabilidad; la reconstrucción algebraica se apoya en las fuentes docentes indicadas.
Archivo del ensayo
La versión original conserva la formulación y la presentación de 2021. El texto de esta página desarrolla sus ejemplos, precisa su notación y amplía la fundamentación geométrica y estadística.
Consultar el PDF original ↗JOSÉ MAURICIO GÓMEZ JULIÁN · Marxist Philosophy of Science
Historia, geometría e inferencia estadística
Leave a Comment/Deja un Comentario