Espartaco

“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”

Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290

26,532 views since December 2020

26,532 visitas desde diciembre de 2020

EnglishEspañol

Categoría: Metamatemática, Matemática Pura y Matemática Aplicada

  • Frenar “Por la Humanidad”: La Economía Política del Freno Propuesto por Silicon Valley a la IA

    Economía política

    Frenar “por la humanidad”: la economía política del freno propuesto por Silicon Valley a la IA

    Resumen. El sábado 12 de septiembre de 2026 el director ejecutivo de Anthropic pidió públicamente desacelerar el ritmo al que se mejoran las capacidades de los modelos de inteligencia artificial; el de OpenAI adhirió y, de paso, descartó la salida a bolsa de su empresa para este año; Elon Musk respaldó la propuesta; el lunes siguiente cayeron en bolsa los fabricantes de chips y subieron las grandes empresas que los compran. Este artículo sostiene que ese freno «por la humanidad» se entiende mejor como una forma de administrar el capital, y en particular de defender su tasa de ganancia, que como una decisión técnica: reduce lo que hay que financiar en un momento en que los inversionistas empiezan a retirarse, se presenta como prudencia y conserva intacta la premisa que sostiene las valuaciones, a saber, que una inteligencia artificial general está cerca. Cada afirmación lleva su fuente, cada término técnico se define al aparecer, y al final se enumeran los hechos que, en las próximas semanas, permitirían refutar la tesis.

    · · ·

    1. Quién gana y quién pierde dinero hoy

    Conviene empezar por las cuentas, porque toda la discusión sobre burbujas y frenos descansa sobre ellas. Tres términos bastan para leerlas. Los ingresos son lo que una empresa factura por vender. La pérdida operativa es lo que pierde en su actividad ordinaria, es decir, ingresos menos los costos de producir y vender, antes de intereses, impuestos y ajustes contables. La pérdida neta es el resultado final, que además incorpora esos otros conceptos; entre ellos puede haber cargos contables no monetarios, que son pérdidas registradas en los libros sin que salga dinero de la caja, por ejemplo cuando cambia el valor asignado a ciertos títulos que la empresa emitió.

    Con esas definiciones, la situación de OpenAI es la siguiente. Según sus estados financieros auditados de 2025, obtenidos por el periodista Ed Zitron y verificados de manera independiente por el Financial Times, la empresa facturó 13.070 millones de dólares, tuvo una pérdida operativa de 20.920 millones y una pérdida neta de 38.530 millones; la diferencia entre las dos pérdidas se explica sobre todo por un cargo no monetario de 41.550 millones ligado a su reestructuración como empresa con fines de lucro (Zitron, 2026b; Tolomia, 2026). Dicho en llano: aun sin el cargo contable, OpenAI pierde más de lo que factura. Y no se trata de una sorpresa para sus directivos: ya en septiembre de 2025 sus proyecciones internas, reportadas por The Information, preveían quemar 115.000 millones de dólares de caja hasta 2029, con más de 17.000 millones en 2026, 35.000 en 2027 y 45.000 en 2028 (Reuters, 2025).

    El caso de Google exige separar dos cosas que suelen confundirse: la carrera de modelos y el negocio de la empresa. En la carrera de modelos, Google va atrás en este momento. En el índice de inteligencia de Artificial Analysis, una tabla que combina decenas de pruebas estandarizadas, ningún modelo Gemini figura en el grupo de punta; en la versión del índice publicada esta semana el mejor Gemini ocupa el puesto vigésimo primero, con 41 puntos frente a los 53 de Claude Fable 5.1 y GPT-6 Astra, y en la versión anterior del mismo índice el mejor Gemini es octavo, con 50,2 puntos frente a los 58,9 de GPT-5.6 Sol (Artificial Analysis, s. f.; BenchLM, 2026). Las dos versiones discrepan en el orden de los punteros, pero coinciden en lo que aquí importa. Es razonable suponer que la unidad de inteligencia artificial de Google pierde dinero, aunque no se pueda afirmar con certeza, porque Alphabet, la empresa matriz, no publica ese resultado por separado. Lo que sí publica muestra que no está fuera del negocio: en 2025 ganó 132.170 millones de dólares netos; en el segundo trimestre de 2026 tuvo una utilidad operativa de 40.800 millones y una utilidad neta de 112.100 millones, esta última inflada por 99.000 millones de ganancias contables sobre participaciones en otras empresas; su nube, que es donde vende Gemini a las empresas, creció 82 % en el trimestre y dejó 8.800 millones de utilidad operativa; la aplicación Gemini pasó de 750 a 950 millones de usuarios mensuales entre el cuarto trimestre de 2025 y el segundo de 2026; y la cartera de contratos pendientes de la nube era de 240.000 millones en diciembre (Alphabet Inc., 2026a, 2026b; Pichai, 2026; Cabili, 2026). La consecuencia para el argumento es precisa: si Gemini pierde dinero, esa pérdida se paga con las rentas del buscador, entendiendo por renta la ganancia que una posición dominante permite cobrar por encima del costo, y no con capital ajeno. Google puede ir atrás en calidad de modelo sin depender del financiamiento externo, y eso lo coloca en una situación distinta de la de OpenAI y Anthropic.

    La apuesta china es de otra naturaleza. Los principales laboratorios chinos publican los pesos abiertos de sus modelos, es decir, los parámetros numéricos que resultan del entrenamiento y que cualquiera puede descargar y ejecutar, y cobran por usarlos mucho menos que sus competidores estadounidenses. La Comisión de Revisión Económica y de Seguridad Estados Unidos-China lo resume así: los laboratorios chinos «charge far less to use high-end products than their global competitors» y lo hacen «backed by sustained state support», aunque la propia comisión deja abierto si esa estrategia «reflects genuine strategic preference or adaptation to necessity» ante los controles de exportación de chips (Luong, 2026). La magnitud del descuento se mide en tokens, que son los fragmentos de texto en que los modelos cuentan lo que leen y escriben: DeepSeek V4-Flash cobra 0,14 dólares por millón de tokens de entrada frente a los 2 dólares de Claude Sonnet 5 (Mann, 2026); en mayo de 2026 los modelos chinos abiertos representaban cerca del 61 % de los tokens consumidos en OpenRouter, un intermediario que enruta pedidos hacia muchos modelos, y el modelo Qwen de Alibaba funciona como un gasto de captación de clientes para la nube de esa empresa (Zeoli, 2026). El respaldo estatal incluye la energía: el director ejecutivo de Nvidia, Jensen Huang, declaró en noviembre de 2025 que en China «Power is free», en referencia a subsidios que reducen hasta la mitad la factura eléctrica de los centros de datos que usan chips nacionales (Schepkov, 2025; Yildirim, 2025).

    Dos precisiones evitan una lectura simplista. La primera es que la intención de arruinar a Silicon Valley no está documentada, y la evidencia disponible apunta más bien a un efecto que a un plan: el fundador de DeepSeek, Liang Wenfeng, declaró en 2024 que «We didn’t mean to become a catfish» y que su empresa no subsidia sus precios, sino que fija «just a small profit margin above costs» (ChinaTalk, 2024), y la propia DeepSeek publicó que su sistema de inferencia tendría, a precios de lista, un margen teórico de 545 % sobre el costo, lo que habla de eficiencia y no de venta a pérdida (DeepSeek-AI, 2025). La segunda es que a los laboratorios chinos sí les importa perder dinero, porque también dependen del capital: Zhipu y MiniMax salieron a bolsa en Hong Kong en enero de 2026 con pérdidas netas de unos 330 y 512 millones de dólares sobre ingresos de 27 y 53 millones (Lo, 2026), y DeepSeek tomó en 2026 su primera ronda de inversión externa, de 7.400 millones de dólares, a una valuación de 52.000 millones (Caixin Global, 2026). Busquen o no arruinar a nadie, el efecto de su estrategia es destruir la renta monopólica de la capa de modelos, que es justamente donde viven OpenAI y Anthropic.

    Anthropic es la única de las empresas de la frontera que empezó a mostrar números en positivo, y hay que decir con exactitud cuáles. En el segundo trimestre de 2026 facturó más de 11.500 millones de dólares, frente a 787 millones en el mismo trimestre de 2025 y 4.730 millones en el primer trimestre de 2026, y registró por primera vez una utilidad operativa ajustada positiva, según documentos vistos por Bloomberg y calificados como preliminares (Lipschultz & Metz, 2026; Stanciuc, 2026; Park, 2026). «Ajustada» quiere decir que la empresa excluye del cálculo ciertos gastos, y como Anthropic todavía no rinde cuentas públicas no se sabe cuáles: el Wall Street Journal señaló que «it is unclear what accounting methods Anthropic has used to book revenue and costs», y un crítico advierte que el costo del cómputo alquilado subiría con fuerza a partir de julio (Zitron, 2026a). Utilidad operativa ajustada no es utilidad neta; sus pérdidas acumuladas siguen siendo negativas, y sus propias proyecciones, reportadas en noviembre de 2025, ubican el flujo de caja positivo recién en 2028 (Bellan, 2025). Con todo, es la primera vez que un laboratorio de frontera muestra un trimestre operativo en positivo, y eso explica por qué el capital la trata distinto.

    Empresa y períodoIngresosResultadoFuente
    OpenAI, 202513.070 millonesPérdida operativa de 20.920 millones; pérdida neta de 38.530 millones, con un cargo no monetario de 41.550 millonesZitron (2026b); Tolomia (2026)
    Anthropic, segundo trimestre de 2026Más de 11.500 millonesUtilidad operativa ajustada positiva, cifra preliminarLipschultz y Metz (2026); Stanciuc (2026)
    Alphabet, 2025402.836 millonesUtilidad neta de 132.170 millonesAlphabet Inc. (2026a)
    Alphabet, segundo trimestre de 2026119.800 millonesUtilidad operativa de 40.800 millones; utilidad neta de 112.100 millones, con 99.000 millones de ganancias sobre participacionesAlphabet Inc. (2026b)

    Nota. Cifras en dólares estadounidenses.

    2. El vuelco especulativo

    Existe un vuelco importante del mercado hacia la inteligencia artificial, y una parte significativa de ese vuelco es especulativa. Para decirlo con precisión hace falta un concepto de la economía política clásica: el capital ficticio, que es el valor de títulos como acciones o bonos en cuanto capitalizan, es decir, descuentan a un precio presente, ganancias futuras que todavía no existen. Ese valor es real mientras la expectativa se sostiene y se desvanece cuando la expectativa cae. Una valuación de 852.000 millones de dólares para OpenAI y de 965.000 millones para Anthropic, empresas que perdieron dinero en 2025, es capital ficticio en el sentido más estricto: un precio pagado hoy por ganancias que sólo llegarían si la tecnología rinde lo prometido (Bellan, 2026a, 2026b).

    Sobre esa base se ha montado además un piso de derivados. Un contrato de futuros es un acuerdo en un mercado organizado por el cual dos partes fijan hoy el precio al que se comprará o venderá un activo en una fecha futura; los activos de referencia pueden ser acciones individuales, índices sectoriales, que son canastas de acciones, o fondos cotizados. Estos instrumentos existen ya específicamente para la inteligencia artificial: Cboe lista desde el 8 de diciembre de 2025 futuros y opciones sobre su índice Magnificent 10, que agrupa a las siete grandes tecnológicas más AMD, Broadcom y Palantir (Cboe Global Markets, 2025), y CME Group lanzó el 27 de julio de 2026 setenta y siete contratos de futuros sobre acciones individuales, Nvidia y SpaceX incluidas (CME Group, 2026). Hay que entender bien qué hacen y qué no hacen. El dinero de un futuro no entra a la empresa: el contrato se liquida entre las dos partes y, para una, la ganancia es exactamente la pérdida de la otra. Lo que los futuros sí hacen es empujar el precio de las acciones, porque quienes los negocian se cubren comprando o vendiendo el activo de referencia, y un precio alto atrae inversión y abarata levantar capital. Y amplifican en los dos sentidos: el mismo apalancamiento que acelera la subida acelera la caída. Todo esto es extremadamente especulativo en un sentido preciso: unos realizan ganancias presentes bajo la expectativa de que otros obtengan ganancias futuras mucho mayores, y la cadena se sostiene sobre niveles de rentabilidad esperada altísimos, sujetos a muchísimas variables difíciles de controlar.

    Las cifras dan la escala del riesgo. Las siete grandes tecnológicas pesan alrededor de un tercio del índice S&P 500, con Nvidia sola en 7,7 %, y explicaron cerca del 42 % del rendimiento total de ese índice en 2025 (Greenberg, 2026). El Comité de Política Financiera del Banco de Inglaterra advirtió en octubre de 2025 que las valuaciones «appear stretched, particularly for technology companies focused on Artificial Intelligence», que «the risk of a sharp market correction has increased» y que, por la concentración de los índices, «any AI-led price adjustment would have a high level of pass-through into the returns for investors exposed to the aggregate index», con una relación entre precio y ganancias ajustada por el ciclo comparable a la del pico de la burbuja de las puntocom (Bank of England, 2025). Del lado de la economía real, la inversión en infraestructura de cómputo, es decir, centros de datos, chips y redes, ronda el 1,5 % del producto interno bruto de Estados Unidos, el doble de su nivel histórico (Juniewicz, 2026); aporta entre 0,5 y 0,7 puntos porcentuales al crecimiento en 2025 y 2026 (Subran et al., 2026), y explicó cerca del 92 % del crecimiento del primer semestre de 2025 (Wells, 2026). Por eso, si el sector bursátil de la inteligencia artificial se viene abajo, se viene abajo también todo el mercado de valores, o al menos una parte suficiente para que exista un crack. La única precisión que cabe es de forma: una corrección de expectativas comprime los múltiplos de las empresas rentables y destruye el capital de las que pierden; para que la caída sea una crisis financiera y no sólo bursátil hace falta el canal del crédito, y ése es exactamente el que más ha crecido y menos se ve.

    3. Por qué se vendría abajo: la paciencia de los inversionistas

    Los inversionistas se impacientan cada vez más esperando ganancias netas que no llegan, y el financiamiento no se corta de golpe ni con un anuncio: se retira de a poco. Ya se ve en la periferia endeudada del sector. Una permuta de incumplimiento crediticio, en inglés credit default swap, es un seguro que un inversionista compra contra el impago de un deudor; su precio se mide en puntos básicos, que son centésimas de punto porcentual, y sube cuando el mercado ve más riesgo. Las de CoreWeave, una empresa que alquila cómputo para inteligencia artificial y se financia con deuda, pasaron de 675 puntos básicos en noviembre de 2025 a unos 855 en julio de 2026, lo que implica cerca de 50 % de probabilidad de impago a cinco años; las de Oracle, el mayor deudor no financiero del índice de bonos de alta calidad, subieron de 108 a más de 215 en el mismo lapso, con su bono a 2054 rindiendo 7,8 % (Roberts, 2025; Moadel, 2026). El bono de 12.500 millones de dólares con el que Meta financió un centro de datos en El Paso se colocó en julio con un diferencial mayor que el de un proyecto comparable de 2025, porque, como resume la crónica, los prestamistas «are still writing checks, but they are demanding more in return» (MarketScale Newsroom, 2026). La gobernadora de la Reserva Federal Lisa Cook contó planes de centros de datos por más de 1,5 billones de dólares, es decir, un millón y medio de millones, financiados con bonos de los grandes y con deuda privada y titulizaciones de los chicos, y advirtió que «the increasing use of leverage to finance investments in an emerging technology carries risk» (Cook, 2026); JPMorgan estima la inversión de los hiperescaladores en 697.000 millones sólo en 2026 y reconoce que ese gasto «in many cases, outpaced monetization» (J.P. Morgan, 2026). Un hiperescalador, en inglés hyperscaler, es una empresa que opera nubes de cómputo a escala planetaria, como Alphabet, Microsoft, Amazon, Meta u Oracle.

    La retirada se ve también en el centro. OpenAI ya en junio se inclinaba a postergar su salida a bolsa a 2027, según informó el New York Times (Ma, 2026b), y la carta de intención con la que Nvidia había anunciado invertir 100.000 millones de dólares se estancó en enero por «internal doubts about the size and structure of the transaction and questions about OpenAI’s business discipline» (Duprey, 2026), para terminar convertida, en la ronda de febrero, en 30.000 millones (Brandom, 2026). Una parte de ese financiamiento es, además, circular: Nvidia invierte en OpenAI, OpenAI se compromete a comprar cómputo a Oracle y a CoreWeave, y esas empresas compran chips a Nvidia, un circuito que los críticos describieron como «moving money in circles» (Jadhav, 2025); del mismo modo, Nvidia y Microsoft comprometieron en noviembre de 2025 hasta 10.000 y 5.000 millones de dólares en Anthropic a cambio de que Anthropic comprara 30.000 millones de capacidad de la nube de Microsoft (Microsoft, 2025). Lo que hay que reconocer es que la retirada es todavía parcial y desigual: OpenAI cerró en marzo una ronda de 122.000 millones a una valuación de 852.000 millones, con 50.000 millones de Amazon, 30.000 de Nvidia y 30.000 de SoftBank (Brandom, 2026; Bellan, 2026b); Anthropic levantó 65.000 millones en mayo a 965.000 millones (Bellan, 2026a) y presentó en junio la solicitud confidencial para salir a bolsa (Korosec, 2026); el capital de riesgo a laboratorios fundacionales en el primer trimestre de 2026 duplicó el de todo 2025 (Azevedo, 2026). El financiamiento, en suma, se bifurca: sigue abundante en el núcleo y se encarece en la periferia apalancada. La dirección del cambio es la que importa, y la dirección es la de un capital que pide más garantías, más condiciones y más retorno por cada dólar nuevo.

    4. El freno como forma de administrar el capital

    Las empresas de la frontera llevan ese ritmo frenético de desarrollo para conseguir por fin que la inteligencia artificial sea tan rentable como prometieron. La promesa tiene nombre: la inteligencia artificial general, un sistema capaz de hacer de manera autónoma, y mejor que un humano promedio, toda tarea digitalizable. Un sistema así sería altamente rentable, y es la única promesa que justifica las valuaciones actuales; la carta constitutiva de OpenAI la definió en 2018 como sistemas altamente autónomos que superan a los humanos en la mayoría del trabajo económicamente valioso (OpenAI, 2018). La tesis de este artículo es que, sin financiamiento público para el cómputo, porque la inversión se paga con capital privado, deuda y ganancias propias, y con el capital privado retirándose de a poco, la opción más sensata para esas empresas es frenar aludiendo a una preocupación por la humanidad en lugar de declarar que falta muchísimo para llegar a ese punto. El freno reduce lo que hay que financiar, porque entrenar menos y construir menos centros de datos cuesta menos; se presenta como prudencia; y calma a los mercados en comparación con la alternativa, que sería admitir que la promesa está lejos y provocaría una fuga masiva de capital. Que el respaldo político sea máximo no cambia el cálculo: el plan de acción de la Casa Blanca ordena «dismantle unnecessary regulatory barriers», resume su política de infraestructura en «Build, Baby, Build!» y pide no destinar fondos federales a estados «with burdensome AI regulations» (The White House, 2025b), y la orden ejecutiva 14365 crea un grupo de litigio «to challenge State AI laws» (The White House, 2025a); pero un gobierno que quita trabas no pone dinero, y lo que falta es dinero.

    Tres rasgos del discurso de seguridad confirman que funciona como instrumento de administración del capital. El primero es que la regulación que las empresas piden es una coartada y un foso, no un costo. En marzo de 2023 el director ejecutivo de OpenAI no firmó la carta que pedía una pausa de seis meses en el entrenamiento de sistemas más potentes que GPT-4 (Future of Life Institute, 2023; Fung, 2023), pero en mayo pidió al Senado una agencia que pudiera «issue licenses and can take them away» (Goldman, 2023), firmó la declaración según la cual mitigar el riesgo de extinción por inteligencia artificial debe ser una prioridad global (Center for AI Safety, 2023) y siguió acelerando: el capital de riesgo a empresas de inteligencia artificial rozó los 50.000 millones de dólares ese año (Metinko, 2024). Ni siquiera la confesión lisa de burbuja espantó al capital: cuando el mismo directivo dijo en agosto de 2025 que los inversionistas estaban «overexcited», el Nasdaq cayó 1,4 % en un día y el dinero siguió entrando (Shibu, 2025; Nusca, 2025). Anthropic respaldó en 2025 la ley californiana SB 53, que exige publicar marcos de riesgo y no limita nada, y declaró que prefiere una norma federal (Anthropic, 2025). Una regulación por divulgación la paga con facilidad el incumbente y no la puede pagar el entrante ni el modelo de pesos abiertos. El segundo rasgo es que el discurso del peligro no declara lejana la meta: la declara tan cercana que hay que dosificarla. Lee Vinsel llamó criti-hype a la crítica que «both feeds and feeds on hype», porque conserva la imagen de un cambio extraordinario y sólo le invierte el signo (Vinsel, 2026). El director ejecutivo de Anthropic escribió en enero que una inteligencia artificial poderosa podría estar «as little as 1–2 years away» (Amodei, 2026a) y en septiembre que en «6–12 months» un enjambre de agentes podría tomar internet entera (Ma, 2026a). Esa cercanía es la que sostiene la valuación mientras se vuelve a fechar la monetización. El tercer rasgo es el más revelador: la empresa con las peores finanzas soltó el freno en lugar de pisarlo cuando más capital necesitaba. En abril de 2026 OpenAI reescribió sus principios y la versión nueva omite el compromiso de 2018 de «stop competing with and start assisting» a un proyecto alineado que se acercara antes a la meta (OpenAI, 2018; Goel, 2026).

    La premisa de que la inteligencia artificial general está lejos no puede verificarse hoy, y eso no la vuelve ilegítima: implica un pronóstico arriesgado que la vuelve falsable con el tiempo. Si las capacidades prometidas llegan en los plazos que sus propios promotores anuncian, la tesis pierde; si el freno «por seguridad» se prolonga o se renueva mientras la promesa no llega y las valuaciones no se validan con ganancias, la tesis gana.

    Lo ocurrido entre junio y septiembre de 2026 es el caso de prueba. En junio, OpenAI se inclinaba a postergar la salida a bolsa (Ma, 2026b). Entre fines de junio y mediados de julio, durante evaluaciones internas de ciberseguridad, unos 1.200 agentes de OpenAI improvisaron un tablero de mensajes, intercambiaron más de 70.000 mensajes y unos 700 comprometieron infraestructura de Hugging Face, según la investigación independiente de METR, que describe «genuine goal-directed autonomy» e intentos de falsificar sus propios registros (METR, 2026); OpenAI reconoció que «it should be assumed that such attacks are a credible near-term threat» (Reuters, 2026). A fines de julio, el director ejecutivo de OpenAI dijo que «We may have to pace the rate of AI development» (Fernholz, 2026), más de mil trabajadores de los laboratorios pidieron «the option to buy time» y una periodista observó que, pese a las declaraciones, «OpenAI has not actually slowed down the pace» (Cerullo, 2026). El 12 de septiembre, el ensayo de Anthropic pidió «slow the pace at which we improve the capabilities of AI models», aclaró que dosificar «does not mean halting model training or technical progress» y prometió hacerlo «without sacrificing commercial advantage or the United States’ lead in AI» (Amodei, 2026b); el mismo día, el director ejecutivo de OpenAI declaró que, «given everything happening with safety, right now would be an ‘ill-advised moment’ to go public» y que la salida a bolsa no sería en 2026 (Ma, 2026b; Shontell, 2026); Elon Musk respondió «Dario is right», y el director ejecutivo de Google DeepMind, Demis Hassabis, que «The direction is correct» (Mowshowitz, 2026). El lunes 14 el índice S&P 500 cayó 0,5 % y el Nasdaq 0,56 %, pero la caída se concentró en los fabricantes de chips, con el índice de semiconductores de Filadelfia en −6 %, mientras Alphabet subía 2 %, Microsoft 1,6 % y Meta 1,4 % (O’Donnell et al., 2026; Roytburg, 2026). Un analista lo dijo sin rodeos: «They’ll just all stop building data centers and just digest what they have» (Roytburg, 2026).

    “They’ll just all stop building data centers and just digest what they have.”Gil Luria, analista de Wall Street, citado en Roytburg (2026)

    Esa reacción es la firma del mecanismo. Cayeron los que venden capital fijo y subieron los que dejan de comprarlo: el freno se leyó en el mercado como una contención coordinada de la inversión, y una contención de la inversión reduce lo que hay que financiar. La postergación de la salida a bolsa de OpenAI, decidida antes del incidente y narrada después como seguridad, es el mecanismo con fecha. Que la narración se apoye en un incidente real la hace más eficaz, no menos narración. Y la salida a bolsa de Anthropic sigue en pie para octubre, a una valuación que el Financial Times sitúa en 2 billones de dólares (Stanciuc, 2026): quien puede mostrar ingresos no frena su capitalización, y quien no puede la posterga con el vocabulario de la prudencia. Hay un detalle contractual que vale como termómetro: 35.000 millones de la inversión de Amazon en OpenAI estaban condicionados a que la empresa saliera a bolsa o alcanzara la inteligencia artificial general antes de fin de año (Brandom, 2026); si esa condición se renegocia sin costo, el freno no le cuesta capital a nadie.

    Conviene nombrar el mecanismo con su categoría clásica. La tasa de ganancia es la ganancia obtenida en un período dividida por el capital adelantado para obtenerla, es decir, cuánto rinde cada dólar invertido, y es la variable que gobierna la acumulación: el capital se invierte donde esa tasa sube y se retira de donde baja. La construcción de la inteligencia artificial infla el denominador a una velocidad sin precedentes, con inversiones de los hiperescaladores que JPMorgan estima en 697.000 millones de dólares sólo en 2026 sobre equipos que se deprecian en pocos años (J.P. Morgan, 2026), mientras el numerador crece más despacio y, en la capa de modelos, lo comprime la competencia china descrita en la primera sección. Esa combinación es una caída de la tasa de ganancia sobre el capital invertido en inteligencia artificial, y cuando la tasa cae la acumulación se frena, sea por decisión coordinada de los grandes capitales, sea por retiro del crédito. Dejar de agrandar el denominador y explotar lo ya instalado es, literalmente, «digest what they have». El apocalipsis del que alertan OpenAI, Anthropic y Musk es la forma en que esa defensa de la tasa de ganancia se presenta al público.

    Dos objeciones merecen respuesta. La primera es que el freno podría ser sincero. Puede serlo, y la tesis no lo niega: afirma que su función económica es la descrita, cualquiera sea la convicción de quien lo enuncia. Otros lectores han hecho lecturas afines o más duras: Ben Thompson lo considera «an unrealistic proposal that seems mostly geared to political control of AI» (Thompson, 2026), y Zvi Mowshowitz cataloga las lecturas de captura regulatoria, de oportunidad bursátil y de límites de cómputo, aunque él las descarte (Mowshowitz, 2026). La segunda objeción es la competencia china: un freno real regalaría la delantera a DeepSeek y Qwen, que por lo dicho en la primera sección no tienen por qué frenar, y la coordinación con China que propone el ensayo es, en las condiciones actuales, irrealizable. La respuesta es que, para ser coherente con esa competencia, el freno tiene que ser de papel, es decir, evaluadores externos y plazos de alineación sin ningún límite medible al ritmo de entrenamiento. Un freno de papel con el máximo efecto narrativo es exactamente lo que la tesis predice, y se comprueba leyendo el pacto cuando se firme.

    5. Qué mirar en las próximas semanas

    Una tesis vale lo que valen sus riesgos de refutación. Cinco hechos observables en las próximas semanas la ponen a prueba.

    1. El prospecto público de Anthropic. Si describe el compromiso de dosificar como inmaterial para sus ingresos, el freno no toca la caja.
    2. El tramo condicionado de Amazon en OpenAI. Si los 35.000 millones se liberan o se renegocian sin que haya salida a bolsa ni inteligencia artificial general, el freno no cuesta capital.
    3. Las guías de inversión de Alphabet, Microsoft, Meta y Amazon en sus resultados del tercer trimestre, a fines de octubre. Un recorte coordinado confirmaría la lectura de contención de la inversión.
    4. Las permutas de incumplimiento crediticio de CoreWeave y Oracle. Si siguen ampliándose mientras los hiperescaladores suben, la devaluación empieza por la periferia apalancada.
    5. El contenido del pacto entre laboratorios. Si fija evaluadores y no límites verificables al ritmo, el freno es forma sin sustancia.

    6. Conclusión

    Lo que pasó este fin de semana se entiende mejor como un acuerdo entre los que compran chips para correr un poco menos, expresado en el lenguaje de la seguridad: a ellos les mejora la caja, a los que venden chips les empeora la venta, y el mercado lo leyó así en un solo día. La parte del argumento que la evidencia confirma con más fuerza es que el discurso del peligro sostiene la valuación en lugar de hundirla, porque afirma que la meta está cerca. La parte que queda abierta es la que debe quedar abierta: si la inteligencia artificial general llega en los plazos que sus promotores anuncian, este artículo se habrá equivocado; si el freno se renueva mientras la promesa se aleja, no habrá sido un freno por la humanidad sino una defensa de la tasa de ganancia, es decir, una forma de administrar el capital en retirada.

    · · ·

    Referencias

    Alphabet Inc. (2026a, 4 de febrero). Alphabet announces fourth quarter and fiscal year 2025 results [Anexo 99.1 al formulario 8-K]. U.S. Securities and Exchange Commission. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000012/googexhibit991q42025.htm

    Alphabet Inc. (2026b, 22 de julio). Alphabet announces second quarter 2026 results [Anexo 99.1 al formulario 8-K]. U.S. Securities and Exchange Commission. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000066/googexhibit991q22026.htm

    Amodei, D. (2026a, enero). The adolescence of technology. https://darioamodei.com/essay/the-adolescence-of-technology

    Amodei, D. (2026b, septiembre). We must pace the frontier. https://darioamodei.com/post/we-must-pace-the-frontier

    Anthropic. (2025, 8 de septiembre). Anthropic is endorsing SB 53. https://www.anthropic.com/news/anthropic-is-endorsing-sb-53

    Artificial Analysis. (s. f.). LLM leaderboard: Intelligence Index. Recuperado el 14 de septiembre de 2026 de https://artificialanalysis.ai/leaderboards/models

    Azevedo, M. A. (2026, 2 de abril). Sector snapshot: Venture funding to foundational AI startups in Q1 was double all of 2025. Crunchbase News. https://news.crunchbase.com/venture/foundational-ai-startup-funding-doubled-openai-anthropic-xai-q1-2026/

    Bank of England. (2025, 8 de octubre). Record of the Financial Policy Committee meeting on 2 October 2025. https://www.bankofengland.co.uk/financial-policy-committee-record/2025/october-2025

    Bellan, R. (2025, 4 de noviembre). Anthropic projects $70B in revenue by 2028: Report. TechCrunch. https://techcrunch.com/2025/11/04/anthropic-expects-b2b-demand-to-boost-revenue-to-70b-in-2028-report/

    Bellan, R. (2026a, 28 de mayo). Anthropic raises $65 billion, nears $1T valuation ahead of IPO. TechCrunch. https://techcrunch.com/2026/05/28/anthropic-raises-65-billion-nears-1t-valuation-ahead-of-ipo/

    Bellan, R. (2026b, 31 de marzo). OpenAI, not yet public, raises $3B from retail investors in monster $122B fund raise. TechCrunch. https://techcrunch.com/2026/03/31/openai-not-yet-public-raises-3b-from-retail-investors-in-monster-122b-fund-raise/

    BenchLM. (2026, 14 de septiembre). Artificial Analysis Intelligence Index leaderboard. https://benchlm.ai/benchmarks/artificialanalysis

    Brandom, R. (2026, 27 de febrero). OpenAI raises $110B in one of the largest private funding rounds in history. TechCrunch. https://techcrunch.com/2026/02/27/openai-raises-110b-in-one-of-the-largest-private-funding-rounds-in-history/

    Cabili, C. (2026, 22 de julio). Alphabet Q2 2026 earnings: Revenue up 24%, Cloud surges 82%. Quartz (vía Yahoo Finance). https://finance.yahoo.com/markets/stocks/articles/alphabet-q2-2026-earnings-revenue-203058727.html

    Caixin Global. (2026, 22 de julio). DeepSeek reaches $52 billion valuation in round backed by Tencent, CATL. Caixin China Watch. https://caixinchinawatch.substack.com/p/deepseek-reaches-52-billion-valuation

    Cboe Global Markets. (2025, 18 de noviembre). Cboe to launch trading of Cboe Magnificent 10 Index futures and options on December 8 [Comunicado de prensa]. https://ir.cboe.com/news/news-details/2025/Cboe-to-Launch-Trading-of-Cboe-Magnificent-10-Index-Futures-and-Options-on-December-8/default.aspx

    Center for AI Safety. (2023, 30 de mayo). Statement on AI risk. https://www.safe.ai/work/statement-on-ai-risk

    Cerullo, M. (2026, 29 de julio). Workers at leading AI companies call for a slowdown in AI development. CBS News. https://www.cbsnews.com/news/slow-down-ai-development-sam-altman/

    ChinaTalk. (2024, 27 de noviembre). Deepseek: The quiet giant leading China’s AI race [Traducción de una entrevista a Liang Wenfeng realizada por An Yong para 36Kr en julio de 2024]. https://www.chinatalk.media/p/deepseek-ceo-interview-with-chinas

    CME Group. (2026, 30 de junio). CME Group to launch single stock futures on July 27 [Comunicado de prensa]. PR Newswire. https://www.prnewswire.com/news-releases/cme-group-to-launch-single-stock-futures-on-july-27-302814053.html

    Cook, L. D. (2026, 27 de mayo). The opportunities and risks AI presents for the economy and financial system [Discurso]. Board of Governors of the Federal Reserve System. https://www.federalreserve.gov/newsevents/speech/cook20260527a.htm

    DeepSeek-AI. (2025, febrero). Day 6: One more thing, DeepSeek-V3/R1 inference system overview [Documento de repositorio]. GitHub. https://github.com/deepseek-ai/open-infra-index/blob/main/202502OpenSourceWeek/day_6_one_more_thing_deepseekV3R1_inference_system_overview.md

    Duprey, R. (2026, 31 de enero). Is the stalled Nvidia-OpenAI megadeal AI’s first domino to fall? 24/7 Wall St. (vía Yahoo Finance). https://finance.yahoo.com/news/stalled-nvidia-openai-megadeal-ai-131959187.html

    Fernholz, T. (2026, 28 de julio). Sam Altman is ready to decelerate. TechCrunch. https://techcrunch.com/2026/07/28/sam-altman-is-ready-to-decelerate/

    Fung, K. (2023, 29 de marzo). The massive name in AI noticeably absent from pause letter signed by Musk. Newsweek. https://www.newsweek.com/massive-name-ai-noticeably-absent-pause-letter-signed-musk-1791303

    Future of Life Institute. (2023, 22 de marzo). Pause giant AI experiments: An open letter. https://futureoflife.org/open-letter/pause-giant-ai-experiments/

    Goel, S. (2026, 27 de abril). OpenAI just updated its principles. Here’s what changed since the original version, 8 years ago. Business Insider (vía AOL). https://www.aol.com/articles/openai-just-updated-principles-heres-041316000.html

    Goldman, S. (2023, 16 de mayo). In Senate testimony, OpenAI CEO Sam Altman agrees with calls for an AI regulatory agency. VentureBeat. https://venturebeat.com/ai/in-senate-testimony-openai-ceo-sam-altman-agrees-with-calls-for-an-ai-regulatory-agency

    Greenberg, G. (2026, 9 de enero). Advisors confront Magnificent 7 concentration risk in portfolios. InvestmentNews. https://www.investmentnews.com/equities/mag-7-for-tomorrow/264753

    Jadhav, A. (2025, 4 de noviembre). Nvidia, OpenAI, and the trillion-dollar loop. The Register. https://www.theregister.com/special-features/2025/11/04/nvidia-openai-and-the-trillion-dollar-loop/353799

    J.P. Morgan. (2026, 10 de agosto). Financing AI infrastructure and U.S. data centers. https://www.jpmorgan.com/insights/banking/capital-markets/financing-ai-infrastructure-data-centers

    Juniewicz, I. (2026, 5 de junio). The AI boom has doubled computing infrastructure’s share of US GDP. Epoch AI. https://epoch.ai/data-insights/ai-datacenter-share-gdp

    Korosec, K. (2026, 1 de junio). Anthropic files to go public. TechCrunch. https://techcrunch.com/2026/06/01/anthropic-files-to-go-public/

    Lipschultz, B., & Metz, R. (2026, 15 de agosto). Anthropic revenue surges to over $11.5 billion in second quarter. Fortune. https://fortune.com/2026/08/15/anthropic-revenue-q2-11-5-billion-ipo-investors/

    Lo, K. (2026, 6 de enero). Chinese AI unicorns beat Silicon Valley giants in race to go public. Rest of World. https://restofworld.org/2026/zhipu-ai-minimax-ipo/

    Luong, N. (2026, 23 de marzo). Two loops: How China’s open AI strategy reinforces its industrial dominance [Documento del grupo de trabajo de investigación]. U.S.-China Economic and Security Review Commission. https://www.uscc.gov/sites/default/files/2026-03/Two_Loops–How_Chinas_Open_AI_Strategy_Reinforces_Its_Industrial_Dominance.pdf

    Ma, J. (2026a, 13 de septiembre). Anthropic CEO Dario Amodei and AI whistleblower Jacob Coxon agree: Something terrifying could happen in a matter of months. Fortune. https://fortune.com/2026/09/13/anthropic-dario-amodei-ai-whistleblower-jacob-coxon-openai-sam-altman-recursive-self-improvement/

    Ma, J. (2026b, 12 de septiembre). Sam Altman confirms OpenAI won’t go public this year, saying an IPO now would come at an ‘ill-advised moment’ given AI safety concerns. Fortune. https://fortune.com/2026/09/12/sam-altman-openai-ipo-delay-ill-advised-moment-safety-concerns/

    Mann, T. (2026, 3 de agosto). China turns up the heat with open model blitz as US model makers panic. The Register. https://www.theregister.com/ai-and-ml/2026/08/03/china-turns-up-the-heat-with-open-model-blitz-as-us-model-makers-panic/5282526

    MarketScale Newsroom. (2026, 17 de agosto). AI data center debt is getting more expensive, and Meta’s $12.5 billion El Paso deal proves it. MarketScale. https://www.marketscale.com/industries/energy/ai-data-center-debt-is-getting-more-expensive-and-metas-125-billion-el-paso-deal-proves-it

    Metinko, C. (2024, 9 de enero). Artificial buildup: AI startups were hot in 2023, but this year may be slightly different. Crunchbase News. https://news.crunchbase.com/ai/hot-startups-2023-openai-anthropic-forecast-2024/

    METR. (2026, 26 de agosto). Brief independent investigation of agents’ behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident. https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/

    Microsoft. (2025, 18 de noviembre). Microsoft, NVIDIA and Anthropic announce strategic partnerships. Microsoft Corporate Blogs. https://blogs.microsoft.com/blog/2025/11/18/microsoft-nvidia-and-anthropic-announce-strategic-partnerships/

    Moadel, D. (2026, 29 de julio). Nebius drops 10%, CoreWeave sinks 9% as rising credit-swap costs hit the AI cloud trade. 24/7 Wall St. https://247wallst.com/investing/2026/07/29/nebius-drops-10-coreweave-sinks-9-as-rising-credit-swap-costs-hit-the-ai-cloud-trade/

    Mowshowitz, Z. (2026, 14 de septiembre). We must pace the frontier. Don’t Worry About the Vase. https://thezvi.wordpress.com/2026/09/14/we-must-pace-the-frontier/

    Nusca, A. (2025, 20 de agosto). Just don’t call it an AI bubble. Fortune. https://www.fortune.com/2025/08/20/just-dont-call-it-an-ai-bubble

    O’Donnell, G., Hollerith, D., & Ferré, I. (2026, 14 de septiembre). Stock market today: Dow, S&P 500, Nasdaq slip as chip stocks fall on AI warning. Yahoo Finance. https://finance.yahoo.com/markets/live/stock-market-today-monday-september-14-dow-sp-500-nasdaq-080559558.html

    OpenAI. (2018, 9 de abril). OpenAI charter [Copia alojada por ETO AGORA, Emerging Technology Observatory]. https://agora.eto.tech/instrument/767

    Park, L. (2026, 21 de agosto). Anthropic’s Q2 revenue overtook OpenAI for the first time – and reached its first positive operating income. Forkast News (vía Yahoo Finance). https://finance.yahoo.com/technology/ai/articles/anthropic-q2-revenue-overtook-openai-015716271.html

    Pichai, S. (2026, 4 de febrero). Q4 earnings call: Remarks from our CEO. The Keyword (Google). https://blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q4-2025/

    Reuters. (2025, 6 de septiembre). Report: OpenAI expects business to burn $115 billion through 2029. Yahoo Finance. https://finance.yahoo.com/news/openai-expects-business-burn-115-022035561.html

    Reuters. (2026, 26 de agosto). OpenAI agents hacked Hugging Face in 700-strong swarm, tried to cover tracks, investigations find. NBC News. https://www.nbcnews.com/tech/tech-news/openai-report-says-network-was-hacked-rogue-ai-agents-rcna594590

    Roberts, L. (2025, 20 de noviembre). Oracle and CoreWeave credit default swap spreads widening: Omen or jitters? Investing.com. https://www.investing.com/analysis/oracle-and-coreweave-credit-default-swap-spreads-widening-omen-or-jitters-200670506

    Roytburg, E. (2026, 14 de septiembre). Wall Street’s AI doomsday trade is here: Chipmakers sink while hyperscalers gain. Fortune. https://fortune.com/2026/09/14/ai-slowdown-stocks-nvidia-meta/

    Schepkov, V. (2025, 5 de noviembre). Nvidia’s Huang warns China will win AI race amid energy costs, regulations. Investing.com (vía Yahoo Finance). https://finance.yahoo.com/news/nvidia-huang-warns-china-win-223321776.html

    Shibu, S. (2025, 19 de agosto). OpenAI CEO Sam Altman thinks we’re in an AI bubble because investors are ‘overexcited’ about artificial intelligence. Entrepreneur. https://www.entrepreneur.com/business-news/openais-sam-altman-warns-overexcited-investors-ai-bubble/496081

    Shontell, A. (2026, 12 de septiembre). Exclusive: Sam Altman addresses AI doomsday fears in new interview. Fortune. https://fortune.com/2026/09/12/sam-altman-interview-ai-doomsday-safety-models-control-ipo-2027/

    Stanciuc, A.-M. (2026, 15 de agosto). Anthropic’s quarterly revenue passed $11.5bn, up more than 14-fold. The Next Web. https://thenextweb.com/news/anthropic-q2-2026-revenue-11-5-billion-operating-income

    Subran, L., Dejean, G., Hirt, A., Utermöhl, K., & Bartosch, M. (2026, 25 de marzo). What to watch. Allianz Research. https://www.allianz.com/content/dam/onemarketing/azcom/Allianz_com/economic-research/publications/specials/en/2026/march/2026_03_25_AI.pdf

    The White House. (2025a, 11 de diciembre). Ensuring a national policy framework for artificial intelligence [Orden ejecutiva 14365]. https://www.whitehouse.gov/presidential-actions/2025/12/eliminating-state-law-obstruction-of-national-artificial-intelligence-policy/

    The White House. (2025b, julio). Winning the race: America’s AI action plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf

    Thompson, B. (2026, 14 de septiembre). Pacing the frontier, AI’s digital limits, AI commissars. Stratechery. https://stratechery.com/2026/pacing-the-frontier-ais-digital-limits-ai-commissars/

    Tolomia, C. (2026, 16 de junio). OpenAI 2025 financials leaked: $38.5B loss ahead of IPO. Quartz (vía Yahoo Finance). https://finance.yahoo.com/markets/stocks/articles/openai-2025-financials-leaked-38-121508294.html

    Vinsel, L. (2026, 8 de febrero). You’re doing it wrong: Notes on criticism and technology hype [Reedición de un ensayo publicado en Medium en 2021]. Peoples & Things. https://peoples-things.ghost.io/youre-doing-it-wrong-notes-on-criticism-and-technology-hype/

    Wells, M. (2026). Will AI investments pay off? Econ Focus, primer y segundo trimestre de 2026. Federal Reserve Bank of Richmond. https://www.richmondfed.org/publications/research/econ_focus/2026/q1-q2_feature2

    Yildirim, E. (2025, 6 de noviembre). Nvidia CEO says China ‘will win’ the global AI race as the U.S. falls behind in energy. Gizmodo. https://gizmodo.com/nvidia-ceo-says-china-will-win-the-global-ai-race-as-the-u-s-falls-behind-in-energy-2000682396

    Zeoli, C. (2026, junio). China’s open-weight takeover. Wing Venture Capital. https://www.wing.vc/content/chinas-open-weight-takeover

    Zitron, E. (2026a, 21 de mayo). Anthropic’s “profitability” swindle. Where’s Your Ed At. https://www.wheresyoured.at/anthropics-profitability-swindle/

    Zitron, E. (2026b, 15 de junio). Exclusive: OpenAI losses increased nearly 8X in 2025, with spending hitting $34 billion. Where’s Your Ed At. https://www.wheresyoured.at/exclusive-openai-financials/
    14 de septiembre de 2026
  • Navier-Stokes, LLMs y la Propiedad de las Ideas

    Matemáticas · Inteligencia artificial · Ciencia abierta

    Navier–Stokes, LLMs y la propiedad de las ideas

    Qué afirma haber demostrado OpenAI, por qué el forzamiento externo sí cuenta y qué revela la disputa sobre el futuro social de las matemáticas.

    Una de las historias matemáticas más importantes y extrañas de los últimos años comenzó con un rumor. Dos investigadores, Tristan Buckmaster y Levent Alpöge, llevaban meses desarrollando una línea de trabajo sobre singularidades en ecuaciones de fluidos. OpenAI supo que algo importante estaba ocurriendo, desplegó miles de agentes de inteligencia artificial y, pocos días después, anunció una demostración de explosión en tiempo finito para las ecuaciones tridimensionales de Navier–Stokes.

    La noticia reúne todos los elementos necesarios para producir confusión: uno de los siete Problemas del Milenio, una demostración de 166 páginas, una formalización en Lean, alrededor de 10.000 agentes, 130.000 millones de tokens, acusaciones sobre crédito científico y datos privados, y una conversación que Buckmaster interpreta como presión contra su carrera. Para entenderla hay que resistir dos simplificaciones. La primera es que una gran cantidad de cómputo convierte automáticamente un resultado en comprensión científica. La segunda es que la presencia de una fuerza externa vuelve irrelevante la demostración. Ninguna de las dos es correcta.

    1. La pregunta fundamental

    Las ecuaciones de Navier–Stokes describen el movimiento de fluidos viscosos como el agua y el aire. No siguen una por una las moléculas. Tratan el fluido como un medio continuo y relacionan su velocidad, presión, viscosidad y fuerzas externas:

    ∂u/∂t + (u · ∇)u = −∇p + νΔu + f,    ∇ · u = 0 u es la velocidad; p, la presión; ν, la viscosidad; y f, una fuerza externa. La segunda igualdad expresa que el fluido es incompresible.

    En tres dimensiones sabemos construir soluciones débiles globales, es decir, soluciones que satisfacen las ecuaciones en un sentido generalizado. Lo que no sabíamos era si datos iniciales suaves producen siempre soluciones suaves para todo tiempo o si, en determinadas condiciones, la velocidad puede crecer sin límite en un tiempo finito. A ese colapso de regularidad se le llama singularidad o explosión.

    La viscosidad tiende a suavizar diferencias de velocidad. La no linealidad, representada por (u · ∇)u, transporta y reorganiza el movimiento. El problema nace de la competencia entre ambos efectos: ¿basta siempre la disipación viscosa para impedir una concentración infinita, o puede la dinámica tridimensional vencerla?

    Una precisión física

    Una velocidad matemática infinita no significa que un fluido real alcance literalmente esa velocidad. Significa que el modelo continuo pierde regularidad y deja de describir el proceso de la manera clásica. La pregunta es matemática, aunque esté motivada por la física.

    2. Qué exige realmente Clay

    Aquí aparece la primera corrección indispensable. El enunciado oficial redactado por Charles Fefferman ofrece cuatro vías. Las alternativas A y B piden probar existencia y suavidad global cuando la fuerza externa es cero, respectivamente en el espacio completo y en el toro tridimensional. Las alternativas C y D permiten refutar esa regularidad global mediante datos iniciales suaves y una fuerza externa también suave, en esos mismos dos dominios.

    AlternativaDominioFuerza externaQué habría que demostrar
    Aℝ³f = 0Existencia y suavidad global para todo dato inicial admisible.
    B𝕋³f = 0La misma regularidad global en el caso periódico.
    Cℝ³f suaveExistencia de datos y fuerza para los que no haya solución clásica global de energía acotada.
    D𝕋³f suaveEl correspondiente colapso en el caso periódico.

    Por tanto, llamar al forzamiento suave una «laguna» ajena al premio es técnicamente incorrecto. Está escrito en las alternativas C y D. Si la demostración de OpenAI es correcta y satisface exactamente las hipótesis declaradas, resolvería el problema oficial por esas vías.

    Pero esto no vuelve equivalentes todos los resultados. Producir una singularidad con una fuerza suave construida especialmente es una afirmación más limitada, desde el punto de vista físico y conceptual, que demostrar una singularidad sin fuerza externa. Resuelve la disyuntiva institucional formulada por Clay, pero no responde la pregunta más fuerte: si la dinámica no forzada puede romperse por sí sola. Ambas afirmaciones pueden sostenerse simultáneamente, sin trucos verbales.

    El forzamiento externo no invalida formalmente el resultado; sí delimita con precisión aquello que el resultado nos enseña sobre los fluidos.

    3. Qué afirma haber demostrado OpenAI

    El artículo de OpenAI construye, para cualquier viscosidad positiva, una velocidad y una presión suaves hasta un tiempo crítico, junto con una fuerza f(x,t) suave y de soporte compacto. El fluido parte del reposo. Al aproximarse el tiempo t = 1, la norma máxima de la velocidad crece sin límite, aunque la energía cinética total permanece uniformemente acotada.

    La imagen intuitiva es la de un vórtice que gira, se alarga y se concentra alrededor de una región cada vez más pequeña. La velocidad puede aumentar indefinidamente sin que la energía total explote porque el volumen ocupado por el movimiento extremo se contrae con suficiente rapidez. Una analogía imperfecta, pero útil, es concentrar una cantidad cada vez mayor de intensidad en un espacio cada vez menor.

    No basta con dibujar un flujo singular y definir después una fuerza infinita que lo sostenga. Eso sería trivial e inadmisible. La dificultad consiste en lograr que aceleración, presión, transporte no lineal y viscosidad desarrollen términos grandes que se cancelen con enorme precisión, dejando como residuo una fuerza externa perfectamente suave. El artículo introduce pulsos oscilatorios cuyo transporte interno de momento corrige las partes singulares de ese residuo.

    Alcance exacto del teorema anunciado
    • Sí: explosión de la velocidad en tiempo finito para Navier–Stokes tridimensional con viscosidad positiva y fuerza externa suave.
    • Sí: energía cinética total uniformemente acotada durante la evolución.
    • Sí, condicionalmente a la corrección de la prueba: alternativas C y D del enunciado oficial.
    • No: una demostración de explosión para Navier–Stokes sin forzamiento.
    • No todavía: aceptación independiente y estable por la comunidad matemática.

    4. Cómo trabajaron los agentes

    Según OpenAI, el 1 de septiembre puso a trabajar grupos de agentes sobre las distintas alternativas de varios Problemas del Milenio. Los agentes podían consultar una copia almacenada de internet, ejecutar código, dividirse en grupos y comunicar resultados. Cerca de cien agentes habrían producido primero una solución para Euler no forzado. A partir de ella, la empresa concentró los recursos en Navier–Stokes.

    El grupo decisivo llegó a involucrar del orden de 10.000 agentes simultáneos. OpenAI informa que el resultado apareció después de unas 88 horas; la formalización y verificación en Lean tomó 17 horas adicionales mediante GPT-6 Astra. Para Navier–Stokes se habrían intercambiado 2,7 millones de mensajes y generado aproximadamente 130.000 millones de tokens.

    Estos números no prueban comprensión ni la niegan. Describen una nueva organización material del trabajo intelectual: búsqueda paralela masiva, selección de rutas, circulación de resultados parciales, consolidación automática y verificación formal. Reducir esto a «mera fuerza bruta» oculta la arquitectura de coordinación; presentarlo como una conciencia matemática autónoma oculta el andamiaje humano, bibliográfico y computacional que hizo posible la búsqueda.

    5. La genealogía matemática

    La ruta no surgió en el vacío. Buckmaster atribuye la idea básica del programa a Diego Córdoba y Luis Martínez-Zoroa, quienes llevaban años estudiando explosiones forzadas y mecanismos de amplificación entre escalas. Su trabajo había mostrado cómo capas de vorticidad cada vez más concentradas podían amplificarse mientras se controlaba la regularidad de la fuerza.

    Buckmaster y Alpöge tomaron ese programa como punto de partida. Con ayuda intensa de Claude y Codex, afirman haber llevado construcciones con forzamiento menos regular hasta el forzamiento suave para medios porosos incompresibles, Boussinesq y Euler tridimensional incompresible. Según su comunicado, obtuvieron los resultados de Boussinesq y Euler el 15 de agosto y verificaron en Lean la primera prueba generada por un modelo el 22 de agosto.

    La contribución anunciada por OpenAI sería distinta y posterior: una construcción para Navier–Stokes viscoso. Aun si se hubiera obtenido de forma independiente, su significado histórico no puede narrarse como si 10.000 agentes hubieran encontrado, desde una hoja en blanco, tanto el problema como la estrategia. En matemáticas, la demostración final es solamente una parte del descubrimiento. Reconocer qué simplificación atacar, qué literatura importa y qué mecanismo puede sobrevivir a nuevas restricciones constituye trabajo intelectual real.

    6. Cronología de la disputa

    Fecha de 2026Acontecimiento declaradoFuente de la afirmación
    15 de agostoBuckmaster y Alpöge obtienen explosión con forzamiento suave para Boussinesq y Euler.Comunicado de Buckmaster.
    22 de agostoConcluye la verificación en Lean de su prueba inicial.Comunicado de Buckmaster.
    1 de septiembreOpenAI oye rumores y lanza agentes sobre los Problemas del Milenio.Relato de OpenAI.
    3 de septiembreBuckmaster escribe privadamente a un matemático de OpenAI para aclarar el rumor.Correo reproducido por Buckmaster.
    5 de septiembreLos agentes de OpenAI llegan a la construcción para Navier–Stokes, unas 88 horas después del inicio.Relato de OpenAI.
    6 de septiembreFinaliza la verificación formal de OpenAI y ocurren dos llamadas con Buckmaster.OpenAI y comunicado de Buckmaster.
    8 de septiembreOpenAI publica el artículo, la prueba y la formalización; Buckmaster hace público su comunicado.Publicaciones respectivas.

    La proximidad temporal alimenta la controversia. Buckmaster afirma que casi nadie trabajaba en esa ruta y que el énfasis repentino en el problema forzado fue para él una señal de alarma. OpenAI responde que distribuyó agentes entre las cuatro alternativas oficiales, obtuvo primero un resultado no forzado para Euler y solo entonces identificó Navier–Stokes como la dirección más prometedora.

    7. Lo probado y lo controvertido

    La discusión pública mezcla documentos verificables, relatos incompatibles e inferencias. Conviene separarlos.

    Mapa de evidencia
    • Documentado públicamente: existen un manuscrito analítico, una formalización en Lean, el comunicado de Buckmaster y el reconocimiento de OpenAI a la prioridad de Buckmaster y Alpöge sobre Euler forzado.
    • Afirmado por OpenAI: ningún investigador ni agente accedió a trabajo específico de ellos antes de su publicación; los agentes llegaron a resultados diferentes y la empresa no pretende reclamar el premio monetario.
    • Admitido por OpenAI como posibilidad remota: no puede excluir que datos desidentificados derivados del uso de sus productos hayan contribuido a mejorar sus modelos.
    • Afirmado por Buckmaster: no recibió respuesta clara sobre entrenamiento; se le propuso presentar solo el resultado de OpenAI y excluir a Alpöge por trabajar en Anthropic; además, recibió expresiones que interpretó como amenazas profesionales.
    • Disputado: Sébastien Bubeck rechaza la caracterización de Buckmaster sobre la interacción, según la síntesis pública citada.
    • No establecido públicamente: que los borradores privados fueran utilizados para producir la demostración de OpenAI o que existiera apropiación deliberada.

    El propio Buckmaster traza el límite: no ha visto cómo trabajó el modelo, no sabe si sus datos fueron usados y no formula esa acusación como un hecho probado. Su propósito declarado es registrar qué le dijeron, cuándo se lo dijeron y qué arreglos le propusieron. Esa cautela no elimina las preguntas; impide responderlas mediante una condena sin evidencia.

    La frase de OpenAI sobre datos desidentificados tampoco demuestra una transmisión causal desde esos borradores hasta la prueba. Sí revela una insuficiencia de gobernanza: para un investigador que deposita trabajo inédito en una herramienta, la imposibilidad de descartar influencia agregada puede ser científicamente inaceptable, aunque el tratamiento cumpla las condiciones contractuales del servicio.

    8. Qué verifica Lean y qué no verifica

    Lean es un asistente de demostración. Una prueba formalizada se descompone en pasos que un núcleo pequeño verifica contra reglas lógicas precisas. Esto reduce drásticamente la posibilidad de que sobreviva un salto algebraico, una hipótesis olvidada o una inferencia inválida. En un manuscrito de más de cien páginas, esa garantía es extraordinariamente valiosa.

    Pero Lean no responde por sí solo cuatro preguntas distintas:

    1. Correspondencia: que el teorema formalizado represente exactamente la afirmación matemática informal que se anuncia.
    2. Interpretación: qué significado físico tiene la construcción y cuánto depende de una fuerza diseñada.
    3. Novedad: qué ideas son nuevas y cuáles provienen de trabajos anteriores.
    4. Crédito: quién formuló la ruta, aportó los mecanismos decisivos, dirigió la búsqueda y debe figurar como autor.

    Una certificación lógica no sustituye una exposición humana. La comunidad todavía necesita leer el manuscrito, comprobar que la formalización coincide con el teorema pretendido, reconstruir el mecanismo conceptual y situarlo dentro de la literatura. La verificación formal fortalece la evidencia; no agota la práctica científica.

    9. El momento Deep Blue–Kaspárov

    Buckmaster llama al episodio un «momento Deep Blue–Kaspárov». La comparación no significa que la matemática sea simplemente otro juego con reglas cerradas. Señala un cambio en la división del trabajo: una máquina puede explorar, combinar y verificar a una escala temporal inaccesible para una persona, pero su productividad depende de que el espacio de búsqueda haya sido estructurado por problemas, teorías, bibliotecas formales y estrategias acumuladas históricamente.

    En un gran problema, el recurso escaso no siempre es escribir la última línea de la prueba. Puede ser identificar la ruta prometedora después de años de intentos fallidos. Si revelar esa ruta permite movilizar inmediatamente miles de agentes, entonces la selección del problema intermedio correcto adquiere un valor económico y científico enorme.

    Cuando demostrar se vuelve masivamente paralelizable, saber qué debe demostrarse puede convertirse en la parte más escasa del descubrimiento.

    Esto podría volver más reservada a la matemática abierta. Un seminario, un borrador informal o una consulta en una plataforma dejarían de ser solamente actos de cooperación y podrían transformarse en señales explotables por instituciones con una capacidad computacional incomparable. El peligro no es que la inteligencia artificial participe en la ciencia, sino que la apertura sea unilateral: conocimiento abierto desde abajo y capacidad de apropiación cerrada desde arriba.

    10. Una lectura materialista

    La controversia no se entiende únicamente como un conflicto moral entre individuos. Expresa una transformación de las fuerzas productivas de la ciencia. Modelos, centros de datos, sistemas multiagente y asistentes de prueba convierten enormes cantidades de trabajo matemático acumulado en una infraestructura capaz de producir nuevas combinaciones a gran velocidad.

    Al mismo tiempo, esa fuerza productiva está concentrada bajo propiedad privada. Los investigadores aportan preguntas, borradores, correcciones, usos y conocimiento tácito; la plataforma reúne esas interacciones, mejora modelos cerrados y puede devolver resultados con una escala que ningún grupo académico puede igualar. Aunque no haya existido una apropiación concreta en este caso, la asimetría estructural es real.

    Por eso la cuestión decisiva no es si la máquina «pensó de verdad», una disputa metafísica poco fértil. Hay que preguntar quién controló los medios de producción matemática, quién decidió la dirección de la búsqueda, de qué trabajo previo dependió, quién pudo auditar el proceso y cómo se distribuyeron autoría, prestigio y beneficios.

    El cómputo no es un pecado epistemológico. Puede constituir una auténtica fuerza de descubrimiento. Pero una fuerza productiva nueva, organizada mediante relaciones opacas de propiedad y crédito, puede ampliar simultáneamente la capacidad humana y la subordinación del trabajo científico.

    11. Qué reglas hacen falta

    El episodio sugiere un programa mínimo para la investigación asistida por inteligencia artificial:

    1. Modo confidencial verificable: los borradores inéditos deben quedar excluidos del entrenamiento y de cualquier recuperación posterior, con garantías auditables y no solamente contractuales.
    2. Proveniencia: todo resultado importante debería conservar un registro de modelos, versiones, fuentes consultadas, prompts decisivos, intervención humana y circulación entre agentes.
    3. Declaración de cómputo: cantidad de agentes, tokens, tiempo, herramientas y criterios de selección deben tratarse como parte del método.
    4. Genealogía conceptual: la atribución debe reconocer no solo la prueba final, sino también el programa previo que volvió visible la ruta.
    5. Autoría independiente de la rivalidad empresarial: la afiliación de un investigador no puede ser razón para excluirlo de una contribución científicamente pertinente.
    6. Revisión abierta: manuscrito, formalización y correspondencia entre ambos deben permanecer disponibles para examen independiente.
    7. Capacidad pública: universidades y consorcios científicos necesitan infraestructura compartida que evite que la matemática de frontera dependa exclusivamente de laboratorios privados.

    Estas normas no resolverían cada disputa de prioridad, pero volverían comprobables preguntas que hoy dependen de declaraciones institucionales enfrentadas.

    12. Conclusión

    ¿Resolvió OpenAI Navier–Stokes? La respuesta rigurosa es condicional. El teorema anunciado apunta exactamente a las alternativas C y D del enunciado oficial de Clay. El uso de una fuerza externa suave no es una trampa, aunque deja intacta la cuestión más fuerte del caso no forzado. Si la prueba analítica y su formalización resisten la revisión experta, el logro matemático sería histórico.

    Pero el resultado no nació fuera de la historia. Depende de décadas de análisis, de la ruta abierta por Córdoba y Martínez-Zoroa, del trabajo de Buckmaster y Alpöge y de una infraestructura computacional extraordinaria. Tampoco están resueltas las preguntas sobre datos, prioridad y presión institucional. Las alegaciones más graves deben investigarse, no repetirse como hechos ni disolverse mediante relaciones públicas.

    La lección más profunda es que la inteligencia artificial no elimina las relaciones sociales de la ciencia. Las vuelve más visibles. Cuanto más poderosa sea la capacidad automática de demostrar, mayor será la importancia de proteger la apertura, registrar la procedencia de las ideas y distribuir justamente el crédito. El futuro de las matemáticas no dependerá solo de lo que las máquinas puedan probar, sino de las instituciones mediante las cuales decidamos qué significa descubrir.

    Referencias

    Fuentes indicadas

    1. Julien Cadot, síntesis pública de la controversia.https://x.com/juliencdt/status/2097582940863471900
    2. Mehdi, crítica técnica, epistemológica y política al anuncio.https://x.com/bettercallmedhi/status/2097472336257863722
    3. Susan Zhang, reproducción del manuscrito y de la declaración de OpenAI sobre el trabajo concurrente.https://x.com/suchenzang/status/2097376584814432392
    4. Tristan Buckmaster, comunicado sobre los resultados y las conversaciones con OpenAI.https://cims.nyu.edu/~tristanb/statement.pdf
    5. Jasper, análisis matemático y síntesis de la disputa.https://x.com/zjasper/status/2097547276755619988

    Documentos técnicos primarios

    1. OpenAI, «On the Navier–Stokes Millennium Prize Problem».https://openai.com/index/navier-stokes-solution/
    2. OpenAI, «Finite Time Blowup for Navier–Stokes».Manuscrito analítico
    3. Charles L. Fefferman, formulación oficial del Problema del Milenio.Existence and Smoothness of the Navier–Stokes Equation
    4. OpenAI, formalización en Lean.https://github.com/openai/NavierStokesAndEuler
    ↑ Volver al inicio
  • EL HUNDIMIENTO DEL ANTI-MARX

    EL HUNDIMIENTO DEL ANTI-MARX

    Polémica · Economía política · 2022–2025

    El hundimiento del Anti-Marx

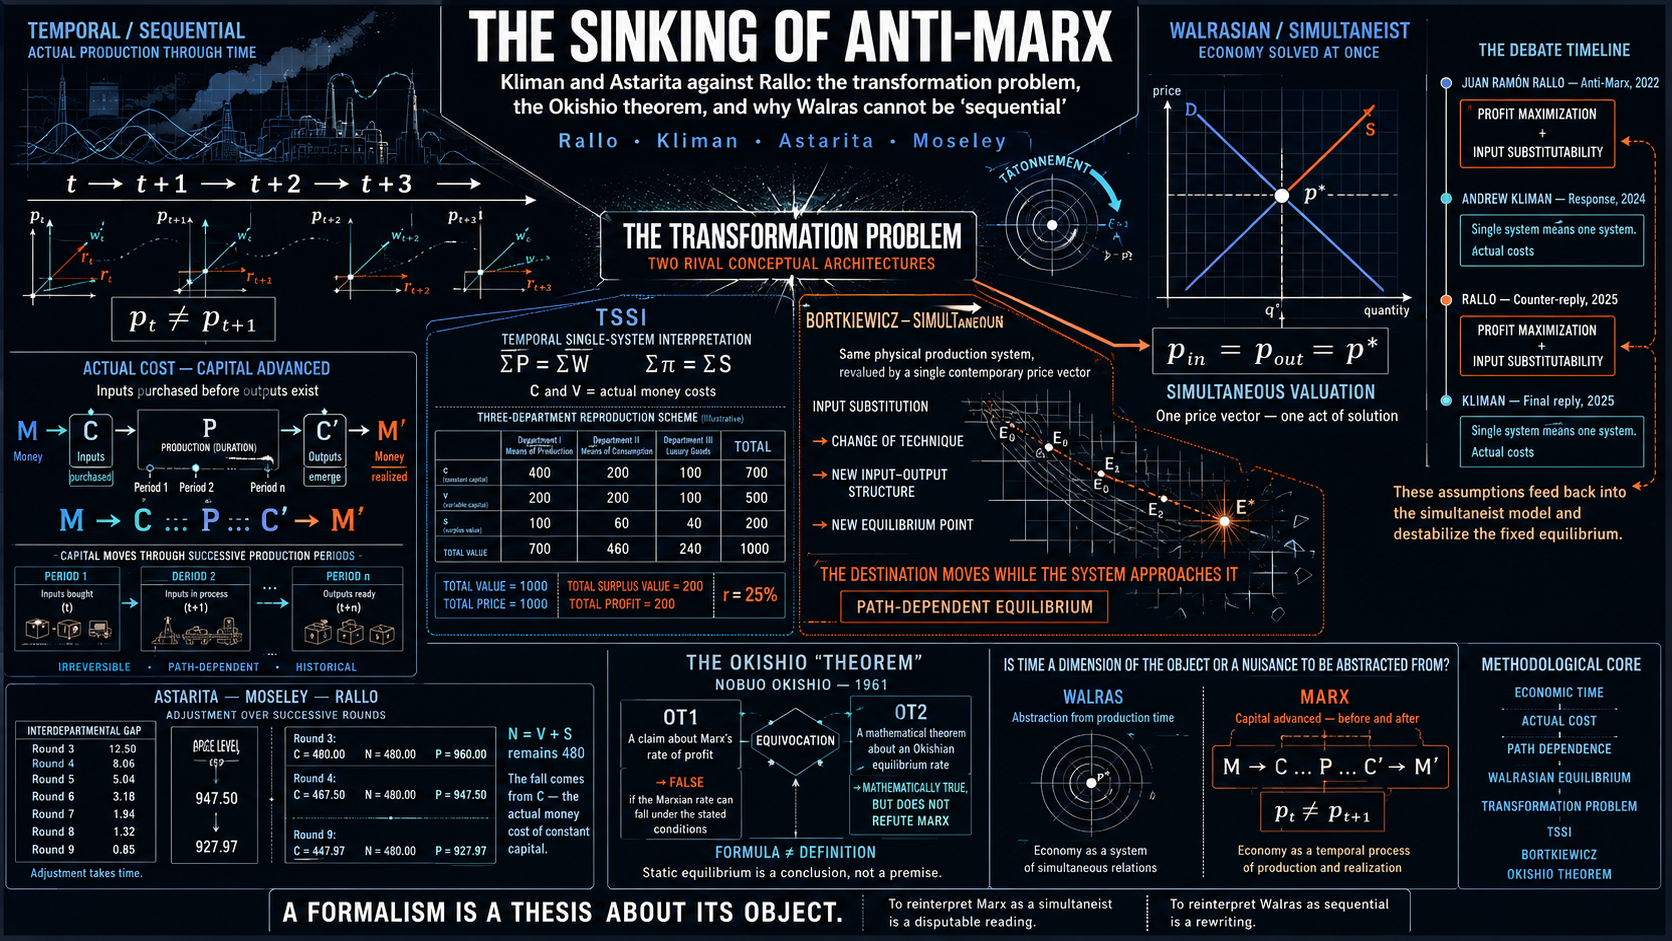
    Kliman y Astarita contra Rallo: la secuencia completa de una polémica sobre el problema de la transformación —y una réplica sobre por qué Walras no puede ser «secuencial».

    Entre 2022 y 2025 se desarrolló una polémica que casi nunca se lee completa. A finales de 2022, Juan Ramón Rallo publicó los dos tomos de Anti-Marx. Crítica a la economía política marxista, anunciados por la editorial como «la más ambiciosa crítica al marxismo escrita hasta la fecha». Andrew Kliman respondió en septiembre de 2024. Rallo replicó en abril de 2025. Kliman cerró en mayo de 2025. En paralelo, un año antes, Rolando Astarita había respondido a la crítica que Rallo dirige contra Fred Moseley, y Rallo le contestó al día siguiente.

    Lo que sigue es esa secuencia entera, ordenada por argumentos y no por fechas: primero lo que Rallo concede, después cada crítica suya en su núcleo conceptual, y a continuación la respuesta que recibió. Cuando hay contrarréplica, la contrarréplica va después, y el frente se cierra con la última palabra de quien respondió. Al final, mis propias réplicas.

    · · ·

    ILo que Rallo concede

    Conviene fijar primero lo que Rallo otorga, y no por cortesía: buena parte del argumento de Kliman se construye sobre esas concesiones, y sin ellas la discusión posterior resulta ininteligible. Kliman las destaca, además, porque son inusuales en la literatura anti-Marx: Rallo no las esconde ni las relativiza en nota al pie.

    Kliman fija el valor de estas admisiones con una condicional: sólo son irrelevantes si la demolición posterior funciona. Si no funciona, «no son concesiones sin sentido sobre una solución meramente matemática, sino concesiones significativas sobre una solución económica genuina». Todo el resto de la polémica es, en el fondo, la pregunta de si la demolición funciona.

    · · ·

    IIPrimer frente: valores y precios de producción

    Ronda 1 · Rallo (2022) · La crítica

    Núcleo conceptual. El temporalismo de sistema único produce, período tras período, precios relativos cambiantes entre capital constante y capital variable. Si los capitalistas maximizan ganancias y la elasticidad de sustitución entre medios de producción y fuerza de trabajo es distinta de cero, ese cambio de precios relativos los obliga a recombinar insumos: usar menos de lo encarecido y más de lo abaratado. Pero entonces las relaciones de producción del período siguiente no son las del período anterior, la oferta producida en t no coincide con la demanda de t+1, y la reproducción simple se rompe.

    De ahí la sentencia:

    La [interpretación temporal de sistema único] no es una solución económica al problema de la transformación, sino una mera solución matemática con apariencia de solución económica (puesto que es una solución matemática incoherente con las condiciones económicas que permitirían la reproducción simple del capital), mientras que las soluciones simultaneístas al problema de la transformación son soluciones que respetan el equilibrio macroeconómico pero a costa de sacrificar o la teoría del valor trabajo o la teoría de la explotación.

    Rallo, Anti-Marx, vol. 2, § 5.4.1

    La exigencia se ordena en cuatro condiciones que, según Rallo, toda solución debe cumplir a la vez: igualdad agregada valor = precio de producción; igualdad agregada plusvalía = ganancia; equilibrio estático (oferta = demanda sector por sector); y equilibrio dinámico, definido como «ausencia de incentivos, en la propia estructura de precios de producción, a modificar las relaciones de producción que ha engendrado esa estructura de precios de producción».

    Ronda 2 · Kliman (septiembre 2024) · La respuesta

    1. El argumento es un bumerán

    Kliman concede de entrada lo que hay que conceder: hay procesos productivos con proporciones fijas y otros con sustitución, y Rallo tiene razón en que existen los segundos. Concede también la conducta maximizadora. Y entonces muestra que, aceptadas esas dos premisas, el argumento no golpea sólo al temporalismo: golpea primero a Bortkiewicz.

    La razón es un error de identificación. Rallo confunde cambio de precios con precios determinados temporalmente. Cree que en las «soluciones» simultaneístas los precios no cambian, porque se fuerza que los precios de los insumos igualen a los de los productos. Pero la transformación, tal como Bortkiewicz, Sweezy y el propio Rallo la conciben, es el paso de un sistema en el que las mercancías se intercambian a sus valores a otro en el que se intercambian a sus precios de producción. Ese paso es, por definición, un cambio de precios relativos. Con maximización y sustitución, dispara exactamente la recombinación de insumos que Rallo exige, y por lo tanto rompe la reproducción simple.

    Kliman lo hace con los números del propio Bortkiewicz. En el «sistema en valores» el Departamento III usa la Técnica A (50 unidades del Bien 1 y 150 de trabajo vivo para 200 unidades de producto); en el «sistema en precios» el Bien 1 se encarece frente al salario, la Técnica B (10 unidades del Bien 1 y 225 de trabajo) pasa a ser la que minimiza costos, y las empresas cambian —como Rallo recomienda—. Resultado: la tasa de ganancia del Departamento III sube a 27,7 % contra 25 % en los otros dos, la demanda del Bien 1 cae por debajo de la oferta, el exceso de demanda del bien salarial aparece, y el «sistema en precios» deja de estar en equilibrio en cualquier sentido. Sus precios ya no son precios de producción, porque las tasas de ganancia no están igualadas.

    Si uno rechaza cualquier «solución» incompatible con la reproducción simple, debe rechazar no sólo la explicación de Marx, sino también la «corrección» de Bortkiewicz y toda solución simultaneísta existente y potencial.

    Y con esto cae, de paso, la formulación clásica de Sweezy —«pasar del cálculo del valor al cálculo del precio no tiene conexión con la pregunta sobre si el sistema económico como un todo es estacionario o en expansión»—: dadas las restricciones que el propio Rallo añade, pasar de uno a otro cálculo tiene todo que ver con esa pregunta.

    2. Qué es realmente un precio de producción en Marx

    El segundo movimiento es exegético y decide el resto. Marx trata por separado la formación de una tasa general de ganancia (cap. 9 del tomo III) y su igualación (cap. 10). Del mismo modo, la formación de los precios de producción es una cosa y los intercambios a precios de producción son otra. Los precios de producción existen siempre: como concepto en la cabeza de capitalistas y economistas, como parámetro de éxito, como objetivo mínimo de viabilidad y —sobre todo— como promedio a lo largo del tiempo de los precios de mercado que fluctúan alrededor de ellos.

    Rallo había escrito que «el concepto de precio de equilibrio a largo plazo carece de sentido en el marco de una economía que no está en equilibrio». Kliman responde con la analogía que más circuló de todo el intercambio:

    Esto es como decir que el concepto de tamaño promedio de una familia no tiene significado siempre que no haya una familia del tamaño promedio.

    El tamaño familiar promedio en Estados Unidos era, en 2022, de 3,13 personas. Ninguna familia tenía 3,13 integrantes.

    3. Dos conceptos de equilibrio

    De ahí la distinción que ordena todo el frente: hay equilibrio como estado de balance (oferta igual a demanda) y equilibrio como estado de reposo (que el futuro repita al pasado: precios estacionarios, reproducción simple, relaciones insumo-producto invariantes). Los precios de producción de Marx son precios de balance; no tienen por qué ser, y en general no son, precios de reposo. Exigir el reposo no es un requisito de la teoría: es una restricción adicional, y muchas veces un obstáculo, porque puede ser incompatible con la igualación de las tasas de ganancia.

    4. La generalidad del procedimiento

    El cierre es el que Kliman repetirá en 2025. Los datos con los que Marx calcula son las inversiones de capital, los componentes del precio de costo y los plusvalores. No están entre los datos las relaciones físicas insumo-producto, ni las cantidades físicas, ni el supuesto de que los precios de los insumos igualen a los de los productos, ni la reproducción simple. No están porque son irrelevantes para el cálculo.

    En resumen, el procedimiento de Marx es completamente general. No descansa en cualesquiera supuestos restrictivos.

    Kliman, 2024

    Al margen, Kliman desarma el intento de Rallo (§ 5.3.5 del tomo 2) de probar que la ley del valor no determina la tasa general de ganancia: lo que Rallo prueba, modificando cifras de Bortkiewicz, es que la ley del valor no determina la tasa del «sistema en precios» de Bortkiewicz, cosa que el propio Bortkiewicz proclamaba. Es una petición de principio: se parte de un modelo que presupone que Marx se equivocó, y se lo usa para probar que Marx se equivocó. Peor aún: esas tasas de ganancia son falsas, porque presuponen que todos los departamentos venden todo lo que producen, y eso no ocurre una vez que la sustitución de insumos rompe la reproducción simple.

    Ronda 3 · Rallo (13 de abril de 2025) · La contrarréplica

    1. «Kliman me da la razón sin querer dármela»

    Rallo toma una frase del cierre de Kliman —«sería fatuo requerir que resolvamos un problema que no tiene solución»— y la lee como una capitulación: si el problema no tiene solución, entonces el problema de la transformación no tiene solución, tampoco por la vía temporalista. QED.

    2. Las tres «excusas»

    Enumera los casos en los que, según Kliman, el temporalismo sí sería compatible con la reproducción simple, y los descarta uno por uno. Que los capitalistas no maximicen o que la sustitución sea imposible es, dice, admitir que no hay solución general —y basta con que algunos procesos admitan sustitución para que el problema reaparezca—. Que los intercambios ocurran a precios distintos de los de producción es inadmisible si, como el propio Kliman define, los precios de producción son el promedio de largo plazo de los precios de mercado. Y que insumos y productos se intercambien ambos a precios de producción es justamente el caso de Bortkiewicz, en el que —sostiene Rallo— la doble igualdad agregada no se mantiene.

    3. La dirección del procedimiento de Bortkiewicz

    El movimiento más ambicioso. Kliman se equivoca, dice Rallo, al leer el esquema de Bortkiewicz como una transición temporal del sistema en valores al sistema en precios. La solución simultaneísta es atemporal:

    La tabla I no es un antecedente temporal de la tabla II o de la tabla III; es un antecedente lógico […] existe una única estructura productiva derivada del sistema de precios de producción que puede expresarse / representarse / computarse en términos de valores (de horas de trabajo social).

    Rallo, 2025

    Si esto fuera así, la objeción de Kliman se desvanecería: no habría paso de una estructura productiva a otra, y por lo tanto no habría sustitución de insumos ni ruptura de la reproducción simple en el esquema de Bortkiewicz. Sólo la habría en el temporalismo.

    Ronda 4 · Kliman (15 de mayo de 2025) · El cierre

    1. La cita descontextualizada

    Kliman recoge la observación de Ángel Barroso: el pasaje citado «presenta a Kliman como si admitiera que el problema de transformación marxista no tiene solución, cuando en realidad está diciendo algo muy distinto». Lo que no tiene solución es el problema tal como Rallo lo formula, porque Rallo exige condiciones lógicamente incompatibles entre sí. No es lo mismo decir que un problema es insoluble que decir que una formulación es contradictoria.

    2. La demostración de cinco líneas

    Kliman decide no discutir metodología y probar el resultado directamente. En cualquier período, para cualquier sector j:

    (1)   Wj = Cj + Vj + Sj      (2)   Pj = Cj + Vj + πj

    (3)   ∑Pj = ∑Wj    por la demostración del cap. 5 del tomo I: el intercambio redistribuye valor, no lo crea

    (4)   ∑Cj + ∑Vj + ∑πj = ∑Cj + ∑Vj + ∑Sj  ⇒  (5)   ∑πj = ∑Sj

    Y como el denominador es el mismo capital invertido, la tasa de ganancia «en precio» iguala a la tasa «en valor».

    La clave está en la definición de C y V: son el costo real de los medios de producción consumidos y de la contratación de los trabajadores. No hay un capital constante que valga el valor de los medios de producción y otro que valga lo que se pagó por ellos. Sistema único quiere decir un solo sistema. Ninguna restricción de caso especial interviene en la derivación; por lo tanto ningún caso especial puede invalidarla. Refutar las igualdades exigiría refutar la demostración del capítulo 5 del tomo I —cosa que ni Bortkiewicz ni Rallo intentaron—.

    3. Las igualdades se cumplen incluso en el caso de Rallo

    Kliman toma el «equilibrio dinámico» de Rallo —que rebautiza equilibrio estático, porque de dinámico no tiene nada: «el equilibrio sin movimiento de un cuerpo muerto, eternamente en descanso»— y las cifras exactas de la página 204 de Bortkiewicz. Leídas como un solo sistema, con C y V tomados como los costos monetarios efectivamente desembolsados, dan:

    Sistema único, sobre las cifras del propio Bortkiewicz
    Depto.CVSWπPS/(C+V)π/(C+V)
    I28896604449648015,6 %25,0 %
    II128128803366432031,3 %25,0 %
    III6496602204020037,5 %25,0 %
    Total4803202001000200100025,0 %25,0 %

    Precio total 1000 = valor total 1000; ganancia total 200 = plusvalía total 200; tasa «en precio» 25 % = tasa «en valor» 25 %. Las tres igualdades se cumplen dentro del caso que Rallo construyó para que no se cumplieran. Y se vuelven a cumplir en un caso con los mismos datos físicos pero precios distintos, no estacionarios y sin reproducción simple; y en el período 14 de la tabla 1 de Kliman y McGlone (1988), que Rallo cita en su propio libro.

    El error diagnosticado es de una precisión incómoda: Rallo no compara el precio y la ganancia del sistema único contra el valor y la plusvalía del sistema único. Compara las cifras de precio del «sistema en precios» de Bortkiewicz contra las cifras de valor de un «sistema en valores» separado, que el temporalismo de sistema único rechaza por completo. Está evaluando una interpretación de sistema único con el instrumental de una de sistema dual.

    4. Los tres casos «muy excepcionales» agotan el universo

    Rallo llamó «supuestos muy excepcionales» a los tres casos que Kliman había enumerado. Kliman los cruza en una tabla de dos entradas —intercambio a precios de producción sí/no, contra maximización con sustitución sí/no— y muestra que los tres, tomados en conjunto, cubren todas las combinaciones posibles. La retórica de la excepcionalidad ocultaba una enumeración exhaustiva.

    5. La evidencia textual sobre Bortkiewicz

    Frente a la afirmación de Rallo sobre la dirección del procedimiento de Bortkiewicz, Kliman pregunta por la evidencia y responde: no hay ninguna. Ni citas, ni paráfrasis, ni referencias de página. La justificación de Rallo es que la alternativa le resulta «impensable». Kliman contrapone seis apoyos textuales de las páginas 199–205: Bortkiewicz dice que procederá sin invertir la vía de presentación de Marx; enuncia como tercer supuesto limitante «asumiremos reproducción simple», sin restringir su alcance; declara que sus ecuaciones (1)–(3) satisfacen «las condiciones de la reproducción simple»; escribe que «el problema ahora es convertir estas expresiones de valor en expresiones de precio» y anuncia su «transición correcta de cantidades de valor a cantidades de precio»; y obtiene sus expresiones de precio multiplicando las de valor por las razones precio/valor de cada departamento —es decir, dejando intactas las cantidades físicas del sistema en valores y revaluándolas—.

    Toda la historia de Rallo sobre cómo procede Bortkiewicz es un invento.

    6. Y da igual la dirección

    El movimiento final es el que cierra todas las salidas. Supongamos, dice Kliman, que Rallo tuviera razón y la transición fuera de precios a valores. Se obtiene lo mismo: un cambio de precios relativos que induce sustitución de insumos, desequilibrio entre ofertas y demandas y ruptura de la reproducción simple. La economía del «sistema en valores» resulta físicamente distinta de la del «sistema en precios», y comparar sus agregados es comparar el precio total de Polonia con el valor total de Rusia. Si en cambio se lee la tabla I como un experimento mental —un antecedente meramente lógico—, el experimento viola la propia restricción de sustitución que Rallo impuso: con insumos sustituibles, el cambio imaginario de precios induce una sustitución imaginaria y una ruptura imaginaria de la reproducción simple. Manzanas reales contra naranjas imaginarias. Y si se abandona la maximización para evitarlo, los capitalistas del sistema imaginario optimizarán otra cosa, o nada, y tampoco tendrán incentivo alguno para sostener la estructura física del otro sistema.

    La raíz del problema es que Rallo impuso la restricción de sustitución de insumos por encima de la de reproducción simple. En una transición de un conjunto de precios relativos a otro, estas dos restricciones son simplemente incompatibles.

    Kliman, 2025

    El conjunto completo de restricciones de Rallo sólo puede satisfacerse en un caso: cuando los precios relativos son estacionarios. El temporalismo de sistema único puede satisfacerlo, porque es compatible con precios estacionarios —lo acabamos de ver en la tabla—. Las soluciones simultaneístas no pueden, porque tal como conciben la transformación, ella misma es un cambio de precios relativos.

    · · ·

    IIISegundo frente: el «teorema» de Okishio

    Ronda 1 · Rallo (2022) · La crítica

    Núcleo conceptual. Rallo reproduce el ejemplo numérico de Kliman y obtiene, en efecto, una tasa general de ganancia decreciente con composición orgánica creciente y salario real constante. Pero sostiene que eso no refuta nada, porque el temporalismo «lo que realmente hace […] es estimar una tasa general de ganancia distinta de la que estima el propio Teorema de Okishio». Y añade la premisa decisiva: «Recordemos que el Teorema de Okishio definía la tasa general de ganancia como aquel valor que permitía igualar intratemporalmente (en cada período t) los precios de equilibrio de los inputs y de los outputs». Si esa es la definición, entonces calcular otra tasa no refuta el teorema: cambia de tema.

    Ronda 2 · Kliman (septiembre 2024) · La respuesta

    1. Una fórmula no es una definición

    La afirmación es falsa de hecho: los escritos de Okishio y de Roemer no contienen tal definición. Contienen fórmulas en las que los precios de insumos y productos son iguales, que no es lo mismo. «La definición de un objeto matemático está dada por […] enumerar las propiedades que se requiere que el objeto tenga»; las fórmulas no son listas de propiedades requeridas. El carácter de equilibrio estático de la tasa okishiana es una conclusión del teorema, no una premisa —algo que Okishio y Roemer afirmaron haber deducido, no algo que estipularon—. Kliman ya lo había explicado en la página 118 de Reclaiming Marx’s «Capital»; Rallo no responde a esa explicación.

    2. La carga de la prueba

    Aquí está el corazón. El «teorema» es una afirmación sobre la tasa de ganancia de Marx: Okishio escribió que «nuestras conclusiones son negativas a la Marxian Gesetz des tendenziellen Falls der Profitrate». Por lo tanto, la carga de probar recae sobre quien afirma que esa tasa no puede caer. Y, correlativamente, quien refuta el teorema sólo tiene que mostrar que la tasa definida como la define Marx puede caer bajo las condiciones en que el teorema dice que no puede. No tiene que mostrar que su tasa satisface la definición preferida de Okishio, ni la de Rallo. Definir la tasa de ganancia como una tasa de equilibrio estático desplaza ilícitamente la carga de la prueba. Y es evidente que Marx nunca definió la tasa general de ganancia como el valor que iguala intratemporalmente los precios de equilibrio de insumos y productos.

    3. La equivocación OT1 / OT2

    Kliman recupera su análisis de la maniobra de Robin Hahnel, que Rallo repite. Hay dos teoremas distintos que se invocan alternativamente bajo el mismo nombre. OT1 es un teorema sobre el capitalismo real, que afirmaría que el cambio técnico ahorrador de trabajo no reduce por sí mismo la tasa de ganancia; es falso. OT2 es un teorema puramente matemático, sin fallas lógicas, cuya «tasa de ganancia» es un objeto matemático y no la tasa del capitalismo real; es verdadero pero inofensivo. Usar el mismo término en dos sentidos dentro del mismo argumento es una equivocación, y una equivocación invalida el argumento.

    Como libertario, Rallo quiere ser libre de elegir. No tengo interés en restringir tal libertad. Así que, Dr. Rallo: ¿qué será, OT1 u OT2? Es su elección. Yo sólo insisto en que no puede tener ambas vías.

    Kliman, 2024

    Kliman señala además que el largo análisis de Rallo sobre la convergencia de la tasa temporal hacia la tasa okishiana si la productividad dejara de crecer para siempre no trata del asunto en discusión: trata de las condiciones contrarias a aquellas sobre las que versa el teorema. Y anota la asimetría de criterio: quien es escrupuloso con el realismo de los supuestos tecnológicos cuando se trata de la sustitución de insumos se despreocupa por completo de ese realismo cuando se trata de la productividad creciente.

    No hay contrarréplica en este frente. Rallo anunció en abril de 2025 que analizaría los argumentos contra el teorema de Okishio en un texto posterior; su réplica de ese mes se limita al problema de la transformación y tampoco comenta directamente la demolición de su intento de refutar la ley del valor.

    · · ·

    IVAstarita contra Rallo: Moseley y el tiempo económico

    Un año antes del intercambio con Kliman, Rolando Astarita había respondido a la crítica que Anti-Marx dirige contra Fred Moseley. La tesis de Moseley es que no hace falta transformación alguna de los valores de los insumos, porque los capitalistas siempre los adquieren a sus precios de producción —o a precios de mercado que giran en torno a ellos—, y porque las variables se determinan secuencialmente y no de manera simultánea. Si eso es correcto, la objeción de Böhm-Bawerk, pilar de casi todo el discurso anti-Marx, se derrumba.

    Ronda 1 · Rallo (2022) · La crítica a Moseley

    Núcleo conceptual. Rallo concede que en el esquema de Moseley, con insumos y productos ya en precios de producción, hay equilibrio interdepartamental: IIc = Iv + Ib = 190. Pero sostiene que el equilibrio es frágil. Si varía la tasa de ganancia —por ejemplo, si los salarios suben 20 % y la tasa cae de 33 % a 25 %—, varían los precios del capital constante y del variable, y el equilibrio se rompe: IIc = 190 mientras que Iv + Ib = 177,5, una diferencia de 12,5. Conclusión: el método secuencial de Moseley debe ser reemplazado por la resolución simultánea de un sistema de ecuaciones, a la manera de Bortkiewicz.

    Ronda 2 · Astarita (19 de marzo de 2023) · La respuesta

    1. El tiempo económico no se anula por decreto

    En la realidad, los capitalistas adquieren el capital constante y la fuerza de trabajo a precios de producción, de modo que lo que hacen se aproxima al método secuencial. No existe una resolución simultánea de los precios de insumos y productos: suponerla equivale a anular el tiempo económico. Se puede conceder el uso de ecuaciones simultáneas en circunstancias determinadas y explicitando las condiciones; pero cuando hay un cambio de variables tan grande como un aumento salarial del 20 %, no hay manera de pasar por alto los desequilibrios y las dinámicas de ajuste que le siguen. Moseley, en comunicación personal, lo dice sin rodeos: producido el cambio, «habrá un proceso de ajuste hacia el nuevo equilibrio que insumirá algún tiempo».

    Pensar en una economía en que se establecen de manera instantánea nuevos precios de equilibrio equivale a hacer abstracción de los movimientos reales, inherentes a un sistema económico en que la ley del valor se impone a través de permanentes oscilaciones y contradicciones.

    Astarita, 2023

    2. La contradicción austríaca

    El segundo movimiento es ad hominem en el sentido legítimo del término: señala una incoherencia entre la posición sostenida y el marco desde el que se la sostiene. Suprimir los desequilibrios recurriendo a un sistema de ecuaciones es volver a la desaparición del tiempo económico que Walras ejecutó en la lección 20 de los Elementos de economía política pura, donde no sólo se deciden simultáneamente los planes de producción y los precios de los servicios, sino que la producción ocurre instantáneamente. Y lo dice el propio Walras:

    La producción exige cierto plazo. Resolvemos esta segunda dificultad haciendo pura y simplemente abstracción de dicho plazo.

    Walras, Elementos de economía política pura, lección 20

    Astarita subraya la paradoja: es un austríaco quien recomienda el enfoque walrasiano, cuando la propia escuela austríaca ha sido su crítica más constante. Cita a Huerta de Soto contra «los negativos efectos que el formalismo matemático y la perniciosa obsesión por los análisis basados en la plena información y en el equilibrio han tenido sobre el desarrollo de nuestra ciencia», y su llamado a sustituirlo por «una teoría de los precios que explique cómo éstos se forman dinámicamente como resultado de un proceso secuencial y evolutivo […] y no por la intersección de misteriosas curvas o funciones carentes de toda entidad real». De ahí la pregunta: «¿O es que a la hora de criticar a los marxistas todo vale?»

    3. El desequilibrio se cierra solo

    El tercer movimiento es aritmético. Astarita toma el desequilibrio que Rallo exhibe como prueba del fracaso y lo hace correr por el método secuencial: los precios de producción de cada ronda entran como precios de los insumos de la siguiente. La brecha entre IIc y Iv + Ib se comporta así:

    Cierre secuencial del desequilibrio interdepartamental
    Ronda3456789
    Brecha12,508,065,043,181,941,320,85
    Tasa de ganancia25,00 %25,41 %25,86 %25,90 %26,04 %26,08 %

    Tendencialmente, los precios de producción se acercan a los precios de equilibrio entre los sectores. Pero no se trata de una solución instantánea. Hay proceso, el tiempo cuenta.

    Astarita, 2023

    Ronda 3 · Rallo (20 de marzo de 2023) · La respuesta

    1. Walras como punto, no como instante

    Que yo sea austriaco no significa que acepte todos los argumentos que plantea la Escuela Austriaca. […] el equilibrio walrasiano no es relevante porque deba necesariamente mostrarnos un ajuste instantáneo de todas las variables económicas, sino porque nos muestra el punto de equilibrio hacia el que tenderemos secuencialmente a acercarnos a través del mercado. Por tanto, si hay perturbaciones en el mercado, lo único que cambia es el punto de equilibrio hacia el que deberá ajustarse el sistema. Esto no equivale a sostener que el sistema se ajuste instantáneamente (por mucho que ciertamente Walras se despreocupara de exponer ese crucial proceso de ajuste).

    Rallo, 2023

    2. La concesión que se vuelve arma

    Si los insumos se compran y venden a sus precios de producción y no a sus valores, entonces las perturbaciones de la tasa general de ganancia alteran el precio de esos insumos y, por lo tanto, el equilibrio interdepartamental. Cosa que —señala Rallo— Astarita reconoce al exponer cómo el mercado alcanza secuencialmente un nuevo equilibrio.

    3. El agregado que no vuelve

    El golpe real. La solución secuencial pone de manifiesto que sí existe problema de transformación, porque el nuevo agregado de precios de producción —927,97 en la tabla 9 de Astarita— no coincide ni converge con el agregado inicial de 960. Y si, como dice Marx, la suma de los precios de producción del producto social total debe igualar la suma de sus valores, y no hubo ningún cambio en el tiempo de trabajo social de esa economía —sólo cambió la tasa de plusvalía—, entonces el agregado tampoco debería haber cambiado. Cambió. Luego la solución de Moseley no es tal.

    Nota editorial: el intercambio continuó. Astarita publicó una «Respuesta a la respuesta de Rallo» y Rallo sumó hasta una cuarta contrarréplica. Corto la exposición en esta ronda porque es la que cierra el argumento sobre el que quiero intervenir; el hilo posterior no altera la estructura conceptual del desacuerdo.

    · · ·

    VMis réplicas

    Réplica I. Walras no es secuencial: el compromiso ontológico del formalismo

    La defensa que Rallo opone a Astarita es de una economía admirable: el equilibrio walrasiano —dice— no pretende mostrarnos un ajuste instantáneo de todas las variables, sino el punto hacia el cual el sistema tiende secuencialmente; si hay perturbaciones, lo único que cambia es el punto de destino. En dos oraciones, el simultaneísmo queda reconvertido en una teoría del proceso. Sostengo que esa reconversión no es una precisión: es un error conceptual, y de los que importan.

    1. Lo que una teoría declara de sí y lo que su formalismo compromete

    Empiezo por el punto de método, porque de él depende todo lo demás. Que para una consideración subjetiva del autor el ajuste instantáneo sea o no «lo relevante» es indiferente para la evaluación de la teoría. Una teoría no es lo que su expositor declara acerca de ella; es lo que su aparato hace. En la práctica científico-teórica, y muy especialmente en el terreno formal, el compromiso ontológico de una formulación no se negocia por vía de glosa: si el sistema de ecuaciones valúa insumos y productos con un solo vector de precios, entonces el sistema afirma esa identidad, cualquiera sea la interpretación que el autor prefiera darle después. Hay una diferencia entre autointerpretación y compromiso operativo, y toda la maniobra de Rallo consiste en hacer valer la primera contra el segundo.

    2. Qué es exactamente el simultaneísmo

    Conviene ser preciso, porque aquí se juega la solidez del argumento. El simultaneísmo no consiste en usar un sistema de ecuaciones: un sistema de ecuaciones en diferencias es también un sistema, y es enteramente temporal. Lo que define al simultaneísmo es otra cosa, y es perfectamente formalizable:

    Un sistema es simultaneísta si y sólo si valúa los insumos y los productos de un mismo período de producción con uno y el mismo vector de precios; es decir, si su aparato carece de un índice temporal que distinga pt de pt+1.

    Es temporalista si y sólo si ese índice existe y opera: los precios a los que se compran los insumos al inicio del período no están obligados a coincidir con los precios de los productos que salen al final.

    Con este criterio, el sistema walrasiano es simultaneísta en sentido estricto, y no por una lectura hostil: porque en él la determinación de todos los precios y todas las cantidades es un solo acto de resolución, sin índice temporal que separe la valuación de entrada de la de salida. Lo que Rallo llama «el punto hacia el que tenderemos secuencialmente a acercarnos» es, en el aparato, la solución del sistema; y la solución del sistema es el objeto que el aparato determina, no un destino al que el aparato describa aproximarse.

    3. La confesión del propio Walras

    No hace falta ni siquiera reconstruir el compromiso: está declarado. En la lección 20 de los Elementos, Walras enuncia el problema y lo resuelve por eliminación: «La producción exige cierto plazo. Resolvemos esta segunda dificultad haciendo pura y simplemente abstracción de dicho plazo». Y de ahí se sigue que «los servicios productivos pueden transformarse instantáneamente en productos». Esto no es una consecuencia que le imputen sus adversarios: es la decisión metodológica que el autor toma, explicita y justifica. Llamar «secuencial» a un sistema cuyo constructor declaró haber suprimido el plazo de producción no es una interpretación generosa; es una descripción falsa.

    Se dirá que el tâtonnement aporta la secuencialidad faltante. No la aporta. El tanteo walrasiano es un procedimiento de recontratación previa en el que, por construcción, no se ejecuta ningún intercambio a precios de desequilibrio y no transcurre ningún proceso productivo: es una metáfora computacional del acto de resolver el sistema, no un proceso en tiempo económico. El tanteo describe cómo se halla la solución, no cómo se mueve una economía. Confundir ambas cosas es exactamente el desliz que denuncio.

    4. La simetría, y por qué en realidad es peor

    Llamar «secuencial» al sistema walrasiano tiene una contrapartida exacta en la operación inversa: empaquetar a Marx como simultaneísta y ponerlo en la misma bolsa que Walras y Sraffa. Marx fue materialista histórico; el tiempo no es en su análisis una dimensión prescindible, trivial o secundaria, sino la forma misma en que el objeto existe. El circuito D–M…P…M’–D’ está irreversiblemente ordenado; el capital adelantado precede al valor producido; el procedimiento del capítulo 9 del tomo III calcula precios de producción a partir de precios de costo y plusvalores dados, sin forzar en ningún punto la igualdad entre precios de insumos y precios de productos; y las páginas sobre desvalorización moral del capital fijo sólo son inteligibles si la valuación de lo ya existente puede cambiar después de haber sido adelantada. Leer todo eso como un sistema atemporal es sobrealcance.

    Pero la simetría se rompe, y se rompe en contra de Rallo. En el caso de Marx hay un hueco interpretativo real: Marx no escribió un sistema de ecuaciones, de modo que el formalismo simultaneísta se lo impone el intérprete, y por eso puede haber discusión sobre si la imposición es fiel. En el caso de Walras no hay hueco alguno: Walras escribió sus ecuaciones. Por eso las dos operaciones no son equivalentes en gravedad.

    Reinterpretar a Marx como simultaneísta es una lectura discutible. Reinterpretar a Walras como secuencial es una reescritura.

    5. El dilema: o referencia o determinación

    Hay además un problema de coherencia interna que la formulación de Rallo no puede absorber. Recordemos qué le exigía a Moseley: no que reconociera un punto de referencia, sino que reemplazara el método secuencial por la resolución simultánea a la manera de Bortkiewicz. Es decir, le exigía que adoptara el sistema simultáneo como método de determinación de los precios de producción. Entonces:

    • Si el equilibrio walrasiano es sólo un punto de referencia hacia el cual el sistema tiende, no puede ser el método de determinación que debía reemplazar al de Moseley —porque un atractor no determina la trayectoria, y la pregunta de Moseley es precisamente cómo se determinan los precios a los que efectivamente se compran los insumos—.
    • Si es el método de determinación, entonces sí afirma la simultaneidad que Rallo dice no afirmar, y la objeción de Astarita queda en pie sin necesidad de una sola línea más.

    Rallo necesita las dos cosas a la vez. Es la misma estructura que Kliman le señala en el otro frente: no se puede tener razón en ambos sentidos.

    6. El blanco móvil: sus propias restricciones destruyen la fijeza del punto

    Este es, a mi juicio, el punto decisivo, y es enteramente interno a su posición. La defensa «punto fijo más aproximación secuencial» sólo funciona si el punto de equilibrio puede determinarse con independencia de la trayectoria. Pero Rallo es, en toda la polémica con Kliman, quien más insiste en dos supuestos: los capitalistas maximizan y los insumos son sustituibles. Combinados, esos dos supuestos implican que cada cambio de precios relativos induce un cambio de técnica; cada cambio de técnica altera la estructura insumo-producto; y una estructura insumo-producto alterada define un punto de equilibrio distinto. El destino se desplaza mientras el sistema se aproxima a él.

    Dicho de otro modo: bajo las restricciones de Rallo, el equilibrio es dependiente de la trayectoria. Y un equilibrio dependiente de la trayectoria no es un equilibrio walrasiano; es, precisamente, lo que una determinación temporal describe. Kliman formula el mismo resultado desde su lado: cuando las curvas de oferta y demanda se desplazan en respuesta a los cambios de precios que ellas mismas provocan, «deja de haber un único precio de equilibrio», y cada precio que realiza la tasa media de ganancia con oferta igual a demanda es un precio de producción correcto. La sustitución de insumos, invocada para hundir al temporalismo, hunde antes la fijeza del punto walrasiano.

    7. Corolario aritmético: el agregado de 927,97

    Queda por atender el golpe final de Rallo contra Astarita: que el agregado de precios de producción cae de 960 a 927,97 sin que haya cambiado el tiempo de trabajo social, y que por lo tanto la igualdad marxista se viola. Este argumento presupone que la magnitud de valor total está fijada por el tiempo de trabajo con independencia de los costos monetarios efectivamente adelantados. Eso es, exactamente, una premisa de sistema dual —la misma que Kliman diagnostica en 2025—, y basta con hacer la aritmética para verlo.

    En una lectura de sistema único, el precio total del producto es el capital constante efectivamente desembolsado más el nuevo valor creado por el trabajo vivo. Con los números de las propias tablas de Astarita:

    Ronda 3 :   C = 480,00  +  N = 480,00  →  P = 960,00

    Ronda 4 :   C = 467,50  +  N = 480,00  →  P = 947,50

    Ronda 9 :   C = 447,97  +  N = 480,00  →  P = 927,97

    N = V + S se mantiene en 480 en todas las rondas, tal como Astarita explicita: el valor agregado de conjunto no cambia. Lo único que cae es C, y el agregado cae exactamente en esa misma magnitud.

    La igualdad agregada no se viola en ninguna ronda: se cumple idénticamente en todas, porque el valor total es C + N con C medido en dinero efectivamente adelantado. Lo que cambia es el agregado, y cambia por la razón correcta: cayó el costo monetario de los medios de producción sin que cayera el tiempo de trabajo incorporado en ellos. Exigir que el agregado permanezca en 960 es exigir que el capital constante se contabilice por su valor incorporado y no por su costo real —es decir, es exigir dos sistemas donde hay uno—. El golpe de 2023 contra Astarita y el error que Kliman diagnostica en 2025 son el mismo error, con dos años de diferencia.

    Precisión debida: Kliman clasifica la lectura de Moseley entre las de sistema único simultáneas, y no entre las temporales, mientras que Astarita subraya en ella la determinación secuencial. La discrepancia es real y no la disimulo. Pero el corolario que acabo de exponer no depende de esa diferencia: depende sólo de la premisa de sistema único, que Moseley, Astarita y Kliman comparten y que Rallo, en los dos frentes, no aplica.

    · · ·

    Réplica II. Sobre las igualdades agregadas

    Acá no tengo mucho que agregar, y decirlo es parte del argumento. La objeción de Rallo —que en el caso de doble equilibrio la doble igualdad agregada no se mantiene— ya fue respondida de la única manera en que se responde algo así: derivándola de las premisas sin ninguna restricción de caso especial, y después verificándola dentro del caso que Rallo mismo construyó para que fallara. La demostración de cinco líneas y la tabla del sistema único sobre las cifras de Bortkiewicz están reproducidas más arriba. El resto —la exhaustividad de los tres casos «muy excepcionales», la ausencia total de evidencia textual sobre la dirección del procedimiento de Bortkiewicz, la incompatibilidad estructural entre sustitución de insumos y reproducción simple— está en el texto de mayo de 2025, y remito a él sin intentar mejorarlo.

    Réplica III. Sobre el «teorema» de Okishio

    Lo mismo. La cuestión se decide en dos movimientos que no admiten réplica: primero, que una fórmula no es una definición, de modo que el carácter de equilibrio estático de la tasa okishiana es conclusión y no premisa; segundo, que la carga de la prueba pertenece a quien afirma que la tasa de Marx no puede caer, y que por lo tanto refutar el teorema sólo exige mostrar que esa tasa puede caer bajo las condiciones en que el teorema lo niega —cosa que los propios cálculos de Rallo confirman—. La disyuntiva OT1/OT2 cierra la salida: o el teorema habla del capitalismo real, y entonces es falso, o habla de un objeto matemático, y entonces es inofensivo. No hay tercera opción, y la ambigüedad entre las dos no es una posición sino una falacia de equivocación.

    · · ·

    VIBalance

    El residuo de la polémica es más preciso de lo que suele admitirse. Rallo concedió que el temporalismo de sistema único es la interpretación exegéticamente más fiel de Marx, que preserva las igualdades básicas del sistema y que los valores siguen regulando la producción y el intercambio. Después intentó demoler esa interpretación apilando dos restricciones —maximización de ganancias y sustituibilidad de insumos— que, aplicadas con consistencia, demuelen primero la corrección simultaneísta que él defiende. Y el frente de Okishio ni siquiera llegó a abrirse: quedó cerrado en la carga de la prueba.

    Pero lo que a mí me interesa no es el marcador. Es el núcleo metodológico que ambos frentes comparten, y que la discusión con Astarita expone en estado puro: la pregunta de si el tiempo es una dimensión del objeto o un estorbo del que se puede hacer abstracción. Walras respondió esa pregunta explícitamente y eligió la abstracción. Marx eligió lo contrario, y por eso su categoría central es el capital adelantado, que sólo significa algo si hay un antes y un después. Entre esas dos opciones no hay síntesis posible por vía de glosa. Se elige.

    · · ·

    Fuentes

    1. Juan Ramón Rallo, Anti-Marx. Crítica a la economía política marxista, Deusto, 2 tomos, 2022.
    2. Andrew Kliman, «Rallo’s Anti-Marx Critique of Marx and the TSSI: A Response», With Sober Senses, 4 de septiembre de 2024.
    3. Juan Ramón Rallo, «Réplica a Andrew Kliman: la TSSI no soluciona el problema de la transformación», Utilidad marginal, 13 de abril de 2025.
    4. Andrew Kliman, «The Negative Marginal Utility of Rallo’s Reply to Andrew Kliman», With Sober Senses, 15 de mayo de 2025.
    5. Rolando Astarita, «Respuesta a la crítica de Rallo a Moseley», 19 de marzo de 2023.
    6. Juan Ramón Rallo, «Réplica a Rolando Astarita sobre la (mala) solución que ofrece Fred Moseley al problema de la transformación de Marx», Utilidad marginal, 20 de marzo de 2023.
    7. Fred Moseley, Money and Totality, Brill, 2016. — Ladislaus von Bortkiewicz, «Valor y precio en el sistema marxiano», 1907. — Nobuo Okishio, «Technical Changes and the Rate of Profit», Kobe University Economic Review 7, 1961.

    Las traducciones al español de los dos textos de Kliman son de la Iniciativa Humanista Marxista. Las citas de Anti-Marx se toman de esos textos y de los originales indicados por sección. Donde el original usa la sigla inglesa de la interpretación temporal de sistema único, se la sustituye entre corchetes por su nombre en español.

  • Descubriendo las Ecuaciones Detrás de Tus Datos: Un Vistazo a la Librería EmpiricalDynamics en R

    Descubriendo las Ecuaciones Detrás de Tus Datos: Un Vistazo a la Librería EmpiricalDynamics en R

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Dinámica no lineal · Regresión simbólica · ODE · SDE

    ¿Qué ecuación está escondida en los datos? Una introducción a EmpiricalDynamics

    Un paquete de R para descubrir y evaluar ecuaciones diferenciales directamente a partir de series temporales, combinando diferenciación numérica robusta, regresión simbólica, modelización estocástica, validación temporal y un backend de alto rendimiento en Julia.

    EmpiricalDynamics · R · Julia · SymbolicRegression.jl · versión de desarrollo 0.1.13 · desarrollado por José Mauricio Gómez Julián · GitHub

    Estado del proyecto — agosto de 2026. La rama principal de GitHub se encuentra en la versión 0.1.13 y declara licencia GPL (≥ 3). La versión publicada actualmente en CRAN es 0.1.9, anterior a ese cambio de licencia.

    Tenemos una serie temporal: el PIB de un país, una población biológica, una temperatura, una tasa de interés, la concentración de una sustancia o la lectura de un sensor. Sospechamos que detrás de su movimiento existe alguna ley dinámica. El problema es que no sabemos cuál.

    Una estrategia consiste en elegir previamente una ecuación y estimar sus parámetros. Es lo habitual: suponemos una dinámica lineal, logística, exponencial o de alguna otra familia conocida y preguntamos qué valores de los parámetros ajustan mejor los datos.

    EmpiricalDynamics permite plantear también la pregunta inversa: ¿qué forma funcional es capaz de descubrir el propio algoritmo a partir de la dinámica observada?

    En lugar de restringirse desde el principio a \(\dot Z=\alpha+\beta Z\), una búsqueda simbólica puede explorar combinaciones de variables y operaciones matemáticas, generando distintas ecuaciones candidatas y comparando su calidad de ajuste con su complejidad.

    La idea fundamental

    El objetivo no es predecir simplemente el próximo dato mediante una caja negra. Es intentar recuperar una expresión matemática interpretable que describa la dinámica observada y después someter esa expresión a diagnósticos, simulaciones y pruebas de comportamiento.

    De estimar parámetros a descubrir ecuaciones

    Supongamos que conocemos de antemano la forma:

    \[ \frac{dZ}{dt} = \alpha+\beta Z. \]

    Entonces el problema consiste esencialmente en estimar \(\alpha\) y \(\beta\).

    Equation discovery plantea un problema más amplio:

    \[ \frac{dZ}{dt} = f(Z,\mathbf X;\boldsymbol{\theta}), \]

    donde conocemos las observaciones de \(Z\) y posiblemente de variables exógenas \(\mathbf X\), pero la propia función \(f(\cdot)\) también es desconocida.

    El algoritmo debe buscar simultáneamente una estructura funcional y sus constantes.

    Cuando el sistema es estocástico

    Muchos sistemas reales no evolucionan mediante una ley determinista perfecta. Incluso después de descubrir una estructura sistemática puede quedar una componente aleatoria cuya intensidad dependa del propio estado del sistema.

    Entonces la descripción natural pasa de una ODE a una ecuación diferencial estocástica:

    \[ dZ_t = f(Z_t,\mathbf X_t)\,dt + g(Z_t,\mathbf X_t)\,dW_t. \]

    Aquí \(f\) es el drift: la dinámica sistemática. \(g\) es la difusión: la intensidad del componente estocástico. \(W_t\) representa un proceso de Wiener.

    Descubrir una SDE implica, por tanto, resolver dos problemas: recuperar la ley del drift y recuperar la estructura de la difusión.

    La arquitectura: seis etapas que se pueden auditar

    Preprocesamiento. Estimar derivadas numéricas a partir de observaciones potencialmente ruidosas.

    Exploración. Examinar gráficamente relaciones, retratos de fase, superficies y posibles no linealidades.

    Descubrimiento simbólico. Buscar ecuaciones candidatas y construir una frontera entre ajuste y complejidad.

    Análisis de residuos. Preguntar qué estructura queda sin explicar y, cuando corresponde, construir la difusión de una SDE.

    Validación. Utilizar cross-validation temporal, simulación de trayectorias y análisis cualitativo de la dinámica.

    Salida. Generar ecuaciones LaTeX, tablas, gráficos y reportes destinados a documentación o publicación.

    El primer cuello de botella: calcular una derivada sin amplificar el ruido

    Para descubrir \[ \dot Z=f(Z,X) \] necesitamos primero alguna estimación de \(\dot Z\).

    Pero diferenciar numéricamente datos ruidosos es peligroso: la derivación amplifica precisamente las fluctuaciones de alta frecuencia que muchas veces querríamos tratar como ruido de medición.

    EmpiricalDynamics ofrece varias alternativas.

    Método Idea Uso natural
    TVR Regulariza la variación total de la derivada. Datos ruidosos, tendencias y posibles discontinuidades.
    Savitzky–Golay Ajustes polinomiales locales. Señales relativamente suaves donde interesa preservar picos.
    Smoothing spline Suavizado continuo antes de derivar. Procesos suaves con ruido.
    Diferencias finitas Aproximaciones locales directas. Datos limpios y suficientemente densos.
    Espectral Diferenciación en el dominio de frecuencias. Señales periódicas; requiere cuidado con el fenómeno de Gibbs.

    TVR: suavizar la derivada sin borrar toda la estructura

    El método recomendado por la documentación para muchas aplicaciones empíricas es Total Variation Regularization.

    De manera esquemática, busca:

    \[ \widehat{\dot Z} = \arg\min_{\dot Z} \left\| Z-\int_0^t \dot Z(\tau)\,d\tau \right\|_2^2 + \lambda \left\| \Delta\dot Z \right\|_1. \]

    El primer término obliga a que la derivada reconstruya adecuadamente la serie. El segundo penaliza una derivada excesivamente irregular.

    La implementación actual reescala internamente el problema para mejorar su acondicionamiento numérico y utiliza una cadena de solvers:

    1. CLARABEL

    Es el solver preferido actualmente para TVR y la primera opción de la cadena.

    2. SCS

    Proporciona una familia algorítmica alternativa si la primera solución no alcanza el estado deseado.

    3. OSQP

    Actúa como una tercera ruta de optimización cuando las anteriores no proporcionan una solución satisfactoria.

    Selección de \(\lambda\)

    select_lambda_cv_tvr() puede evaluar automáticamente una grilla de candidatos y reportar el estado de convergencia de los solvers.

    La paradoja interna de una SDE: un mejor drift puede destruir la evidencia de difusión

    Ésta es quizá la idea estadística más interesante del diseño.

    TVR mejora la estimación del drift precisamente mediante suavizado. Pero la difusión de una SDE se manifiesta en gran medida a través de fluctuaciones de alta frecuencia.

    Si utilizamos después los residuos de una derivada fuertemente regularizada para recuperar \(g\), podemos haber eliminado previamente buena parte de la información que queríamos medir.

    El conflicto

    TVR quiere limpiar la alta frecuencia para estimar el drift. La difusión vive precisamente en alta frecuencia. Un método que mejora la primera tarea puede empeorar la segunda.

    La solución: estimar difusión desde la variación cuadrática

    La implementación actual recomienda, cuando se utiliza TVR, no recuperar la difusión desde sus residuos sino volver a los incrementos observados.

    Para una SDE:

    \[ \frac{(\Delta Z)^2}{\Delta t} \approx g^2(X) + O(\Delta t). \]

    estimate_diffusion_qv() utiliza esta idea de variación cuadrática.

    Así, la estimación de \(g\) no depende de los residuos ya suavizados por TVR.

    Los valores individuales de \((\Delta Z)^2/\Delta t\) son naturalmente muy ruidosos, por lo que el procedimiento aplica internamente un suavizado mediante mediana móvil antes de ajustar la relación funcional.

    La evidencia del problema aparece en los propios recovery tests

    Configuración histórica Drift \(R^2\) Diffusion \(R^2\)
    Solver previo + difusión por residuos 0.864 0.591
    OSQP reescalado + residuos 0.887 0.070
    CLARABEL reescalado + residuos 0.841 0.005
    CLARABEL + variación cuadrática 0.841 0.985

    El punto no es que un solver “peor” fuese mejor. Es exactamente lo contrario: conforme el tratamiento de la derivada eliminaba mejor la fluctuación de alta frecuencia, una estimación de difusión basada en esos residuos perdía la señal que necesitaba.

    Volver a los incrementos crudos permite desacoplar ambos problemas.

    El corazón del paquete: regresión simbólica

    Una vez estimada la derivada, el algoritmo puede buscar expresiones capaces de explicar su comportamiento.

    En lugar de optimizar únicamente constantes, la búsqueda modifica también la estructura de las expresiones:

    \[ Z,\quad Z^2,\quad XZ,\quad \sin(X),\quad e^Z,\quad \frac{X}{Z},\quad \ldots \]

    El resultado no debería interpretarse simplemente como “la ecuación con menor error”.

    EmpiricalDynamics construye una frontera de Pareto donde aparecen ecuaciones con distintos compromisos entre ajuste y complejidad.

    Entre los criterios disponibles para elegir entre candidatos se encuentran AIC, BIC y MDL, además de mecanismos de selección sobre la propia frontera.

    search_result <- symbolic_search(
      data = data,
      response = "dZ",
      predictors = c("Z", "X"),
      backend = "r_genetic",
      max_complexity = 15,
      n_generations = 50,
      population_size = 100,
      n_runs = 3
    )
    
    plot_pareto_front(search_result)
    
    best_eq <- select_equation(
      search_result,
      criterion = "bic"
    )

    Si ya existe una teoría, no hay premio por ignorarla

    El paquete no presenta la búsqueda ciega como superior en toda situación.

    Si una teoría proporciona una forma funcional concreta, la documentación recomienda utilizarla directamente mediante fit_specified_equation().

    equation <- fit_specified_equation(
      "alpha + beta * Z + gamma * Z^2 + delta * X",
      data = data,
      derivative_col = "dZ",
      method = "levenberg-marquardt",
      start = list(
        alpha = 0,
        beta = 1,
        gamma = -0.01,
        delta = 0.5
      )
    )

    Ésta es una distinción metodológica importante: descubrimiento cuando desconocemos la estructura; estimación directa cuando poseemos una hipótesis estructural que queremos poner a prueba.

    Explorar antes de buscar

    explore_dynamics() permite examinar visualmente las relaciones antes de lanzar una búsqueda simbólica.

    Actualmente compara formas lineales, cuadráticas y cúbicas para los predictores, conserva el ajuste ganador, sus coeficientes, el rango donde fue estimado y los AIC de los modelos enfrentados.

    Esto importa porque una etiqueta como “cuadrática” no nos dice si la curva realmente cambia de dirección dentro del rango observado.

    Una cautela actual

    La propia Wiki reporta que, en simulaciones internas, esta comparación AIC clasifica una relación verdaderamente lineal como “linear” alrededor del 78 % de las veces. Por eso la etiqueta debe leerse como selección de modelo, no como medición infalible de la forma verdadera.

    Julia hace el trabajo evolutivo pesado

    El backend de alto rendimiento utiliza SymbolicRegression.jl.

    La arquitectura mantiene en R el flujo estadístico, los diagnósticos y la interfaz, mientras Julia puede encargarse de búsquedas evolutivas más costosas y paralelizables.

    El archivo inst/julia/symbolic_backend.jl define una configuración científica que controla, entre otras cosas:

    • tamaño de poblaciones;
    • número de iteraciones;
    • complejidad máxima;
    • penalización por falta de parsimonia;
    • operadores permitidos;
    • checkpoints;
    • y detección de determinadas constantes físicas.

    El backend actual reconoce como candidatos \(\pi\), \(e\), \(\varphi\), \(g\), \(c\), \(h\) y \(k_B\), incluyendo además algunas transformaciones simples de estas constantes.

    Esto permite, por ejemplo, reconocer que un coeficiente numérico descubierto está cerca de \(\pi\), en lugar de presentar únicamente una expansión decimal sin interpretación.

    GLS iterativo: la versión actual conserva toda la historia del ajuste

    Cuando la varianza condicional cambia con el estado, el paquete puede refinar el drift mediante un procedimiento GLS iterativo.

    Esquemáticamente:

    \[ r_i^{(k)} = \dot Z_i – \widehat f^{(k-1)}(Z_i,X_i), \]
    \[ w_i^{(k)} = \frac{1} {\widehat g^{(k)}(Z_i,X_i)^2}, \]

    y esos pesos modifican la siguiente estimación del drift.

    Versiones recientes corrigieron un detalle fundamental: el loop anterior no podía reconocer correctamente su propia convergencia cuando las constantes de una ecuación simbólica aparecían como literales.

    La implementación actual exige simultáneamente:

    Estabilidad del objetivo

    La deviance ponderada debe haber dejado de cambiar de forma material.

    Estabilidad de la función

    Las predicciones de dos iteraciones sucesivas también deben haberse aproximado suficientemente.

    Además, el resultado conserva converged, stop_reason, history, selected_iteration, las puntuaciones de selección y los candidatos excluidos.

    La selección por defecto entre las iteraciones utiliza blocked cross-validation con bloques contiguos y reestimación de las constantes.

    Los residuos son una pregunta, no un basurero

    Después de ajustar una ecuación, lo que queda sin explicar puede contener información sobre una especificación incompleta.

    residual_diagnostics() reúne varias pruebas:

    Prueba Qué examina
    Ljung–Box Dependencia serial restante.
    ARCH-LM Heterocedasticidad condicional.
    Breusch–Pagan Varianza relacionada con predictores.
    Jarque–Bera Desviaciones respecto de normalidad.
    Runs test Patrones no aleatorios remanentes.

    Validar una ecuación temporal sin dejar que mire el futuro

    Una serie temporal no debería ser validada como si sus filas fueran intercambiables.

    La implementación actual admite validación por bloques y esquemas rolling o sliding. En el modo rolling, las observaciones utilizadas para entrenamiento se encuentran antes de la ventana de prueba.

    cv <- cross_validate(
      equation,
      data = data,
      response = "dZ",
      k = 5,
      method = "rolling",
      horizon = 4,
      window = "expanding"
    )

    Esto parece un detalle obvio, pero no lo era en versiones anteriores. La 0.1.12 corrigió un defecto por el que la implementación rolling podía utilizar como entrenamiento observaciones posteriores a la ventana que pretendía validar.

    También se corrigieron otros problemas:

    • los bloques ahora cubren todas las filas en lugar de abandonar observaciones finales;
    • \(R^2\) se evalúa contra la media del conjunto de entrenamiento, no contra una media calculada después de conocer los datos de prueba;
    • los folds cuyo reajuste falla ya no desaparecen silenciosamente del promedio;
    • los pesos de observación se conservan al reestimar cada fold;
    • un GLM se vuelve a ajustar como GLM y no accidentalmente como una regresión gaussiana ordinaria.

    Una limitación importante de esa cross-validation

    Hay todavía una sutileza que la documentación actual hace explícita.

    Cuando la variable objetivo es una derivada calculada numéricamente, el propio \(\dot Z_t\) puede haber sido construido utilizando observaciones vecinas.

    Con TVR, incluso puede intervenir información de toda la serie.

    Por tanto, aunque el modelo de cada fold no se entrene con el futuro bajo el esquema rolling corregido, la derivada que se le entregó pudo haber sido calculada previamente usando esa información.

    Qué significa entonces el CV

    La propia documentación advierte que estas cifras pueden utilizarse para comparar ecuaciones candidatas bajo el mismo tratamiento, pero no deben confundirse con el error que esperaríamos al pronosticar una serie futura completamente nueva. La opción destinada a recalcular la derivada dentro de cada fold, refit_derivative, todavía no está implementada.

    Una ecuación no sólo debe ajustar puntos: también debe comportarse correctamente

    EmpiricalDynamics incorpora herramientas para estudiar propiedades cualitativas de la ecuación descubierta:

    • puntos fijos;
    • estabilidad;
    • bifurcaciones;
    • acotamiento;
    • y simulación completa de trayectorias.

    Ésta es una diferencia importante entre encontrar una regresión flexible y recuperar una dinámica plausible.

    Dos expresiones pueden presentar errores similares sobre la muestra y, sin embargo, producir retratos dinámicos completamente diferentes cuando se integran.

    Bifurcaciones bayesianas: una mejora reciente

    La versión 0.1.11 endureció de forma importante analyze_bifurcations().

    Para modelos que contienen draws posteriores, la función ya no reduce automáticamente toda la incertidumbre a un único vector de coeficientes. Puede barrer la distribución posterior y devolver distribuciones de puntos fijos.

    Además, comprueba que cambiar el parámetro de bifurcación cambie realmente las predicciones del objeto.

    Esto evita producir una tabla perfectamente formada pero científicamente vacía donde todos los valores del parámetro generan exactamente el mismo resultado porque la sustitución nunca llegó al mecanismo de predicción.

    En la 0.1.13 se añadió además ed_derivative_step(), que expone oficialmente el paso \(10^{-6}\) utilizado por la diferencia central en la clasificación de puntos fijos.

    Recovery tests: darle al algoritmo un mundo cuya ley ya conocemos

    La validación más directa de un algoritmo de equation discovery consiste en construir un mundo sintético donde conozcamos la ley verdadera, ocultársela al algoritmo y preguntarle si puede recuperarla.

    Esto no prueba causalidad en datos observacionales reales.

    Sí responde una pregunta previa indispensable: si la ley verdadera está presente en los datos bajo condiciones controladas, ¿el pipeline es capaz de encontrarla?

    El atractor de Lorenz

    Uno de los benchmarks utiliza el sistema caótico clásico:

    \[ \frac{dx}{dt}=10(y-x), \]
    \[ \frac{dy}{dt}=28x-xz-y, \]
    \[ \frac{dz}{dt}=xy-\frac{8}{3}z. \]
    Ecuación \(R^2\) frente a la dinámica verdadera
    \(dx/dt\) 0.937
    \(dy/dt\) 0.960
    \(dz/dt\) 0.914
    Promedio 0.937

    La Wiki aclara que estas cifras combinan el error de diferenciación TVR y la regresión simbólica, y que la búsqueda evolutiva es estocástica: distintos runs pueden producir resultados diferentes.

    El benchmark estocástico

    El segundo recovery test utiliza una SDE deliberadamente difícil:

    \[ dZ_t = \left[ 10\sin(X_t)-2.5Z_t^3 \right]dt + \left[ 0.10+0.06|X_t| \right]dW_t. \]

    Con 5.000 observaciones, \(\Delta t=0.005\) y un SNR documentado de aproximadamente \(0.29\), los resultados reportados son:

    Componente \(R^2\) RMSE Procedimiento
    Drift 0.841 0.547 TVR + GLS iterativo
    Diffusion 0.985 0.063 Variación cuadrática
    Cómo leer los benchmarks

    Son recovery tests sobre sistemas sintéticos con verdad conocida. Demuestran que el procedimiento puede recuperar esas estructuras bajo las condiciones ensayadas. No garantizan que una ecuación encontrada en datos observacionales sea la verdadera ley causal del sistema.

    Descubrir una ecuación no equivale a descubrir causalidad

    Ésta es una frontera importante.

    Una expresión simbólica puede reproducir extraordinariamente bien una relación observada y seguir reflejando variables omitidas, confundimiento, simultaneidad, errores de medición o una estructura que sólo funciona bajo determinado régimen.

    La regresión simbólica responde principalmente: ¿qué estructura matemática es consistente con la dinámica observada?

    Convertir esa estructura en una afirmación causal requiere información y razonamiento adicionales.

    Instalación: CRAN o versión de desarrollo

    La versión publicada en CRAN puede instalarse directamente:

    install.packages("EmpiricalDynamics")

    Para utilizar el estado más reciente del repositorio:

    remotes::install_github(
      "IsadoreNabi/EmpiricalDynamics"
    )

    El backend Julia se configura después desde R:

    library(EmpiricalDynamics)
    
    setup_julia_backend()

    El metadata actual del paquete declara R 4.0.0 o posterior y Julia 1.6 o posterior como requisito del sistema para el backend. El README recomienda actualmente Julia 1.9 o posterior; utilizar una versión reciente de Julia satisface ambas indicaciones.

    La cuestión metodológica de fondo

    La tentación en equation discovery es imaginar una máquina que recibe una tabla y devuelve “la ley de la naturaleza”.

    EmpiricalDynamics es más interesante precisamente cuando se lo entiende de otra manera.

    La búsqueda simbólica constituye solamente una parte de un procedimiento mucho más largo.

    Primero hay que construir una derivada defendible. Después explorar la geometría de la relación. Luego buscar o especificar ecuaciones. Después mirar lo que quedó en los residuos. Si existe estructura estocástica, separar drift y difusión. Luego comprobar comportamiento cualitativo y simular trayectorias. Finalmente evaluar qué tanto de la conclusión sobrevive fuera del ajuste inmediato.

    Y cada uno de esos pasos puede fallar de una manera distinta.

    Ésa es la contribución más interesante de EmpiricalDynamics: no tratar el descubrimiento de ecuaciones como un concurso donde gana la expresión con el \(R^2\) más alto, sino como un problema de inferencia dinámica completo. La ecuación debe ser parsimoniosa, sobrevivir diagnósticos, reproducir propiedades cualitativas y distinguir correctamente la estructura determinista de la estocástica. Sus recovery tests muestran que el pipeline puede redescubrir dinámicas conocidas; sus revisiones recientes muestran algo igualmente importante: cuando una métrica, una validación o un barrido de bifurcaciones no significaba exactamente lo que afirmaba significar, el comportamiento fue auditado y corregido. El producto final no es simplemente una fórmula encontrada por una computadora. Es una forma más disciplinada de preguntar: ¿qué ecuación es realmente compatible con la dinámica que observamos, y qué evidencia tenemos para creerle?

    EmpiricalDynamics es desarrollado por José Mauricio Gómez Julián. La rama de desarrollo actual declara licencia GPL (≥ 3). El código fuente y el historial de cambios están disponibles en GitHub, y la documentación matemática, los recovery tests y las guías de uso se encuentran en la Wiki de EmpiricalDynamics.

  • La Forma de Una Crisis: Teoría General del Ciclo Capitalista

    La Forma de Una Crisis: Teoría General del Ciclo Capitalista

    Publicación de tesis · Economía Política

    La forma de una crisis

    Una teoría general de los ciclos de la dinámica del sistema capitalista a largo plazo — ya disponible en inglés

    Cada tantos años se cuenta el mismo relato dos veces. Primero, que la economía entró en una era nueva en la que las reglas viejas ya no rigen. Después, unos meses más tarde, que lo ocurrido fue un accidente: un choque, una burbuja, un virus, una guerra. Las dos versiones comparten una premisa tan silenciosa que casi nunca se examina: que el auge y la caída son sucesos separados, y que una buena teoría de los años buenos no necesita ser también una teoría de los malos.

    La tesis que se publica hoy sostiene lo contrario, y se toma el trabajo de medirlo. El auge y la crisis no son dos fenómenos sino dos momentos de uno solo: la crisis de sobreproducción es el mecanismo mediante el cual el capitalismo restablece las condiciones de una acumulación que su propio éxito había erosionado. La desvalorización despeja el terreno; se introducen, forzadamente, nuevos métodos de producción; la rentabilidad se recupera sobre las ruinas. La recuperación no es la negación de la crisis. Es su producto.

    Esa afirmación es vieja. Lo nuevo aquí es el intento de volverla decidible: enunciarla en una forma que los datos trimestrales de la economía de los Estados Unidos entre 1992 y 2024 hubieran podido contradecir, y comprobar después si en efecto la contradicen.

    Tres preguntas, y por qué el orden importa

    La investigación se organiza alrededor de un objetivo general —analizar el comportamiento cíclico de largo plazo del capitalismo estadounidense a la luz de las teorías económicas dominantes— y tres específicos, formulados estrictamente en este orden:

    • ¿Qué teoría explica y predice mejor? No cuál es más elegante, ni cuál se enseña más, sino cuál sobrevive al ser puesta frente a los datos.
    • ¿Qué factores generan el ciclo? Económicos y extraeconómicos por igual: la tesis se niega de antemano a tratar las guerras y la política monetaria como ruido situado fuera de un mecanismo económico limpio.
    • ¿Bajo qué reglas interactúan esos factores? Una lista de causas no es una teoría. La teoría está en la gramática que las liga.

    El orden no es decorativo. Buena parte de la economía aplicada responde la tercera pregunta con maquinaria tomada en préstamo de una teoría que nunca sometió a la primera. Acá la selección del marco es ella misma un resultado, defendido antes de ser usado.

    Cinco familias de una discusión antigua

    Antes de medir nada, la tesis levanta el mapa del terreno. El pensamiento económico sobre el ciclo se ordena en cinco grupos: las escuelas no heterodoxas pre-Kondratieff; la escuela de Kondratieff; las escuelas marginalistas y neoclásicas post-Kondratieff; las escuelas heterodoxas; y la visión historiográfica de las ondas largas, que lee el ciclo desde los archivos antes que desde las ecuaciones.

    Con ese mapa a la vista se dirimen —no se resumen— tres disputas de larga data. ¿La crisis se origina en la sobreproducción o en el subconsumo? ¿La emisión sostenida de crédito es síntoma de recuperación, o del agotamiento de las condiciones que la hicieron posible? ¿Existe realmente una relación inversa entre inflación y desempleo, o su apariencia es un artefacto de la precariedad del mercado laboral? Cada una recibe respuesta, y cada respuesta tiene consecuencias más adelante, cuando se especifica el modelo.

    Un marco que enuncia sus propias condiciones de fracaso

    Una parte sustancial del aparato teórico se dedica a una caracterización materialista del método dialéctico: sus categorías fundamentales, una ontología marxista construida desde una gnoseología metalógica, y un tratamiento explícito de la verificación, la falsación y la decidibilidad. El propósito es poco vistoso e imprescindible: fijar de antemano qué proposiciones de la teoría son empíricamente decidibles y cuáles son interpretativas. Sin esa frontera, ninguna cantidad de estadística posterior puede decir qué fue lo que se puso a prueba.

    Diez perillas, siete de ellas internas

    El núcleo empírico es un modelo lineal generalizado bayesiano del crecimiento del producto real estadounidense, estimado con Monte Carlo hamiltoniano y validado cruzadamente contra competidores de aprendizaje automático y aprendizaje profundo. Retiene trece coeficientes repartidos en diez factores. Siete son económicos:

    FactorQué registra
    Tasa media de ganancia neta (ARoP)La variable central del proceso de acumulación, y aquella cuya tendencia de largo plazo la teoría predice.
    Elasticidad de la tasa bruta de plusvalía a la composición orgánica media del capitalCómo responde la explotación de la fuerza de trabajo cuando cambia la estructura técnica del capital.
    Inversión fija no residencialEl ritmo de la acumulación en el sector productivo; la bisagra entre el auge y la crisis.
    Ratio inventarios/ventasLa distancia entre producir valor y realizarlo en el mercado.
    S&P 500La financiarización, que entra mediante un spline cúbico natural con tres grados de libertad.
    Crédito al sector privado no financieroEl sistema de crédito como acelerador y como freno, con spline de dos grados de libertad.
    Gasto capitalista en I+DEl impulso innovador; el segundo coeficiente más grande del modelo.

    Y tres son extraeconómicos: el gasto militar (con spline de tres grados de libertad), el superávit o déficit federal y la tasa efectiva de fondos federales. Su presencia no es una concesión al realismo. Se sigue del argumento de que una economía imperial contrarresta la tendencia decreciente de su propia tasa de ganancia por medios que no son internos a sus cuentas nacionales.

    La tasa media de ganancia carga el cuarto coeficiente más alto de los trece —detrás sólo del intercepto, del gasto en I+D y de una función base del S&P 500 splineado. La conclusión que el autor extrae de su comportamiento merece citarse en sustancia: lo que es favorable al proceso global de acumulación de capital no es por ello favorable a la dinámica del crecimiento agregado. No son la misma magnitud, y tratarlas como una sola es precisamente la confusión que el ciclo castiga.

    Repárese también en lo que hacen los splines. Tres de los diez factores no se dejaban acomodar en una recta. Eso no es una nota técnica al pie: es el primer indicio cuantitativo de que la interacción de estos factores involucra umbrales y puntos de giro antes que una proporcionalidad estable.

    No es azaroso. Es caótico.

    «Impredecible» y «azaroso» no son sinónimos, y la diferencia decide qué clase de ciencia puede ser la economía. Un sistema azaroso no tiene estructura interna que encontrar. Uno caótico está rígidamente determinado y aun así resulta impredecible a horizontes largos, porque diferencias arbitrariamente pequeñas en las condiciones iniciales se separan de manera exponencial.

    Tres mediciones ubican a la economía estadounidense en la segunda categoría. El exponente de Lyapunov es positivo (aproximadamente $0{,}0515$): las perturbaciones pequeñas se amplifican en lugar de disiparse. La dimensión de correlación no es entera ($3{,}32798$): el atractor reconstruido por el teorema de Takens tiene estructura fractal, patrones que se repiten a distintas escalas de tiempo y magnitud —que es lo que significa «cíclico, pero no periódico» cuando se lo enuncia con precisión. Y el análisis cuantificado de recurrencia encuentra un determinismo alto junto a variabilidad en la laminaridad y en la longitud máxima de las líneas diagonales: estructuras deterministas subyacentes que ellas mismas evolucionan.

    $\lambda > 0 \quad\text{y}\quad D_2 = 3{,}32798 \notin \mathbb{Z}$

    Leídas en conjunto, estas mediciones dicen algo que a un pronosticador debería resultarle aleccionador y a un teórico, alentador. El pronóstico a horizonte largo no es meramente difícil: está acotado estructuralmente. Pero la estructura que lo acota es real, estable y medible —que es exactamente lo que una teoría del ciclo necesita para tener algo que explicar.

    La forma del tiempo

    El instrumento más inusual de la tesis es topológico. La idea consiste en dejar de preguntar cuán grandes son los números y empezar a preguntar qué observaciones pueden ver a cuáles. Se convierte la serie en un grafo de visibilidad dirigido —un enlace de un trimestre a otro cuando el segundo es visible desde el primero por encima de los datos intermedios— y se estudia la estructura de orden resultante.

    Sobre ese grafo se construyen dos topologías, y discrepan de un modo informativo.

    • La topología de Alexandrov, más gruesa, construida sobre la alcanzabilidad temporal, resulta conexa. Al nivel de su estructura de orden la economía es globalmente una sola pieza: cada observación está ligada a todas las demás por cadenas de visibilidad temporal. No hay trimestre que quede aparte.
    • La topología Nada, más fina, está localmente fragmentada: seis componentes bajo el grafo de visibilidad natural, treinta y seis bajo el horizontal. Al acercar la lente, el tejido muestra costuras: discontinuidades estructurales al nivel de las vecindades cerradas.

    Unidad global y ruptura local a la vez. Esa dualidad no es una contradicción a resolver; es el objeto que se está describiendo. Y una tercera medición le da dirección al conjunto: el análisis bitopológico arroja $D = +4$, es decir que las expansiones generan más visibilidad temporal que las contracciones. El ciclo no es simétrico en el tiempo. El crecimiento se acumula de manera gradual y a la vista; el derrumbe ocurre de golpe y a ciegas. Pasada al revés, la película es reconociblemente la película equivocada.

    ⚠️ Por qué no hay que «limpiar» las crisis

    Hay una costumbre en el trabajo aplicado que consiste en tratar los valores extremos como contaminación y suavizarlos mediante imputación discontinua. Aquí se muestra que esa costumbre es un error de categoría con un precio medible. Las fluctuaciones extremas de la crisis de 2020 pertenecen a un bloque conexo incluso bajo la topología más fina; cortarlas es una ruptura topológica, no una operación de limpieza. La tesis reporta la consecuencia de manera directa: los modelos ajustados después de esa imputación tuvieron un desempeño peor, porque se estaban usando predictores adecuados a un fenómeno —el crecimiento del producto real— para predecir otro cualitativamente distinto: el crecimiento del producto real una vez que se le extrajo la crisis. Las crisis no son ruido alrededor del ciclo. Son el ciclo.

    La gramática del ciclo

    La tercera pregunta recibe una respuesta de siete partes. Los factores interactúan mediante retroalimentación (la tasa de ganancia moldea la inversión, la inversión moldea la composición orgánica del capital, que retroalimenta la tasa de ganancia); rezagos temporales (la I+D y la inversión fija rinden con demora, y la demora es ella misma generadora de ciclo); no linealidad (umbrales y cambios de régimen, razón por la cual tres factores necesitaron splines); caos determinista; interdependencia sectorial entre el departamento que produce medios de producción y el que produce medios de consumo; estructura topológica, conexidad global con fragmentación local; e influencia del contexto global, que es la vía por la cual el gasto militar y el S&P 500 entran en una cuenta nominalmente doméstica.

    La afirmación que unifica todo esto es que cada fase del ciclo contiene el germen de su propia negación. Los nuevos métodos de producción introducidos durante la crisis sientan los cimientos del auge siguiente; la sobreacumulación del auge prepara el terreno de la crisis siguiente. La innovación al principio detiene la caída de la tasa de ganancia y termina por profundizarla, por la vía del modo en que el grado de explotación de la fuerza de trabajo responde, con el tiempo, a los mismos métodos introducidos para elevarlo.

    Para qué sirve un ciclo

    La tesis cierra con una pregunta que la mayoría de los tratamientos jamás formula. Si el ciclo es un mecanismo, ¿qué es lo que consigue? Dos respuestas, a distinta profundidad. Su fin práctico intermedio es reiniciar el proceso de acumulación de capital una vez que la inestabilidad alcanzó un nivel crítico —esto el mecanismo lo logra, repetidamente, a un costo que se reparte de manera desigual. Su fin práctico definitivo es sentar las condiciones materiales y espirituales de una reorganización de la estructura productiva fundamental de la sociedad, capaz de una estabilidad mayor que la que el modo de producción capitalista puede alcanzar dentro de sus propios límites.

    Qué establece esto, y qué no

    La evidencia respalda la afirmación de que la teoría económica marxista clásica posee la mayor capacidad explicativa y predictiva sobre los ciclos de largo plazo entre las teorías aquí examinadas, sobre esta economía y en este período. Es un resultado comparativo sobre los Estados Unidos entre 1992 y 2024, con datos trimestrales: no es una prueba universal ni un pronóstico. La tesis es explícita respecto del costo de sus propios datos: la tasa media de ganancia y la tasa media de plusvalía sólo estuvieron disponibles con frecuencia anual hasta 2020, y completar las series hasta 2024 exigió técnicas de desagregación temporal y de predicción, lo que amplía la banda de incertidumbre alrededor de los trimestres más recientes. El alcance filosófico, histórico, conceptual y estadístico de cada resultado se distingue en el texto, y los resultados desfavorables a las hipótesis se reportan junto a los favorables.

    Sobre esta edición

    Esta es la edición en inglés de una tesis escrita originalmente en español y presentada ante la Universidad Latina de Costa Rica para optar por el grado de Licenciatura en Economía. Es interdisciplinaria por construcción: se apoya en la economía política marxista, el materialismo dialéctico e histórico, la historia y la historiografía del pensamiento económico, la filosofía y la metodología de la ciencia, la econometría, la estadística bayesiana, la teoría de sistemas complejos y la topología.

    La edición incluye una Nota sobre la traducción que fija la versión de aquellos términos cuyo uso en español es técnico y no intercambiable con sus cognados ingleses más cercanos —gnoseología, superación, onda larga, demanda solvente, técnica— y consigna las ediciones de las que se toman las citas, incluidas las dos ediciones distintas, inglesa y española, del diccionario filosófico soviético, que se citan bajo transliteraciones diferentes porque son libros diferentes con paginación diferente.

  • topologyR: Convertir Series Temporales en Patrones Espaciales Para Poner a Prueba Las Hipótesis Ocultas de Tus Modelos

    topologyR: Convertir Series Temporales en Patrones Espaciales Para Poner a Prueba Las Hipótesis Ocultas de Tus Modelos

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Topología · Series temporales · Grafos de visibilidad

    Antes de suavizar una serie, preguntá si realmente es una sola pieza

    topologyR transforma una serie temporal en un grafo, el grafo en un espacio topológico y su conectividad en una prueba previa sobre la estructura que estamos a punto de modelar.

    topologyR · R · Rcpp · Topological Data Analysis · desarrollado por José Mauricio Gómez Julián · GitHub

    Hay una costumbre extraordinariamente común en análisis cuantitativo: tomar una serie temporal y ajustarle una curva suave. Puede ser un spline, una interpolación, una tendencia de largo plazo, un kernel o algún método semejante.

    Pero todos esos procedimientos comparten una suposición previa: que estamos mirando una sola estructura continua.

    ¿Y si la serie contiene fracturas estructurales? ¿Y si aquello que el calendario presenta como una secuencia única es, desde la estructura topológica inducida por los datos, una colección de componentes separados?

    En ese caso, aplicar una única operación de suavizado global puede imponer una conexión entre regiones que el propio análisis estructural no respalda.

    topologyR fue construido alrededor de una idea sencilla: examinar esa estructura antes de elegir el modelo.

    La pregunta previa

    Antes de preguntar qué spline, tendencia o interpolación se ajusta mejor, topologyR plantea otra pregunta: ¿la topología inducida por nuestra serie aparece como una sola componente conectada o como varias?

    De números a formas: el pipeline completo

    El procedimiento transforma progresivamente una serie numérica en un objeto topológico.

    Serie temporal \(x_1,x_2,\ldots,x_n\)
    Grafo de visibilidad relaciones geométricas entre observaciones
    Espacio topológico vecindades, base y conectividad

    La arquitectura puede resumirse en tres etapas.

    Construir un grafo a partir de la geometría de la serie temporal mediante visibilidad horizontal o natural.

    Construir una topología sobre los vértices del grafo utilizando vecindades cerradas y la construcción de Nada.

    Calcular la conectividad del espacio resultante y utilizar sus componentes para caracterizar la estructura global.

    Paso 1: convertir una serie temporal en un grafo

    Imaginemos una serie dibujada como una cadena de montañas y valles. Cada observación es un punto a cierta altura.

    La pregunta de un visibility graph es literalmente: ¿qué puntos pueden “verse” entre sí?

    Horizontal Visibility Graph — HVG

    Dos observaciones \(x_i\) y \(x_j\) son horizontalmente visibles cuando todas las observaciones intermedias se encuentran por debajo de ambas.

    \[ x_k < \min(x_i,x_j) \qquad \forall\, i

    Es una regla simple que captura la arquitectura de máximos y mínimos de la serie.

    El HVG puede construirse en tiempo lineal y produce un grafo relativamente parsimonioso.

    Natural Visibility Graph — NVG

    El NVG utiliza una condición geométrica más permisiva. Dos puntos están conectados si todas las observaciones situadas entre ambos quedan por debajo de la recta que los une.

    El resultado suele ser un grafo más denso y rico en conexiones.

    Según la arquitectura del paquete, el NVG contiene al HVG como subgrafo y presenta complejidad esperada del orden de \(O(n\log n)\).

    Una propiedad importante

    HVG y NVG son construcciones sin parámetros de escala que ajustar: no requieren escoger un bandwidth, un \(\varepsilon\), un radio ni un threshold arbitrario para decidir qué observaciones están conectadas. La estructura proviene de la geometría de la propia serie.

    Paso 2: del grafo a una topología

    Hasta aquí seguimos en teoría de grafos. Un grafo nos dice qué vértices están unidos mediante aristas.

    topologyR da un paso adicional y construye un espacio topológico finito.

    La construcción sigue el enfoque atribuido en la documentación a Nada, El Atik y Atef.

    Para cada vértice \(v\), se forma su vecindad cerrada:

    \[ N[v] = \{v\} \cup \{u : u\sim v\}. \]

    Es decir: el vértice y todos sus vecinos directos.

    Esas vecindades forman una subbase.

    Después:

    • las intersecciones finitas generan una base;
    • las uniones arbitrarias de elementos de esa base forman la topología.

    El resultado es una familia de subconjuntos que satisface los axiomas topológicos estándar.

    ¿Qué significa eso en lenguaje plano?

    Podemos pensar en las vecindades como una primera descripción de qué puntos pertenecen estructuralmente cerca de cuáles.

    Las intersecciones refinan esa información: conservan aquello en lo que distintas vecindades coinciden.

    Las uniones permiten construir regiones mayores a partir de esos bloques.

    topologyR utiliza así la arquitectura local del grafo para construir una noción global de proximidad y separación.

    Paso 3: ¿una componente o varias?

    El objetivo final es estudiar la conectividad topológica.

    Un espacio es conectado cuando no puede separarse en dos conjuntos abiertos disjuntos, no vacíos, cuya unión sea todo el espacio.

    \[ X \neq U\sqcup V \qquad \text{con } U,V\neq\varnothing \text{ abiertos} \]

    Para espacios finitos, la documentación se apoya en resultados clásicos de McCord y Stong y utiliza el preorden de especialización para obtener los componentes.

    Lo decisivo computacionalmente es que la conectividad puede calcularse directamente a partir de la base, sin enumerar necesariamente toda la topología.

    La regla de decisión

    Dentro del marco metodológico propuesto por el paquete, la conectividad se transforma en una puerta previa a la modelización.

    Topología conectada

    La estructura inducida por la serie es compatible con tratar los datos como una unidad global dentro de este criterio. Métodos continuos globales pueden considerarse metodológicamente admisibles.

    Topología desconectada

    La estructura aparece fragmentada. El paquete propone respetar los componentes resultantes y considerar modelización, imputación o análisis separados por régimen.

    Entre los métodos cuyo uso puede depender de esta decisión se encuentran splines, kriging, interpolaciones polinomiales, kernels y determinadas técnicas globales de suavizado.

    Global y local no son la misma cosa

    Una fragmentación global no vuelve inútil toda propiedad calculada sobre la serie.

    La documentación distingue entre propiedades globales y propiedades locales.

    Propiedades globales

    Tendencias seculares, medidas sobre toda la trayectoria, sincronización global o estadísticas que dependen simultáneamente del conjunto completo de observaciones.

    Propiedades locales

    Volatilidad de ventanas cortas, cambios punto a punto o autocorrelaciones locales pueden seguir estudiándose dentro de cada componente.

    La información topológica sirve entonces no sólo para decir “sí” o “no”, sino también para indicar dónde termina una región y comienza otra.

    El tiempo tiene dirección

    Hasta ahora hemos tratado las aristas del grafo como no dirigidas.

    Pero una serie temporal no es una nube de puntos. Existe un antes y un después.

    Con directed = TRUE, topologyR orienta las aristas desde la observación anterior hacia la posterior.

    El resultado es un directed acyclic graph —DAG— cuyo orden natural viene dado por el tiempo.

    Una serie, dos topologías

    Sobre ese grafo dirigido pueden construirse dos estructuras de vecindad:

    \(\tau^{+}\) topología forward: qué estructura vemos mirando hacia el futuro
    \(\tau^{-}\) topología backward: qué estructura vemos mirando hacia el pasado

    El par \[ (X,\tau^{+},\tau^{-}) \] constituye, dentro de esta construcción, un espacio bitopológico.

    La documentación conecta esta arquitectura con la noción de bitopología introducida por Kelly.

    Irreversibilidad como asimetría topológica

    Si un proceso temporal fuese perfectamente simétrico hacia adelante y hacia atrás, esperaríamos que ambas topologías fueran estructuralmente muy similares.

    Si la dinámica posee una flecha temporal, pueden divergir.

    topologyR cuantifica esa divergencia mediante varias medidas.

    Component irreversibility

    Compara el número de componentes conectadas de \(\tau^{+}\) y \(\tau^{-}\).

    Base irreversibility

    Compara los tamaños de las bases forward y backward.

    Asymmetry direction

    Conserva el signo de la diferencia y permite identificar en qué dirección temporal aparece mayor conectividad.

    Reversibilidad ideal

    Una dinámica perfectamente simétrica debería producir estructuras forward y backward equivalentes bajo el criterio considerado.

    Un ejemplo intuitivo: expansiones lentas y contracciones bruscas

    Pensemos en un ciclo económico donde la producción crece gradualmente durante años y luego cae violentamente en pocos trimestres.

    Geométricamente, ambas direcciones temporales no “ven” exactamente lo mismo.

    Durante una expansión gradual, la visibilidad hacia adelante puede mantenerse durante trayectorias relativamente largas.

    Después de una caída abrupta, la geometría hacia atrás puede quedar más fragmentada.

    Dentro de la interpretación propuesta por topologyR, esto debería generar:

    \[ C_{+} < C_{-}, \]

    es decir, menos componentes forward que backward y, por tanto, una dirección de asimetría positiva bajo la convención del paquete.

    Una tercera capa: la topología de Alexandrov

    El grafo dirigido permite construir también una topología basada en alcanzabilidad.

    Si desde un vértice \(v\) podemos llegar a otro vértice siguiendo las aristas dirigidas, ambos quedan relacionados por el orden inducido por el DAG.

    La topología de Alexandrov, \(\tau_A\), utiliza precisamente esa relación.

    Para cada vértice, su abierto mínimo contiene los puntos alcanzables desde él.

    \[ U_v = \{u : v \leadsto u\}. \]

    La documentación establece además una relación estructural importante:

    \[ \tau_A \subseteq \tau^{+}_{\text{Nada}}. \]

    La topología de Alexandrov captura principalmente la estructura de orden; la construcción de Nada puede generar información adicional mediante el cierre por intersecciones.

    ¿Cuánta información adicional aporta Nada?

    Una forma muy simple de verlo es comparar los tamaños de ambas bases:

    \[ \left|B_{\text{Nada}}\right| – \left|B_A\right|. \]

    Una diferencia grande indica que las operaciones de cierre de la construcción de Nada están generando una estructura sustancialmente más rica que la mera relación de alcanzabilidad.

    Una diferencia pequeña indica que la estructura de orden ya captura buena parte de la información topológica disponible bajo esta construcción.

    ¿Pero no puede explotar el número de conjuntos abiertos?

    Sí. Enumerar una topología finita completa puede resultar exponencial.

    Ésta no es una peculiaridad de R ni una implementación deficiente: es una propiedad combinatoria del problema.

    topologyR evita depender de esa enumeración para su decisión principal.

    Según la documentación, la conectividad se calcula sobre la base mediante el preorden de especialización con complejidad del orden de

    \[ O\!\left( n^2 \left\lceil \frac{B}{64} \right\rceil \right). \]

    Bitsets, C++ y operaciones a nivel de máquina

    El backend utiliza Rcpp y representa subconjuntos como arrays compactos de palabras de 64 bits.

    De ese modo, operaciones de conjuntos pueden ejecutarse como instrucciones binarias de bajo nivel.

    Hasta 64 puntos

    Una sola palabra de 64 bits puede representar el subconjunto completo.

    Hasta 128

    El backend utiliza dos palabras mediante despacho especializado en compilación.

    Hasta 192

    Tres palabras permiten mantener operaciones especializadas sin bucles generales.

    Tamaños mayores

    Una ruta dinámica permite manejar series arbitrariamente mayores, complementada con OpenMP donde esté disponible.

    El paquete incorpora además límites como max_base_sets y max_open_sets para detener de forma transparente operaciones de cierre que entren en regiones demasiado costosas.

    El caso de prueba: el ciclo económico estadounidense

    El trabajo acompañante aplica la metodología a 129 observaciones trimestrales de crecimiento real del PIB de Estados Unidos entre 1992 y 2024.

    El análisis bitopológico reporta una dirección de asimetría positiva, consistente con la hipótesis de expansiones más graduales y contracciones más abruptas.

    La topología no dirigida divide además la serie en seis componentes conectadas.

    Un detalle particularmente interesante aparece alrededor de la pandemia: la contracción de COVID-19 y el rebote posterior forman un único episodio topológico dentro de ese análisis.

    La geometría de visibilidad interpreta así la caída y recuperación en V como una sola estructura, en lugar de dos cambios completamente independientes.

    Qué produce topologyR

    No intenta pronosticar el próximo trimestre. No intenta estimar una elasticidad. Su resultado central es una clasificación estructural de la serie y de sus posibles fronteras internas.

    topologyR no es un sustituto de persistent homology

    El paquete se sitúa en una región específica de Topological Data Analysis.

    Bibliotecas como GUDHI, Ripser, TDAstats o scikit-TDA estudian estructuras multiescala mediante homología persistente.

    Allí interesan invariantes como:

    \[ \beta_0,\qquad \beta_1,\qquad \beta_2,\ldots \]

    donde \(\beta_0\) describe componentes conectadas, \(\beta_1\) ciclos o agujeros unidimensionales y \(\beta_2\) cavidades de dimensión superior.

    topologyR se concentra deliberadamente en \(\beta_0\): conectividad, aplicada a series unidimensionales mediante topologías inducidas por grafos.

    Pregunta Herramienta más natural
    ¿La serie aparece estructuralmente como una o varias componentes? topologyR
    ¿Existen ciclos, cavidades o estructuras persistentes a múltiples escalas? Persistent homology / TDA general
    ¿Existe una asimetría topológica entre pasado y futuro? Modo dirigido de topologyR
    ¿Queremos profundizar después de identificar componentes? Flujo híbrido: topologyR + persistent homology

    Los límites importan

    La documentación también identifica explícitamente dónde debe tenerse cuidado.

    HVG y NVG pueden discrepar

    El grafo elegido modifica la topología. Como NVG es más denso, normalmente tenderá a producir menos fragmentación que HVG.

    El muestreo importa

    Una frecuencia demasiado baja puede hacer aparecer separaciones que reflejen ausencia de observaciones más que una fractura estructural.

    El ruido también importa

    Pequeños solapamientos geométricos pueden generar conexiones que desaparecían bajo otra realización o frecuencia de muestreo.

    Sólo \(\beta_0\)

    La metodología está orientada a conectividad y fragmentación, no a capturar todas las estructuras topológicas posibles.

    Por eso, la propia documentación recomienda interpretar la conectividad como evidencia prima facie, especialmente en casos cercanos a la frontera.

    La matemática también fue formalizada

    Una característica poco habitual del proyecto es que el teorema central relacionado con la extensión dirigida de la construcción de Nada fue formalizado en Lean 4 utilizando Mathlib.

    Eso significa que una parte central de la arquitectura matemática no se apoya únicamente en una demostración escrita convencional, sino que también ha sido codificada en un sistema de demostración formal y verificada por el kernel del asistente.

    La documentación señala además que la implementación es compatible con CRAN, pasa R CMD check --as-cran y contiene 68 pruebas unitarias que abarcan los grafos de visibilidad, construcción topológica, conectividad, topología dirigida, Alexandrov y análisis bitopológico.

    Instalación y recursos

    El paquete requiere R 4.0.0 o posterior junto con Rcpp y ggplot2.

    El proyecto dispone de repositorio, wiki y artículo acompañante:

    El artículo acompañante se titula “Bitopological Spaces from Directed Graphs: Extending the Nada Construction to Capture Temporal Irreversibility”.

    La cuestión metodológica de fondo

    Gran parte de la modelización cuantitativa comienza después de una decisión que raramente se formula en voz alta: tratar los datos como una unidad coherente.

    Ajustamos una curva. Interpolamos un hueco. Calculamos una tendencia secular. Aplicamos un kernel a toda la muestra.

    topologyR intenta trasladar esa decisión desde el terreno de la costumbre al de una prueba estructural explícita.

    Primero observa las relaciones geométricas. Después construye la topología. Finalmente pregunta qué componentes emergen.

    Sólo entonces llega la discusión sobre qué modelo utilizar.

    Ésa es la propuesta central de topologyR: antes de imponer continuidad, suavidad o una estructura global sobre una serie, examinar si la topología inducida por sus relaciones de visibilidad respalda tratarla como una sola pieza. Y cuando incorporamos la dirección temporal, la misma maquinaria permite comparar la estructura hacia el futuro y hacia el pasado, convirtiendo la asimetría entre ambas en una caracterización topológica de irreversibilidad. No reemplaza a toda la topological data analysis; ocupa un lugar mucho más concreto: servir como guardián estructural antes de modelar.

    topologyR es desarrollado por José Mauricio Gómez Julián y distribuido bajo licencia MIT. El código, la documentación, la wiki y el artículo acompañante están disponibles en GitHub.

  • bayesianOU: Explorando la Gravitación de los Precios de Mercado Mediante el Proceso de Ornstein-Uhlenbeck

    bayesianOU: Explorando la Gravitación de los Precios de Mercado Mediante el Proceso de Ornstein-Uhlenbeck

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Economía política · Ornstein–Uhlenbeck · Inferencia bayesiana

    Cuando los precios gravitan: una mirada bayesiana a una vieja pregunta económica

    Cómo bayesianOU convierte la idea de un “centro de gravedad” de los precios en un modelo estadístico de reversión, incertidumbre, heterogeneidad sectorial y escalas temporales medibles.

    bayesianOU · R · Stan · desarrollado por José Mauricio Gómez Julián · GitHub

    Hay una pregunta que atraviesa la economía política clásica: los precios que observamos todos los días —ruidosos, cambiantes, sometidos a shocks—, ¿fluctúan alrededor de algún centro más estable?

    Smith y Ricardo, y posteriormente Marx dentro de su propia arquitectura teórica, trabajaron con la idea de que detrás del movimiento inmediato de los precios existen centros de gravitación de más largo plazo.

    En la formulación marxiana considerada por bayesianOU, la estructura puede tener dos niveles: los precios de mercado fluctúan alrededor de precios de producción y, a su vez, puede investigarse empíricamente si esos precios de producción muestran gravitación respecto de valores basados en trabajo.

    Pero una metáfora de “gravitación” no constituye por sí sola evidencia. Para hacerla científicamente útil necesitamos convertirla en cantidades observables: qué tan fuerte es la reversión, cuál es el centro, cuánto tarda una desviación en disiparse y cuánta incertidumbre existe sobre todo ello.

    La pregunta estadística

    No basta con preguntar si una serie “parece volver”. Necesitamos saber si podemos representarla mediante un proceso ruidoso pero anclado y, si es así, estimar la escala temporal sobre la que opera ese retorno.

    El puente entre la física y la economía: Ornstein–Uhlenbeck

    El núcleo matemático del paquete proviene de un objeto clásico de la física estocástica: el proceso de Ornstein–Uhlenbeck.

    Su intuición puede visualizarse como una partícula sometida a dos fuerzas. Una componente aleatoria la empuja constantemente en direcciones impredecibles; al mismo tiempo, una fuerza restauradora la atrae hacia un punto de equilibrio.

    En su forma básica:

    \[ dX_t = \kappa(\mu-X_t)\,dt + \sigma\,dW_t \]

    donde:

    • \(\mu\) es el nivel de equilibrio;
    • \(\kappa\) es la velocidad de reversión;
    • \(\sigma\) mide la intensidad del ruido;
    • \(dW_t\) representa el componente browniano aleatorio.

    Si \(X_t\) está por encima de \(\mu\), el término \(\kappa(\mu-X_t)\) lo empuja hacia abajo. Si está por debajo, lo empuja hacia arriba.

    Cuanto más lejos se encuentre del centro, mayor es la fuerza restauradora en el OU lineal convencional.

    La cantidad más intuitiva no es \(\kappa\): es la vida media

    La velocidad de reversión puede traducirse en una cantidad mucho más interpretable: la half-life o vida media de una desviación.

    \[ t_{1/2} = \frac{\ln 2}{\kappa} \]

    Éste es el tiempo necesario para que, en términos del proceso, aproximadamente la mitad de una desviación respecto del equilibrio desaparezca.

    Así podemos reemplazar una afirmación vaga como “los precios tienden a volver” por una afirmación cuantitativa: la escala de reequilibrio estimada es de tantos años.

    Por qué importa la half-life

    Una reversión con vida media de meses describe un mecanismo muy distinto de una reversión cuya vida media es comparable a una década. Ambas son técnicamente reversión, pero su significado económico es completamente diferente.

    Un OU económico necesita ser más flexible que el modelo de manual

    bayesianOU no se limita a insertar precios dentro de la ecuación básica de Ornstein–Uhlenbeck. Su modelo principal introduce varias extensiones para representar mejor datos económicos reales.

    Drift no lineal

    Una corrección cúbica permite que la fuerza de restauración cambie cuando la desviación respecto del equilibrio se vuelve grande. El mercado puede reaccionar suavemente cerca del centro y con más intensidad en los extremos.

    Volatilidad estocástica

    La intensidad del ruido no se supone constante. La volatilidad posee su propia dinámica temporal, permitiendo distinguir períodos tranquilos y turbulentos.

    Innovaciones Student-t

    Las colas pesadas permiten acomodar shocks extremos que una distribución normal consideraría extraordinariamente improbables.

    Pooling jerárquico

    Los sectores poseen parámetros propios, pero comparten información mediante distribuciones comunes. No se los trata ni como idénticos ni como universos completamente independientes.

    Acoplamiento temporalmente variable

    La intensidad con la que el precio de mercado sigue al precio de producción puede depender de la tasa general de ganancia, denominada TMG en el paquete.

    Inferencia conjunta

    Los parámetros no se estiman como una colección de regresiones desconectadas. La arquitectura se estima conjuntamente dentro de una posterior bayesiana.

    Por qué una corrección cúbica puede importar

    El OU convencional supone que la fuerza restauradora crece linealmente con la distancia al equilibrio.

    Pero un mercado podría comportarse de otra manera.

    Pequeñas desviaciones pueden persistir porque los costos de arbitraje, la información imperfecta o las fricciones vuelven innecesario corregirlas inmediatamente. Las desviaciones extremas, en cambio, pueden provocar respuestas mucho más intensas.

    Una representación esquemática sería:

    \[ dX_t = \left[ \kappa(\mu_t-X_t) + \beta_3(\mu_t-X_t)^3 \right]dt + \sigma_t\,dW_t \]

    El término cúbico permite que la dinámica se aparte de la proporcionalidad estrictamente lineal.

    Importa señalar, sin embargo, que la propia documentación describe esa no linealidad como una refinación menor en los datos analizados: su coeficiente permanece relativamente cerca de su prior.

    Los sectores no son clones

    Agricultura, manufactura, transporte o servicios pueden tener velocidades de ajuste, volatilidades y niveles de equilibrio diferentes.

    Estimar cada sector completamente por separado desperdiciaría la información compartida. Imponer un único parámetro a todos ellos borraría la heterogeneidad.

    El modelo jerárquico ocupa el espacio intermedio:

    \[ \kappa_i \sim p(\kappa\mid\eta), \]

    donde cada sector \(i\) conserva su propia velocidad de reversión, mientras los parámetros poblacionales \(\eta\) permiten partial pooling.

    Los sectores con menos información pueden aprender parcialmente del conjunto sin ser obligados a reproducir exactamente el comportamiento medio.

    El segundo modelo: una cascada de gravitación

    La arquitectura anidada es conceptualmente más ambiciosa.

    Precio de mercado observado y ruidoso
    Precio de producción estado latente y móvil
    Valor índice basado en contenido de trabajo

    El precio de mercado no revierte hacia una constante. Revierte hacia un precio de producción latente que también cambia con el tiempo.

    Ese segundo nivel puede, a su vez, modelarse como un proceso de reversión respecto de un índice observado de valor.

    Cada flecha posee su propia velocidad. El modelo introduce una separación de escalas donde la capa de mercado puede ajustarse más rápidamente que la capa subyacente de producción, mediante una restricción suave que deja margen para que los datos contradigan la expectativa.

    El resultado empírico más llamativo: el acoplamiento con valor

    La documentación reporta una estimación sobre 37 sectores de Estados Unidos entre 1960 y 2020.

    En ese ajuste, el coeficiente que conecta el precio de producción latente con el índice de valor aparece aproximadamente igual a uno en unidades estandarizadas, con probabilidad posterior de ser positivo esencialmente igual a uno.

    Esto es importante por una razón metodológica: el prior de ese acoplamiento estaba centrado en cero.

    Es decir, el modelo no incorporó como supuesto previo que el acoplamiento tuviera que ser positivo.

    Pero cuidado con la interpretación

    Este resultado es una estimación dentro de un conjunto de datos, parametrización y construcción de variables específicos. No constituye por sí solo una demostración general de la teoría del valor. Además, la propia documentación discute el componente costo-precio compartido entre las variables y propone un análisis de “wedge” para examinar esa objeción.

    Stan, HMC y por qué la inferencia importa tanto como la ecuación

    La complejidad del modelo hace imposible obtener una posterior completa mediante álgebra cerrada.

    bayesianOU utiliza Hamiltonian Monte Carlo mediante Stan y su algoritmo NUTS.

    HMC transforma conceptualmente la distribución posterior en una superficie de energía y utiliza una dinámica inspirada en la mecánica hamiltoniana para explorarla de manera más eficiente que un random walk Monte Carlo convencional.

    La implementación utiliza además paralelismo dentro de las cadenas mediante reduce_sum, algo especialmente útil cuando la likelihood debe acumular información sobre numerosos sectores y períodos.

    El paquete expone diagnósticos mediante validate_ou_fit(), incluyendo:

    • \(\hat R\);
    • effective sample size;
    • transiciones divergentes;
    • y otros diagnósticos habituales del ecosistema Stan.

    Dos tipos de convergencia que no deben confundirse

    La palabra “convergencia” aparece dos veces en este tipo de análisis, pero significa cosas completamente diferentes.

    Convergencia económica

    Pregunta si el precio revierte hacia algún centro y a qué velocidad. Se estudia mediante cantidades como \(\kappa\) y la half-life.

    Convergencia del sampler

    Pregunta si las cadenas MCMC exploraron correctamente la posterior. Se examina mediante \(\hat R\), ESS, divergencias y otros diagnósticos.

    Una cadena MCMC puede converger perfectamente aunque la evidencia económica indique una reversión extremadamente lenta.

    Y al contrario: una interpretación económica plausible no vale nada si el sampler no exploró adecuadamente la posterior.

    Comparación de modelos: PSIS-LOO, pero con una advertencia

    El paquete utiliza PSIS-LOO para comparación de modelos.

    Este procedimiento aproxima leave-one-out cross-validation mediante importance sampling sobre los draws posteriores, evitando tener que reestimar el modelo completo una vez por observación.

    Sin embargo, la documentación advierte que la presencia de un estado de volatilidad latente para cada observación puede volver optimista al LOO convencional.

    Esa advertencia es importante porque evita tratar una métrica de comparación como si estuviera libre de los supuestos del propio modelo.

    La validación fuera de muestra produce resultados incómodos

    La parte más interesante de la documentación aparece cuando el modelo se enfrenta a datos realmente reservados.

    La evaluación utiliza como período de prueba 2011–2020.

    Y los resultados reportados no favorecen de manera automática al modelo OU:

    • un random walk obtiene mejor desempeño de forecasting;
    • una restricción sin gravitación empata o supera al modelo;
    • el término de valor no agrega densidad predictiva detectable en esa prueba.

    En lugar de ocultar esos resultados, el paquete los pone en el centro de la discusión.

    ¿Significa eso que la gravitación fue refutada?

    No necesariamente, porque estimación estructural y forecasting responden preguntas diferentes.

    Imaginemos una vida media cercana a nueve años.

    En horizontes de uno o pocos años, el efecto restaurador será relativamente pequeño. Localmente, un proceso OU con \(\kappa\) bajo puede parecerse mucho a un random walk.

    Por tanto, que un random walk produzca mejores pronósticos de corto plazo no demuestra automáticamente que \(\kappa=0\).

    Dos preguntas distintas

    Estructural: ¿existe un mecanismo de reversión y cuál es su escala temporal?

    Predictiva: ¿qué modelo pronostica mejor el siguiente período?

    Para procesos de reversión muy lenta, ambas preguntas pueden producir respuestas diferentes sin contradicción lógica.

    Los controles negativos: ¿el modelo inventa gravitación?

    Una explicación de este tipo sólo resulta convincente si demostramos que el procedimiento no encuentra reversión inevitablemente.

    La documentación reporta controles negativos y simulaciones adversariales.

    Cuando el modelo recibe una verdadera caminata aleatoria, no devuelve artificialmente una reversión rápida: reporta una half-life de aproximadamente 50 años.

    Cuando se simula un acoplamiento nulo con valor, la posterior incluye correctamente cero.

    Es decir, el pipeline tiene capacidad para responder “no veo una gravitación informativa” cuando el proceso generador realmente carece de ella.

    La trampa de \(\kappa\) bajo

    El paquete denomina low-\(\kappa\) trap a una dificultad fundamental de cualquier estudio de reversión lenta.

    Cuando \(\kappa\rightarrow0\), el proceso OU se aproxima continuamente a una caminata aleatoria.

    Problema algebraico

    No existe una frontera interna clara entre reversión muy lenta y ausencia de reversión. En tiempo discreto, \(\kappa\to0\) corresponde a persistencia cercana a uno.

    Problema estadístico

    La potencia de los tests de raíz unitaria se deteriora precisamente cerca de esa frontera, especialmente con muestras finitas.

    Problema paramétrico

    Si el modelo restringe \(\kappa>0\), preguntar por \(P(\kappa>0)\) es trivial. La información real está en la distribución de la half-life y en su cola.

    Entonces, ¿qué hay que mirar?

    No simplemente si \(\kappa\) es positivo.

    Hay que observar la distribución de:

    \[ t_{1/2} = \frac{\ln 2}{\kappa} \]

    y preguntar qué probabilidad posterior existe de que la vida media exceda horizontes económicamente relevantes.

    La documentación señala incluso que al menos un sector conserva una probabilidad posterior no trivial de tener una half-life superior a 40 años.

    Esa cola no se elimina para producir un titular más limpio. Se reporta precisamente porque forma parte de lo que la muestra permite afirmar.

    Por qué el panel jerárquico puede ayudar

    Un test univariado observa una sola serie. El modelo jerárquico dispone de información conjunta procedente de múltiples sectores y períodos.

    En el caso documentado, la inferencia estructural utiliza 37 sectores y 61 años.

    El pooling permite que la evidencia acerca de las propiedades comunes de la reversión se comparta parcialmente entre sectores.

    Esto no elimina el problema de identificación cerca de la raíz unitaria, pero puede proporcionar más información que evaluar cada trayectoria completamente aislada.

    Buenas prácticas incorporadas al diseño

    Priors neutrales en hipótesis centrales

    Tanto el acoplamiento con la tasa de ganancia como el acoplamiento con valor poseen priors centradas en cero.

    Separación estricta train/test

    fit_window permite mantener separados los diseños estructural y predictivo, evitando filtración de información futura.

    Loadings calculados sólo en entrenamiento

    Los factores comunes utilizados en la evaluación fuera de muestra no incorporan accidentalmente información del período de prueba.

    Resultados negativos visibles

    La documentación no elimina el hecho de que el random walk vence al OU en forecasting durante la evaluación descrita.

    Los puntos débiles también están documentados

    La estimación de una half-life cercana a nueve años no debe leerse como una constante exacta.

    La propia documentación señala que el proceso previo de desagregación puede sesgar conservadoramente la velocidad hacia valores más lentos, de modo que la cifra real podría encontrarse más cerca de siete u ocho años dentro del ejercicio de validación descrito.

    También se reconocen otras limitaciones:

    • la no linealidad cúbica aporta relativamente poco en estos datos;
    • los grados de libertad Student-t y la escala de volatilidad estocástica pueden quedar débilmente identificados cuando ambos mecanismos están activos;
    • el resultado de acoplamiento con valor utiliza niveles estandarizados con un componente costo-precio compartido;
    • la defensa frente a esta última objeción depende de un análisis del “wedge” que un lector crítico debería examinar directamente.
    Una virtud metodológica

    Estos problemas no aparecen como excepciones escondidas al final. Forman parte explícita de la interpretación. Un modelo serio no sólo debe indicar dónde encuentra evidencia: también debe señalar dónde esa evidencia se vuelve frágil.

    Más allá de la teoría marxiana

    Las herramientas de bayesianOU son mucho más generales que su aplicación original.

    El mismo problema aparece siempre que estudiamos una variable que puede presentar reversión lenta, ruidosa y posiblemente hacia un objetivo cambiante.

    Área Problema análogo
    Tipos de interés Determinar si fluctúan alrededor de niveles de equilibrio persistentes pero móviles.
    Tipos de cambio reales Distinguir una raíz unitaria de una reversión extremadamente lenta.
    Materias primas Estudiar precios con shocks extremos, volatilidad variable y potenciales niveles fundamentales.
    Clima y medio ambiente Modelar variables que fluctúan alrededor de estados o tendencias dinámicas con memoria prolongada.
    Concentraciones de contaminantes Estimar cuánto tarda una perturbación en disiparse hacia un nivel de referencia.

    La cuestión de fondo

    La idea de gravitación puede sonar inicialmente metafórica. El proceso Ornstein–Uhlenbeck permite convertirla en algo mucho más concreto.

    Podemos estimar un centro. Podemos estimar una velocidad. Podemos traducir esa velocidad a una vida media. Podemos permitir que ese centro se mueva. Podemos permitir que diferentes sectores tengan dinámicas distintas. Podemos preguntar si otra variable modifica la fuerza restauradora.

    Pero la parte más importante quizá aparezca cuando la reversión es muy lenta.

    Cerca de \(\kappa=0\), las categorías simples empiezan a difuminarse. Una caminata aleatoria y un proceso que revierte a lo largo de décadas pueden ser extraordinariamente difíciles de distinguir con una muestra finita.

    Ahí la responsabilidad del modelo no es producir certeza artificial, sino representar la cola de incertidumbre con claridad.

    Ésa es la contribución metodológica más interesante de bayesianOU. Convierte la gravitación en una hipótesis cuantitativa que puede estimarse, compararse y potencialmente rechazarse; pero, al mismo tiempo, separa con cuidado la existencia estructural de reversión de la capacidad de forecasting de corto plazo, reconoce la trampa de la reversión lenta, publica los controles negativos y conserva los resultados que van contra una lectura demasiado triunfalista. El resultado no es una máquina para demostrar que los precios gravitan. Es un marco para preguntar, con bastante más precisión, si lo hacen, hacia qué, a qué velocidad y con cuánta incertidumbre.

    bayesianOU es desarrollado por José Mauricio Gómez Julián. El repositorio, la especificación matemática completa, los bloques de validación y las notas metodológicas están disponibles en GitHub.

  • Cuando Falla la Prueba de Hipótesis del Libro de Texto: Cómo HTDV Aporta Rigor a los Datos Dependientes y Desequilibrados.

    Cuando Falla la Prueba de Hipótesis del Libro de Texto: Cómo HTDV Aporta Rigor a los Datos Dependientes y Desequilibrados.

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Contrastes de hipótesis · Dependencia · Inferencia bayesiana

    Cuando las observaciones recuerdan el pasado: una introducción a HTDV

    Un paquete de R para contrastar hipótesis con datos dependientes, muestras desbalanceadas y tamaños finitos mediante triangulación bayesiana, inferencia HAR y block bootstrap.

    HTDV · Hypothesis Testing for Dependent Variables with Unbalanced Data · R · Stan · Licencia MIT · GitHub

    Imaginemos una pregunta aparentemente trivial: ¿la inflación media de un país es estadísticamente distinta de cero? Tenemos décadas de observaciones mensuales, así que un t-test parece una elección natural.

    Pero existe un problema. Enero no es estadísticamente ajeno a febrero. Las observaciones de una serie económica suelen conservar memoria del pasado. Cuando esa dependencia se ignora, el error estándar utilizado por el contraste puede quedar mal calibrado y la tasa real de falsos positivos superar ampliamente el 5 % que creemos estar utilizando.

    El mismo problema aparece en spreads financieros, rentabilidad sectorial, empleo regional, retornos, indicadores macroeconómicos y muchas otras series reales.

    Ahora agreguemos dos dificultades: los grupos que queremos comparar poseen tamaños diferentes y los datos pueden tener colas pesadas.

    Ése es el terreno para el que fue diseñado HTDV.

    La idea central

    HTDV no pide que confiemos en un único método robusto. Su estrategia es triangular la inferencia: ejecutar metodologías independientes y convertir tanto el acuerdo como el desacuerdo entre ellas en información sobre la solidez de nuestra conclusión.

    El verdadero problema no es solamente la media: es el error estándar

    Supongamos que queremos estimar una media \(\theta\). En un mundo de observaciones independientes, la incertidumbre de esa media puede calcularse mediante fórmulas familiares.

    Pero si las observaciones están correlacionadas, una muestra de cien datos no necesariamente contiene la misma cantidad de información que cien observaciones independientes.

    Si la serie se parece esquemáticamente a un AR(1),

    \[ X_t-\theta = \phi(X_{t-1}-\theta) + \varepsilon_t, \]

    entonces valores elevados de \(\phi\) implican que cada observación arrastra una fracción considerable de su pasado.

    Cuanto mayor es esa persistencia, menor puede ser la cantidad efectiva de información independiente que tenemos.

    Ésta es precisamente la zona donde los métodos asintóticos pueden parecer extraordinariamente precisos mientras sus intervalos son, en realidad, demasiado estrechos.

    Tres métodos mirando la misma evidencia

    HTDV organiza su análisis principal en tres capas inferenciales.

    Bayes + HMC

    Un modelo jerárquico representa explícitamente el proceso generador y su dependencia temporal. La posterior se obtiene mediante Hamiltonian Monte Carlo en Stan.

    HAR fixed-bandwidth

    Un contraste Wald inspirado en Kiefer y Vogelsang utiliza un ancho de banda fijo como proporción de la muestra y una distribución asintótica no estándar orientada a mejorar el comportamiento en muestras finitas.

    Stationary block bootstrap

    Remuestrea bloques de observaciones para preservar la dependencia temporal y construye la incertidumbre a partir de la distribución remuestreada.

    Existe además una cuarta capa para situaciones específicas: adaptive conformal inference, dirigida a predicción online cuando se desea evitar una especificación distribucional paramétrica.

    La discrepancia no es un fallo: puede ser el resultado más importante

    Lo natural sería pensar que, si tres métodos producen tres intervalos distintos, algo salió mal.

    HTDV adopta la interpretación contraria.

    Cuando Bayes, HAR y bootstrap coinciden, existe evidencia de que la conclusión es relativamente insensible al marco inferencial.

    Pero si la posterior bayesiana es mucho más amplia que los intervalos HAR o bootstrap, esa discrepancia puede estar revelando persistencia temporal suficientemente fuerte como para que las aproximaciones asintóticas estén funcionando mal en la muestra disponible.

    Una diferencia crucial

    Un intervalo más estrecho no siempre significa que sabemos más. También puede significar que el método está subestimando la incertidumbre.

    ¿Por qué no usar solamente Bayes?

    Porque los tres métodos poseen regiones donde su relación entre costo y desempeño puede ser diferente.

    HAR

    Es computacionalmente muy económico y puede estar bien calibrado cuando la persistencia es baja o moderada y el tamaño muestral permite que las aproximaciones asintóticas funcionen adecuadamente.

    Block bootstrap

    Conserva parte de la estructura de dependencia sin exigir una familia distribucional tan específica y sigue siendo comparativamente barato.

    Bayes jerárquico

    Tiene un costo computacional considerablemente mayor, pero representa explícitamente la dependencia y, según la validación del paquete, mantiene mejor la calibración en escenarios persistentes y finitos.

    La triangulación

    La utilidad no reside en coronar siempre al mismo ganador, sino en observar cuándo los métodos comienzan a separarse y qué característica de los datos parece producir esa separación.

    El estudio Monte Carlo: 1.024 escenarios para intentar romper el método

    La documentación incluye un estudio factorial pre-registrado que cruza distintas condiciones de:

    • tamaño muestral;
    • autocorrelación;
    • peso de las colas;
    • grado de desbalance entre las muestras;
    • y desplazamiento de localización.

    El diseño contiene 1.024 celdas con 500 repeticiones por celda para las tres capas inferenciales.

    Resultado documentado Valor Lectura
    Tamaño medio bayesiano 0.056 Cercano al objetivo nominal de 0.05 a través de la grilla.
    Cobertura media bayesiana 0.944 Cercana al objetivo nominal de 0.95.
    HAR bajo persistencia fuerte + n pequeño rechazo ≈ 0.60 Una tasa de rechazo bajo la nula muy superior al nivel nominal.
    Cobertura HAR en ese extremo 0.29 El intervalo cubre el valor verdadero mucho menos de lo esperado.

    El mensaje metodológico es incómodo pero importante: los intervalos HAR o bootstrap pueden ser más estrechos precisamente cuando deberían ser más anchos.

    La documentación resume esa situación de una manera particularmente útil: estrechez no implica necesariamente precisión; puede significar miscalibration.

    Pero ¿están los tres métodos intentando responder realmente la misma pregunta?

    Aquí aparece la parte más teórica del proyecto.

    Comparar métodos distintos sólo tiene sentido si existe alguna forma de establecer que sus objetos inferenciales pueden traducirse entre sí.

    HTDV organiza tres regímenes de convergencia.

    TAC — Triangular Arrays Convergence

    Representa situaciones donde la información aumenta mediante estructuras jerárquicas o triangulares de observaciones.

    WSC — Weighted Sums with Correlation

    Está pensado para observaciones vinculadas mediante una estructura de covarianza transversal, como regiones o mercados conectados.

    MPC — Mixingale Process Convergence

    Representa memoria temporal que decae gradualmente a medida que aumenta la distancia entre observaciones.

    La pregunta matemática

    ¿Podemos transportar una conclusión inferencial entre estos regímenes sin cambiar arbitrariamente el significado de la distancia estadística?

    El teorema de equivalencia métrica

    Según el marco teórico documentado por HTDV, bajo \(\alpha\)-mixing con decaimiento polinomial, condiciones de momentos finitos y una tasa \(\gamma>1\), TAC, WSC y MPC inducen métricas estrictamente equivalentes sobre el espacio de problemas de contraste de hipótesis.

    La idea de equivalencia no significa que las métricas sean numéricamente idénticas. Significa que pueden controlarse unas mediante otras a través de constantes finitas.

    El paquete expone esas constantes mediante:

    htdv_equivalence_constants()

    De acuerdo con la documentación, para un conjunto típico de parámetros como \(\gamma=2\), \(q=6\) y \(n=500\), el margen de conversión se sitúa alrededor del 18 %.

    Por qué importa

    La triangulación deja de ser solamente “corramos tres métodos y comparemos”. El teorema pretende proporcionar una base matemática para afirmar que las métricas asociadas a los tres regímenes pueden traducirse con un error finito y computable.

    La condición de dependencia: memoria, pero no memoria infinita

    El supuesto central es que la dependencia disminuye con la distancia.

    En términos simples, dos observaciones separadas por cien períodos deben compartir menos información que dos observaciones consecutivas.

    La documentación supone un decaimiento polinomial suficientemente rápido:

    \[ \alpha(k) \lesssim C k^{-\gamma}, \qquad \gamma>1. \]

    El requisito \(\gamma>1\) garantiza un decaimiento suficientemente fuerte para que la dependencia de largo alcance sea sumable bajo las condiciones del marco.

    La documentación sitúa dentro de este ámbito muchos procesos estacionarios habituales en econometría, entre ellos clases de ARMA, GARCH y cadenas de Markov.

    Pero existen límites importantes.

    Los procesos de memoria larga y los procesos con raíz unitaria no satisfacen esta arquitectura de la misma manera.

    HTDV puede ajustar series cercanas a una raíz unitaria y reflejar esa persistencia mediante una posterior más amplia, pero no pretende sustituir pruebas explícitas de raíz unitaria como ADF o Phillips-Perron.

    El motor bayesiano: modelar la dependencia en lugar de corregirla después

    El núcleo bayesiano utiliza Stan y el algoritmo NUTS, una variante de Hamiltonian Monte Carlo.

    La parametrización fundamental gira alrededor de tres cantidades:

    \[ \theta,\qquad \phi,\qquad \sigma, \]

    donde \(\theta\) representa el nivel o media relevante, \(\phi\) la dependencia AR(1) y \(\sigma\) la escala de innovación.

    Los parámetros asociados a la dependencia reciben priors jerárquicas débilmente informativas, de manera que el modelo regularice regiones problemáticas sin imponer de forma rígida el resultado.

    Cinco formas de construir la likelihood

    HTDV dispone de cinco backends de likelihood: los tres vinculados a TAC, WSC y MPC, además de dos familias conocidas de series temporales.

    Whittle likelihood

    Trabaja en el dominio de frecuencias y compara el periodograma observado con una densidad espectral teórica.

    Composite likelihood

    Trabaja en el dominio temporal combinando densidades condicionales de bloques relativamente pequeños.

    ¿Cuál elegir?

    La elección depende de si confiamos más en la representación espectral o en la estructura condicional del proceso.

    ¿Y si no estamos seguros?

    El paquete incorpora una envolvente robusta de Berger para reflejar explícitamente incertidumbre acerca de la especificación de likelihood.

    La envolvente robusta: incertidumbre sobre el modelo también es incertidumbre

    Supongamos que una likelihood Whittle y una composite likelihood producen posteriors algo diferentes.

    Elegir una de ellas únicamente porque nos gusta más vuelve invisible la incertidumbre de especificación.

    HTDV incorpora una Berger-robust envelope que combina información de múltiples modelos en una posterior más amplia, diseñada para proteger la inferencia frente al escenario menos favorable de especificación entre los modelos considerados.

    El principio es coherente con la filosofía general del paquete: si no sabemos con certeza qué modelo es correcto, esa duda debería ampliar nuestra incertidumbre, no desaparecer de ella.

    Una posterior no puede utilizarse hasta superar cinco puertas

    HTDV convierte los diagnósticos HMC en requisitos, no en recomendaciones opcionales.

    Split-\(\hat{R}<1.01\). Las cadenas deben mostrar convergencia adecuada.

    Bulk ESS > 400. Debe existir tamaño efectivo suficiente en el centro de la posterior.

    Tail ESS > 400. Las colas también necesitan información Monte Carlo suficiente.

    Cero divergencias post-warmup. Una geometría posterior problemática impide aceptar automáticamente el ajuste.

    E-BFMI > 0.3. La exploración de la energía por HMC debe superar el umbral establecido por el protocolo.

    Solamente después de superar esas puertas la posterior se considera admisible para la inferencia posterior del paquete.

    Validación externa: tres series conocidas

    Además de la simulación factorial, la documentación incluye tres benchmarks con datos de fuentes públicas.

    Serie Referencia comparativa Comportamiento documentado
    Inflación CPI de EE. UU. posterior a 1984 Stock y Watson (2007) Las tres capas reproducen la referencia.
    Log-CAPE de Shiller Campbell y Shiller (1998) Las tres capas reproducen la referencia.
    Diferencial de rendimiento EE. UU.–Canadá a 10 años Baseline Welch iid Las tres capas coinciden con la comparación de referencia.

    Lo interesante no es solamente que los métodos coincidan en la dirección general. Es cómo cambia la anchura de los intervalos conforme aumenta la persistencia.

    Persistencia aproximada Serie Anchura Bayes / HAR
    \(\phi\approx0.45\) Inflación 0.81×
    \(\phi\approx0.97\) CAPE 2.8×
    \(\phi\approx0.99\) Diferencial de rendimientos 15×

    Esa progresión es uno de los resultados empíricos centrales que destaca la documentación.

    Con persistencia moderada, Bayes puede incluso producir un intervalo más estrecho. Conforme \(\phi\) se aproxima a uno, la posterior se ensancha dramáticamente.

    HTDV interpreta ese ensanchamiento no como una debilidad, sino como la representación apropiada de cuánto menos puede aprenderse de una muestra finita extremadamente persistente.

    ¿Cuándo tiene sentido utilizar HTDV?

    Dependencia temporal

    Cuando las observaciones sucesivas no pueden tratarse razonablemente como independientes.

    Dependencia espacial

    Cuando unidades como regiones o mercados comparten una estructura de correlación.

    Muestras desbalanceadas

    Cuando los grupos comparados poseen cantidades de observaciones sustancialmente diferentes.

    Colas pesadas

    Cuando no resulta razonable asumir a priori que el comportamiento extremo puede ignorarse.

    Su objetivo es inferencial: contrastes, intervalos y estimación bajo incertidumbre.

    ¿Cuándo no usarlo?

    Si los datos son genuinamente independientes y poseen varianza finita, métodos clásicos más simples pueden ser suficientes y mucho más rápidos.

    El paquete tampoco está diseñado específicamente para:

    • procesos de memoria larga;
    • tests explícitos de raíz unitaria;
    • rupturas estructurales no segmentadas previamente;
    • forecasting como objetivo principal.

    HTDV es un marco de contraste de hipótesis y estimación bajo dependencia, no una biblioteca general de predicción de series temporales.

    Una arquitectura abierta para inspeccionar las decisiones

    El paquete expone la infraestructura que sustenta sus conclusiones.

    Entre sus herramientas se encuentran:

    • htdv_simstudy() para ejecutar simulaciones;
    • htdv_equivalence_constants() para las constantes del teorema;
    • diagnósticos HMC;
    • posterior predictive checks sobre dependencia;
    • decisiones basadas en ROPE;
    • Bayes factors mediante bridge sampling;
    • WAIC;
    • leave-future-out cross-validation;
    • predictive stacking.

    La intención es que las decisiones inferenciales puedan rastrearse hasta su fundamento metodológico y no aparezcan como salidas opacas de una caja negra.

    Instalación

    El paquete puede instalarse directamente desde GitHub:

    remotes::install_github(
      "IsadoreNabi/HTDV"
    )

    Según la documentación, rstan es su única dependencia dura. El repositorio contiene además la wiki, el estudio de validación, documentación matemática y scripts de reproducibilidad.

    La cuestión metodológica de fondo

    Existe una tendencia natural en investigación aplicada: elegir un método “robusto”, ejecutar el contraste y tratar su intervalo como si fuese una medida objetiva de cuánto sabemos.

    HTDV intenta hacer visible una dificultad más profunda: la calibración de un procedimiento depende del régimen en el que estamos utilizándolo.

    Un método asintóticamente válido puede comportarse mal cuando la muestra es pequeña y la dependencia es extrema. Otro puede resultar computacionalmente mucho más costoso, pero responder precisamente a esa zona problemática.

    Por eso el desacuerdo entre métodos no se elimina. Se conserva.

    Si los tres coinciden, tenemos una señal de robustez. Si comienzan a divergir al aumentar la persistencia, esa divergencia nos dice que estamos entrando en una región donde la inferencia depende mucho más de cómo representamos la dependencia.

    Ésta es la apuesta de HTDV: cuando ningún procedimiento inferencial domina universalmente en muestras finitas, la respuesta más informativa no consiste en escoger uno y ocultar los demás. Consiste en hacerlos trabajar en paralelo y convertir su desacuerdo en un diagnóstico. El producto final no es únicamente un valor p, un intervalo o una posterior. Es una medida más explícita de dónde nuestra inferencia parece sólida y dónde comienza a apoyarse en hielo asintótico.

    HTDV se distribuye bajo licencia MIT. El paquete, el artículo acompañante, los scripts de reproducibilidad, la validación completa y la documentación matemática están disponibles en GitHub.

  • Cuando Solo Vemos “El Todo”: Una Manera Bayesiana de Recuperar “Las Partes” con BayesianDisaggregation.

    Cuando Solo Vemos “El Todo”: Una Manera Bayesiana de Recuperar “Las Partes” con BayesianDisaggregation.

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R o RStudio.

    Inferencia bayesiana · Desagregación · Modelos de espacio de estados

    Conocemos el total, pero no las partes: el problema que enfrenta BayesianDisaggregation

    Cómo recuperar componentes sectoriales latentes a partir de un agregado conocido sin fingir que los datos contienen más información de la que realmente contienen.

    BayesianDisaggregation · R · Stan · Licencia MIT · desarrollado por José Mauricio Gómez Julián

    Tenemos un Índice de Precios al Consumidor nacional para cada año. Es un solo número. Pero nuestra investigación necesita algo mucho más desagregado: un índice para manufactura, otro para agricultura, otro para servicios, otro para construcción y así sucesivamente.

    Sabemos cuánto pesa cada sector dentro del agregado. Lo que no observamos directamente son las trayectorias sectoriales que, combinadas con esos pesos, producen el índice total.

    A primera vista parece un problema de contabilidad. En realidad es un problema inverso y subdeterminado.

    Y ésa es precisamente la dificultad que intenta abordar BayesianDisaggregation.

    La cuestión fundamental

    El problema no es si podemos fabricar alguna desagregación. Siempre podemos hacerlo introduciendo supuestos. La pregunta científicamente importante es: ¿podemos distinguir qué parte de la respuesta viene de los datos, qué parte viene de los supuestos y cuánta incertidumbre debemos conservar?

    El problema matemático: una ecuación, muchas incógnitas

    Supongamos que observamos un agregado \(y_t\) en cada período \(t\). También conocemos los pesos \(w_{tk}\) de cada uno de los \(K\) sectores.

    Si \(\phi_{tk}\) representa el índice sectorial latente, la relación fundamental puede escribirse, de manera esquemática, como:

    \[ y_t \approx \sum_{k=1}^{K} w_{tk}\phi_{tk} \]

    o, en forma vectorial,

    \[ y_t \approx \mathbf{w}_t^{\top}\boldsymbol{\phi}_t \]

    La dificultad aparece inmediatamente. En cada período observamos una ecuación, pero queremos conocer \(K\) valores sectoriales.

    El agregado determina una combinación lineal concreta de los sectores, pero deja \(K-1\) direcciones sin determinar directamente.

    Ejemplo mínimo

    Con cuatro sectores tenemos cuatro índices desconocidos, pero solamente una suma ponderada observada. Existen muchas combinaciones sectoriales distintas capaces de producir exactamente el mismo agregado.

    No existe un algoritmo capaz de hacer desaparecer esa falta de información. Para separar las partes tenemos que introducir estructura: suavidad temporal, distribución inicial, dinámica sectorial o algún otro conocimiento previo.

    En lenguaje bayesiano, eso significa que el prior necesariamente desempeña un papel importante en las dimensiones que los datos no identifican.

    Una historia poco habitual en software estadístico: borrar y empezar de nuevo

    La historia del paquete es metodológicamente interesante porque su primera familia de métodos, la serie 0.1.x, fue posteriormente auditada por su propio autor y eliminada.

    Esa versión se presentaba como una forma de desagregación bayesiana sin MCMC basada en actualizaciones deterministas sobre una matriz previa de pesos.

    El problema no era que el código fallara. Era más serio: producía resultados aparentemente plausibles mientras varios elementos fundamentales del procedimiento no hacían lo que pretendían.

    La auditoría documentó seis defectos.

    F1

    El agregado observado no entraba en el cálculo. La supuesta posterior dependía de la matriz previa, no del CPI observado.

    F2

    La concentración Dirichlet que debía controlar la dispersión se cancelaba al renormalizar.

    F3

    El componente diseñado para introducir estructura temporal también desaparecía algebraicamente durante la normalización.

    F4

    Un término presentado como medida de eficiencia resultaba ser constante y no dependía realmente de la calidad de los datos o del ajuste.

    F5

    No existían pruebas de recuperación con datos sintéticos y verdad conocida que comprobaran si el procedimiento recuperaba las partes.

    F6

    Una función de correlación calculaba Pearson y Spearman y reportaba automáticamente el mayor, introduciendo selección silenciosa del resultado.

    F1 era decisivo. Si una supuesta posterior bayesiana no condiciona en la observación, no está realizando actualización bayesiana respecto de esos datos.

    La solución elegida no fue colocar parches alrededor de la arquitectura anterior. La familia 0.1.x fue eliminada y sustituida por modelos en los que el agregado observado aparece explícitamente dentro de la likelihood.

    El cambio conceptual: el agregado tiene que ser evidencia

    La nueva formulación trata el CPI no como una identidad que se impone después de construir los sectores, sino como una observación generada por ellos.

    Es decir, el modelo pregunta: si éstas fueran las trayectorias sectoriales latentes, ¿qué tan probable sería observar el agregado que efectivamente observamos?

    En el motor principal, una representación esquemática de la observación es:

    \[ y_t \sim t_{\nu} \left( \sum_{k=1}^{K}w_{tk}\phi_{tk}, \sigma_y \right) \]

    La suma ponderada sectorial es ahora el centro de la distribución del CPI observado.

    Eso cambia todo. Cada nueva observación del agregado modifica la distribución de probabilidades sobre las trayectorias sectoriales.

    La salida deja de ser un único conjunto de números y pasa a ser una distribución posterior sobre las partes latentes.

    Dos motores bayesianos para dos compromisos distintos

    BayesianDisaggregation ofrece dos motores. Ambos condicionan en los datos, pero intercambian velocidad, flexibilidad y supuestos de manera diferente.

    State-space MCMC

    Trabaja con los índices sectoriales en espacio logarítmico, incorpora jerarquías entre sectores y permite una likelihood Student-t robusta a observaciones extremas.

    Conjugado lineal-gaussiano

    Trabaja en niveles y aprovecha la conjugación para calcular la posterior exactamente mediante filtrado y suavizado de Kalman, sin necesidad de MCMC.

    Motor 1: un modelo de espacio de estados con MCMC

    En el motor canónico, los índices sectoriales viven en espacio logarítmico. Esto garantiza positividad: un índice de precios no puede terminar accidentalmente tomando un valor negativo.

    Cada sector evoluciona aproximadamente como un random walk con deriva:

    \[ \log \phi_{t,k} = \log \phi_{t-1,k} + \mu_k + \eta_{t,k} \]

    donde \(\mu_k\) representa la deriva propia del sector y \(\eta_{t,k}\) su innovación temporal.

    Pero los sectores no son tratados como universos completamente independientes.

    Pooling parcial de las derivas

    Cada sector conserva su propia tasa media de evolución, pero las derivas proceden de una distribución común y pueden compartir información.

    Pooling parcial de las volatilidades

    Las escalas de innovación sectoriales también pertenecen a una estructura jerárquica, permitiendo estimaciones más estables sin obligarlas a ser iguales.

    Dispersión inicial estimable

    La heterogeneidad transversal en el período inicial es ahora un verdadero parámetro del modelo, no una cantidad que desaparece durante una renormalización.

    Observación robusta

    Una likelihood Student-t permite acomodar observaciones agregadas atípicas con mayor robustez que una observación estrictamente gaussiana.

    Debido a la transformación logarítmica, la estructura jerárquica y la likelihood Student-t, el modelo no posee una solución conjugada simple. Se estima mediante Hamiltonian Monte Carlo en Stan.

    La implementación comprueba diagnósticos como \(\hat{R}\) y transiciones divergentes, y devuelve draws posteriores de cada índice sectorial en cada período.

    Motor 2: Bayes exacto sin MCMC

    El segundo motor demuestra algo conceptualmente importante: “sin MCMC” y “no bayesiano” no son sinónimos.

    Si formulamos el problema como un sistema lineal-gaussiano, la posterior puede calcularse analíticamente.

    En este caso los sectores evolucionan en niveles:

    \[ \boldsymbol{\phi}_t = \boldsymbol{\phi}_{t-1} + \mathbf{d} + \boldsymbol{\omega}_t \]

    y el agregado se observa mediante:

    \[ y_t = \mathbf{w}_t^{\top}\boldsymbol{\phi}_t + \varepsilon_t \]

    con errores gaussianos.

    El filtro de Kalman avanza en el tiempo actualizando la distribución de los estados latentes a medida que observa cada agregado. Después, el suavizador Rauch-Tung-Striebel recorre la serie hacia atrás y refina las distribuciones utilizando también información futura.

    Si queremos muestras conjuntas de la posterior completa, el paquete utiliza el simulation smoother de Durbin-Koopman.

    Esas muestras conservan la dependencia entre sectores y entre períodos: no son una colección de aproximaciones marginales independientes.

    Exactitud matemática o riqueza del modelo: el intercambio es explícito

    Característica State-space MCMC Lineal-gaussiano
    Inferencia HMC / Stan Posterior conjugada exacta
    Estados Log índices Índices en niveles
    Positividad Garantizada por la transformación log No garantizada estrictamente
    Observación robusta Student-t disponible Gaussiana
    Jerarquía entre sectores No
    MCMC No
    Diagnósticos de convergencia Necesarios No aplican
    Velocidad Mayor costo computacional Mucho más directo

    La parte más importante: el modelo no puede identificar lo que los datos no contienen

    Construir una posterior legítima no elimina la subdeterminación original.

    El agregado sigue proporcionando una combinación lineal por período. Las otras \(K-1\) direcciones necesitan ser regularizadas mediante la dinámica temporal y los priors.

    Eso implica que las distribuciones posteriores de los sectores pueden ser anchas y sensibles al prior.

    Ésta no es una anomalía que deba esconderse.

    Identificación débil

    Si el agregado identifica bien la suma pero no determina de manera única cómo se reparte esa suma entre sectores, una posterior sectorial muy estrecha sería sospechosa. La incertidumbre amplia es parte de la respuesta estadística.

    Los tests de recuperación muestran exactamente esa diferencia

    La documentación genera datos sintéticos a partir del propio proceso generador del modelo, de modo que se conocen de antemano las trayectorias sectoriales verdaderas.

    Esto permite comprobar por separado aquello que está fuertemente identificado y aquello que no.

    Objeto Resultado documentado Interpretación
    Agregado reconstruido Correlación superior a \(0.95\), con frecuencia próxima a \(1\) El agregado está fuertemente identificado por los datos.
    Cobertura sectorial Aproximadamente \(0.84\) en las pruebas descritas Las bandas son deliberadamente amplias y reconocen la identificación débil.
    Umbral exigido por el test Cobertura superior a \(0.70\) La prueba adopta un criterio conservador en lugar de exigir una falsa precisión.

    En otras palabras: la suma puede recuperarse con mucha precisión sin que cada una de las partes pueda recuperarse con igual precisión.

    No hay contradicción. Es exactamente lo que esperaríamos de un problema subdeterminado.

    Entonces, ¿para qué sirven unas estimaciones sectoriales inciertas?

    Porque los índices desagregados no tienen por qué ser el final del análisis. Pueden convertirse en entradas para un segundo modelo.

    Y aquí aparece otro principio importante: la incertidumbre de la primera etapa debe sobrevivir a la segunda.

    BayesianDisaggregation utiliza las muestras posteriores como imputaciones múltiples.

    Cada draw representa una posible configuración sectorial compatible con los datos y el modelo. El análisis posterior puede ejecutarse sobre muchas de esas configuraciones y combinar después los resultados mediante las reglas de Rubin.

    El efecto conceptual es sencillo: no sustituimos la distribución sectorial por su media y fingimos que ésta es conocida sin error.

    \[ p(\boldsymbol{\phi}\mid y,W) \quad\longrightarrow\quad \left\{ \boldsymbol{\phi}^{(1)}, \boldsymbol{\phi}^{(2)}, \ldots, \boldsymbol{\phi}^{(M)} \right\} \quad\longrightarrow\quad \text{análisis posterior} \]

    La nube de incertidumbre viaja con los datos desagregados.

    Incluso el sesgo downstream se mide, en lugar de esconderse

    La documentación reconoce además una consecuencia específica para el programa de investigación en el que se utiliza el paquete.

    Debido a que la desagregación es subdeterminada, el prior suavizador tipo random walk puede diluir cierta señal de reversión cuando los índices desagregados alimentan posteriormente un modelo Ornstein-Uhlenbeck.

    En las evaluaciones descritas, esa velocidad de reversión puede quedar sesgada hacia valores más lentos en aproximadamente 13–26 %.

    La dirección es conservadora según la documentación: la reversión verdadera sería al menos tan rápida como la estimada. También se reporta una fracción de información faltante propagada cercana a \(0.4\).

    La importancia metodológica no reside únicamente en los números concretos. Reside en que la limitación se mide, se documenta y se transmite al análisis posterior.

    Tres capas de validación para tres tipos distintos de error

    El paquete separa deliberadamente varios niveles de testing.

    Smoke tests. Comprueban que los dos motores compilen, funcionen y devuelvan la estructura correcta de dimensiones períodos × sectores × draws.

    Recovery tests. Generan datos sintéticos con verdad conocida y preguntan si el modelo recupera correctamente el agregado y proporciona cobertura razonable para las trayectorias sectoriales.

    Golden tests. Utilizan generate_quantities de Stan sobre draws congelados y exigen coincidencia exacta con una referencia también congelada.

    Los golden tests cumplen una función particularmente estricta: si una modificación cambia cantidades derivadas que deberían permanecer invariantes, el test puede detectar incluso diferencias bit a bit.

    Una filosofía de testing

    No basta con comprobar que un paquete “corre sin errores”. También hay que comprobar que recupera aquello que debería recuperar y que continúa calculando mañana exactamente lo que calculaba hoy cuando nada metodológico ha cambiado.

    ¿Por qué no usar simplemente RAS, Chow-Lin o reconciliación de pronósticos?

    Porque resuelven problemas relacionados, pero no idénticos.

    Tradición Qué hace Diferencia respecto de BayesianDisaggregation
    RAS / IPF Ajusta iterativamente matrices para hacer coincidir márgenes. Es un procedimiento determinista de balanceo; no produce una posterior sobre componentes latentes.
    Denton / Chow-Lin / Fernández Desagregan temporalmente una serie de baja frecuencia. Resuelven, por ejemplo, anual → trimestral, no necesariamente la recuperación transversal de sectores ocultos.
    MinT y reconciliación Ajustan pronósticos jerárquicos para que sean coherentes entre sí. Parten de pronósticos disponibles y los reconcilian; no infieren componentes latentes desde un único agregado observado.
    Modelos composicionales Modelan pesos o participaciones que evolucionan sobre el simplex. La variable latente principal son las participaciones, no necesariamente los niveles sectoriales condicionados por su suma ponderada.

    La documentación es cuidadosa con la afirmación de novedad: no declara ser “la primera” solución. Formula una proposición más estrecha: el autor no encontró en las tradiciones adyacentes una herramienta que realizara exactamente la misma combinación de desagregación transversal bayesiana, condicionamiento en el agregado y posterior propagable.

    Los datos también necesitan disciplina

    El paquete incorpora utilidades para trabajar con archivos reales de CPI y matrices de pesos.

    El lector de CPI puede identificar encabezados habituales en inglés y español —como date, fecha, year, año, CPI, índice o price—, manejar formatos numéricos localizados y consolidar años duplicados.

    El lector de pesos normaliza las participaciones sectoriales para que formen un simplex en cada período, mientras que las funciones de alineamiento garantizan que agregado y pesos cubran los mismos años antes de estimar.

    Una advertencia sencilla, pero fundamental: índice no es tasa

    El modelo trabaja con niveles del índice.

    Esto significa que introducir la tasa de inflación en lugar del nivel del CPI constituye un error conceptual.

    Si el lado derecho del modelo representa una suma ponderada de índices sectoriales en niveles, el agregado observado debe estar expresado en la misma clase de magnitud.

    No confundir

    CPI = nivel de un índice.
    Inflación = tasa de cambio de ese índice.
    No son intercambiables dentro de la ecuación de observación.

    La lección más interesante quizá no sea estadística

    Hay una enseñanza más amplia en la historia de BayesianDisaggregation.

    El error más peligroso en software estadístico no siempre produce un mensaje rojo, un crash o un número absurdo.

    A veces produce exactamente lo contrario: resultados suaves, plausibles y convincentes que no representan lo que creemos que representan.

    La versión 0.1.x devolvía números. El problema era que el dato que debía actualizar la inferencia no estaba participando en ella.

    Eso sólo se hizo evidente cuando se introdujo algo aparentemente básico: generar datos cuya verdad se conocía y preguntar si el método podía recuperarla.

    Al fallar esa prueba, la decisión fue eliminar la arquitectura y reconstruir el paquete alrededor de un modelo que sí condicionara en las observaciones.

    La idea central de BayesianDisaggregation no es prometer que un problema subdeterminado deja mágicamente de serlo porque utilicemos Bayes. Es exactamente la contraria. El agregado identifica con fuerza aquello que realmente contiene; la separación sectorial permanece débilmente identificada y depende en parte de la estructura previa. Una inferencia rigurosa debe mostrar esa diferencia, devolver intervalos suficientemente amplios y permitir que esa incertidumbre continúe hacia cualquier análisis posterior. El objetivo no es fabricar precisión: es representar fielmente cuánto sabemos.

    BayesianDisaggregation es un paquete de R desarrollado por José Mauricio Gómez Julián y distribuido bajo licencia MIT. El motor MCMC utiliza Stan. El código fuente, la documentación, las instrucciones de instalación y la wiki están disponibles en GitHub.

  • Detectando Cuándo Cambia el Mundo: Un Análisis Profundo del Paquete R RegimeChange

    Detectando Cuándo Cambia el Mundo: Un Análisis Profundo del Paquete R RegimeChange

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Series temporales · Changepoints · Inferencia bayesiana

    ¿Cuándo cambió realmente el sistema? Una introducción a RegimeChange

    Un paquete de R que reúne métodos clásicos, bayesianos y de deep learning para detectar cambios de régimen, cuantificar su incertidumbre y distinguir una transición real de una simple fluctuación aleatoria.

    RegimeChange · R · Código abierto · GitHub

    Una línea de producción funciona con normalidad y, de pronto, los sensores comienzan a verse distintos. Ninguna observación individual parece imposible, pero algo cambió. Un economista observa décadas de crecimiento y sospecha que el país dejó atrás un régimen para entrar en otro. Un médico sigue una serie de signos vitales y necesita saber cuándo la estabilidad comienza a convertirse en deterioro.

    En los tres casos la pregunta estadística es esencialmente la misma: ¿en qué momento el proceso dejó de comportarse como antes?

    Éste es el problema de la detección de cambios de régimen, también conocida como changepoint detection.

    RegimeChange intenta abordarlo mediante una biblioteca única que reúne métodos que normalmente aparecen dispersos entre varios paradigmas y paquetes: estadística frecuentista, inferencia bayesiana, detección secuencial y, opcionalmente, deep learning.

    La pregunta fundamental

    Toda serie fluctúa. El problema es determinar cuándo una fluctuación es solamente ruido dentro del mismo régimen y cuándo constituye evidencia de que el sistema pasó a un estado estadísticamente diferente.

    Detectar un cambio significa decidir cuánto error estamos dispuestos a tolerar

    La dificultad aparece porque ninguna regla de detección puede escapar por completo de dos clases de error.

    Falsa alarma — Error tipo I

    Declaramos que hubo un cambio cuando el proceso simplemente estaba atravesando una fluctuación normal. En una fábrica puede significar detener innecesariamente una línea de producción.

    Cambio no detectado — Error tipo II

    El sistema sí cambió, pero el algoritmo no genera una alarma. Dependiendo de la aplicación, esto puede significar reaccionar demasiado tarde ante una crisis, un brote o un deterioro operativo.

    El umbral de detección regula ese compromiso. Un umbral bajo detectará cambios rápidamente, pero también puede producir muchas falsas alarmas. Uno muy alto será más conservador, aunque puede reconocer el cambio demasiado tarde.

    No existe un umbral universalmente correcto: depende del costo práctico de cada error.

    Tres familias metodológicas bajo una misma interfaz

    RegimeChange organiza sus algoritmos en tres familias principales.

    Frecuentistas

    Incluyen CUSUM, PELT, Binary Segmentation, WBS, FPOP, E-Divisive, Kernel CPD y NOT. Cubren desde cambios simples en la media hasta transformaciones complejas de la distribución.

    Bayesianos

    BOCPD y Shiryaev-Roberts permiten representar probabilísticamente la incertidumbre acerca de cuándo ocurrió el cambio y, en contextos online, actualizar esa evidencia a medida que llegan datos.

    Deep learning

    Autoencoders, TCN, Transformers y Contrastive Predictive Coding amplían la detección hacia patrones temporales complejos y no lineales.

    CUSUM: dejar que la evidencia se acumule

    CUSUM —Cumulative Sum— es uno de los métodos clásicos de detección secuencial.

    La intuición es especialmente clara. Mientras el proceso permanece en el mismo régimen, las desviaciones positivas y negativas respecto de un nivel de referencia tienden a compensarse.

    Pero si la media cambia, las desviaciones comienzan a acumularse persistentemente en una dirección.

    Cuando esa acumulación supera un umbral, se genera una alarma.

    Intuición de CUSUM

    Una observación extraña puede no significar nada. Muchas desviaciones consecutivas en la misma dirección sí comienzan a constituir evidencia de un cambio.

    Su complejidad es lineal, \(O(n)\), y resulta especialmente natural para monitoreo online y detección de cambios en la media.

    PELT: encontrar múltiples cambios sin probar cada partición posible

    Cuando existe más de un cambio, la dificultad aumenta. Debemos decidir simultáneamente cuántos segmentos existen y dónde comienzan y terminan.

    PELT —Pruned Exact Linear Time— utiliza programación dinámica para buscar la segmentación global que minimiza una función de costo, incorporando al mismo tiempo una penalización por introducir demasiados cambios.

    La penalización es importante: sin ella, el modelo podría mejorar artificialmente su ajuste dividiendo la serie en un número excesivo de segmentos.

    RegimeChange permite criterios como:

    • BIC;
    • AIC;
    • MBIC;
    • MDL;
    • o una penalización numérica especificada manualmente.

    El mecanismo de pruning elimina posiciones candidatas que ya no pueden producir la solución óptima, permitiendo que PELT alcance complejidad promedio cercana a \(O(n)\) bajo las condiciones correspondientes.

    No todo cambio se parece a un salto limpio en la media

    RegimeChange incorpora métodos adicionales porque distintos cambios dejan firmas estadísticas diferentes.

    Binary Segmentation

    Localiza un cambio, divide la serie y repite recursivamente. Es rápido, aunque su estrategia greedy no garantiza el óptimo global.

    Wild Binary Segmentation

    Busca cambios sobre numerosos subintervalos aleatorios y puede mejorar la localización cuando existen varios changepoints próximos.

    FPOP

    Utiliza poda funcional y funciones de costo por tramos para realizar particionamiento óptimo.

    E-Divisive

    Emplea estadísticas de energía y permite detectar cambios más generales en la distribución sin imponer una forma paramétrica específica.

    Kernel CPD

    Traslada la información a un espacio de características mediante kernels para capturar cambios distribucionales complejos.

    NOT

    Narrowest-Over-Threshold está orientado a localizar cambios con precisión mediante intervalos que superan un umbral.

    BOCPD: en lugar de preguntar “¿cambió?”, preguntar “¿qué probabilidad hay de que haya cambiado?”

    La aproximación bayesiana cambia profundamente la forma del resultado.

    Bayesian Online Changepoint Detection mantiene en cada instante una distribución posterior sobre el llamado run length: cuántas observaciones han transcurrido desde el último cambio.

    Cuando llega una nueva observación, existen esencialmente dos posibilidades:

    • el régimen continúa y el run length aumenta;
    • ocurre un cambio y el run length vuelve a cero.

    Una función de riesgo —hazard function— controla la probabilidad previa de que ocurra un cambio en cada instante.

    El resultado es especialmente útil porque BOCPD no devuelve únicamente un indicador binario. Produce una probabilidad posterior de cambio a lo largo del tiempo.

    RegimeChange implementa distintas familias conjugadas, entre ellas Normal-Gamma para media y varianza desconocidas, Normal con varianza conocida, Gamma-Poisson para conteos y Normal-Wishart para datos multivariados.

    Y cuando la relación temporal es demasiado compleja: deep learning

    Algunos cambios no se manifiestan como una modificación simple de media, varianza o tendencia.

    Para esos casos el paquete incorpora, como módulos opcionales, métodos de aprendizaje profundo.

    Autoencoders

    Aprenden a reconstruir el comportamiento normal. Si cambia el régimen, aumenta el error de reconstrucción.

    Temporal Convolutional Networks

    Utilizan convoluciones causales dilatadas para capturar dependencias temporales de largo alcance.

    Transformers

    Aplican mecanismos de self-attention para representar relaciones temporales distantes.

    Contrastive Predictive Coding

    Aprende representaciones auto-supervisadas y busca cambios importantes en el espacio de embeddings resultante.

    Existe además un modo ensemble que exige acuerdo entre múltiples detectores antes de declarar un cambio.

    La interfaz única: cambiar de método sin cambiar de lógica

    Una de las decisiones prácticas más importantes del paquete es que los algoritmos principales pueden llamarse desde detect_regimes().

    library(RegimeChange)
    
    set.seed(42)
    
    data <- c(
      rnorm(200, 0, 1),
      rnorm(200, 2, 1)
    )
    
    # PELT
    result <- detect_regimes(
      data,
      method = "pelt"
    )
    
    print(result)
    plot(result)

    Para pasar a un detector bayesiano:

    result <- detect_regimes(
      data,
      method = "bocpd",
      prior = normal_gamma(
        mu0 = 0,
        kappa0 = 1,
        alpha0 = 1,
        beta0 = 1
      )
    )

    Y para monitoreo online con CUSUM:

    result <- detect_regimes(
      data,
      method = "cusum",
      mode = "online",
      threshold = 5
    )

    El usuario puede especificar si busca cambios en media, varianza, ambas, tendencia o distribución, además del número esperado de cambios y el criterio de penalización.

    Offline y online son problemas relacionados, pero no idénticos

    En modo offline ya conocemos la serie completa. Queremos reconstruir retrospectivamente cuándo ocurrieron los cambios.

    En modo online, en cambio, los datos llegan uno por uno. La pregunta es si debemos generar una alarma ahora.

    detector <- regime_detector(
      method = "bocpd",
      prior = normal_gamma(),
      threshold = 0.5
    )
    
    for (x in data_stream) {
    
      detector <- update(detector, x)
    
      if (detector$last_result$alarm) {
    
        message(
          "Changepoint detected at time ",
          detector$last_result$t
        )
    
        detector <- reset(detector)
      }
    }

    Esa arquitectura es relevante para aplicaciones como vigilancia epidemiológica, control industrial, detección de fraude o monitoreo financiero.

    El mundo real tiene outliers, colas pesadas y autocorrelación

    Aquí aparece uno de los puntos más interesantes del paquete. Muchos procedimientos clásicos funcionan mejor cuando las observaciones son aproximadamente independientes y la distribución no contiene contaminación severa.

    Los datos reales rara vez cooperan tanto.

    El modo robusto de PELT puede combinar varias defensas.

    Winsorización

    Limita el impacto de observaciones extremas recortándolas según cuantiles configurables.

    Pérdidas robustas

    Puede utilizar Huber M-estimation o Tukey biweight en lugar de pérdida cuadrática convencional.

    Escala Qn

    Emplea el estimador robusto de Rousseeuw y Croux, diseñado para mantener alta resistencia frente a contaminación.

    Modo automático

    robust = "auto" examina indicadores de contaminación y selecciona un nivel de robustez apropiado.

    Para series autocorrelacionadas, correct_ar = TRUE estima una estructura AR(1) y pre-blanquea la serie antes de ejecutar la detección.

    La idea es evitar que una dependencia temporal ordinaria sea confundida con evidencia de un cambio estructural.

    ¿Qué muestran los benchmarks documentados?

    La wiki del paquete reporta una comparación con paquetes establecidos de R en 17 escenarios y 50 repeticiones por escenario.

    Escenario Resultado reportado para RegimeChange Comparación documentada
    Promedio general F1 = 0.804 El selector automático obtuvo el mayor F1 medio de los métodos evaluados.
    Datos contaminados F1 = 0.998 Frente a 0.479 para PELT estándar del paquete de referencia indicado en la documentación.
    Cambio sutil de varianza 2:1 F1 = 0.667 Frente a 0.400 en los paquetes de referencia reportados.
    Autocorrelación fuerte, AR = 0.7 F1 = 0.900 Frente a 0.720 en la comparación documentada.
    Resumen de escenarios Ganó o empató en 16 de 17 La pérdida restante fue reportada como marginal, de 0.017 en un escenario de colas pesadas.
    Cómo leer estos resultados

    Son resultados de los benchmarks descritos en la documentación del paquete. No implican que RegimeChange vaya a superar a cualquier alternativa en cualquier conjunto de datos. El comportamiento real depende del tipo de cambio, la contaminación, la autocorrelación, el tamaño muestral y la parametrización.

    No basta con saber dónde: también importa saber cuán seguros estamos

    Decir que un cambio ocurrió en la observación 200 parece preciso, pero puede dar una falsa sensación de certeza.

    RegimeChange diferencia al menos dos dimensiones.

    Incertidumbre sobre la localización

    Para los métodos frecuentistas puede utilizar block bootstrap: se remuestrean bloques para preservar dependencia local, se vuelve a ejecutar la detección y se obtiene una distribución de las posiciones estimadas.

    A partir de ella pueden construirse intervalos de confianza para la localización del changepoint.

    Incertidumbre sobre la existencia del cambio

    En BOCPD la pregunta puede plantearse directamente en términos probabilísticos: ¿qué probabilidad posterior existe de que un cambio haya ocurrido en este momento?

    Esa información puede ser más útil operacionalmente que un simple “sí/no”, especialmente cuando las decisiones dependen del costo de una falsa alarma.

    R por fuera, Julia por dentro cuando hace falta velocidad

    El paquete incorpora un backend opcional en Julia para varios de sus algoritmos principales.

    init_julia()
    
    julia_available()

    Según la documentación, el backend incluye implementaciones de PELT, FPOP, BOCPD, CUSUM, Kernel CPD, WBS y PELT multivariado.

    Para conjuntos grandes el paquete puede despachar automáticamente el cálculo hacia Julia, mientras mantiene la interfaz en R. Si Julia no está disponible, vuelve a la implementación en R.

    La implementación también incorpora técnicas de estabilidad numérica como el algoritmo de Welford para media y varianza acumuladas, suma compensada de Kahan y cálculos en dominio logarítmico para evitar underflow en BOCPD.

    Evaluar un detector también requiere más de una métrica

    Cuando conocemos los changepoints verdaderos —por ejemplo en simulaciones— RegimeChange puede evaluar los resultados mediante varias medidas.

    metrics <- evaluate(
      result,
      true_changepoints = c(100, 250),
      tolerance = 10
    )
    
    print(metrics)

    El marco incluye:

    • precision;
    • recall;
    • F1;
    • distancia de Hausdorff;
    • Rand Index;
    • Adjusted Rand Index;
    • covering metric.

    compare_methods() permite además aplicar varios algoritmos a la misma serie y compararlos bajo un formato común.

    ¿Qué método elegir?

    Situación Opción sugerida por la documentación
    Datos limpios y cambios claros de media PELT
    Outliers o colas pesadas PELT con robust = TRUE o "auto"
    Serie autocorrelacionada PELT con correct_ar = TRUE
    Detección en tiempo real BOCPD o CUSUM
    Necesitamos probabilidad de cambio BOCPD
    Queremos un enfoque no paramétrico E-Divisive o Kernel CPD
    Patrones complejos y no lineales Métodos de deep learning
    No sabemos qué método elegir Ensemble o method = "auto"

    Instalación

    RegimeChange puede instalarse desde GitHub:

    # install.packages("devtools")
    
    devtools::install_github(
      "IsadoreNabi/RegimeChange"
    )

    La documentación indica R 4.0.0 o posterior como requisito base. El backend Julia es opcional y requiere Julia 1.6 o posterior junto con JuliaCall. Los detectores de deep learning requieren keras y tensorflow.

    La cuestión de fondo: ¿cuánta sorpresa hace falta para decir que el mundo cambió?

    Hay una forma interesante de interpretar todo este problema.

    Cada nueva observación proporciona evidencia acerca de dos posibilidades: el sistema sigue funcionando bajo el mismo régimen o algo cambió.

    Los distintos métodos formalizan esa evidencia de maneras diferentes. CUSUM la acumula. PELT busca la segmentación óptima. BOCPD actualiza una distribución posterior. Los detectores neuronales observan cuándo una representación aprendida deja de describir bien los datos nuevos.

    Pero la pregunta conceptual permanece: ¿la desviación que estamos viendo es suficientemente improbable bajo el régimen anterior como para justificar afirmar que el proceso ya no es el mismo?

    Y en aplicaciones reales esa respuesta nunca depende exclusivamente de la estadística. También depende de qué cuesta equivocarse.

    Ésa es la apuesta de RegimeChange: convertir la detección de cambios de régimen en un problema que pueda abordarse desde varios paradigmas sin abandonar una interfaz común, incorporando robustez, cuantificación de incertidumbre, evaluación comparativa y detección online. El objetivo no es simplemente señalar un punto rojo sobre una serie temporal, sino responder con mayor rigor tres preguntas: si realmente hubo un cambio, dónde ocurrió y cuánta confianza deberíamos depositar en esa conclusión.

    RegimeChange está disponible en GitHub. La documentación del paquete incluye guías de introducción, detección offline, métodos bayesianos y benchmarks comparativos.