
Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.
ESCUCHA ESTE POST COMO PODCAST
Cuando las observaciones recuerdan el pasado: una introducción a HTDV
Un paquete de R para contrastar hipótesis con datos dependientes, muestras desbalanceadas y tamaños finitos mediante triangulación bayesiana, inferencia HAR y block bootstrap.
Imaginemos una pregunta aparentemente trivial: ¿la inflación media de un país es estadísticamente distinta de cero? Tenemos décadas de observaciones mensuales, así que un t-test parece una elección natural.
Pero existe un problema. Enero no es estadísticamente ajeno a febrero. Las observaciones de una serie económica suelen conservar memoria del pasado. Cuando esa dependencia se ignora, el error estándar utilizado por el contraste puede quedar mal calibrado y la tasa real de falsos positivos superar ampliamente el 5 % que creemos estar utilizando.
El mismo problema aparece en spreads financieros, rentabilidad sectorial, empleo regional, retornos, indicadores macroeconómicos y muchas otras series reales.
Ahora agreguemos dos dificultades: los grupos que queremos comparar poseen tamaños diferentes y los datos pueden tener colas pesadas.
Ése es el terreno para el que fue diseñado HTDV.
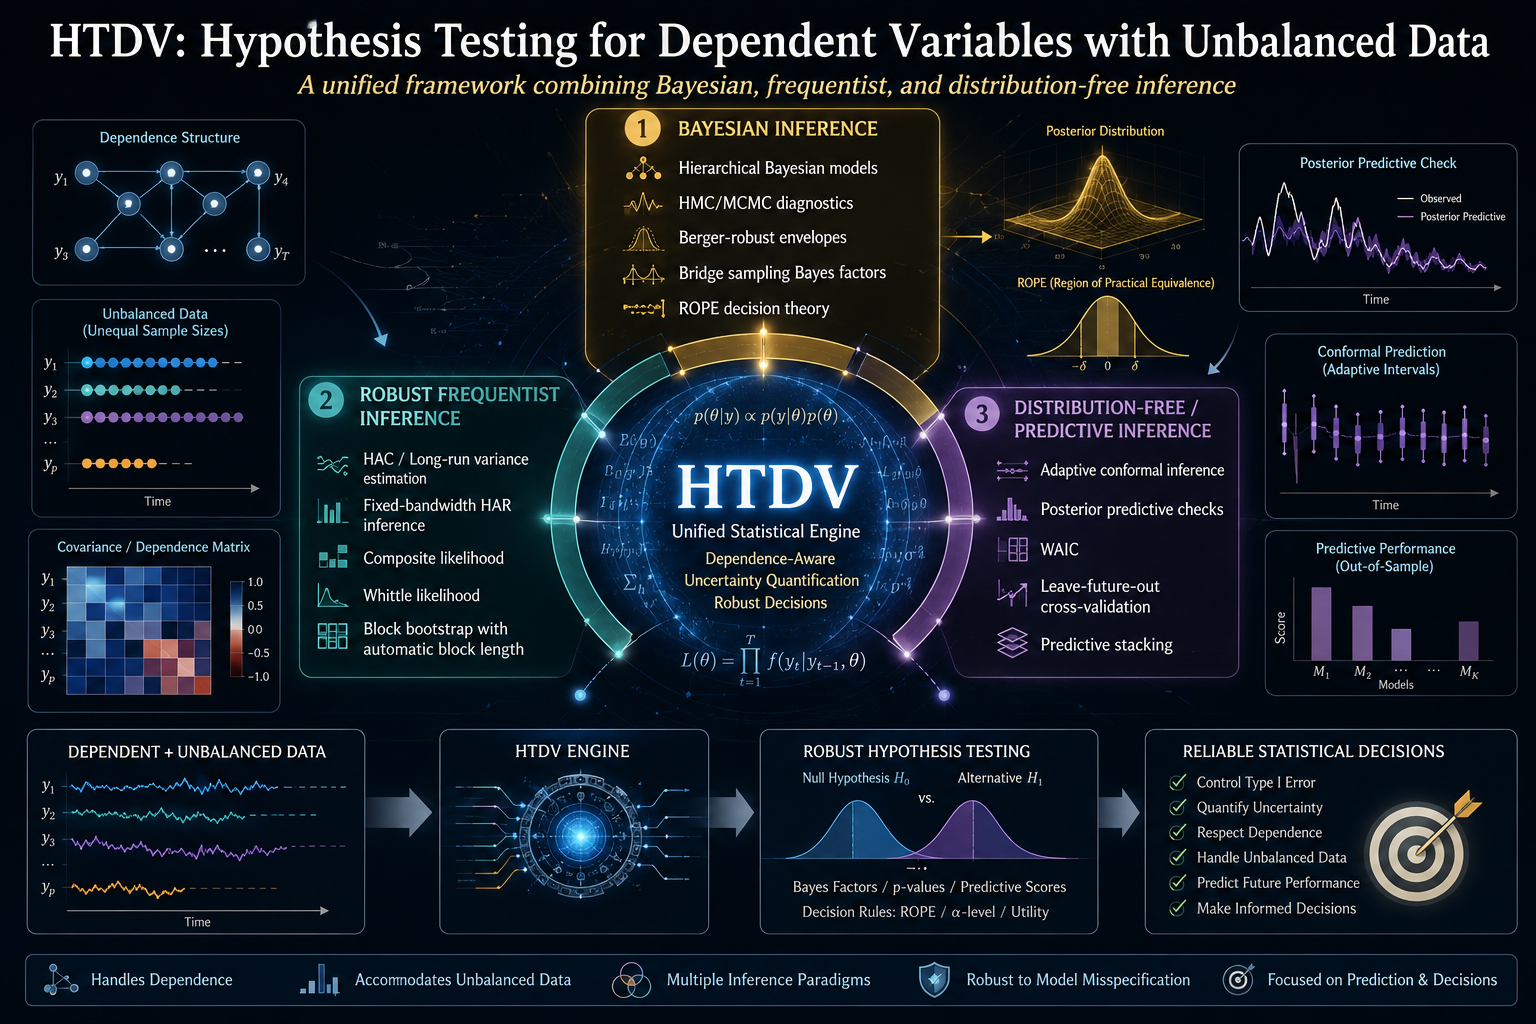
HTDV no pide que confiemos en un único método robusto. Su estrategia es triangular la inferencia: ejecutar metodologías independientes y convertir tanto el acuerdo como el desacuerdo entre ellas en información sobre la solidez de nuestra conclusión.
El verdadero problema no es solamente la media: es el error estándar
Supongamos que queremos estimar una media \(\theta\). En un mundo de observaciones independientes, la incertidumbre de esa media puede calcularse mediante fórmulas familiares.
Pero si las observaciones están correlacionadas, una muestra de cien datos no necesariamente contiene la misma cantidad de información que cien observaciones independientes.
Si la serie se parece esquemáticamente a un AR(1),
entonces valores elevados de \(\phi\) implican que cada observación arrastra una fracción considerable de su pasado.
Cuanto mayor es esa persistencia, menor puede ser la cantidad efectiva de información independiente que tenemos.
Ésta es precisamente la zona donde los métodos asintóticos pueden parecer extraordinariamente precisos mientras sus intervalos son, en realidad, demasiado estrechos.
Tres métodos mirando la misma evidencia
HTDV organiza su análisis principal en tres capas inferenciales.
Bayes + HMC
Un modelo jerárquico representa explícitamente el proceso generador y su dependencia temporal. La posterior se obtiene mediante Hamiltonian Monte Carlo en Stan.
HAR fixed-bandwidth
Un contraste Wald inspirado en Kiefer y Vogelsang utiliza un ancho de banda fijo como proporción de la muestra y una distribución asintótica no estándar orientada a mejorar el comportamiento en muestras finitas.
Stationary block bootstrap
Remuestrea bloques de observaciones para preservar la dependencia temporal y construye la incertidumbre a partir de la distribución remuestreada.
Existe además una cuarta capa para situaciones específicas: adaptive conformal inference, dirigida a predicción online cuando se desea evitar una especificación distribucional paramétrica.
La discrepancia no es un fallo: puede ser el resultado más importante
Lo natural sería pensar que, si tres métodos producen tres intervalos distintos, algo salió mal.
HTDV adopta la interpretación contraria.
Cuando Bayes, HAR y bootstrap coinciden, existe evidencia de que la conclusión es relativamente insensible al marco inferencial.
Pero si la posterior bayesiana es mucho más amplia que los intervalos HAR o bootstrap, esa discrepancia puede estar revelando persistencia temporal suficientemente fuerte como para que las aproximaciones asintóticas estén funcionando mal en la muestra disponible.
Un intervalo más estrecho no siempre significa que sabemos más. También puede significar que el método está subestimando la incertidumbre.
¿Por qué no usar solamente Bayes?
Porque los tres métodos poseen regiones donde su relación entre costo y desempeño puede ser diferente.
Es computacionalmente muy económico y puede estar bien calibrado cuando la persistencia es baja o moderada y el tamaño muestral permite que las aproximaciones asintóticas funcionen adecuadamente.
Conserva parte de la estructura de dependencia sin exigir una familia distribucional tan específica y sigue siendo comparativamente barato.
Tiene un costo computacional considerablemente mayor, pero representa explícitamente la dependencia y, según la validación del paquete, mantiene mejor la calibración en escenarios persistentes y finitos.
La utilidad no reside en coronar siempre al mismo ganador, sino en observar cuándo los métodos comienzan a separarse y qué característica de los datos parece producir esa separación.
El estudio Monte Carlo: 1.024 escenarios para intentar romper el método
La documentación incluye un estudio factorial pre-registrado que cruza distintas condiciones de:
- tamaño muestral;
- autocorrelación;
- peso de las colas;
- grado de desbalance entre las muestras;
- y desplazamiento de localización.
El diseño contiene 1.024 celdas con 500 repeticiones por celda para las tres capas inferenciales.
| Resultado documentado | Valor | Lectura |
|---|---|---|
| Tamaño medio bayesiano | 0.056 | Cercano al objetivo nominal de 0.05 a través de la grilla. |
| Cobertura media bayesiana | 0.944 | Cercana al objetivo nominal de 0.95. |
| HAR bajo persistencia fuerte + n pequeño | rechazo ≈ 0.60 | Una tasa de rechazo bajo la nula muy superior al nivel nominal. |
| Cobertura HAR en ese extremo | 0.29 | El intervalo cubre el valor verdadero mucho menos de lo esperado. |
El mensaje metodológico es incómodo pero importante: los intervalos HAR o bootstrap pueden ser más estrechos precisamente cuando deberían ser más anchos.
La documentación resume esa situación de una manera particularmente útil: estrechez no implica necesariamente precisión; puede significar miscalibration.
Pero ¿están los tres métodos intentando responder realmente la misma pregunta?
Aquí aparece la parte más teórica del proyecto.
Comparar métodos distintos sólo tiene sentido si existe alguna forma de establecer que sus objetos inferenciales pueden traducirse entre sí.
HTDV organiza tres regímenes de convergencia.
Representa situaciones donde la información aumenta mediante estructuras jerárquicas o triangulares de observaciones.
Está pensado para observaciones vinculadas mediante una estructura de covarianza transversal, como regiones o mercados conectados.
Representa memoria temporal que decae gradualmente a medida que aumenta la distancia entre observaciones.
¿Podemos transportar una conclusión inferencial entre estos regímenes sin cambiar arbitrariamente el significado de la distancia estadística?
El teorema de equivalencia métrica
Según el marco teórico documentado por HTDV, bajo \(\alpha\)-mixing con decaimiento polinomial, condiciones de momentos finitos y una tasa \(\gamma>1\), TAC, WSC y MPC inducen métricas estrictamente equivalentes sobre el espacio de problemas de contraste de hipótesis.
La idea de equivalencia no significa que las métricas sean numéricamente idénticas. Significa que pueden controlarse unas mediante otras a través de constantes finitas.
El paquete expone esas constantes mediante:
htdv_equivalence_constants()De acuerdo con la documentación, para un conjunto típico de parámetros como \(\gamma=2\), \(q=6\) y \(n=500\), el margen de conversión se sitúa alrededor del 18 %.
La triangulación deja de ser solamente “corramos tres métodos y comparemos”. El teorema pretende proporcionar una base matemática para afirmar que las métricas asociadas a los tres regímenes pueden traducirse con un error finito y computable.
La condición de dependencia: memoria, pero no memoria infinita
El supuesto central es que la dependencia disminuye con la distancia.
En términos simples, dos observaciones separadas por cien períodos deben compartir menos información que dos observaciones consecutivas.
La documentación supone un decaimiento polinomial suficientemente rápido:
El requisito \(\gamma>1\) garantiza un decaimiento suficientemente fuerte para que la dependencia de largo alcance sea sumable bajo las condiciones del marco.
La documentación sitúa dentro de este ámbito muchos procesos estacionarios habituales en econometría, entre ellos clases de ARMA, GARCH y cadenas de Markov.
Pero existen límites importantes.
Los procesos de memoria larga y los procesos con raíz unitaria no satisfacen esta arquitectura de la misma manera.
HTDV puede ajustar series cercanas a una raíz unitaria y reflejar esa persistencia mediante una posterior más amplia, pero no pretende sustituir pruebas explícitas de raíz unitaria como ADF o Phillips-Perron.
El motor bayesiano: modelar la dependencia en lugar de corregirla después
El núcleo bayesiano utiliza Stan y el algoritmo NUTS, una variante de Hamiltonian Monte Carlo.
La parametrización fundamental gira alrededor de tres cantidades:
donde \(\theta\) representa el nivel o media relevante, \(\phi\) la dependencia AR(1) y \(\sigma\) la escala de innovación.
Los parámetros asociados a la dependencia reciben priors jerárquicas débilmente informativas, de manera que el modelo regularice regiones problemáticas sin imponer de forma rígida el resultado.
Cinco formas de construir la likelihood
HTDV dispone de cinco backends de likelihood: los tres vinculados a TAC, WSC y MPC, además de dos familias conocidas de series temporales.
Trabaja en el dominio de frecuencias y compara el periodograma observado con una densidad espectral teórica.
Trabaja en el dominio temporal combinando densidades condicionales de bloques relativamente pequeños.
La elección depende de si confiamos más en la representación espectral o en la estructura condicional del proceso.
El paquete incorpora una envolvente robusta de Berger para reflejar explícitamente incertidumbre acerca de la especificación de likelihood.
La envolvente robusta: incertidumbre sobre el modelo también es incertidumbre
Supongamos que una likelihood Whittle y una composite likelihood producen posteriors algo diferentes.
Elegir una de ellas únicamente porque nos gusta más vuelve invisible la incertidumbre de especificación.
HTDV incorpora una Berger-robust envelope que combina información de múltiples modelos en una posterior más amplia, diseñada para proteger la inferencia frente al escenario menos favorable de especificación entre los modelos considerados.
El principio es coherente con la filosofía general del paquete: si no sabemos con certeza qué modelo es correcto, esa duda debería ampliar nuestra incertidumbre, no desaparecer de ella.
Una posterior no puede utilizarse hasta superar cinco puertas
HTDV convierte los diagnósticos HMC en requisitos, no en recomendaciones opcionales.
Split-\(\hat{R}<1.01\). Las cadenas deben mostrar convergencia adecuada.
Bulk ESS > 400. Debe existir tamaño efectivo suficiente en el centro de la posterior.
Tail ESS > 400. Las colas también necesitan información Monte Carlo suficiente.
Cero divergencias post-warmup. Una geometría posterior problemática impide aceptar automáticamente el ajuste.
E-BFMI > 0.3. La exploración de la energía por HMC debe superar el umbral establecido por el protocolo.
Solamente después de superar esas puertas la posterior se considera admisible para la inferencia posterior del paquete.
Validación externa: tres series conocidas
Además de la simulación factorial, la documentación incluye tres benchmarks con datos de fuentes públicas.
| Serie | Referencia comparativa | Comportamiento documentado |
|---|---|---|
| Inflación CPI de EE. UU. posterior a 1984 | Stock y Watson (2007) | Las tres capas reproducen la referencia. |
| Log-CAPE de Shiller | Campbell y Shiller (1998) | Las tres capas reproducen la referencia. |
| Diferencial de rendimiento EE. UU.–Canadá a 10 años | Baseline Welch iid | Las tres capas coinciden con la comparación de referencia. |
Lo interesante no es solamente que los métodos coincidan en la dirección general. Es cómo cambia la anchura de los intervalos conforme aumenta la persistencia.
| Persistencia aproximada | Serie | Anchura Bayes / HAR |
|---|---|---|
| \(\phi\approx0.45\) | Inflación | 0.81× |
| \(\phi\approx0.97\) | CAPE | 2.8× |
| \(\phi\approx0.99\) | Diferencial de rendimientos | 15× |
Esa progresión es uno de los resultados empíricos centrales que destaca la documentación.
Con persistencia moderada, Bayes puede incluso producir un intervalo más estrecho. Conforme \(\phi\) se aproxima a uno, la posterior se ensancha dramáticamente.
HTDV interpreta ese ensanchamiento no como una debilidad, sino como la representación apropiada de cuánto menos puede aprenderse de una muestra finita extremadamente persistente.
¿Cuándo tiene sentido utilizar HTDV?
Cuando las observaciones sucesivas no pueden tratarse razonablemente como independientes.
Cuando unidades como regiones o mercados comparten una estructura de correlación.
Cuando los grupos comparados poseen cantidades de observaciones sustancialmente diferentes.
Cuando no resulta razonable asumir a priori que el comportamiento extremo puede ignorarse.
Su objetivo es inferencial: contrastes, intervalos y estimación bajo incertidumbre.
¿Cuándo no usarlo?
Si los datos son genuinamente independientes y poseen varianza finita, métodos clásicos más simples pueden ser suficientes y mucho más rápidos.
El paquete tampoco está diseñado específicamente para:
- procesos de memoria larga;
- tests explícitos de raíz unitaria;
- rupturas estructurales no segmentadas previamente;
- forecasting como objetivo principal.
HTDV es un marco de contraste de hipótesis y estimación bajo dependencia, no una biblioteca general de predicción de series temporales.
Una arquitectura abierta para inspeccionar las decisiones
El paquete expone la infraestructura que sustenta sus conclusiones.
Entre sus herramientas se encuentran:
htdv_simstudy()para ejecutar simulaciones;htdv_equivalence_constants()para las constantes del teorema;- diagnósticos HMC;
- posterior predictive checks sobre dependencia;
- decisiones basadas en ROPE;
- Bayes factors mediante bridge sampling;
- WAIC;
- leave-future-out cross-validation;
- predictive stacking.
La intención es que las decisiones inferenciales puedan rastrearse hasta su fundamento metodológico y no aparezcan como salidas opacas de una caja negra.
Instalación
El paquete puede instalarse directamente desde GitHub:
remotes::install_github(
  "IsadoreNabi/HTDV"
)
Según la documentación, rstan es su única dependencia dura.
El repositorio contiene además la wiki, el estudio de validación,
documentación matemática y scripts de reproducibilidad.
La cuestión metodológica de fondo
Existe una tendencia natural en investigación aplicada: elegir un método “robusto”, ejecutar el contraste y tratar su intervalo como si fuese una medida objetiva de cuánto sabemos.
HTDV intenta hacer visible una dificultad más profunda: la calibración de un procedimiento depende del régimen en el que estamos utilizándolo.
Un método asintóticamente válido puede comportarse mal cuando la muestra es pequeña y la dependencia es extrema. Otro puede resultar computacionalmente mucho más costoso, pero responder precisamente a esa zona problemática.
Por eso el desacuerdo entre métodos no se elimina. Se conserva.
Si los tres coinciden, tenemos una señal de robustez. Si comienzan a divergir al aumentar la persistencia, esa divergencia nos dice que estamos entrando en una región donde la inferencia depende mucho más de cómo representamos la dependencia.
HTDV se distribuye bajo licencia MIT. El paquete, el artículo acompañante, los scripts de reproducibilidad, la validación completa y la documentación matemática están disponibles en GitHub.
Leave a Comment/Deja un Comentario