Espartaco

“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”

Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290

26,533 views since December 2020

26,533 visitas desde diciembre de 2020

EnglishEspañol

Categoría: Metamatemática, Matemática Pura y Matemática Aplicada

  • Extracción de Señales del Ruido: Cómo SignalY Aborda Tres Problemas Complejos en Datos de Panel

    Extracción de Señales del Ruido: Cómo SignalY Aborda Tres Problemas Complejos en Datos de Panel

    Puedes también encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Econometría · Extracción de señales · Series temporales multivariadas

    Del ruido a la estructura: cómo SignalY busca la señal oculta en datos complejos

    Un paquete de R que reúne selección bayesiana de variables, descubrimiento de factores, wavelets, descomposición empírica, filtrado bayesiano y pruebas de persistencia en un mismo flujo para paneles y series temporales multivariadas.

    Desarrollado por José Mauricio Gómez Julián · Licencia MIT · GitHub

    Imaginemos una matriz con cincuenta columnas y apenas unos cientos de observaciones. Cada columna representa un indicador macroeconómico, financiero o político. Sabemos que, en alguna parte de esa matriz, existe una señal que merece nuestra atención. El problema es que también hay ruido, redundancia, tendencias comunes y variables que parecen importantes únicamente porque se mueven junto con otras.

    Entonces aparecen tres preguntas distintas, pero estrechamente conectadas: ¿qué variables importan realmente?, ¿qué estructura latente existe detrás de ellas? y ¿qué tan persistentes son las señales que terminamos extrayendo?

    Normalmente responderlas obliga a saltar entre varios paquetes: uno para selección de variables, otro para PCA, otro para filtros, otro para pruebas de raíz unitaria y otro para visualizar resultados.

    SignalY nace precisamente para reducir esa fragmentación. Su idea no es inventar de nuevo cada uno de esos métodos, sino organizarlos dentro de un marco coherente donde las diferentes etapas del análisis puedan comunicarse entre sí.

    La idea en una frase

    SignalY intenta convertir una tarea fragmentada — seleccionar, descomponer y caracterizar una señal— en un único flujo reproducible de análisis estadístico.

    Tres preguntas, tres pilares

    Selección: ¿cuáles de todas las variables disponibles contienen información estructural y cuáles pueden considerarse principalmente ruido?

    Descomposición: una vez identificada o construida la señal, ¿qué parte corresponde a tendencia, ciclos de distintas frecuencias y fluctuaciones residuales?

    Persistencia: ¿los componentes extraídos son estacionarios, poseen raíz unitaria o se encuentran en una zona fronteriza cercana a la no estacionariedad?

    Primer pilar: ¿qué variables importan?

    En un problema de alta dimensión podemos tener decenas de predictores, aunque sólo unos pocos contengan la señal que realmente interesa. Una regresión convencional puede intentar asignar un coeficiente a todos, pero con muestras moderadas eso abre rápidamente la puerta al sobreajuste.

    SignalY aborda el problema mediante regresión bayesiana dispersa con prior Horseshoe.

    La intuición detrás de la Horseshoe

    La prior Horseshoe pertenece a la familia de priors global-local shrinkage. Su objetivo es ejercer mucha presión sobre los coeficientes pequeños —probablemente asociados a ruido— y, simultáneamente, permitir que las señales fuertes escapen de esa contracción.

    Podemos representar la idea esquemáticamente como:

    $$ \beta_j \sim \mathcal{N} \left( 0, \tau^2 \lambda_j^2 \right) $$

    donde $\tau$ controla la contracción global y $\lambda_j$ permite una adaptación local para cada coeficiente.

    Si la evidencia a favor de una variable es débil, la fuerza global puede empujar su coeficiente hacia cero. Si existe una señal suficientemente fuerte, su parámetro local puede permitir que sobreviva.

    La intuición

    En lugar de preguntar “¿incluyo o elimino esta variable?” antes de estimar, la Horseshoe plantea algo más gradual: ¿cuánto debe contraerse cada coeficiente dada la información disponible?

    Una posterior no selecciona variables por sí sola

    Ajustar una prior de contracción es apenas la primera parte del problema. Todavía necesitamos convertir las distribuciones posteriores en alguna regla práctica para determinar qué variables conservar.

    SignalY incluye cuatro estrategias distintas.

    Projection predictive selection

    Proyecta la distribución posterior del modelo completo sobre modelos más pequeños y busca el subconjunto mínimo cuyo desempeño predictivo permanezca suficientemente próximo al modelo de referencia.

    Intervalos creíbles

    Conserva variables cuyos intervalos posteriores no incluyen cero. Es una estrategia sencilla de interpretar, aunque puede resultar conservadora cuando la dimensión es alta.

    Selección por contracción

    Utiliza la intensidad de shrinkage —representada mediante cantidades como $\kappa$— para detectar qué variables consiguieron escapar sustancialmente de la contracción.

    Selección por magnitud

    Aplica un filtro basado directamente en el tamaño del efecto, útil como cribado inicial o como complemento a las decisiones bayesianas.

    La ventaja de ofrecer las cuatro dentro del mismo sistema es que el investigador puede comprobar hasta qué punto una selección depende de una única definición de “variable importante”.

    Otra pregunta: quizá las cincuenta variables sean la manifestación de tres factores

    No todo problema de alta dimensión exige seleccionar columnas individualmente. A veces muchas variables son expresiones diferentes de unos pocos procesos latentes.

    SignalY incorpora dos estrategias para explorar esta posibilidad.

    PCA + block bootstrap

    La componente principal resume variación común, mientras que el bootstrap por bloques intenta respetar la dependencia temporal al construir medidas de incertidumbre.

    Dynamic Factor Model

    Utiliza criterios de información de Bai y Ng para determinar el número de factores estáticos y posteriormente modela su evolución mediante un VAR.

    Topología informacional

    El módulo de PCA incorpora además análisis basados en entropía para caracterizar el contenido informativo de los componentes extraídos.

    La diferencia es importante. PCA ayuda a encontrar direcciones de máxima variación común. Un modelo factorial dinámico intenta además describir cómo evolucionan temporalmente esos factores.

    Segundo pilar: una serie no es una sola cosa

    Después de seleccionar variables o construir una señal compuesta aparece una nueva pregunta: ¿qué estructura interna tiene esa serie?

    Una observación temporal puede mezclar tendencia secular, oscilaciones de mediano plazo, ciclos rápidos y ruido. SignalY ofrece tres maneras metodológicamente diferentes de intentar separarlos.

    Wavelets: mirar el tiempo y la escala simultáneamente

    Una transformada de Fourier representa una señal mediante ondas sinusoidales que se extienden indefinidamente. Eso es extremadamente útil para identificar frecuencias, pero sacrifica localización temporal: sabemos qué frecuencia existe, pero no necesariamente cuándo aparece.

    Las wavelets utilizan oscilaciones localizadas. SignalY implementa la Maximal Overlap Discrete Wavelet Transform (MODWT) con wavelets de Daubechies.

    La descomposición produce componentes de detalle:

    $$ D_1,\;D_2,\;D_3,\;\ldots,\;D_J $$

    y una aproximación suave:

    $$ S_J. $$

    Los primeros niveles recogen variaciones relativamente rápidas; al avanzar hacia escalas mayores aparecen oscilaciones progresivamente más lentas. El componente suave representa la estructura de baja frecuencia.

    Una ventaja de MODWT es que no realiza downsampling: cada escala conserva la longitud temporal de la serie original.

    SignalY calcula además una descomposición de la varianza por escala. Esto permite preguntar si la dinámica de una serie está dominada por fluctuaciones rápidas, ciclos intermedios o movimiento de largo plazo.

    EMD: dejar que la propia serie decida cómo descomponerse

    La Empirical Mode Decomposition adopta una filosofía casi opuesta. En lugar de imponer una familia matemática de funciones base, construye los componentes directamente a partir de la geometría local de los datos.

    El algoritmo identifica máximos y mínimos locales, construye envolventes y aplica sucesivamente un procedimiento de sifting para extraer Intrinsic Mode Functions o IMFs.

    De forma esquemática:

    $$ x(t) = \sum_{k=1}^{K} \mathrm{IMF}_k(t) + r(t) $$

    donde $r(t)$ es el residuo o tendencia restante.

    Esto vuelve a EMD especialmente interesante cuando la serie es no estacionaria, no lineal o posee frecuencias que cambian con el tiempo.

    La flexibilidad tiene un costo. EMD puede ser sensible a efectos de borde y al llamado mode mixing, por lo que los componentes extraídos no deberían interpretarse mecánicamente.

    HP-GC: un Hodrick-Prescott donde $\lambda$ deja de ser una elección arbitraria

    El filtro Hodrick-Prescott tradicional es familiar para muchos macroeconomistas. También lo es una de sus críticas más recurrentes: el usuario tiene que escoger un parámetro de suavizado $\lambda$.

    La regla $\lambda=1600$ para datos trimestrales es famosa, pero sigue siendo una regla fijada externamente.

    SignalY incorpora el enfoque de componentes no observados de Grant y Chan, estimado mediante MCMC.

    La señal puede conceptualizarse como:

    $$ y_t = \tau_t + c_t + \varepsilon_t $$

    donde $\tau_t$ representa la tendencia y $c_t$ el ciclo. La tendencia se regula mediante sus segundas diferencias, mientras que el ciclo se modela como un proceso AR(2).

    La diferencia decisiva es que $\lambda$ se estima a partir de los datos mediante MCMC en lugar de fijarse manualmente.

    El resultado incluye distribuciones posteriores para tendencia, ciclo y residuo, de modo que la descomposición incorpora también incertidumbre.

    Tres filtros, una misma serie: ¿por qué no escoger simplemente el mejor?

    SignalY incluye filter_all(), que aplica wavelets, EMD y HP-GC a la misma serie y devuelve los resultados en un formato comparable.

    Esto es más que una comodidad de programación.

    La idea metodológica

    Si un componente aparece bajo varias descomposiciones con supuestos diferentes, tenemos más razones para considerarlo una propiedad robusta de la señal. Si aparece únicamente bajo un filtro, puede ser una característica dependiente del método.

    Wavelets parten de una base predeterminada. EMD deja que la descomposición sea guiada por los propios datos. HP-GC utiliza un modelo probabilístico de componentes no observados. No responden exactamente la misma pregunta y por eso compararlos puede resultar más informativo que declarar a uno universalmente superior.

    Tercer pilar: ¿la señal vuelve a su centro o se aleja indefinidamente?

    Extraer una tendencia o un ciclo no termina el análisis. Para modelar correctamente un componente necesitamos conocer su régimen de persistencia.

    Un proceso estacionario y un random walk pueden parecer similares en una muestra corta y, sin embargo, tienen propiedades estadísticas muy diferentes.

    Por eso SignalY ejecuta una batería de cuatro pruebas de raíz unitaria.

    Prueba Hipótesis nula Qué aporta
    ADF Existe raíz unitaria Es la prueba clásica de Dickey-Fuller aumentada y depende de la especificación de rezagos.
    Phillips-Perron Existe raíz unitaria Introduce una corrección no paramétrica frente a correlación serial y heterocedasticidad.
    KPSS La serie es estacionaria Invierte la hipótesis nula, lo que la hace especialmente útil como contraste de las pruebas anteriores.
    ERS Existe raíz unitaria La prueba Elliott-Rothenberg-Stock busca mayor potencia en alternativas cercanas a la unidad.

    Por qué cuatro pruebas pueden ser mejores que una

    El problema es que ninguna prueba individual es definitiva. ADF y Phillips-Perron pueden tener poca potencia cuando el proceso se encuentra muy cerca de una raíz unitaria.

    KPSS parte, en cambio, de la hipótesis nula opuesta. Esa asimetría permite utilizar los resultados conjuntamente.

    SignalY resume la evidencia con una lógica del tipo:

    Estacionaria

    ADF, PP o ERS ofrecen evidencia contra la raíz unitaria y KPSS no rechaza estacionariedad.

    Raíz unitaria

    Las pruebas con raíz unitaria como nula no logran rechazarla y KPSS sí rechaza la hipótesis de estacionariedad.

    Zona fronteriza

    Los resultados son mixtos o inconsistentes entre pruebas, sugiriendo un proceso potencialmente cercano a la unidad.

    Transparencia

    La clasificación automática no oculta las pruebas originales: estadísticas y valores p permanecen disponibles para inspección.

    El punto de unión: signal_analysis()

    Todos estos módulos pueden utilizarse de manera independiente, pero el diseño de SignalY cobra sentido cuando se encadenan.

    La función signal_analysis() funciona como orquestador:

    result <- signal_analysis(
      data = data,
      y_formula = Y ~ X1 + X2 + X3,
      methods = c(
        "wavelet",
        "emd",
        "pca",
        "dfm",
        "unitroot"
      ),
      verbose = TRUE
    )

    Una llamada puede combinar:

    • selección o reducción de columnas;
    • descubrimiento de factores;
    • descomposición temporal;
    • análisis de persistencia;
    • resúmenes y visualizaciones dentro de una estructura común.

    Los objetos resultantes incluyen métodos como print(), summary() y plot(), y las visualizaciones pueden mostrar perfiles de coeficientes, cargas de PCA, factores dinámicos y componentes de los filtros.

    ¿Cómo sabemos que los procedimientos recuperan lo que deberían?

    La documentación incluye experimentos sobre datos sintéticos con estructura verdadera conocida. Esto es importante: si sabemos de antemano qué variables, factores o ciclos generaron los datos, podemos medir qué tan bien los recupera cada método.

    Tarea sintética Método Resultado documentado
    Recuperar 3 factores latentes PCA / DFM Correlación $$r>0.95$$ y recuperación exacta del número de factores.
    Seleccionar 5 variables entre 50 Horseshoe $F1>0.85$ y precisión superior a $0.90$.
    Recuperar una tendencia logarítmica EMD Correlación $r>0.95$ con la tendencia verdadera.
    Extraer un ciclo multiescala Wavelet $D_3+D_4$ Correlación $r>0.70$ con el ciclo verdadero.
    Tendencia estocástica + ciclo AR(2) HP-GC bayesiano Tendencia $r>0.90$; ciclo $r>0.50$.
    Clasificación de estacionariedad Batería de raíz unitaria 4 de 4 casos sintéticos clasificados correctamente.
    Cómo interpretar estos números

    Son pruebas de recuperación sobre simulaciones. Demuestran que, bajo los escenarios sintéticos evaluados, los métodos pueden recuperar estructuras conocidas. No implican que la misma precisión esté garantizada en cualquier conjunto de datos del mundo real.

    ¿Quién puede sacar provecho de SignalY?

    Economistas

    Para paneles y sistemas multivariados donde interesa separar predictores relevantes, factores comunes, ciclos y tendencias antes de especificar modelos posteriores.

    Investigación cuantitativa

    Para finanzas, macroeconomía o economía política cuando existen conjuntos de predictores amplios y la selección ad hoc resulta difícil de justificar.

    Ciencia de datos

    Para señales no estacionarias, no lineales o multiescala donde se necesita algo más que una rutina puramente descriptiva de procesamiento digital.

    Un flujo mínimo

    La instalación y una primera ejecución pueden ser muy compactas:

    # Instalar desde GitHub
    remotes::install_github("IsadoreNabi/SignalY")
    
    library(SignalY)
    
    # Preparar un data frame
    data <- data.frame(
      Y = as.vector(Y),
      X
    )
    
    # Flujo mínimo
    result <- signal_analysis(
      data = data,
      y_formula = "Y",
      methods = c(
        "pca",
        "wavelet",
        "unitroot"
      )
    )
    
    plot(result)

    SignalY está distribuido bajo licencia MIT y está diseñado para trabajar con estructuras de datos habituales de R.

    La cuestión metodológica de fondo

    Ninguno de los elementos centrales de SignalY existe exclusivamente dentro del paquete. La Horseshoe tiene una literatura propia. PCA y los modelos factoriales dinámicos poseen décadas de desarrollo. MODWT, EMD, el filtro HP y las pruebas de raíz unitaria son herramientas establecidas.

    La propuesta está en cómo se conectan.

    Podemos comenzar con cincuenta variables, utilizar shrinkage para identificar aquellas que contienen mayor señal, descubrir después factores latentes comunes, descomponer la serie resultante en escalas temporales y, finalmente, preguntarnos si cada componente es estacionario o persistente.

    También podemos someter la misma serie a wavelets, EMD y HP-GC y observar qué estructuras aparecen bajo los tres enfoques.

    O podemos obtener factores dinámicos y estudiar después el régimen de persistencia de cada uno antes de utilizarlos en una etapa econométrica posterior.

    Ésa es la idea central de SignalY: la extracción de señal no debería entenderse como una colección de procedimientos aislados. Seleccionar variables cambia qué señal vemos; descomponerla cambia qué escalas estudiamos; y determinar su persistencia cambia qué modelos pueden ser apropiados después. El valor del paquete está en convertir esas decisiones sucesivas en un flujo coherente, comparable y reproducible.

    SignalY es desarrollado por José Mauricio Gómez Julián y se distribuye bajo licencia MIT. El código fuente, la documentación y la wiki están disponibles en GitHub.

  • EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Inferencia causal · Series temporales · Validación predictiva

    Una relación estadística no basta: cómo EconCausal intenta comprobar si sobrevivirá al futuro

    Un paquete de R que integra modelos de corrección de errores, regresión no lineal, series temporales estructurales bayesianas, errores autorregresivos y validación temporal dentro de un protocolo reproducible para evaluar relaciones causales en series temporales.

    EconCausal · R · Econometría aplicada · GitHub

    Encontramos una relación en nuestros datos. Es estadísticamente significativa. Los coeficientes parecen razonables. Tal vez incluso encaje perfectamente con la teoría. Pero todavía queda una pregunta incómoda: ¿seguirá apareciendo dentro de seis meses, cuando el modelo tenga que enfrentarse a datos que aún no existen?

    Esta pregunta es especialmente importante en economía. Las relaciones temporales que parecen sólidas dentro de una muestra pueden desaparecer cuando cambia el régimen macroeconómico, cuando llega una crisis o, sencillamente, cuando el modelo deja de describir el pasado y tiene que predecir el futuro.

    EconCausal fue construido alrededor de ese problema. Su objetivo no es ofrecer un nuevo botón que convierta correlaciones en causalidad, sino imponer un procedimiento más exigente: preanalizar los datos, estimar la relación desde varios marcos metodológicos y obligarla a sobrevivir a pruebas temporales antes de aceptarla.

    La idea en una frase

    EconCausal funciona como una especie de línea de control de calidad para afirmaciones causales en series temporales: una relación candidata debe superar una secuencia explícita de pruebas antes de recibir luz verde.

    El problema: correlación hoy no significa estabilidad mañana

    Una regresión convencional puede indicarnos que dos variables se mueven juntas. Pero una covariación estadística no nos dice automáticamente por qué ocurre, en qué dirección opera la relación ni si seguirá apareciendo cuando cambien las condiciones económicas.

    En series temporales existe además una dificultad adicional: las observaciones no son intercambiables. El año 2020 viene después de 2019. El trimestre siguiente depende, en mayor o menor medida, de la historia anterior. Ignorar esta estructura puede generar resultados que parecen mucho más robustos de lo que realmente son.

    EconCausal aborda el problema combinando tres marcos metodológicos distintos. Ninguno de ellos pretende monopolizar el significado de causalidad; la idea es obtener perspectivas complementarias sobre una misma relación.

    ECM-MARS

    Combina corrección de errores y cointegración con Multivariate Adaptive Regression Splines para capturar ajustes no lineales entre equilibrio de largo plazo y dinámica de corto plazo.

    BSTS

    Descompone la serie en componentes estructurales dentro de un marco bayesiano y permite construir distribuciones contrafactuales y pronósticos con incertidumbre explícita.

    BGLM-AR(1)

    Ajusta un modelo lineal generalizado bayesiano mientras representa explícitamente la dependencia temporal de los errores mediante una estructura autorregresiva de primer orden.

    Primera vía: ECM-MARS y la diferencia entre corto y largo plazo

    Muchas variables económicas pueden alejarse entre sí durante períodos relativamente cortos y, sin embargo, mantener una relación de equilibrio a largo plazo.

    Ésta es precisamente la intuición detrás de un Modelo de Corrección de Errores o ECM. Si dos variables están cointegradas, sus movimientos de corto plazo pueden desviarse, pero existe alguna fuerza de ajuste que impide que esa divergencia crezca indefinidamente.

    En su forma conceptual más sencilla, podemos imaginar:

    $$ \Delta Y_t = \alpha + \lambda \left( Y_{t-1} – \beta X_{t-1} \right) + \gamma \Delta X_t + \varepsilon_t $$

    El término entre paréntesis representa el desequilibrio acumulado respecto de la relación de largo plazo. El parámetro $\lambda$ refleja la velocidad con la que el sistema responde a ese desequilibrio.

    El problema es que la respuesta real puede no ser lineal. Una economía podría tolerar pequeñas desviaciones durante bastante tiempo y reaccionar bruscamente cuando se cruza cierto umbral.

    Ahí aparece MARS —Multivariate Adaptive Regression Splines—. En lugar de obligar al ajuste a seguir una única pendiente lineal, MARS puede encontrar automáticamente regiones y umbrales donde la dinámica cambia.

    Intuición

    ECM aporta la arquitectura económica del equilibrio de largo plazo y la corrección de corto plazo; MARS permite que el mecanismo de ajuste sea flexible y potencialmente no lineal.

    Antes de estimar, hay que demostrar que el problema está bien planteado

    EconCausal no lanza automáticamente un ECM sobre cualquier par de series. Antes, el protocolo comprueba las condiciones que justifican un análisis de cointegración.

    Comprueba si las variables son integradas de orden uno, $I(1)$, condición previa para el análisis de cointegración utilizado por este procedimiento.

    Ejecuta las pruebas de cointegración de Engle-Granger y Johansen.

    Aplica una regla de tipo either: si cualquiera de las dos pruebas proporciona evidencia suficiente de cointegración, el análisis puede continuar.

    Controla correlación serial y heterocedasticidad mediante errores estándar consistentes HAC.

    Ajusta el ECM utilizando MARS como motor de regresión.

    Somete posteriormente la relación a validación temporal mediante ventanas de origen móvil.

    La utilización conjunta de Engle-Granger y Johansen es deliberada. Engle-Granger es relativamente directo, mientras que Johansen puede manejar estructuras de cointegración más ricas en contextos multivariados. El protocolo prefiere utilizar ambas perspectivas en lugar de hacer depender todo el análisis de una sola prueba.

    Segunda vía: BSTS y el contrafactual

    La segunda familia metodológica cambia la pregunta. En lugar de concentrarse primero en cointegración y corrección de errores, un modelo de Bayesian Structural Time Series representa la serie como un sistema de componentes estructurales.

    Conceptualmente, podemos pensar en una descomposición como:

    $$ Y_t = \mu_t + \tau_t + \mathbf{x}_t^{\top}\boldsymbol{\beta} + \varepsilon_t $$

    donde $\mu_t$ puede representar el nivel o tendencia, $\tau_t$ algún componente temporal adicional y $\mathbf{x}_t^{\top}\boldsymbol{\beta}$ el efecto de variables predictoras.

    Esta representación resulta especialmente útil para inferencia causal cuando queremos formular una pregunta contrafactual: ¿qué habría ocurrido con la variable analizada si una intervención o cambio determinado no hubiese sucedido?

    EconCausal incorpora además priors spike-and-slab, que realizan selección probabilística de variables. En lugar de incluir automáticamente todos los predictores o eliminarlos mediante procedimientos stepwise, el modelo estima qué variables tienen mayor probabilidad de pertenecer a la estructura predictiva.

    Al ser bayesiano, el resultado no es solamente una predicción puntual. Se obtiene una distribución posterior, lo que permite expresar explícitamente la incertidumbre asociada al contrafactual.

    Tercera vía: BGLM-AR(1) y el problema de los errores que recuerdan el pasado

    Uno de los errores más comunes en econometría aplicada consiste en estimar una regresión como si los residuos de un período no tuviesen ninguna relación con los del período anterior.

    En muchos procesos económicos esto es poco plausible.

    EconCausal incorpora por ello un Bayesian Generalized Linear Model con errores AR(1). Una representación básica de la estructura residual es:

    $$ \varepsilon_t = \rho\varepsilon_{t-1} + \eta_t, \qquad |\rho|<1 $$

    Si $\rho$ es distinto de cero, parte del error actual está relacionado con el error del período anterior.

    Ignorar esa dependencia puede generar intervalos excesivamente estrechos y una falsa sensación de precisión. Modelarla explícitamente permite que la incertidumbre estadística refleje mejor la estructura temporal de los datos.

    La estimación se realiza mediante Hamiltonian Monte Carlo a través de Stan, con priors débilmente informativas calibradas para variables estandarizadas.

    La regla que hace distinto al protocolo: no basta con mejorar una sola métrica

    Uno de los elementos centrales de EconCausal es su criterio dual de evaluación.

    Una relación candidata no se considera respaldada simplemente porque obtenga mejores predicciones puntuales, ni porque mejore la distribución predictiva. Debe mejorar simultáneamente ambas dimensiones.

    1. Densidad predictiva — ELPD

    Se evalúa la calidad de la distribución predictiva mediante Expected Log Predictive Density, utilizando PSIS-LOO cuando corresponde.

    2. Precisión puntual — RMSE

    También debe mejorar la precisión de los pronósticos puntuales, evaluada mediante Root Mean Squared Error.

    Esto importa porque ambos criterios responden preguntas distintas. Un modelo podría reducir el RMSE y, al mismo tiempo, producir una distribución de incertidumbre peor calibrada. Otro podría representar muy bien la incertidumbre, pero producir predicciones centrales peores.

    EconCausal exige superar ambos filtros.

    La prueba decisiva: dejar que el futuro haga de árbitro

    El rasgo más característico del protocolo aparece en la validación. Una relación temporal no se considera estable porque haya funcionado en una única partición de entrenamiento y prueba.

    El paquete utiliza validación Leave-Future-Out con ventanas y horizontes configurables.

    La lógica es:

    $$ \underbrace{ y_1,\ldots,y_t }_{\text{entrenamiento}} \quad\longrightarrow\quad \underbrace{ y_{t+1},\ldots,y_{t+h} }_{\text{futuro}} $$

    Después el punto de corte avanza y el proceso se repite:

    Se entrena utilizando únicamente información disponible hasta cierto momento.

    Se pronostican observaciones estrictamente posteriores.

    Se calcula el desempeño predictivo.

    La frontera temporal avanza.

    El procedimiento se repite en múltiples ventanas.

    El resultado incluye una medida de soporte temporal: la proporción de ventanas en las que la relación continúa satisfaciendo los criterios establecidos.

    Por qué esto importa

    Una relación que funciona magníficamente en una única ventana puede ser casualidad. Una relación que reaparece sistemáticamente cuando el modelo debe predecir distintos segmentos futuros ofrece una evidencia mucho más difícil de atribuir a una partición afortunada de la muestra.

    Menos libertad invisible para el investigador

    Buena parte del análisis aplicado contiene decisiones que el lector nunca llega a observar: qué transformación se probó primero, qué ventana se descartó, qué modelo alternativo se abandonó, qué umbral se modificó después de mirar los resultados.

    Este problema suele describirse como researcher degrees of freedom.

    EconCausal intenta reducirlos mediante un protocolo explícito: prepruebas, reglas de aceptación, umbrales y procedimientos de validación están integrados dentro del mismo flujo reproducible.

    Esto no elimina el juicio científico. Pero vuelve más visible qué reglas condujeron desde los datos hasta la conclusión.

    ¿Dónde está la novedad?

    No en inventar desde cero Engle-Granger, Johansen, MARS, BSTS, modelos AR(1), Stan, PSIS-LOO o validación temporal.

    Todas estas herramientas tienen antecedentes bien establecidos.

    Según una evaluación de novedad incluida en la documentación del paquete, la contribución reside en la combinación de esos componentes dentro de un protocolo end-to-end concreto, con prepruebas, reglas duales de decisión, umbrales de soporte y validación temporal.

    Esa distinción es importante: la afirmación metodológica no es “hemos inventado nuevas matemáticas”, sino “hemos convertido varias técnicas existentes en un procedimiento único, explícito y auditable”.

    ¿Quién podría utilizar EconCausal?

    Aunque el paquete fue desarrollado inicialmente para investigación económica, el problema que intenta resolver es mucho más general: relaciones direccionales entre variables observadas a lo largo del tiempo.

    Macroeconomía

    Para estudiar relaciones entre producción, precios, salarios, inversión, crédito, empleo u otras variables con dinámica temporal.

    Política pública

    Para evaluar si una relación asociada a una intervención permanece estable bajo distintos contextos económicos.

    Finanzas

    Para diferenciar una asociación histórica aparente de una relación que mantiene capacidad predictiva fuera de muestra.

    También puede servir como herramienta pedagógica para estudiantes de econometría e inferencia causal, precisamente porque obliga a recorrer etapas que en un análisis manual resultan fáciles de omitir.

    Instalación

    El paquete puede instalarse directamente desde GitHub:

    # Instalar desde GitHub
    remotes::install_github("IsadoreNabi/EconCausal")
    
    # En Windows, si falla la construcción de las viñetas:
    remotes::install_github(
      "IsadoreNabi/EconCausal",
      build_vignettes = FALSE
    )

    EconCausal utiliza una infraestructura bayesiana moderna, incluyendo cmdstanr para muestreo HMC, loo para cálculos PSIS-LOO y bsts para los componentes de series temporales estructurales.

    Lo que EconCausal no puede hacer por vos

    Un protocolo riguroso no convierte datos pobres en datos excelentes.

    Si la muestra es demasiado pequeña, las variables contienen errores de medición importantes o existen rupturas estructurales tan fuertes que destruyen la relación estudiada, ningún paquete estadístico puede eliminar mágicamente esas limitaciones.

    Tampoco sustituye el conocimiento del dominio.

    Que una relación sea estable, direccional y predictivamente robusta es una evidencia importante, pero una interpretación causal todavía necesita un mecanismo teórico, una consideración seria de variables confusoras y una evaluación de los supuestos identificadores.

    Límite fundamental

    EconCausal intenta disciplinar la inferencia estadística. No puede decidir por sí solo qué mecanismo causal existe en el mundo real.

    La cuestión de fondo

    En análisis temporal es relativamente fácil encontrar relaciones que describen bien el pasado. Lo difícil es encontrar relaciones que permanezcan cuando llega información nueva.

    EconCausal desplaza por ello parte del énfasis metodológico desde “¿obtuvimos significancia?” hacia una pregunta más dura: “¿esta relación sigue funcionando cuando le pedimos que sobreviva fuera de la muestra donde la descubrimos?”

    Esa diferencia puede parecer pequeña, pero cambia la filosofía del análisis. La significancia estadística deja de ser la meta final y se convierte apenas en una pieza dentro de una cadena de validación mucho más amplia.

    La contribución de EconCausal está en el protocolo. ECM-MARS, BSTS, modelos bayesianos con errores AR(1), HMC, PSIS-LOO, RMSE y validación Leave-Future-Out ya pertenecen al repertorio de la econometría moderna. Lo distintivo es obligarlos a trabajar juntos bajo reglas explícitas y reproducibles, de modo que una relación no sea aceptada porque se vea convincente en una muestra, sino porque resista una batería organizada de pruebas y mantenga apoyo cuando se enfrenta al futuro.

    EconCausal está disponible en GitHub. Las metodologías subyacentes se apoyan, entre otros trabajos, en Engle & Granger (1987), Johansen (1991), Friedman (1991), Scott & Varian (2014), Vehtari et al. (2017) y Hyndman & Athanasopoulos (2021).

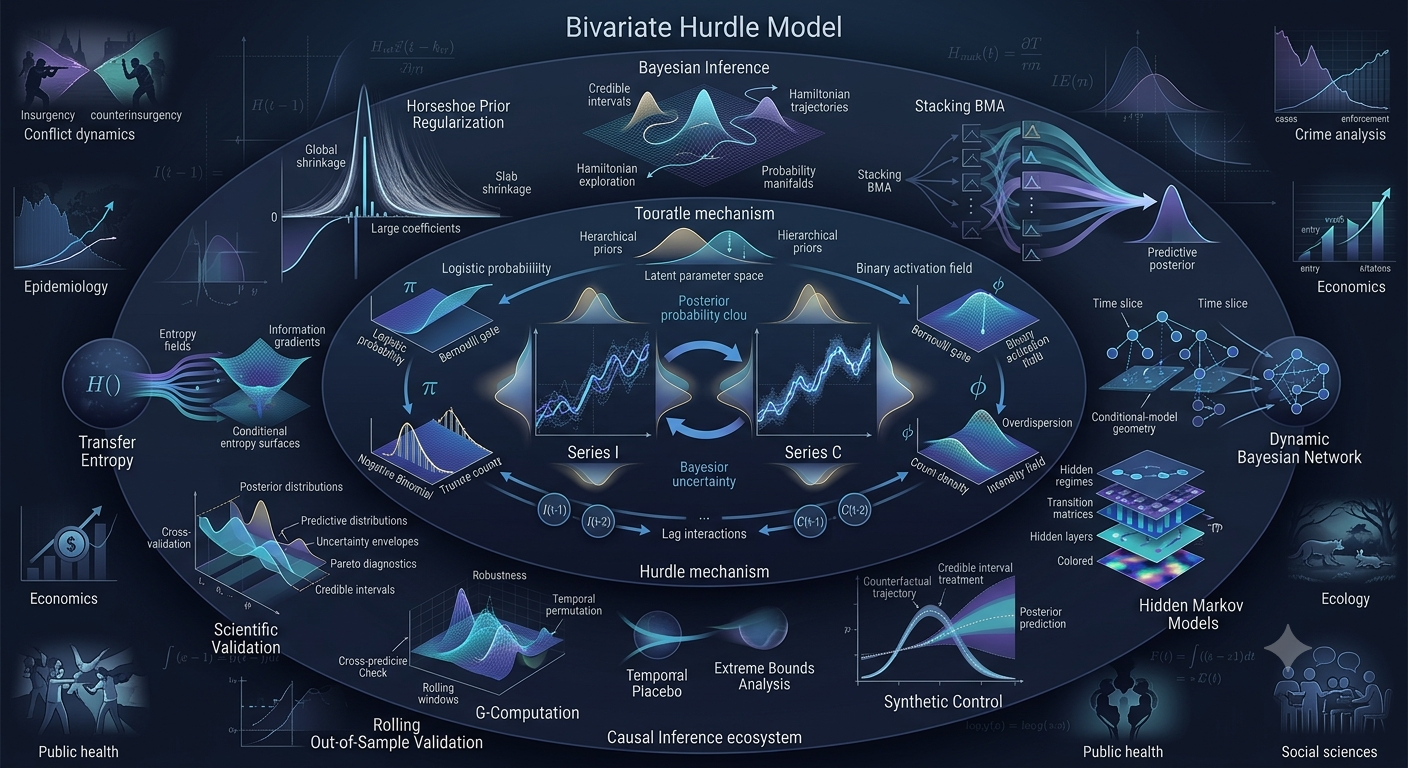
  • bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

    bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

    También puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Estadística bayesiana · Series temporales · Inferencia causal

    Cuando dos series tienen demasiados ceros: una introducción a bivarhr

    Un paquete de R que combina modelos hurdle bivariados, regularización horseshoe, comparación predictiva y múltiples estrategias de inferencia causal para uno de esos problemas que parecen sencillos hasta que uno intenta analizarlos de verdad.

    Por José Mauricio Gómez Julián · CRAN · GitHub

    Imaginemos que queremos estudiar dos procesos que evolucionan juntos en el tiempo. Podrían ser ataques insurgentes y operaciones contrainsurgentes, casos de una enfermedad y muertes asociadas, protestas y respuestas del gobierno, entradas y salidas de empresas o cualquier otro par de fenómenos registrados como conteos.

    Hasta aquí nada parece especialmente extraño. Tenemos series temporales, tenemos conteos y tenemos una considerable caja de herramientas estadística. El problema comienza cuando los datos se parecen más al mundo real que a los ejemplos de un manual.

    Puede ocurrir que durante la mayor parte del tiempo no suceda absolutamente nada: cero ataques, cero protestas, cero extinciones, cero nuevos casos. Después, cuando finalmente ocurre algo, el número observado puede variar enormemente. A eso se suma otra dificultad: las dos series pueden influenciarse predictivamente entre sí con rezagos, mientras docenas de variables adicionales compiten por entrar en el modelo.

    bivarhr fue diseñado precisamente para trabajar en ese cruce de problemas.

    La idea en una frase

    En lugar de tratar por separado el exceso de ceros, la dinámica entre ambas series, la selección de variables, la incertidumbre sobre el modelo y la evidencia causal, bivarhr intenta integrarlos dentro de un único flujo de análisis reproducible.

    Primero: ¿por qué tantos ceros son un problema?

    Un modelo de Poisson convencional presupone una estructura relativamente simple para los conteos. La distribución binomial negativa permite mayor dispersión y suele funcionar mejor cuando la variabilidad excede lo que admitiría un Poisson.

    Pero ninguna de esas decisiones resuelve automáticamente un conjunto de datos en el que, por ejemplo, el 60 %, 70 % u 80 % de las observaciones son exactamente cero.

    Un modelo hurdle aborda el problema dividiéndolo conceptualmente en dos mecanismos.

    1. Primero pregunta si el proceso logra cruzar el “obstáculo”: ¿ocurrió algo o el resultado fue cero?
    2. Solamente después, condicionando a que ocurrió algo, pregunta: ¿cuánto ocurrió?

    La primera parte puede modelarse mediante una distribución Bernoulli con enlace logit. La segunda, en bivarhr, mediante una binomial negativa truncada en cero.

    Formalmente, para una de las series \(I\) en el instante \(t\):

    \[ P(Y_{I,t}=0)=1-\pi_{I,t} \]

    mientras que, para un conteo positivo,

    \[ P(Y_{I,t}=y\mid y>0) = \pi_{I,t} \frac{ f_{\mathrm{NB}}(y\mid\mu_{I,t},\phi_I) }{ 1-f_{\mathrm{NB}}(0\mid\mu_{I,t},\phi_I) } \]

    Aquí, \(\pi_{I,t}\) representa la probabilidad de observar un valor distinto de cero, \(\mu_{I,t}\) controla el conteo esperado una vez superado el hurdle y \(\phi_I\) gobierna la dispersión.

    Esta separación es importante. El proceso que determina si sucede algo no tiene por qué ser el mismo que determina la intensidad de lo que sucede.

    ¿Y qué aporta que el modelo sea bivariado?

    Supongamos que llamamos \(I\) y \(C\) a nuestras dos series. Analizarlas por separado perdería precisamente una de las preguntas más interesantes: ¿contiene el pasado de una información útil para predecir el futuro de la otra?

    bivarhr permite introducir valores rezagados de \(C\) en la ecuación correspondiente a \(I\), valores rezagados de \(I\) en la de \(C\), ambas cosas simultáneamente o ninguna.

    Especificación C → I I → C Lectura
    A No C contiene información predictiva rezagada sobre I
    B No I contiene información predictiva rezagada sobre C
    C Dinámica predictiva bidireccional
    D No No Sin efectos cruzados rezagados

    Esta comparación permite estudiar causalidad en el sentido de Granger: si conocer el pasado de una variable mejora sistemáticamente la predicción de otra una vez considerada la información pertinente.

    Una distinción importante

    La causalidad de Granger es una afirmación sobre precedencia e información predictiva. No equivale, por sí sola, a demostrar una relación causal estructural. Precisamente por eso bivarhr no termina el análisis en los rezagos cruzados: incorpora otras herramientas que permiten contrastar la misma hipótesis desde ángulos diferentes.

    Muchos predictores, pocos datos: el papel del horseshoe

    Imaginemos ahora que, además de ambas series, disponemos de indicadores económicos, variables institucionales, condiciones climáticas, tendencias, cambios de régimen y distintas transformaciones de cada una.

    El número de parámetros puede crecer rápidamente. Con una muestra relativamente pequeña, un modelo suficientemente flexible puede terminar aprendiendo ruido.

    Para enfrentarse a este problema, bivarhr utiliza la prior horseshoe regularizada.

    La intuición es sencilla aunque su formulación matemática sea más rica: los coeficientes que no encuentran suficiente respaldo en los datos son fuertemente contraídos hacia cero, mientras que las señales verdaderamente importantes pueden escapar de esa contracción.

    El mecanismo combina un parámetro global de contracción, \(\tau\), que controla el nivel general de esparsidad, con parámetros locales \(\lambda_j\), capaces de adaptarse a cada coeficiente. La versión regularizada empleada por el paquete sigue el enfoque de Piironen y Vehtari y limita además comportamientos excesivamente extremos de los coeficientes.

    En términos prácticos, esto significa que el investigador no necesita convertir la selección manual de variables en una sucesión interminable de decisiones ad hoc.

    El problema que viene después: ¿qué modelo elegimos?

    Incluso después de definir la estructura general, queda una decisión incómoda. ¿Cuántos rezagos deberíamos utilizar? ¿Uno? ¿Dos? ¿Tres? ¿Qué grado de regularización es apropiado?

    La respuesta habitual consiste en escoger el modelo que obtiene el mejor valor de algún criterio y descartar los demás.

    bivarhr sigue otra filosofía. Combina modelos mediante predictive stacking, asignándoles pesos según su capacidad predictiva.

    \[ p_{\mathrm{stack}}(y_t) = \sum_{m=1}^{M} w_m\, p(y_t\mid y_{1:t-1},\mathcal{M}_m) \]

    Los pesos se estiman buscando maximizar la densidad logarítmica predictiva esperada —ELPD—, evaluada mediante PSIS-LOO. En términos menos técnicos: los modelos que predicen mejor reciben más influencia y los que predicen peor reciben menos.

    El resultado evita hacer depender toda la inferencia de una única decisión sobre el número exacto de rezagos o sobre un solo conjunto de hiperparámetros.

    De la predicción a la causalidad: buscar evidencia convergente

    Probablemente éste sea el aspecto más ambicioso del paquete. bivarhr no propone que un único procedimiento estadístico resuelva automáticamente el problema de la causalidad. En su lugar, proporciona varias herramientas complementarias.

    Entropía de transferencia

    Pregunta cuánto reduce el pasado de una serie nuestra incertidumbre acerca de la otra, más allá de la información contenida en su propio pasado. A diferencia del Granger lineal tradicional, procede desde la teoría de la información.

    Redes Bayesianas Dinámicas

    Buscan aprender relaciones dirigidas entre variables situadas en distintos momentos, permitiendo distinguir conexiones directas de estructuras mediadas por otras variables.

    Modelos Ocultos de Markov

    Permiten investigar si ambas series parecen estar gobernadas por estados latentes, como períodos de calma, transición o escalada que no fueron etiquetados previamente.

    VARX

    Aporta una comprobación desde la tradición clásica de series temporales, incluyendo diagnósticos de estabilidad, autocorrelación, normalidad y efectos ARCH.

    Análisis de sensibilidad

    Siguiendo a Cinelli y Hazlett, cuantifica cuán potente tendría que ser un confusor no observado para explicar un efecto estimado.

    Control sintético

    Mediante series temporales estructurales bayesianas puede construir un escenario contrafactual y comparar lo observado con lo que habría ocurrido en ausencia de una intervención.

    Ninguno de estos métodos convierte mágicamente una asociación en causalidad. Su utilidad reside en otra cosa: permiten preguntar si una conclusión sobrevive cuando el mismo problema se examina mediante representaciones y supuestos diferentes.

    Un resultado no vale mucho si desaparece al tocar el modelo

    Una parte importante de bivarhr está dedicada no a producir resultados nuevos, sino a intentar destruir los resultados que ya obtuvimos.

    Ésa es una virtud.

    Placebos temporales

    Si se altera aleatoriamente el orden temporal de los datos y el modelo continúa funcionando igual de bien, existe un problema: quizá no estaba aprendiendo realmente la dinámica temporal.

    Evaluación fuera de muestra

    El paquete permite ajustar modelos en fracciones sucesivas de la muestra y evaluar sus pronósticos sobre las observaciones restantes. En lugar de preguntar solamente qué tan bien describe el modelo los datos conocidos, preguntamos qué tan bien funciona cuando tiene que enfrentarse a datos que no utilizó para estimarse.

    Análisis de límites extremos

    También puede reestimarse el modelo bajo distintas combinaciones de controles. Si un resultado fundamental cambia de signo o desaparece cada vez que modificamos ligeramente la especificación, tenemos razones para desconfiar de su robustez.

    G-computation

    Finalmente, la simulación posterior permite construir cantidades contrafactuales del tipo: ¿cómo cambiaría \(I\) si elimináramos determinados rezagos cruzados o variables de transición? Así es posible expresar los resultados en términos de efectos promedio del tratamiento bajo la especificación causal adoptada.

    ¿En qué campos puede resultar útil?

    El paquete nació alrededor de un problema estadístico, no de una disciplina particular. Por eso su campo potencial de aplicación es amplio.

    Campo Ejemplos de pares de procesos
    Salud pública Casos y mortalidad; hospitalizaciones y reingresos; vacunación y brotes.
    Criminología Delitos y respuestas policiales; incautaciones y sobredosis.
    Economía Entradas y salidas de empresas; patentes y citas; determinados conteos asociados a flujos comerciales.
    Ecología Depredadores y presas; aparición y desaparición de especies; colonización y extinción local.
    Ciencia política Protestas y respuestas gubernamentales; iniciativas legislativas y vetos.
    Entornos digitales Publicaciones de desinformación y actividad posterior de verificación.

    ¿Qué ocurre bajo el capó?

    Aunque el objetivo del paquete es ofrecer un flujo integrado, la infraestructura estadística es plenamente bayesiana allí donde se ajusta el modelo hurdle principal.

    Componente Implementación
    Muestreo Stan NUTS mediante cmdstanr
    Regularización Horseshoe regularizado
    Evaluación predictiva PSIS-LOO y ELPD
    Combinación de modelos Pesos de predictive stacking
    Convergencia \(\hat{R}\), ESS y divergencias
    Diagnóstico LOO Valores de Pareto \(k\)

    El código Stan tampoco constituye una caja negra: puede inspeccionarse mediante get_hurdle_model(), mientras que las cantidades generadas permiten obtener log-verosimilitudes por observación, predicciones posteriores y valores ajustados.

    Empezar a utilizar bivarhr

    El paquete puede instalarse desde GitHub, mientras que también dispone de distribución a través de CRAN.

    # Instalación desde GitHub
    devtools::install_github("isadorenabi/bivarhr")
    
    # Instalar cmdstanr
    install.packages(
      "cmdstanr",
      repos = c(
        "https://stan-dev.r-universe.dev",
        getOption("repos")
      )
    )
    
    cmdstanr::install_cmdstan()
    
    # Paquetes opcionales para el conjunto completo
    # de herramientas causales
    install.packages(c(
      "RTransferEntropy",
      "bnlearn",
      "sensemakr",
      "CausalImpact",
      "vars",
      "openxlsx"
    ))

    Un ajuste mínimo con dos rezagos y efectos cruzados en ambas direcciones puede escribirse de forma compacta:

    fit <- fit_one(
      DT,
      k = 2,
      spec = "C",
      iter_warmup = 500,
      iter_sampling = 500,
      chains = 2
    )
    
    print(fit$fit$summary())

    Si queremos comparar múltiples órdenes de rezago y configuraciones de la prior horseshoe, podemos construir una cuadrícula y dejar que el procedimiento de selección y stacking evalúe el conjunto:

    hs_grid <- expand.grid(
      hs_tau0 = c(0.1, 0.5, 1.0),
      hs_slab_scale = c(1, 5),
      hs_slab_df = 4
    )
    
    bma_results <- select_by_bma(
      DT = DT,
      spec = "C",
      k_grid = 0:3,
      hs_grid = hs_grid,
      iter_warmup = 1000,
      iter_sampling = 1200,
      chains = 4,
      use_parallel = TRUE
    )
    
    print(bma_results$table)

    El punto más interesante no es un modelo: es el flujo de trabajo

    Es fácil describir bivarhr enumerando sus piezas: binomial negativa hurdle, horseshoe, Stan, PSIS-LOO, stacking, entropía de transferencia, redes bayesianas, modelos de Markov, VARX y análisis contrafactual.

    Pero hacer solamente esa lista oculta lo más interesante del proyecto.

    Prácticamente ninguno de esos métodos existe únicamente dentro de bivarhr. Lo particular es su intento de reunirlos alrededor de una secuencia coherente de preguntas.

    ¿Los ceros forman parte central del proceso? Entonces hay que modelarlos explícitamente. ¿Las dos variables evolucionan conjuntamente? Entonces no conviene estimarlas como mundos separados. ¿Hay demasiados predictores? Regularicemos. ¿No sabemos qué especificación elegir? Incorporémoslo a la incertidumbre predictiva. ¿Queremos hablar de causalidad? No dependamos de una única evidencia. ¿Encontramos un efecto? Intentemos romperlo con placebos, cambios de especificación y evaluación fuera de muestra.

    Ésa es, en última instancia, la apuesta de bivarhr: que la solidez de una investigación aplicada no depende únicamente de utilizar una técnica estadística sofisticada, sino de construir un camino reproducible desde los datos hasta la conclusión y someter cada tramo de ese camino a comprobaciones independientes.

    bivarhr es software de código abierto distribuido bajo licencia MIT. Disponible en CRAN y GitHub. Autor: José Mauricio Gómez Julián · ORCID.

  • Economía Política y Teoría de las Probabilidades: Smith, Marx y la Ley de los Grandes Números

    Economía Política y Teoría de las Probabilidades: Smith, Marx y la Ley de los Grandes Números

    El Cuaderno de Economía Política
    Explorando la economía más allá de los manuales

    ¿Todos los trabajadores son explotados por igual?
    Un supuesto marxiano puesto a prueba con teoría de probabilidades

    Cómo sesenta años de datos sectoriales de Estados Unidos y versiones no clásicas de la Ley de los Grandes Números permiten examinar un supuesto fundamental detrás de la tasa media de ganancia marxiana

    ~ 9 min de lectura

    Detrás de los análisis marxistas de la tasa media de ganancia existe un supuesto importante siempre que no se modelan explícitamente las diferencias en el grado de explotación del trabajo entre los distintos sectores productivos: las tasas sectoriales de plusvalía pueden tratarse como magnitudes que tienden hacia la uniformidad. Adam Smith proporcionó el argumento económico original para esta tendencia y, dentro de la economía política marxista, el postulado adquirió una importancia central. Pero ¿puede defenderse esa tendencia cuando los sectores reales no son independientes ni estadísticamente idénticos? Un artículo publicado en 2022 por José Mauricio Gómez Julián en Ciencia Económica aborda el problema simultáneamente desde tres direcciones: la teoría de probabilidades, los mecanismos concretos del mercado de trabajo estudiados por Smith y Marx, y evidencia estadística de Estados Unidos correspondiente al período 1960–2020.

    El problema, en lenguaje sencillo

    En la teoría marxista, la plusvalía es el valor producido por el trabajo más allá del valor representado por la fuerza de trabajo. Para llevar este concepto al terreno empírico, el artículo utiliza una aproximación basada en la contabilidad nacional moderna: el excedente bruto de operación representa el tiempo de trabajo excedente y las remuneraciones de los trabajadores representan el tiempo de trabajo necesario. El cociente entre ambos proporciona la tasa sectorial empleada en el análisis estadístico.

    La cuestión importa porque la tendencia hacia la uniformidad de las tasas sectoriales de plusvalía forma parte de la base sobre la cual se construyen la tasa media de ganancia y, consiguientemente, los precios de producción marxianos. Pero aquí existe un matiz fundamental. El artículo no presenta los precios de producción como precios de equilibrio preexistentes alrededor de los cuales los precios de mercado simplemente oscilan. Siguiendo a Carchedi y de Haan, adopta una interpretación dinámica: los precios de mercado existen primero y la competencia capitalista —incluidas la competencia tecnológica y la movilidad de los capitales— los presiona hacia un promedio sistémico. Los precios de producción existen precisamente a través de este proceso de convergencia, y no como un centro fijo establecido de antemano.

    La pregunta empírica, por tanto, no consiste en determinar si todas las industrias poseen exactamente la misma tasa de explotación en cada instante. Lo que se somete a examen es una tendencia hacia la uniformidad asintótica: cuando el análisis se aproxima a un período suficientemente largo y/o a un conjunto suficientemente grande de sectores relevantes, ¿se comportan las tasas sectoriales de una manera compatible con la convergencia hacia un valor esperado global?

    Por qué importa la perspectiva asintótica

    El artículo conecta esta pregunta con la teoría del conocimiento de Marx. Su argumento es que el método marxiano no puede reducirse a aceptar pasivamente hechos empíricos aislados. Mediante una apropiación materialista de la dialéctica hegeliana, el análisis privilegia la totalidad: el fenómeno debe comprenderse a través de sus relaciones, de su desarrollo y del sistema más amplio del que forma parte. En el artículo, la expresión régimen asintótico condensa estadísticamente esta idea: un horizonte temporal suficientemente largo, un número suficientemente grande de unidades o ambas cosas.

    Esto importa porque un sector observado aisladamente puede diferir sustancialmente de otro. La uniformidad, si existe, no tiene por qué aparecer como igualdad punto por punto. Puede ser una propiedad que sólo se vuelve visible cuando el sistema se considera a una escala suficientemente grande.

    Entra en escena la Ley de los Grandes Números

    El marco matemático es la Ley de los Grandes Números (LGN). En términos generales, las leyes de los grandes números describen las condiciones bajo las cuales los promedios se estabilizan alrededor de un valor esperado conforme aumenta la cantidad de información. La versión fuerte se refiere a la convergencia casi segura; la versión débil, a la convergencia en probabilidad.

    La dificultad aparece inmediatamente. Las formulaciones clásicas suelen descansar en supuestos fuertes, entre ellos la independencia y la identidad de distribución. Estas condiciones no son realistas para los sectores de una economía capitalista. Las industrias interactúan mediante cadenas productivas, competencia, salarios, tecnología, demanda y movimientos de capital; además, sus estructuras productivas son diferentes. Los propios resultados estadísticos del artículo confirman que las variables sectoriales ni son idénticamente distribuidas ni son, en términos generales, linealmente independientes.

    Esto no vuelve irrelevante a la LGN. Por el contrario, la parte teórica del estudio pregunta si versiones más generales de la ley pueden acomodar la estructura del problema económico. La respuesta es afirmativa, pero condicionada: distintos resultados matemáticos flexibilizan diferentes componentes de los supuestos clásicos y no todos lo hacen de la misma manera.

    Lo que realmente establece la literatura matemática

    • Li, Rao y Wang (1995): estudian una ley fuerte para sumas ponderadas de variables aleatorias independientes con índices multidimensionales, sujeta a condiciones estructurales y de momentos específicas.
    • Adler y Rosalsky (1987): establecen un resultado de ley fuerte para sumas ponderadas normalizadas de variables aleatorias independientes e idénticamente distribuidas.
    • Chen y Sung (2016): generalizan resultados relativos a sumas ponderadas bajo condiciones de dominación estocástica y ponderación, flexibilizando restricciones relevantes sobre la estructura distributiva.
    • Sung (2011): es especialmente importante para la aplicación económica porque proporciona condiciones suficientes bajo las cuales las variables pueden ser dependientes, sujetas a requisitos sobre sus momentos y otras condiciones técnicas.
    • Andrews (1988) y Davidson (2021): proporcionan resultados relativos a leyes débiles y un marco más amplio para procesos débilmente dependientes, incluidas estructuras de tipo mixingala relevantes para la econometría.
    «La lógica del planteamiento de Smith relativo a la ley de tendencia hacia la UTP es consistente con la lógica detrás de determinadas variedades de la LGN». Gómez Julián, 2022

    La palabra determinadas es esencial. El artículo no sostiene que la simple invocación de una LGN no clásica demuestre automáticamente la proposición marxiana. La consistencia formal depende de que se satisfagan las condiciones del teorema particular que se esté utilizando. En algunos casos pueden ser necesarias transformaciones del conjunto de datos: por ejemplo, agrupar o desagregar sectores, organizar observaciones en estructuras como triangular arrays, o estimar períodos faltantes cuando corresponda. Que dichos requisitos puedan satisfacerse efectivamente depende del conjunto de datos concreto.

    ¿Qué cuenta como sector productivo?

    Antes de realizar el análisis estadístico, el artículo afronta un problema de clasificación específicamente marxiano: no toda actividad que aparece en las cuentas nacionales debe incorporarse necesariamente al cálculo de la tasa media de ganancia. Los sectores pertinentes son aquellos considerados productivos en relación con el circuito del capital y con la producción de plusvalía.

    La distinción es particularmente importante en el sector servicios. A partir de la literatura sobre trabajo productivo e improductivo, el estudio distingue entre actividades que producen directamente plusvalía, actividades que facilitan su producción en otros lugares y actividades situadas fuera del circuito del capital relevante para el análisis. Después de armonizar las clasificaciones sectoriales a lo largo del período histórico y aplicar esos criterios teóricos, el análisis empírico trabaja con 36 sectores productivos.

    Lo que muestran los datos de Estados Unidos

    El componente empírico utiliza datos de la Oficina de Análisis Económico de Estados Unidos (Bureau of Economic Analysis, BEA) correspondientes al período 1960–2020. Las tasas sectoriales de plusvalía se construyen a partir del excedente bruto de operación y las remuneraciones de los trabajadores, y posteriormente se analizan sus distribuciones de probabilidad, las correlaciones de Pearson entre pares de sectores y las diferencias entre los parámetros de localización sectoriales y sus equivalentes globales.

    Principales resultados empíricos

    • Los sectores no están idénticamente distribuidos: de los 36 sectores, 16 se ajustan mejor a una distribución uniforme, 13 a Cauchy, 3 a logística, 2 a lognormal y 2 a Weibull. Ninguno presenta a la distribución normal como su mejor ajuste.
    • Los sectores no son, en términos generales, linealmente independientes: se calculan 630 correlaciones de Pearson por pares. Su media es aproximadamente 0,081 y su mediana aproximadamente 0,140.
    • La dependencia por pares de magnitud apreciable no es excepcional: 256 de las 630 correlaciones —aproximadamente el 40,63 %— son iguales o superiores a 0,30. El artículo concluye por ello que los sectores no pueden tratarse, en términos generales, como linealmente independientes.
    • La mayoría de las medidas resumen de las diferencias se aproximan a cero: respecto de la media global, la suma de las diferencias sectoriales es aproximadamente 3,38 × 10⁻¹⁴ y su media aproximadamente 9,38 × 10⁻¹⁶. Respecto de la mediana global, los valores correspondientes también son pequeños.
    • Existe una excepción importante: la mediana de las diferencias calculadas con respecto a la media global no se encuentra próxima a cero. Por ello, el artículo habla de una tendencia general hacia la nulificación recíproca, y no de una cancelación perfecta en todos los estadísticos.
    • Las diferencias presentan formas distributivas distintas: las calculadas respecto de la media global se ajustan mejor a una distribución de Cauchy, con la logística como segunda opción; las calculadas respecto de la mediana global se ajustan mejor a una uniforme, con la normal como segunda opción.

    Este patrón es importante precisamente porque los datos empíricos no reproducen los supuestos de la LGN clásica. Los sectores continúan siendo heterogéneos e interdependientes. Sin embargo, el comportamiento descriptivo de sus desviaciones proporciona, según la interpretación del autor, evidencia favorable a una tendencia hacia la nulificación recíproca cuando el sistema se considera como una totalidad.

    Por qué se dejaron de lado las pruebas convencionales de significancia

    El artículo considera inicialmente pruebas para evaluar las diferencias entre medias o medianas sectoriales y sus equivalentes globales, entre ellas procedimientos t de Student y de Wilcoxon, acompañados de bootstrapping. Finalmente sostiene que las pruebas inferenciales disponibles no son adecuadas para extraer conclusiones válidas a partir de esta estructura particular de datos.

    El problema no se reduce a la ausencia de normalidad. Dependiendo del procedimiento, resultan relevantes supuestos acerca de la forma de las distribuciones, la independencia lineal, el emparejamiento de las observaciones y la igualdad de tamaños muestrales. Las variables económicas son interdependientes por su propia naturaleza y el bootstrapping no elimina toda la dificultad: aunque el remuestreo puede romper la relación entre los grupos inmediatamente comparados, no elimina la dependencia existente entre los componentes sectoriales que conforman el grupo global.

    Existe además un matiz especialmente importante: las pruebas descartadas indicaron diferencias estadísticamente significativas. Aun así, el artículo se niega a tratar esos resultados como evidencia inferencial válida porque no se satisfacen adecuadamente las condiciones necesarias. En consecuencia, sustituye esa vía inferencial por un análisis descriptivo —o, como el propio artículo sugiere, quizá más precisamente semidescriptivo— basado en el comportamiento y en las distribuciones de probabilidad de las diferencias.

    Smith, Marx y el mecanismo económico

    El argumento probabilístico constituye sólo una dimensión de la investigación. Una segunda dimensión vuelve a la explicación de Adam Smith sobre el ajuste del mercado de trabajo. Smith sostiene que las ventajas y desventajas totales de los diferentes empleos existentes en una misma localidad deben ser iguales o tender constantemente hacia la igualdad; de lo contrario, los movimientos de trabajadores y capitales tenderían a erosionar las condiciones excepcionalmente favorables o desfavorables.

    El artículo organiza la discusión de Smith alrededor de siete factores que influyen sobre las remuneraciones: la sencillez o dificultad del trabajo; si este resulta agradable o desagradable; el peligro y sus efectos sobre la salud; la regularidad o temporalidad del empleo; el grado de confianza depositado en el trabajador; la probabilidad de éxito profesional; y consideraciones subjetivas como la pasión por una profesión, la búsqueda de reputación, la confianza en las propias capacidades y la confianza en la propia suerte.

    Estos factores son importantes precisamente porque no implican sectores aislados. Al contrario: las tasas sectoriales pueden relacionarse directamente mediante la interdependencia orgánica de la producción capitalista e indirectamente mediante fuerzas comunes que afectan salarios y condiciones laborales. En este sentido, el mecanismo económico descrito por Smith y Marx resulta más naturalmente compatible con marcos probabilísticos generalizados que admiten dependencia que con un modelo clásico que exige independencia recíproca.

    • • •

    Entonces, ¿qué establece realmente el artículo?

    La conclusión es favorable al supuesto de uniformidad, pero está cuidadosamente delimitada. En el plano teórico, la lógica de la tendencia smithiana hacia la uniformidad de las tasas sectoriales de plusvalía es consistente con determinadas versiones fuertes y débiles de la Ley de los Grandes Números que permiten variables correlacionadas y/o no exigen identidad distributiva. Esta consistencia formal está condicionada a que puedan satisfacerse los requisitos concretos de los resultados matemáticos pertinentes.

    En el plano empírico, los datos estadounidenses muestran precisamente la heterogeneidad y la interdependencia que impiden formular un argumento simplista basado en la LGN clásica. Al mismo tiempo, el análisis descriptivo de las desviaciones sectoriales produce resultados que apuntan en una dirección favorable a la proposición de Smith y Marx sobre la tendencia hacia la uniformidad de las tasas sectoriales de plusvalía.

    No se trata, por tanto, de una demostración de que toda economía capitalista, en cualquier período histórico, deba presentar una tasa uniforme de plusvalía. Tampoco se afirma que todos los sectores posean la misma tasa en cada instante. La conclusión, más acotada y defendible, es que el supuesto utilizado en los análisis marxistas de largo plazo sobre la tasa media de ganancia posee una formulación probabilística plausible y encuentra evidencia empírica a su favor en el caso estadounidense estudiado.

    La distinción es importante. La contribución del artículo no consiste en eliminar la diversidad sectorial, sino en preguntar si la diversidad existente en el nivel de las partes puede coexistir con una regularidad asintótica en el nivel de la totalidad. Su respuesta es cautelosamente afirmativa, y es precisamente la combinación de heterogeneidad, interdependencia y regularidad sistémica lo que vuelve al problema interesante tanto desde las matemáticas como desde la economía política.

    Artículo original: Gómez Julián, J. M. (2022). «Sobre la validez del supuesto de uniformidad en las tasas de plusvalía sectorial desde la teoría de las probabilidades». Ciencia Económica, Año 11, No. 17, Universidad Nacional Autónoma de México, Facultad de Economía. DOI: 10.22201/fe.24484962e.2022.11.17.2. Acceso abierto bajo licencia CC BY-NC-ND 4.0.
  • La Inflación No Siempre Es Un Fenómeno Monetario ni se manifiesta en todas partes.

    La Inflación No Siempre Es Un Fenómeno Monetario ni se manifiesta en todas partes.

    Más allá de la curva de Phillips — Inflación, cambio tecnológico y plusvalía
    Economía política Oct.–nov. 2025 · 10 min de lectura

    Más allá de la curva de Phillips

    Un estudio con datos estadounidenses de 1968 a 2021 no encuentra una relación inversa significativa de largo plazo entre inflación y desempleo y plantea, desde una perspectiva marxista, que la inflación funciona como un mecanismo de ajuste del salario real mediante el cual los beneficios del cambio tecnológico pueden transformarse en plusvalía relativa.

    La curva de Phillips ocupa desde hace décadas un lugar central en la macroeconomía convencional: la idea de que inflación y desempleo mantienen una relación inversa que condiciona las opciones de política económica. Este estudio somete esa relación a contraste empírico y plantea una explicación alternativa de la inflación desde la economía política marxista.

    Utilizando datos de Estados Unidos para el período 1968–2021, la investigación no encuentra una relación estadísticamente significativa de largo plazo entre inflación y desempleo. En cambio, identifica relaciones relevantes entre los indicadores de cambio tecnológico —aproximados mediante el gasto en investigación y desarrollo (I+D)—, los precios, los salarios reales y la tasa de plusvalía.

    La hipótesis central es que la inflación no debe entenderse únicamente como un desequilibrio entre oferta y demanda ni como un fenómeno puramente monetario. Desde el marco desarrollado en el artículo, funciona también como un mecanismo de ajuste salarial dentro del proceso de acumulación capitalista.

    Qué está realmente en juego con la curva de Phillips

    El artículo reconstruye el desarrollo intelectual de la curva de Phillips: el trabajo de William Phillips de 1958 sobre desempleo y variación de los salarios nominales, y la posterior adaptación de Samuelson y Solow al vínculo entre desempleo e inflación. Esa reconstrucción histórica describe cómo se formuló y consolidó la teoría; no equivale, por sí misma, a conceder que exista una relación económica universal y estable entre ambas variables.

    La pregunta empírica es precisamente si esa relación inversa puede sostenerse frente a los datos. Para Estados Unidos en el período analizado, la respuesta obtenida es negativa: cuando se examinan las relaciones de largo plazo y se introducen controles, no aparece una asociación inversa estadísticamente significativa capaz de sostener el trade-off convencional.

    El alcance exacto de esta conclusión El estudio no necesita afirmar que una sola muestra histórica haya demostrado por sí misma la inexistencia universal de toda posible curva de Phillips. Lo que demuestra es que la relación no aparece de manera significativa en los datos estadounidenses analizados. La investigación funciona así como una primera pieza de un programa empírico más amplio: si se quiere evaluar la pretensión general de existencia de la curva, el análisis debe replicarse en otros períodos, países, estructuras económicas y especificaciones. Esta investigación coloca la primera piedra; el edificio completo exige más evidencia.

    Una estrategia empírica más amplia que una simple correlación

    El estudio combina análisis descriptivo, inferencia bayesiana, herramientas de series temporales y un modelo bayesiano de la tasa de plusvalía. Las distintas técnicas no cumplen la misma función: cada una permite examinar una parte diferente de la estructura propuesta.

    Correlaciones bayesianas

    Se estiman correlaciones ordinarias y parciales de Pearson y Kendall entre indicadores de cambio tecnológico, inflación y desempleo. Las correlaciones parciales permiten controlar variables como el PIB nominal, el PIB real y los salarios reales. La evidencia se evalúa mediante factores bayesianos, utilizando BF > 3 como criterio de evidencia sustancial a favor de una correlación.

    Los resultados no pueden reducirse a la frase “más I+D siempre implica más inflación”. Las correlaciones ordinarias varían según la fuente de I+D y el indicador de precios: aparecen relaciones tanto positivas como negativas. Sin embargo, al introducir controles emergen relaciones positivas particularmente importantes entre el gasto en I+D federal y capitalista y el índice de precios al consumidor.

    También resulta central el papel de los salarios reales: al controlar su efecto, varias correlaciones negativas entre las fuentes de cambio tecnológico y la inflación total dejan de ser estadísticamente significativas. Esto es coherente con la hipótesis de que el salario real ocupa una posición mediadora en el mecanismo estudiado.

    Causalidad de Granger

    Las pruebas de Granger del artículo no se utilizan para afirmar que “el desempleo no causa la inflación”. Su objeto son las relaciones temporales entre los indicadores de cambio tecnológico y los indicadores de precios, empleando uno, dos y tres rezagos.

    Con un rezago se encuentran relaciones estadísticamente significativas entre todos los tipos de indicadores de cambio tecnológico y todos los tipos de indicadores de precios. Además, el promedio de los valores-p es menor cuando los indicadores tecnológicos actúan como variables explicativas que cuando lo hacen los precios. Con dos rezagos, los indicadores de precios explican la I+D capitalista; con tres, vuelve a predominar el cambio tecnológico como determinante temporal de los precios.

    El resultado, por tanto, es más complejo que una causalidad mecánica en un único sentido: existen interacciones y retroalimentaciones, aunque el patrón temporal proporciona evidencia importante a favor del papel del cambio tecnológico.

    Modelos de corrección de errores

    Tras las comprobaciones correspondientes de las propiedades de las series, los modelos de corrección de errores encuentran que el gasto federal en I+D determina estadísticamente la inflación subyacente, el IPC y el IPP; que el gasto capitalista en I+D determina el IPC y el IPP; y que la I+D de otras fuentes determina igualmente diversos indicadores de precios.

    En la dirección contraria, la inflación subyacente aparece como el canal mediante el cual los precios pueden determinar los indicadores de cambio tecnológico. De nuevo, el resultado describe una estructura dinámica con retroalimentaciones, no una flecha causal simplista.

    · · ·

    Los salarios también cuentan una historia

    El trabajo examina directamente la dinámica de salarios y precios. Las series no poseen la misma estructura probabilística: el crecimiento de los salarios nominales se ajusta a una distribución Gamma, el crecimiento de la inflación total a una distribución Cauchy y el de la inflación subyacente a una distribución logística.

    Esa diferencia importa. Comparar directamente parámetros de distribuciones tan distintas puede inducir a conclusiones incorrectas. Por ello, el artículo utiliza análisis de tendencia-ciclo mediante ondículas de Daubechies, que permiten comparar la dinámica temporal sin imponer una estructura distributiva común.

    Las tendencias obtenidas muestran que los indicadores de precios se encuentran sistemáticamente por encima de los salarios nominales y reales en las comparaciones realizadas. Esto conecta la dinámica inflacionaria con la evolución del poder adquisitivo y prepara el terreno para el mecanismo marxista que constituye el núcleo teórico del artículo.

    El mecanismo marxista: de la innovación al ajuste del salario real

    Cuando un capitalista introduce una innovación tecnológica que eleva la productividad, puede producir mercancías en mejores condiciones que sus competidores y obtener temporalmente una plusvalía extraordinaria: una ventaja derivada de encontrarse por delante de las condiciones productivas medias.

    Pero esa ventaja no puede durar indefinidamente. La competencia impulsa la difusión de la tecnología. Los demás capitalistas adoptan las nuevas técnicas para no quedar rezagados y, a medida que la innovación se generaliza, desaparece la ventaja extraordinaria del pionero.

    Aquí entra el elemento central de la hipótesis. Frente a los aumentos de productividad, la inflación puede operar como mecanismo de ajuste del salario real: los precios aumentan sin que los salarios nominales tengan que reducirse directamente y, si estos no crecen en la misma proporción, disminuye el poder adquisitivo de los trabajadores.

    De esta manera, los beneficios del cambio tecnológico pueden continuar repercutiendo positivamente en la tasa de plusvalía incluso después de que la innovación se haya difundido. El mecanismo no consiste simplemente en que “la inflación absorba una diferencia de costos”. Su elemento distributivo decisivo es la reducción relativa del salario real frente al aumento de productividad.

    Innovación tecnológica
    I+D federal y privada
    Plusvalía extraordinaria
    ventaja temporal
    Difusión tecnológica
    competencia capitalista
    Presión sobre la
    tasa de ganancia
    Inflación
    ajuste del salario real
    Menor poder adquisitivo
    del trabajo
    Plusvalía relativa
    para la clase capitalista
    Acumulación y
    desigualdad
    Fig. 1 — Versión divulgativa del mecanismo desarrollado en el Diagrama 1 del artículo.

    La prueba que conecta tecnología, precios y plusvalía

    Una de las piezas empíricas más importantes del estudio es un modelo lineal generalizado bayesiano objetivo. La variable dependiente es el logaritmo natural de la tasa de plusvalía bruta; como variables explicativas se utilizan el logaritmo del gasto global en I+D y el logaritmo del índice de precios al consumidor.

    49–61 % intervalo de varianza de la tasa de plusvalía bruta explicada por I+D global e IPC
    0,709 mediana del coeficiente del gasto global en I+D
    0,195 mediana del coeficiente del IPC

    El modelo alcanza un R² de 0,55. Al estar formulado en logaritmos, los coeficientes pueden interpretarse como elasticidades. Además, presenta buenos indicadores de validación cruzada y factores de inflación de la varianza de 1,17 para ambas variables explicativas.

    Este resultado es especialmente importante porque enlaza empíricamente tres componentes que la interpretación teórica presenta como relacionados: cambio tecnológico, inflación y tasa de plusvalía. No se trata solo de observar que tecnología y precios se mueven conjuntamente; ambos contienen información sustancial para explicar la variación de la plusvalía bruta.

    · · ·

    Qué sostiene realmente el artículo sobre la inflación

    La interpretación marxista propuesta considera la inflación como parte de la lucha distributiva entre capital y trabajo. Cuando el incremento de los precios reduce los salarios reales, los aumentos de productividad pueden beneficiar principalmente al capital mediante un aumento de la tasa de plusvalía.

    Desde esta perspectiva, la inflación desempeña una función sistémica: contribuye a transformar los efectos temporales de la plusvalía extraordinaria en plusvalía relativa para el conjunto de la clase capitalista, preservando los beneficios de la innovación incluso después de que las nuevas tecnologías se hayan generalizado.

    La inflación aparece así no como un mero accidente monetario, sino como un mecanismo vinculado a la acumulación capitalista, al ajuste de los salarios reales y a la distribución del ingreso entre capital y trabajo.

    Esto tampoco implica negar que las variables monetarias puedan desempeñar un papel. La tesis más precisa es que reducir la inflación a un fenómeno puramente monetario resulta insuficiente para explicar las relaciones empíricas y distributivas estudiadas.

    Lo que el artículo no pretende haber terminado

    El trabajo delimita expresamente sus propias fronteras. La investigación utiliza únicamente datos de Estados Unidos y cubre el período 1968–2021. Por ello, sus resultados no deben presentarse como si una sola investigación hubiese agotado la demostración histórica de la inexistencia de la curva de Phillips en toda economía, época o contexto.

    Pero esta limitación no neutraliza el hallazgo. Si una relación presentada durante décadas como pieza fundamental de la teoría macroeconómica no aparece en una serie estadounidense extensa y bajo una estrategia estadística amplia, existe una razón sustantiva para cuestionar su generalidad y seguir sometiéndola a prueba.

    La primera pieza del rompecabezas La conclusión adecuada no es “la curva queda universalmente refutada con una sola muestra”, pero tampoco “quizá la curva siga siendo válida y este resultado sea una anomalía”. El estudio aporta una primera pieza empírica dentro de un problema más grande. Para completar el rompecabezas hace falta repetir este tipo de investigación en más países, períodos históricos y estructuras económicas. Cada nueva replicación permitirá evaluar hasta dónde puede sostenerse —o desmontarse— la pretensión general de una relación inversa entre inflación y desempleo.

    Las limitaciones importan, pero también indican por dónde continuar

    El gasto en I+D como proporción del PIB es una aproximación al cambio tecnológico, no una medición exhaustiva. No captura plenamente los spillovers tecnológicos, las transferencias internacionales de tecnología, las innovaciones organizacionales, el aprendizaje por la práctica, las mejoras incrementales no formalizadas ni toda la adopción creativa de tecnologías ya existentes.

    Al mismo tiempo, el artículo defiende su utilización porque ofrece series largas, comparables y metodológicamente estandarizadas y porque existe una relación bien documentada entre I+D y medidas posteriores de productividad. Precisamente porque omite formas reales de cambio tecnológico, el indicador puede interpretarse como una cota inferior conservadora del cambio tecnológico total.

    El propio estudio señala además que las relaciones encontradas son complejas y pueden estar afectadas por variables no incorporadas al análisis. También reconoce que, aunque el núcleo teórico queda delineado y sometido a verificación econométrica, todavía debe conectarse con otros componentes de la teoría marxista, como los ciclos económicos y la tendencia decreciente de la tasa media de ganancia.

    ¿Y qué implica todo esto para la política económica?

    Aquí conviene no atribuirle al artículo conclusiones que todavía no desarrolla. El trabajo no presenta una teoría acabada de política monetaria ni concluye, por ejemplo, que una determinada decisión sobre tasas de interés sea simplemente “tratar el síntoma y no la enfermedad”.

    En cambio, señala explícitamente esas preguntas como una línea de trabajo pendiente: deben desarrollarse las implicaciones tanto para la organización sindical de los trabajadores como para los hacedores de política económica, y debe examinarse la relación de la teoría propuesta con las políticas monetarias contemporáneas, particularmente los regímenes de metas de inflación.

    La consecuencia inmediata del artículo es, por tanto, anterior a cualquier receta: si la inflación posee una dimensión estructural ligada al cambio tecnológico, los salarios reales, la plusvalía y la distribución del ingreso, entonces una teoría que pretenda explicarla exclusivamente mediante variables monetarias deja fuera una parte esencial del fenómeno.

    · · ·

    Más allá de la curva

    La contribución del estudio puede condensarse en tres resultados: no encuentra una relación estadísticamente significativa de largo plazo entre inflación y desempleo para Estados Unidos durante el período estudiado; encuentra evidencia de relaciones relevantes entre cambio tecnológico e inflación; y obtiene resultados consistentes con la hipótesis de que la inflación reduce los salarios reales y permite que las ganancias de productividad repercutan en la tasa de plusvalía.

    La importancia del argumento no reside simplemente en sustituir una correlación por otra. El cambio de perspectiva es más profundo: pasa de tratar la inflación como un problema aislado de precios a situarla dentro de la reproducción y acumulación del capital y de la disputa por la distribución del valor producido.

    En ese marco, la pregunta deja de ser únicamente por qué suben los precios. También pasa a ser: ¿qué ocurre con los beneficios de las mejoras tecnológicas cuando se generalizan? ¿Cómo se distribuyen esos incrementos de productividad entre capital y trabajo? ¿Qué función desempeña la variación del salario real en ese proceso?

    Son esas relaciones —y no una simple sustitución mecánica entre inflación y desempleo— las que el artículo propone situar en el centro del análisis.

  • VENTAJA ABSOLUTA VS. VENTAJA COMPARATIVA: UNA COMPARACIÓN MULTIDIMENSIONAL

    VENTAJA ABSOLUTA VS. VENTAJA COMPARATIVA: UNA COMPARACIÓN MULTIDIMENSIONAL

    Teoría del comercio · Econometría · Política económica

    ¿Y si David Ricardo estaba equivocado?
    Un nuevo desafío econométrico a la ventaja comparativa

    Basado en: Gómez Julián, J. M. (2025). “Teorías del comercio internacional versus resultados de los tratados comerciales.” Revista Cubana de Economía Internacional, 12(1), 36–57. Leer el artículo original

    La mayoría de las personas que han llevado un curso introductorio de economía se han encontrado con una idea engañosamente sencilla: los países deberían especializarse en aquello que hacen relativamente mejor, incluso si otro país es mejor produciendo todo. Esta es la doctrina de la ventaja comparativa, atribuida en gran medida al trabajo de David Ricardo de comienzos del siglo XIX sobre el comercio entre Inglaterra y Portugal. Se ha convertido en una de las justificaciones más citadas del libre comercio y de la arquitectura de los tratados comerciales modernos.

    Un artículo de 2025 de Juan Manuel Gómez Julián, publicado en la Revista Cubana de Economía Internacional, plantea una pregunta provocadora: ¿los datos reales de los tratados comerciales respaldan la ventaja comparativa, o apuntan de nuevo hacia la idea más antigua y sencilla de la ventaja absoluta? Su respuesta, alcanzada mediante una combinación de análisis histórico, razonamiento matemático y modelización econométrica moderna, probablemente incomode buena parte del pensamiento convencional sobre política comercial.

    Las dos ideas en competencia, explicadas en lenguaje sencillo

    Antes de entrar en la contribución del artículo, conviene dejar absolutamente claro qué está en juego. Imaginemos dos países:

    • País A puede producir tanto trigo como acero de manera más eficiente —más rápido, más barato y utilizando menos recursos— que el País B.
    • País B es menos eficiente en la producción de ambos bienes.

    La ventaja absoluta (Adam Smith, 1776) sostiene: el País A es sencillamente mejor en ambos bienes. El País B no tiene ninguna razón evidente para competir directamente con él, y el comercio entre ambos estará condicionado por la magnitud de la diferencia en sus capacidades productivas.

    La ventaja comparativa (David Ricardo, 1817) responde: un momento; aunque el País A sea mejor en ambos bienes, es proporcionalmente mejor produciendo acero que trigo. El País B, aunque sea peor en todo, es relativamente menos malo produciendo trigo. Por tanto, si el País A se concentra en el acero y el País B en el trigo, y ambos comercian, los dos terminan beneficiándose. La superioridad absoluta no importa; lo que importa es la proporción entre las eficiencias dentro de cada país.

    La idea es elegante. Pero también es, como sostiene Gómez Julián, sorprendentemente frágil cuando se contrasta con datos del mundo real.

    Lo que realmente hace el artículo

    Gómez Julián aborda la cuestión desde tres ángulos complementarios, lo que proporciona al artículo una amplitud metodológica poco habitual.

    1. Generalización matemática

    En primer lugar, examina hasta qué punto cada teoría se sostiene cuando se la lleva matemáticamente más lejos; es decir, cuando se pregunta si su lógica continúa siendo válida bajo supuestos más generales y realistas que los modelos de manual originales de dos países y dos bienes. Según encuentra, la ventaja comparativa depende de un conjunto estrecho de supuestos —tecnologías idénticas en determinados aspectos, costos constantes, ausencia de costos de transporte y pleno empleo— que tienden a desmoronarse cuando el modelo se vuelve más realista. La ventaja absoluta, por el contrario, mantiene su coherencia bajo una gama más amplia de condiciones.

    2. Contexto histórico

    En segundo lugar, el artículo reconstruye la historia intelectual del problema. Ricardo desarrolló la ventaja comparativa en un mundo en el que la naturaleza de la producción era fundamentalmente distinta de la actual economía globalizada e intensiva en tecnología. El autor sostiene que la teoría fue producto de su época: útil como experimento mental, pero no como guía fiable para la política comercial moderna, especialmente cuando la brecha tecnológica entre los socios comerciales es muy amplia.

    3. Evidencia econométrica

    Es aquí donde el artículo realiza su contribución más distintiva. Gómez Julián utiliza dos familias de modelos estadísticos para comprobar cuál de las dos teorías explica mejor los resultados reales de los tratados comerciales:

    • Modelos de Equilibrio General Computable (EGC) — modelos de simulación a gran escala que intentan representar la economía completa, sector por sector, y posteriormente simulan qué ocurre cuando un tratado comercial modifica aranceles, cuotas o condiciones de acceso a los mercados. Son ampliamente utilizados por instituciones como el Banco Mundial y la OMC.
    • Modelos Lineales Generalizados (GLM) bayesianos objetivos — un enfoque estadístico moderno que emplea inferencia bayesiana —actualizando las creencias mediante los datos— con un mínimo de supuestos subjetivos (priores “objetivos”). Esto permite que los datos hablen con mayor libertad, sin imponer fuertes ideas preconcebidas acerca de cuál “debería” ser la respuesta.

    Los resultados combinados apuntan en la misma dirección: los resultados comerciales entre países con asimetrías tecnológicas significativas son explicados mejor por la ventaja absoluta que por la ventaja comparativa.

    ¿Qué significa esto en la práctica?

    Las implicaciones prácticas son importantes y van a contracorriente de las recomendaciones dominantes en materia de política comercial durante las últimas décadas.

    Si la ventaja comparativa es el enfoque correcto, entonces el libre comercio entre cualesquiera dos países —ricos o pobres, tecnológicamente avanzados o no— resulta mutuamente beneficioso casi por definición. La recomendación de política económica es sencilla: liberalizar, firmar acuerdos y reducir barreras.

    Pero si la ventaja absoluta constituye un modelo mejor, entonces la estructura del acuerdo importa enormemente. Un tratado comercial entre un país altamente industrializado y otro predominantemente agrícola no es intrínsecamente beneficioso para ambas partes. Puede encerrar al país menos desarrollado en exportaciones de bajo valor agregado mientras inunda sus mercados con bienes manufacturados que desplazan a la industria local. Las asimetrías tecnológicas y salariales entre los firmantes pasan entonces a ocupar un lugar central, en lugar de constituir una consideración secundaria.

    En otras palabras, los resultados de Gómez Julián sugieren que los tratados comerciales deberían diseñarse prestando una atención deliberada a los desequilibrios de poder y a las capacidades productivas de las partes involucradas, en lugar de firmarse simplemente bajo el supuesto de que todo comercio es necesariamente beneficioso.

    Por qué esto importa más allá de la economía

    Si sos politólogo, analista de políticas públicas o simplemente alguien que sigue la geopolítica, este debate está lejos de ser meramente académico. Los tratados comerciales se encuentran entre los instrumentos más importantes de la política exterior y de la estrategia económica interna. Moldean la política industrial, los mercados laborales, los patrones migratorios e incluso las alianzas geopolíticas.

    La cuestión de si un tratado comercial es “justo” o “beneficioso” depende de la teoría económica utilizada para evaluarlo. Si la teoría dominante es incorrecta —o, como mínimo, incompleta—, décadas de recomendaciones en materia de política comercial podrían haber subestimado sistemáticamente los riesgos de la liberalización entre socios desiguales.

    Esto no significa que el proteccionismo sea la respuesta. Pero sí significa que los términos de la relación importan. Un tratado comercial que tome en consideración las brechas tecnológicas, incluya disposiciones para la transferencia de tecnología e incorpore mecanismos de ajuste es un instrumento muy distinto de uno que simplemente elimine los aranceles entre economías desiguales y dé el asunto por terminado.

    Referencia: Gómez Julián, J. M. (2025). Teorías del comercio internacional versus resultados de los tratados comerciales: ¿ventaja absoluta o comparativa? Revista Cubana de Economía Internacional, 12(1), 36–57. https://revistas.uh.cu/rcei/article/view/11142

  • Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Pueden encontrar esta librería y su documentación en CRAN y descargargla directamente desde R y RStudio.

    Además, también les recomendamos echarle un ojo al mapa mental resumen al final de este artículo para entender mejor la relación entre las funciones del paquete.

    Reseña de biblioteca de R

    Conoce gdpar

    Modelos de Parámetros Dinámicos Generales mediante Anclaje de Referencia

    En el cálculo fugaz de una decisión de dos segundos —adelantar un automóvil en una carretera estrecha— el cerebro humano realiza un notable truco estadístico. No construye desde cero un modelo del conductor que se aproxima. En su lugar, recupera una referencia de base: el conductor promedio, que representa tiempos de reacción típicos y un nivel modal de agresividad. En una fracción de segundo, interpreta las señales específicas del conductor real —velocidad relativa, tipo de vehículo, micromovimientos— y estima en qué medida este conductor específico se desvía de la referencia. La decisión de adelantar surge de esa síntesis.

    Esta receta cognitiva —referencia poblacional + desviación individual— constituye el fundamento filosófico del paquete de R gdpar (General Dynamic Parameter models via Reference Anchoring) de José Mauricio Gómez Julián. El paquete toma esta intuición, la formaliza como una descomposición estadística rigurosa, demuestra las condiciones bajo las cuales es matemáticamente identificable, proporciona un motor bayesiano basado en Stan para estimarla y añade capas de inferencia causal, muestreo adaptativo a la geometría e inferencia robusta frente a la dependencia.

    La anatomía de la desviación

    Cada capa de gdpar constituye una elaboración de una única y elegante ecuación. Para cada observación $i$ con covariables $x_i$:

    $$ \theta_i \;=\; \theta_{\text{ref}} \;+\; \Delta(x_i,\; \theta_{\text{ref}}) $$

    Se lee así: el parámetro del individuo $i$ es igual a una referencia poblacional, más una desviación que es, a su vez, función de las covariables del individuo y de la propia referencia.

    Es en esa última cláusula donde la arquitectura se aparta de la estadística clásica. La desviación $\Delta$ no depende únicamente de quién sos (tus covariables $x_i$); depende de cuál es la referencia. Si trasladás el modelo a una nueva población, la función de desviación se comporta de manera diferente porque $\theta_{\text{ref}}$ es uno de sus argumentos. Esta dependencia estructural es la característica definitoria del «anclaje de referencia». Distingue a gdpar de los modelos de efectos aleatorios o de coeficientes variables, en los cuales la desviación está estructuralmente separada de la referencia.

    Entonces, ¿qué forma tiene $\Delta$? El paquete distingue una forma funcional específica denominada descomposición Aditiva–Multiplicativa–Modulada (AMM):

    $$ \Delta(x,\theta_{\text{ref}}) \;=\; \underbrace{a(x)}_{\text{aditiva}} \;+\; \underbrace{b(x)\odot\theta_{\text{ref}}}_{\text{multiplicativa}} \;+\; \underbrace{W(\theta_{\text{ref}})\,x}_{\text{modulada}} $$

    Tres mecanismos, claramente separados e interpretables de forma independiente:

    • $a(x)$ — Un desplazamiento puramente aditivo. Puede pensarse como un efecto fijo tradicional determinado por covariables.
    • $b(x)\odot\theta_{\text{ref}}$ — Un escalamiento de la referencia dependiente de las covariables (mediante el producto de Hadamard o producto elemento a elemento). Aquí es donde «la desviación depende de la referencia» entra de manera multiplicativa.
    • $W(\theta_{\text{ref}})\,x$ — Las covariables se combinan mediante una matriz $W$ que, a su vez, está ajustada por la referencia. Este es el canal explícito y estructuralmente dependiente de la referencia.

    Los modelos estándar aparecen como casos particulares. Si se establece $\Delta \equiv 0$, se obtiene una regresión de efectos fijos. Si se establece $W \equiv 0$, se obtiene un modelo jerárquico con interacción multiplicativa. Si se establece $b \equiv 0$, se obtiene un modelo de coeficientes variables. La AMM es la familia natural mínima que contiene los tres casos y eleva la referencia al papel de argumento activo de la desviación.

    Los tres motores de estimación

    gdpar define tres motores complementarios para estimar $\Delta$. De manera crucial, solo uno es ejecutable en la versión actual: una decisión deliberada de plantear un alcance matemático que excede la superficie ejecutable y de declararlo con transparencia.

    Ruta Motor Representación Estado
    Ruta 1 Bayesiano jerárquico (Stan) AMM paramétrica ✅ Operativa
    Ruta 2 Coeficientes variables (splines) $\beta(z)$ suave 🚧 Conceptual
    Ruta 3 Hiperrred / Red neuronal La red genera $\theta_i$ 🚧 Conceptual

    Las rutas 2 y 3 están documentadas con calidad de referencia —la Wiki desarrolla la teoría asintótica completa (tasas de contracción, Bernstein–von Mises)—, pero si se invocan terminan con gdpar_unsupported_feature_error. La Ruta 1 asigna distribuciones a priori a cada componente ($\theta_{\text{ref}}, a, b, W$) y muestrea la distribución posterior conjunta mediante HMC, produciendo de forma nativa incertidumbre basada en la posterior completa.

    Historia de dos posteriores: EB frente a FB

    Dentro de la Ruta 1, gdpar ofrece dos regímenes inferenciales. Bayes completo (FB), mediante gdpar(), muestrea la posterior conjunta y se mantiene como la opción más fiel a la analogía cognitiva. Bayes empírico (EB), mediante gdpar_eb(), estima los hiperparámetros maximizando una verosimilitud marginal mediante una aproximación de Laplace y, posteriormente, muestrea los parámetros restantes de manera condicional.

    El comparador EB frente a FB

    En lugar de imponer una elección, gdpar los trata como rutas paralelas. Incluye un comparador específico, gdpar_compare_eb_fb(), que cuantifica el grado de concordancia en $\theta_{\text{ref}}$ y en el vector de parámetros reducido $\xi$. La Wiki desarrolla la teoría con profundidad de primer nivel: las posteriores de nivel inferior de EB y FB coinciden asintóticamente (Teorema 7A), mientras que los intervalos EB presentan una cobertura insuficiente de orden $O(n^{-1})$ (Proposición 7B). Si alguna vez te has preguntado si EB es «suficientemente bueno» para tus datos, gdpar permite responderlo empíricamente.

    Regresión distribucional: cada parámetro es una ranura

    gdpar no está restringido a modelar la media. Una distribución de probabilidad posee múltiples parámetros —localización, escala, forma, índice de cola, probabilidad de inflación de ceros— y cada uno de ellos puede tener su propia descomposición AMM. El paquete los indexa mediante $k = 1, \dots, K$:

    $$ \theta_i^{(k)} = \theta_{\text{ref}}^{(k)} + \Delta^{(k)}(x_i, \theta_{\text{ref}}^{(k)}), \qquad k = 1, \dots, K $$

    El repertorio incorporado abarca las familias gaussiana, Poisson, binomial negativa, Bernoulli, Beta, Gamma, Student-$t$, Tweedie, ZIP, ZINB y hurdle. Los modelos inflados en cero y hurdle reciben un tratamiento especialmente elegante: tanto la probabilidad de inflación de ceros $\pi_i$ como el parámetro de conteo $\theta_i$ quedan anclados a sus respectivas referencias, conformando un diseño de desviación dual.

    El puente causal

    Dado que la forma AMM produce parámetros individuales, los efectos individuales del tratamiento surgen de manera natural. gdpar_causal_bridge() implementa un T-learner: ajusta el modelo anclado por separado bajo tratamiento y control y, posteriormente, obtiene el efecto promedio condicional del tratamiento (CATE) en $x_i$ como la diferencia entre las predicciones individuales ancladas:

    $$ \widehat{\tau}(x_i) = \widehat{\mu}_1(x_i) – \widehat{\mu}_0(x_i) $$

    Una segunda capa, gdpar_compare_meta_learners(), compara el learner basado en AMM con meta-learners externos mediante adaptadores conectables: grf::causal_forest del lado de R y CausalForestDML de EconML del lado de Python (mediante reticulate). Las afirmaciones causales del marco se someten a comparación empírica; no se dan simplemente por sentadas.

    Mecánica y engranajes

    Varias decisiones de ingeniería elevan a gdpar de ejercicio teórico a entorno computacional serio:

    • Generador de código Stan: Compone programas a partir de piezas canónicas —bloques AMM para $p=1$ y $p \geq 1$, bloques marginales/condicionales EB y bloques distribucionales-$K$— seleccionadas según la configuración resuelta $(K, p, \text{family}, W, \text{parametrization}, \text{group})$. La base de $W$ admite B-splines con evaluación Cox–de Boor del lado de Stan, garantizando diferenciabilidad dentro de HMC.
    • Verificación previa de identificabilidad: Antes de cualquier muestreo, gdpar_check_identifiability() ejecuta una comprobación de la matriz de Gram (Proposición 1C), una comprobación por coordenada entre componentes (C4-bis) para $p > 1$ y una comprobación anti-aliasing por grupo (C7). Si tu diseño no es identificable, lo sabrás antes de que el muestreador consuma tiempo de CPU, acompañado de un gdpar_identifiability_error estructurado que identifica las direcciones dependientes.
    • Reparametrización guiada por los datos: Trata la parametrización de $b(x) \odot \theta_{\text{ref}}$ como una decisión previa al ajuste. Un breve piloto calcula una razón de información y deriva el problema hacia CP, NCP o —la solución de gdpar dirigida a la causa raíz— una reparametrización lineal que muestrea directamente el producto $\theta_{\text{ref}} \cdot b$, evitando por completo los embudos bilineales.

    Herramientas avanzadas de activación opcional

    Dos capacidades avanzadas están desactivadas por defecto y documentadas con el mismo nivel de detalle que la ruta principal.

    1. Muestreo adaptativo a la geometría

    Las posteriores AMM jerárquicas pueden presentar geometrías particularmente hostiles —embudos, cuasi-determinismo, colas pesadas—. El motor geométrico, de activación opcional, asciende por una jerarquía de métricas riemannianas: Euclidiana → Fisher/SoftAbs → subriemanniana → relativista/Finsler. Un orquestador certificador diagnostica la patología, selecciona una métrica, ajusta el integrador y emite un certificado. Si se certifica que el muestreo completo es inviable, un mecanismo alternativo de Laplace proporciona una posterior plug-in con un ELPD comparable al de mgcv-REML o INLA-Laplace.

    2. Inferencia robusta frente a la dependencia

    gdpar no modela la dependencia temporal o espacial dentro de su estructura puntual; en su lugar, hace que la inferencia sea robusta frente a la dependencia (un enfoque de independencia de trabajo + varianza sándwich, en el espíritu de Liang & Zeger, 1986). Se obtienen diagnósticos (Durbin–Watson, Ljung–Box, $I$ de Moran) y errores estándar robustos mediante bootstrap por bloques: bloques móviles o circulares en el tiempo (con longitud automática de bloque flat-top de Politis–White) y bloques espaciales en mosaico con origen aleatorizado. Las estimaciones puntuales permanecen intactas; únicamente la incertidumbre se vuelve más honesta.

    ⚠️ Limitaciones declaradas con transparencia

    La Wiki es admirablemente explícita respecto del alcance. Solo la Ruta 1 es ejecutable en la versión 0.1.0. La dependencia no se modela: únicamente se hace robusta la inferencia frente a ella. El alcance matemático del paquete excede su superficie ejecutable por diseño. Conviene leer cuidadosamente las notas de «Estado de implementación» antes de depender de una determinada funcionalidad.

    En resumen

    gdpar toma una de las ideas más naturales de la predicción humana —predecir a un individuo como una desviación respecto de una referencia poblacional, donde la propia desviación depende de esa referencia— y la transforma en un marco de regresión bayesiana plenamente especificado, con comprobación de identificabilidad y respaldado por Stan. Es teóricamente riguroso, computacionalmente serio y excepcionalmente transparente respecto de lo que hace y de lo que todavía no hace. Si tu trabajo involucra heterogeneidad individual, regresión distribucional o estimación de efectos causales con incertidumbre fundamentada, gdpar merece una mirada detenida.

  • Marx, Engels y la Paradoja del Valor C

    Marx, Engels y la Paradoja del Valor C

    Por qué una ameba tiene 200 veces más ADN que tú — Una mirada filosófica a la paradoja del valor C
    Divulgación · Filosofía de la Ciencia · Biología Molecular

    La paradoja del valor C:

    ¿Por qué una ameba tiene 200 veces más ADN que tú?

    Un filósofo sostiene que la forma en que contamos los genes está mal planteada y propone una corrección dialéctica informada por la mecánica cuántica.

    Entrada de blog 2025
    ~ 9 min de lectura

    Imagina que te entregan dos libros. Uno es una novela breve; el otro, una enciclopedia del tamaño de una maleta. Intuitivamente, supondrías que la enciclopedia contiene más información. Ahora imagina que la novela resulta contener las instrucciones para construir un ser humano completo, mientras que el enorme volumen apenas describe cómo ser una ameba unicelular. Bienvenido a la paradoja del valor C —uno de los enigmas más persistentes de la biología moderna— y a un artículo reciente que propone una manera verdaderamente inusual de pensarla.

    El artículo en cuestión es “Outlining a Dialectical Hypothesis on the C-Value Paradox in the Light of Quantum Chemistry”, del filósofo José Mauricio Gómez Julián, publicado en el archivo Pitt Philosophy of Science (disponible aquí). No es un artículo típico de biología. Se mueve con fluidez entre la lógica hegeliana, la mecánica cuántica, los elementos genéticos egoístas y las matemáticas de cómo medimos conjuntos. Si eso suena intimidante, no te preocupes: al final de esta entrada verás por qué el argumento importa, incluso si nunca has abierto un libro de biología.

    1. El problema: más ADN, pero no más complejidad

    Empecemos por lo básico. Cada célula viva contiene una copia completa del ADN del organismo: su genoma. Los biólogos miden el tamaño del genoma en pares de bases (pb) o, por comodidad, en megabases (Mb), donde 1 Mb = un millón de pares de bases. Esta medida se denomina valor C.

    En los procariotas (bacterias y arqueas, las formas de vida más simples, sin núcleo celular), la relación es bastante intuitiva: genoma más grande, más genes y, hasta cierto punto, un organismo más complejo. Pero cuando pasamos a los eucariotas (desde las levaduras hasta los seres humanos, cuyas células contienen núcleo), la intuición se derrumba.

    Algunas cifras sorprendentes
    Organismo Tamaño del genoma (Mb) Número de genes (aprox.)
    Levadura12~6,000
    Mosca de la fruta180~14,000
    Ser humano3,400~20,000–25,000
    Cebolla18,000
    Ameba (A. dubia)686,000

    Fuentes: Latorre & Silva (2013); Pray (2022).

    Una ameba unicelular contiene aproximadamente 200 veces más ADN que un ser humano. Una cebolla necesita alrededor de cinco veces más ADN que nosotros. Los anfibios, como grupo, muestran variaciones en el tamaño del genoma de hasta 91 veces. Como señala el artículo, citando a Latorre y Silva, «es difícil creer que esto pueda reflejar variaciones de casi 100 veces en el número de genes necesarios para dar origen a los anfibios correspondientes».

    Tampoco se trata simplemente de cuántos genes hay. Incluso el recuento bruto de genes codificantes de proteínas no sigue bien la complejidad: un pez globo tiene aproximadamente el mismo número que un ser humano (~35,000), y la planta de arroz tiene más (~51,000). La desconexión entre el tamaño del genoma, el número de genes y la complejidad del organismo es la paradoja del valor C.

    2. ¿Por qué debería importarle a alguien fuera de la biología?

    Si eres economista, politólogo o matemático, quizá te preguntes qué tienen que ver las amebas con tu trabajo. La respuesta no está en los detalles biológicos, sino en el tipo de razonamiento que emplea el artículo. Gómez Julián plantea un argumento sobre cómo medimos la complejidad y, en particular, por qué nuestras herramientas estándar de conteo y medición fallan cuando el sistema que estudiamos es fundamentalmente no lineal.

    Este problema aparece en todas partes: en los mercados financieros (donde pequeños choques se propagan de forma impredecible), en los sistemas políticos (donde un solo acontecimiento puede transformar un orden entero) y en la ecología (donde las especies interactúan en redes, no en cadenas). En el fondo, la paradoja del valor C es un caso de estudio sobre lo que ocurre cuando se intenta imponer un marco contable lineal a una realidad no lineal.

    3. La filosofía: ¿qué significa aquí «dialéctico»?

    La columna vertebral filosófica del artículo proviene del materialismo dialéctico, una tradición con raíces en Hegel y desarrollada por Marx, Engels y posteriormente por filósofos soviéticos. Para quienes no estén familiarizados con el término, la idea esencial puede expresarse así:

    Las cosas no son únicamente lo que son en su estado actual de desarrollo, sino también su potencial.

    En este marco, la realidad es una totalidad: no solo lo que existe actualmente, sino también lo que podría existir, lo que está llegando a ser y lo que está siendo aniquilado. El concepto de «contradicción» es central, pero no en el sentido coloquial de un error lógico. Una contradicción dialéctica significa que cualquier cosa compleja contiene tendencias opuestas de desarrollo que son simultáneamente complementarias y mutuamente excluyentes. Estas tendencias pueden ser no antagónicas (estables y coexistentes) o antagónicas (desestabilizadoras y, en última instancia, capaces de obligar al sistema a transformarse en algo cualitativamente nuevo).

    Gómez Julián establece un paralelismo explícito entre esta noción filosófica y el principio de complementariedad de Bohr en mecánica cuántica: para comprender plenamente un fenómeno cuántico se necesita tanto la descripción ondulatoria como la descripción corpuscular, aunque ambas sean mutuamente excluyentes. El artículo sostiene que esto no es meramente una analogía, sino que refleja una estructura lógica más profunda compartida por la física, la química y la biología.

    Para quienes tengan formación en economía, el paralelismo con el razonamiento dialéctico en economía política es directo. Así como una mercancía es simultáneamente valor de uso y valor de cambio —y no puede comprenderse examinando solo uno de esos aspectos—, un gen es simultáneamente una estructura física (una secuencia de ADN) y un agente funcional (portador de información, elemento regulador o replicador «egoísta»). Reducirlo a una sola dimensión es precisamente lo que genera la paradoja.

    4. El núcleo matemático: por qué falla el conteo lineal

    Llegamos ahora a lo que interesará a matemáticos y econometristas. El artículo formula una afirmación matemática precisa: las herramientas que utilizamos para contar genes presuponen linealidad, pero el sistema genético es no lineal.

    Formalmente, una función φ se denomina sigma-aditiva (o numerablemente aditiva) si la medida de una unión de conjuntos disjuntos es igual a la suma de las medidas de cada conjunto. Este es el fundamento estándar de la teoría de la probabilidad y de la teoría de la medida: los axiomas de Kolmogórov en los que se apoya todo estadístico y econometrista.

    Una función subaditiva, en cambio, solo exige que la medida de la unión sea menor o igual que la suma de las partes. Las funciones aditivas son un caso particular de las subaditivas. En genética, cuando se utiliza un modelo aditivo se está suponiendo una relación perfectamente lineal entre el número de copias de un alelo y los rasgos del organismo: sin dominancia, sin interacción y sin epistasis. Como mostraron Huang y Mackay (2016), esta suposición es empíricamente inadecuada para la mayoría de los rasgos cuantitativos.

    El argumento de Gómez Julián es que contar genes mediante funciones sigma-aditivas trata implícitamente el genoma como un sistema lineal: más genes = proporcionalmente más complejidad. Pero la evidencia muestra que esto es falso. La complejidad surge de cómo interactúan los genes, no de cuántos hay. Por lo tanto, la propia función de conteo debe cambiar.

    5. ¿Qué genera realmente la complejidad? Ocho factores

    El artículo propone que cualquier relación significativa entre el número de genes y la complejidad del organismo debe tener en cuenta ocho aspectos clave de los procesos moleculares subyacentes. Aquí están, expresados en términos sencillos:

    1. ¿Qué tipo de información está codificada? — No todos los genes contienen el mismo tipo de instrucción. Algunos codifican proteínas estructurales; otros regulan cuándo y dónde se producen esas proteínas.
    2. ¿Qué sistema de codificación se utiliza? — El «lenguaje» del genoma no es uniforme; distintas regiones operan bajo reglas de codificación diferentes.
    3. ¿Deberíamos asignar un mayor peso a los genes codificantes de proteínas? — Los genes codificantes de proteínas constituyen apenas alrededor del 1,5 % del genoma humano. ¿Debería contar igual el 98,5 % restante?
    4. ¿Qué tipo de transcripción ocurre? — Mediante el splicing alternativo, un solo gen puede producir múltiples proteínas diferentes. Los seres humanos podrían producir más de 500,000 proteínas distintas a partir de solo ~20,000 genes. El proceso no es uno a uno.
    5. El ADN es un sistema dinámico no lineal. — La doble hélice no se comporta como una cadena lineal simple. Los investigadores la modelan mediante hamiltonianos no lineales al menos desde la década de 1980, y a lo largo de la cadena pueden propagarse ondas conformacionales solitarias (solitones).
    6. ¿Qué tipo de gen está involucrado? — Existen genes codificantes de proteínas, genes de ARN, secuencias reguladoras, elementos transponibles y otros. No todos contribuyen a la «complejidad» de la misma manera.
    7. ¿Qué papel desempeñan los «genes negativos»? — Esta es una de las contribuciones más distintivas del artículo. Gómez Julián rebautiza los llamados «genes egoístas» como «genes negativos», tomando prestado de la filosofía dialéctica el concepto de negatividad. Son elementos genéticos (como los transposones) que se replican en beneficio propio, aunque sean dañinos o neutrales para el organismo. Existen en un estado de unidad y lucha con los genes «ordinarios» del organismo, y este conflicto es, según Werren (2011), «un importante motor del cambio y la innovación evolutivos».
    8. ¿Qué sucede durante la transcripción y en torno a ella? — Es el momento en que la doble hélice del ADN se desenrolla y quedan expuestas hebras individuales. Es el punto de máxima vulnerabilidad y máximo potencial creativo: aquí tienen lugar la edición del ADN, el trans-splicing y el quimerismo en tándem. Según el artículo, la fuente de la complejidad no lineal se concentra en esta fase.

    Si estos ocho factores pudieran incorporarse a un nuevo tipo de función de conteo —una que capte las interacciones no lineales, la regulación génica y la interacción dialéctica entre genes «positivos» y «negativos»—, la paradoja podría disolverse. El tamaño del genoma y el número de genes corresponderían entonces, al menos aproximadamente, con la complejidad del organismo.

    6. La química cuántica entra en escena

    Quizá te preguntes: ¿dónde encaja la mecánica cuántica en todo esto? La respuesta del artículo es que los enlaces covalentes que mantienen unido el ADN son fenómenos de naturaleza cuántico-mecánica. Ya en la década de 1920, Heitler y London mostraron que los enlaces covalentes pueden entenderse mediante la ecuación de Schrödinger. Los nucleótidos de cada hebra de ADN están unidos por fuertes enlaces covalentes, de modo que la dinámica de la hebra —su rigidez, su desenrollamiento y sus cambios conformacionales— está regida, en última instancia, por la mecánica cuántica.

    En la práctica, resolver la ecuación de Schrödinger completa para una molécula tan grande como el ADN supone un desafío computacional enorme. Pero se están produciendo avances. El artículo destaca tres progresos recientes:

    Progreso computacional

    Las soluciones analíticas y numéricas del modelo de ADN de Peyrard-Bishop (un modelo no lineal de la dinámica del ADN) muestran actualmente una fuerte convergencia (Al et al., 2020). Se han encontrado soluciones tipo kink y soluciones localizadas para la versión helicoidal del mismo modelo, que podrían servir como herramientas para modelar la transcripción de ADN a ARN (Zdravković et al., 2019). Además, el recocido cuántico se ha aplicado al ensamblaje de novo de genomas, resolviendo el problema combinatorio de unir fragmentos de ADN mediante optimización cuántica e inspirada en la computación cuántica (Boev et al., 2021).

    Son pasos iniciales, pero sugieren que las barreras computacionales para modelar el ADN como un sistema no lineal y cuántico-mecánico no son permanentes. La computación cuántica podría hacer viable en el futuro el análisis de moléculas grandes basado en la ecuación de Schrödinger.

    7. El panorama más amplio: un universo autodidacta

    En este punto, el artículo realiza su movimiento filosófico más ambicioso. Basándose en la investigación de Alexander et al. (2021), Gómez Julián describe un universo autoorganizado, determinista, históricamente determinado y autodidacta: uno que «evoluciona aprendiendo de manera autodidacta sus propias leyes», aplicando a escala cosmológica un proceso físicamente equivalente a la selección natural biológica. Desde esta perspectiva, el universo es un sistema que incorpora nuevas no linealidades a sí mismo con el paso del tiempo, una suerte de incremento espontáneo de la complejidad.

    Esto se vincula con el concepto de emergencia: la aparición espontánea de nueva información (nuevas estructuras, nuevos comportamientos) como resultado de la dinámica interna de un sistema. Las propias leyes de la física podrían estar sometidas a leyes de orden superior, del mismo modo que una lógica de cierto orden está sujeta a las reglas de una lógica de orden superior.

    Para la paradoja del valor C, la implicación es la siguiente: no se pueden comprender las partes (los genes) sin comprender el todo (el organismo y su historia evolutiva), ni se puede comprender el todo sin entender cómo emergió de las partes. La verdad, como diría Hegel, está en la totalidad.

    · · ·

    8. Entonces, ¿cómo sería realmente una solución?

    Gómez Julián se cuida de señalar que su artículo es una guía, no una solución. Propone construir una «función de conteo génico libre de paradoja» (PFGCF): un nuevo objeto matemático que sustituiría el conteo sigma-aditivo simple por algo capaz de captar:

    • Las interacciones génicas no lineales
    • El papel del splicing alternativo y de los elementos reguladores
    • La interacción dialéctica entre los genes ordinarios y los genes «negativos» (egoístas)
    • Las propiedades cuántico-mecánicas de la estructura del ADN
    • Lo que sucede durante la transcripción y en torno a ella

    Esta función quizá ni siquiera sea una única función, sino una familia de funciones, cada una destinada a captar distintos aspectos de la complejidad genómica. Su construcción requerirá, según sostiene el artículo, «filósofos, químicos, genetistas y físicos, así como el uso de equipos computacionales de alta capacidad».

    Se trata, en palabras del propio autor, de una «especulación legítima»: fundamentada en ciencia establecida, pero aún no verificada experimentalmente. El valor del artículo reside en identificar qué factores importan y qué tipo de matemáticas se necesitan, más que en ofrecer un modelo terminado.

    9. Por qué importa este artículo (aunque no seas biólogo)

    Volvamos a la pregunta de por qué esto debería importarle a alguien que no sea biólogo. Hay tres razones:

    El todo es más que la suma de sus partes, y las herramientas que utilizamos para contar las partes deben reflejarlo.

    Primero, el artículo es un caso de estudio de pensamiento interdisciplinario. Entreteje filosofía, matemáticas, química y biología de una manera poco común en cualquier disciplina. Se esté o no de acuerdo con su marco materialista-dialéctico, el intento de tender un puente entre Hegel y la química cuántica resulta intelectualmente estimulante.

    Segundo, pone de relieve un problema metodológico general: cuando las herramientas lineales fallan, ¿qué las sustituye? Los economistas se enfrentan a esto cuando el PIB no capta el bienestar; los politólogos, cuando el recuento de votos no capta la salud democrática; y los matemáticos, cada vez que la teoría de la medida se encuentra con la complejidad del mundo real. En el fondo, el llamado del artículo a crear nuevas funciones de conteo es un llamado a desarrollar nuevas matemáticas.

    Tercero, nos recuerda que las paradojas son productivas. La paradoja del valor C existe desde hace décadas y no ha sido resuelta, pero ha obligado a los biólogos a descubrir el splicing alternativo, los elementos transponibles, el ARN no codificante y la regulación epigenética. La paradoja nunca fue un callejón sin salida; fue una señal que apuntaba hacia verdades más profundas. Es una lección que cualquier disciplina puede aprovechar.

    · · ·

    Puedes leer el artículo completo de José Mauricio Gómez Julián en PhilSci Archive: https://philsci-archive.pitt.edu/24513/

  • Física Teórica y Sobre Por Qué Un Huevo Roto Jamás Vuelve a su Estado Original

    Física Teórica y Sobre Por Qué Un Huevo Roto Jamás Vuelve a su Estado Original

    Por qué los huevos rotos no se recomponen — Una nueva física de la historia, la dirección y el propósito
    Física • Filosofía • Fundamentos

    Por qué los huevos rotos no se recomponen

    Un filósofo sostiene que la historia, y no la mecánica, es la gramática más profunda del mundo físico — y que la propia materia persigue la estabilidad.

    Basado en un artículo de José Mauricio Gómez Julián ~9 min de lectura

    ¿Por qué un huevo roto nunca vuelve a recomponerse por sí solo? Todas las leyes que gobiernan el movimiento de sus átomos son perfectamente reversibles: si reproducimos la película hacia atrás, nada en las matemáticas protesta. Y, sin embargo, en el mundo real, los huevos rotos permanecen rotos. Esta brecha entre lo que permiten nuestras ecuaciones y lo que realmente hace la naturaleza ha perseguido a la física durante más de un siglo. Un nuevo artículo de la Universidad de Costa Rica propone una respuesta tan audaz filosóficamente como precisa matemáticamente.

    La paradoja que no desaparece

    En la década de 1870, el físico austríaco Josef Loschmidt cuestionó la explicación estadística de Ludwig Boltzmann sobre la segunda ley de la termodinámica. Su objeción era devastadoramente simple: si las ecuaciones del movimiento funcionan igual hacia adelante y hacia atrás en el tiempo, ¿cómo puede la entropía —el desorden— aumentar siempre? Esta es la paradoja de Loschmidt, situada en la intersección entre la termodinámica, la mecánica cuántica y la filosofía de la ciencia.

    Los físicos han propuesto muchas respuestas parciales. Algunas apelan a la improbabilidad estadística de la reversión (hay astronómicamente más estados desordenados que ordenados). Otras recurren a condiciones de frontera cosmológicas: el universo simplemente habría comenzado en un estado muy especial de baja entropía. Trabajos más recientes, citados en este artículo, recurren a la teoría de la información y al principio de Landauer (la idea de que borrar información tiene un costo físico mínimo).

    Pero el autor —José Mauricio Gómez Julián, desde la Universidad de Costa Rica— considera insuficientes todas estas soluciones. Su tesis central es provocadora: la paradoja no está en la naturaleza. Está en nuestros modelos. Construimos teorías fundamentalmente ahistóricas y luego nos sorprendemos cuando el mundo real —que es fundamentalmente histórico— no las obedece. El problema, sostiene, no es que la realidad se comporte mal. Es que nuestras teorías se niegan a recordar.

    El giro central

    En lugar de preguntar «¿Por qué el mundo macroscópico es irreversible?», el artículo reformula por completo la cuestión: «¿Por qué insistimos en construir modelos reversibles y luego llamamos paradoja a la irreversibilidad?»

    El motor filosófico: el materialismo dialéctico

    El artículo se fundamenta en el materialismo dialéctico, una tradición filosófica arraigada en Marx y Engels, desarrollada previamente por Hegel en su forma idealista y posteriormente por físicos soviéticos como Blokhintsev y Rosental. Si esto suena inusual para un artículo de física, el autor diría que precisamente ahí está el punto.

    El materialismo dialéctico sostiene que la realidad está constituida por materia en movimiento, que las contradicciones no son fallas de nuestro pensamiento sino rasgos del mundo, y que los cambios cuantitativos terminan produciendo saltos cualitativos. También insiste en una distinción que la física moderna ha tendido a confundir:

    • Epistemología — lo que podemos conocer y medir (nuestras limitaciones como observadores).
    • Ontología — lo que realmente existe en el mundo, independientemente de nuestra capacidad para observarlo.

    Esta distinción resulta ser la herramienta más incisiva del artículo. Cuando la mecánica cuántica afirma que la posición de una partícula es «incierta», el autor pregunta: ¿esa incertidumbre es una característica de la realidad (ontología) o una característica de nuestro conocimiento (epistemología)? Su respuesta es matizada y tiene consecuencias importantes. La propia ecuación de Schrödinger es plenamente determinista: si se le proporciona un estado inicial y un hamiltoniano, predecirá la función de onda futura con perfecta precisión. La aleatoriedad aparece únicamente cuando intentamos medir, cuando el sistema cuántico entra en contacto con nuestros instrumentos macroscópicos.

    En otras palabras, la probabilidad en la mecánica cuántica es un recurso epistemológico —una poderosa herramienta para manejar la complejidad y el conocimiento incompleto—, no una afirmación de que la realidad misma sea fundamentalmente aleatoria. Esto no significa que la mecánica cuántica esté equivocada. Significa que su carácter probabilístico nos habla de nosotros, no del universo.

    El autor procura, sin embargo, distinguir esto del determinismo laplaciano clásico. El principio de incertidumbre de Heisenberg, sostiene, es ontológico: refleja características estructurales genuinas de la realidad (la complementariedad entre posición y momento). Por tanto, el mundo es determinista en un sentido profundo, pero no en el sentido ingenuo de un mecanismo de relojería. Es determinista del modo en que lo es un sistema complejo y dependiente de la trayectoria: restringido, estructurado y regido por leyes, pero demasiado intrincado para que ningún observador pueda predecirlo por completo.

    Cuando el terreno contradice al mapa, confía en el terreno

    Dependencia de la trayectoria: la historia antes que el tiempo

    Aquí es donde el artículo realiza su movimiento conceptual más original. El autor sostiene que la dependencia de la trayectoria es más fundamental que el tiempo mismo.

    ¿Qué significa esto? En los sistemas complejos —economías, ecosistemas, organismos vivos—, el estado actual no depende únicamente de las condiciones presentes, sino de toda la secuencia de acontecimientos que condujo hasta él. Una economía con el mismo PIB, población y tecnología que otra puede comportarse de manera muy distinta porque sus instituciones, crisis y decisiones de política siguieron una trayectoria histórica diferente. El artículo sostiene que esto no es solo una característica de los sistemas complejos. Es una característica de toda la realidad física, a todas las escalas.

    En este marco, el tiempo se replantea. No es un parámetro de fondo a través del cual suceden las cosas (como en la mecánica newtoniana), ni una dimensión entretejida en el espacio-tiempo (como en la relatividad), sino una estructura que registra las transformaciones materiales: una especie de memoria universal. El espacio y el tiempo coemergen como el tejido necesario para que la materia se desarrolle y preserve su trayectoria evolutiva.

    El autor remonta esta idea a la filosofía de la naturaleza de Hegel (publicada décadas antes de la relatividad de Einstein), donde lugar, espacio y tiempo se entienden como una unidad, y donde el movimiento —y, por tanto, la materia— surge de su contradicción. El pasaje es llamativo:

    El lugar es singularidad espacial… Este perecer y regenerarse del espacio en el tiempo y del tiempo en el espacio… es el movimiento. Este devenir… es la unidad inmediata, idéntica y existente del espacio y el tiempo: es la materia.
    — Hegel, Enciclopedia de las ciencias filosóficas

    Si la dependencia de la trayectoria es fundamental, entonces la irreversibilidad no es algo que deba explicarse, sino algo que debe asumirse, del mismo modo que los matemáticos asumen la existencia de los números naturales en lugar de demostrarla. Cada huevo roto, cada estrella que envejece y cada especie que ha evolucionado constituyen evidencia de que el universo recuerda su propia historia.

    Una nueva ecuación para un universo que recuerda

    El autor no se detiene en la filosofía. Propone una reformulación matemática concreta de la ecuación de Schrödinger —la ecuación fundamental de la mecánica cuántica— para hacer explícita la dependencia de la trayectoria.

    La mecánica cuántica estándar se escribe así:

    Forma estándar

    iℏ ∂ψ/∂t = Ĥ ψ

    donde el hamiltoniano Ĥ describe la energía del sistema en un instante dado.

    La reformulación del artículo introduce un hamiltoniano dependiente de la historia:

    Forma dependiente de la trayectoria

    iℏ ∂ψ/∂t = Ĥ(t) ψ

    donde Ĥ(t) = Ĥ₀ + ∫ K(t, t′) ψ(t′) dt′

    Aquí, t no es tiempo de reloj, sino un índice de interacción: un ordenamiento de cómo surgieron las interacciones físicas. El núcleo K(t, t′) codifica cómo cada interacción previa influye en la actual.

    Es una propuesta audaz. Afirma que el estado de un sistema cuántico en cualquier momento está determinado por la cadena completa de interacciones que lo condujo hasta allí, no solo por su configuración instantánea. El autor también define una métrica sobre este «espacio de interacciones», que representa la distancia entre interacciones tanto en términos de complejidad como de cambio de energía, y demuestra que satisface las propiedades estándar de una métrica matemática (no negatividad, simetría y desigualdad triangular).

    La elegancia de esta formulación consiste en que reproduce la física conocida como casos particulares:

    • Régimen clásico (baja energía, macroscópico): la métrica se reduce a la geometría euclidiana ordinaria.
    • Régimen relativista (alta velocidad): reproduce el intervalo de espacio-tiempo de Minkowski.
    • Régimen cuántico (entrelazamiento, superposición): la métrica captura las correlaciones cuánticas mediante la entropía de entrelazamiento.

    Entrelazamiento sin acción fantasmal

    El marco dependiente de la trayectoria también ofrece una nueva interpretación del entrelazamiento cuántico, la famosa «acción fantasmal a distancia» de Einstein. En la imagen estándar, medir una partícula entrelazada parece afectar instantáneamente a su compañera, sin importar cuán lejos se encuentre. En el marco del autor, las partículas entrelazadas no se comunican a través del espacio. Comparten una historia común de interacciones. Están «cerca» en el espacio de interacciones incluso cuando están muy separadas en el espacio físico, del mismo modo que dos puntos de una hoja doblada pueden parecer distantes pero resultar adyacentes al desplegarla.

    El teorema de Bell —que demostró que ninguna teoría realista local puede reproducir todas las predicciones cuánticas— no se viola, sino que se reinterpreta: la «no localidad» es real en el espacio-tiempo emergente, pero desaparece cuando se considera el espacio de interacciones más profundo. La localidad se preserva en el nivel fundamental; solo parece quebrarse en el espacio-tiempo efectivo que observamos.

    ¿Por qué la materia busca estabilidad?

    IV

    El segundo gran argumento del artículo se refiere a la teleología: la idea de que los procesos naturales están orientados hacia fines o propósitos. Es un concepto que la ciencia moderna ha desterrado en gran medida (con algunas excepciones notables en biología). El autor sostiene que debe recuperarse, pero de una forma materialista, no mística.

    La tesis es la siguiente: los sistemas físicos tienden universalmente hacia la máxima estabilidad alcanzable dentro de sus restricciones materiales. No se trata de una fuerza externa ni de diseño inteligente. Es una propiedad inherente de la propia materia, surgida de las contradicciones internas de los sistemas materiales.

    La evidencia abarca todas las escalas de la realidad:

    • Cosmológica: Las leyes del universo parecen estar «finamente ajustadas» para la estructura y la complejidad. Los modelos cosmológicos cíclicos sugieren una tendencia a preservar leyes favorables a la estabilidad.
    • Estelar: Las estrellas consumen su combustible nuclear y luego se transforman —en enanas blancas, estrellas de neutrones o supernovas—, representando cada resultado una reorganización hacia el siguiente estado estable alcanzable.
    • Química: La transformación del grafito en diamante inducida por presión. Sistemas autocatalíticos que se reorganizan cuando se agotan los reactivos.
    • Biológica: El papel del ADN como plantilla estable de transcripción. Los equilibrios puntuados de Gould —largos períodos de estasis seguidos de cambios rápidos—. La metamorfosis de los insectos.
    • Neural: La reorganización del cerebro mediante neuroplasticidad después de una lesión o durante el aprendizaje.
    • Social: Revoluciones que ocurren cuando las estructuras de producción existentes se vuelven incompatibles con las fuerzas productivas.

    En cada caso, el patrón es el mismo: los sistemas buscan estabilidad, la alcanzan temporalmente, agotan las condiciones que la hicieron posible, atraviesan una transformación cualitativa y reanudan la búsqueda en una nueva configuración. La estabilidad es el atractor; la transformación es el mecanismo.

    Mínima acción y estados fundamentales

    El autor conecta esta perspectiva teleológica con dos pilares de la física:

    El principio de mínima acción —la regla matemática según la cual los sistemas físicos siguen trayectorias que extremizan (por lo general, minimizan) el funcional de «acción»—. Normalmente se lo trata como una herramienta de cálculo. El artículo lo reinterpreta como una ley teleológica: los sistemas seleccionan trayectorias al servicio de su tendencia hacia la estabilidad, y la trayectoria de mínima acción es la que mejor cumple ese propósito. En ocasiones, el sistema no sigue la trayectoria de energía mínima absoluta, porque ese mínimo absoluto puede no servir al objetivo más amplio de una estabilidad sostenida.

    La tendencia al estado fundamental —la inclinación natural de los sistemas cuánticos a asentarse en su configuración de menor energía—. El autor, apoyándose en el trabajo de Solovej sobre la estabilidad de la materia, sostiene que esto no es meramente un resultado mecánico, sino una expresión de la necesidad fundamental de estabilización de la materia. Los electrones no caen «accidentalmente» a niveles de energía inferiores. Son impulsados hacia ellos por la lógica interna de la realidad material.

    Idea clave

    La teleología aquí no significa propósito en el sentido humano: no hay intenciones ni inteligencia. Es la tendencia de la materia a resolver sus propias contradicciones internas buscando la configuración más estable disponible. El propósito surge de las contradicciones inherentes de la materia, no de ninguna guía externa.

    La flecha del tiempo, reconsiderada

    Con la dependencia de la trayectoria como fundamento, la flecha del tiempo se vuelve casi trivial de explicar. El tiempo fluye en una dirección porque los sistemas son históricos. El futuro no depende únicamente del estado presente, sino de toda la trayectoria que condujo hasta él. La irreversibilidad no es un accidente estadístico ni una condición de frontera cosmológica: es una característica estructural de la realidad, tan básica como la existencia de los números naturales en matemáticas.

    El autor establece una analogía con el Fondo Cósmico de Microondas (CMB), la tenue radiación remanente del universo temprano, que proporciona un «marco preferido» natural para las observaciones cósmicas sin violar la relatividad. De forma análoga, el artículo propone que una dirección temporal preferida puede emerger de la dependencia de la trayectoria sin requerir un tiempo absoluto. Cada observador puede tener su propio «tiempo propio», pero la estructura causal —la cadena de dependencias— es invariante y objetiva en todos los sistemas de referencia.

    Esto tiende un puente entre la mecánica cuántica y la relatividad general. La teoría cuántica trabaja con una noción de tiempo más cercana a la imagen clásica (absoluta), mientras que la relatividad trata el tiempo como relativo y dependiente del observador. El marco de dependencia de la trayectoria ofrece una vía para reconciliar ambas: el ordenamiento de las interacciones es fundamental e independiente del observador; la medición del tiempo es relativa.

    Predicciones comprobables

    El artículo no permanece en el terreno de la filosofía. Propone cuatro protocolos experimentales concretos:

    • Estudios de decoherencia: Preparar sistemas cuánticos idénticos, asignarles diferentes historias de interacción y medir si sus tasas de decoherencia difieren. El artículo predice que sí lo harán.
    • Análisis del entrelazamiento: Generar pares de fotones entrelazados, exponerlos a diferentes historias de interacción y comprobar si la intensidad del entrelazamiento decae exponencialmente con la «distancia de interacción», tal como predice la métrica.
    • Experimento de doble rendija modificado: Introducir historias de interacción controladas antes de que las partículas lleguen a las rendijas y buscar desviaciones dependientes de la historia en el patrón de interferencia.
    • Relojes para la emergencia del tiempo: Preparar relojes atómicos idénticos con diferentes historias de interacción y comparar sus tasas de evolución temporal.

    Son experimentos técnicamente exigentes —requieren temperaturas de milikelvin, vacío ultraalto, detección de fotón único y tomografía cuántica de alta fidelidad—, pero están al alcance de las capacidades actuales de laboratorio. Las predicciones son suficientemente específicas como para poder ser refutadas, que es exactamente lo que exige la buena ciencia.

    Por qué esto importa más allá de la física

    PARA QUIEN NO ES FÍSICO

    Si sos economista, politólogo o simplemente alguien que reflexiona sobre cómo cambian las sociedades, el marco conceptual de este artículo debería resultarte familiar y, al mismo tiempo, provocador.

    El concepto de dependencia de la trayectoria ya es central en la economía institucional (pensemos en Douglass North o en el teclado QWERTY de Paul David). La idea de que la historia importa —de que no se puede comprender el estado actual de un sistema sin saber cómo llegó hasta allí— es un elemento básico de la política comparada y la sociología histórica. Lo que hace este artículo es sostener que la dependencia de la trayectoria no es simplemente una metáfora útil tomada de la física. Es una característica fundamental de la propia realidad física.

    Del mismo modo, el concepto del artículo de teleología sin intención —sistemas que persiguen la estabilidad mediante la lógica interna de sus propias contradicciones— resuena con fuerza con la teoría marxista del materialismo histórico, en la que los modos de producción se desarrollan, agotan su potencial y atraviesan transformaciones revolucionarias. El autor establece esta conexión explícitamente, señalando que las revoluciones ocurren «cuando las relaciones de producción existentes se vuelven incompatibles con las fuerzas productivas en desarrollo».

    Y la distinción entre epistemología y ontología —entre lo que podemos modelar y lo que realmente existe— es una cuestión que todo científico social debería tomarse en serio. Cuando nuestros modelos econométricos no logran predecir una crisis financiera, ¿es la crisis un «cisne negro» (una anomalía) o es evidencia de que nuestros modelos son demasiado ahistóricos para captar la realidad?

    El problema no es que la realidad «contradiga» la teoría, sino que la teoría es una abstracción limitada de la realidad, lo que genera tensión cuando se intenta hacer que la realidad encaje en el modelo en lugar de desarrollar modelos que capten la naturaleza histórico-contextual de la realidad.
    — José Mauricio Gómez Julián

    Un puente entre mundos

    No es un artículo que vaya a convencer a todo el mundo. Su marco filosófico —el materialismo dialéctico— es poco familiar y, para algunos, está políticamente cargado. Sus propuestas matemáticas, aunque rigurosas, son exploratorias y esperan confirmación experimental. Su afirmación de que la teleología es una característica fundamental de la materia les parecerá a muchos físicos un retroceso hacia formas de pensamiento premodernas.

    Pero eso es precisamente lo que hace que valga la pena leerlo. En un panorama donde la física teórica se ha fragmentado entre la teoría de cuerdas, la gravedad cuántica de bucles y diversas interpretaciones de la mecánica cuántica que reproducen los mismos resultados experimentales, un artículo que pregunta «¿Y si estamos partiendo de supuestos equivocados?» es exactamente el tipo de provocación que la ciencia necesita.

    La contribución más profunda del artículo quizá sea metodológica: demostrar que la filosofía y la física pueden informarse mutuamente sin que ninguna colonice a la otra. El marco filosófico aporta la claridad conceptual necesaria para formular mejores preguntas. La física aporta la disciplina experimental necesaria para comprobar si esas preguntas tienen respuestas reales.

    Sobrevivan o no sus propuestas específicas al escrutinio experimental, el artículo logra algo más modesto, pero no menos importante: hace que veamos el huevo roto de otra manera. No como un problema que debe explicarse hasta hacerlo desaparecer, sino como evidencia de un universo que recuerda y que, al recordar, avanza irreversiblemente.

    Artículo original: “A Dialectical Materialist Analysis on Path Dependence, Irreversibility and Teleology in Physical Systems”, de José Mauricio Gómez Julián, Universidad de Costa Rica.

    Disponible como preprint: OSF Preprints

    Esta entrada es un resumen explicativo y no representa las opiniones del autor ni de ninguna institución. Cualquier error de interpretación es responsabilidad exclusiva del autor del blog.