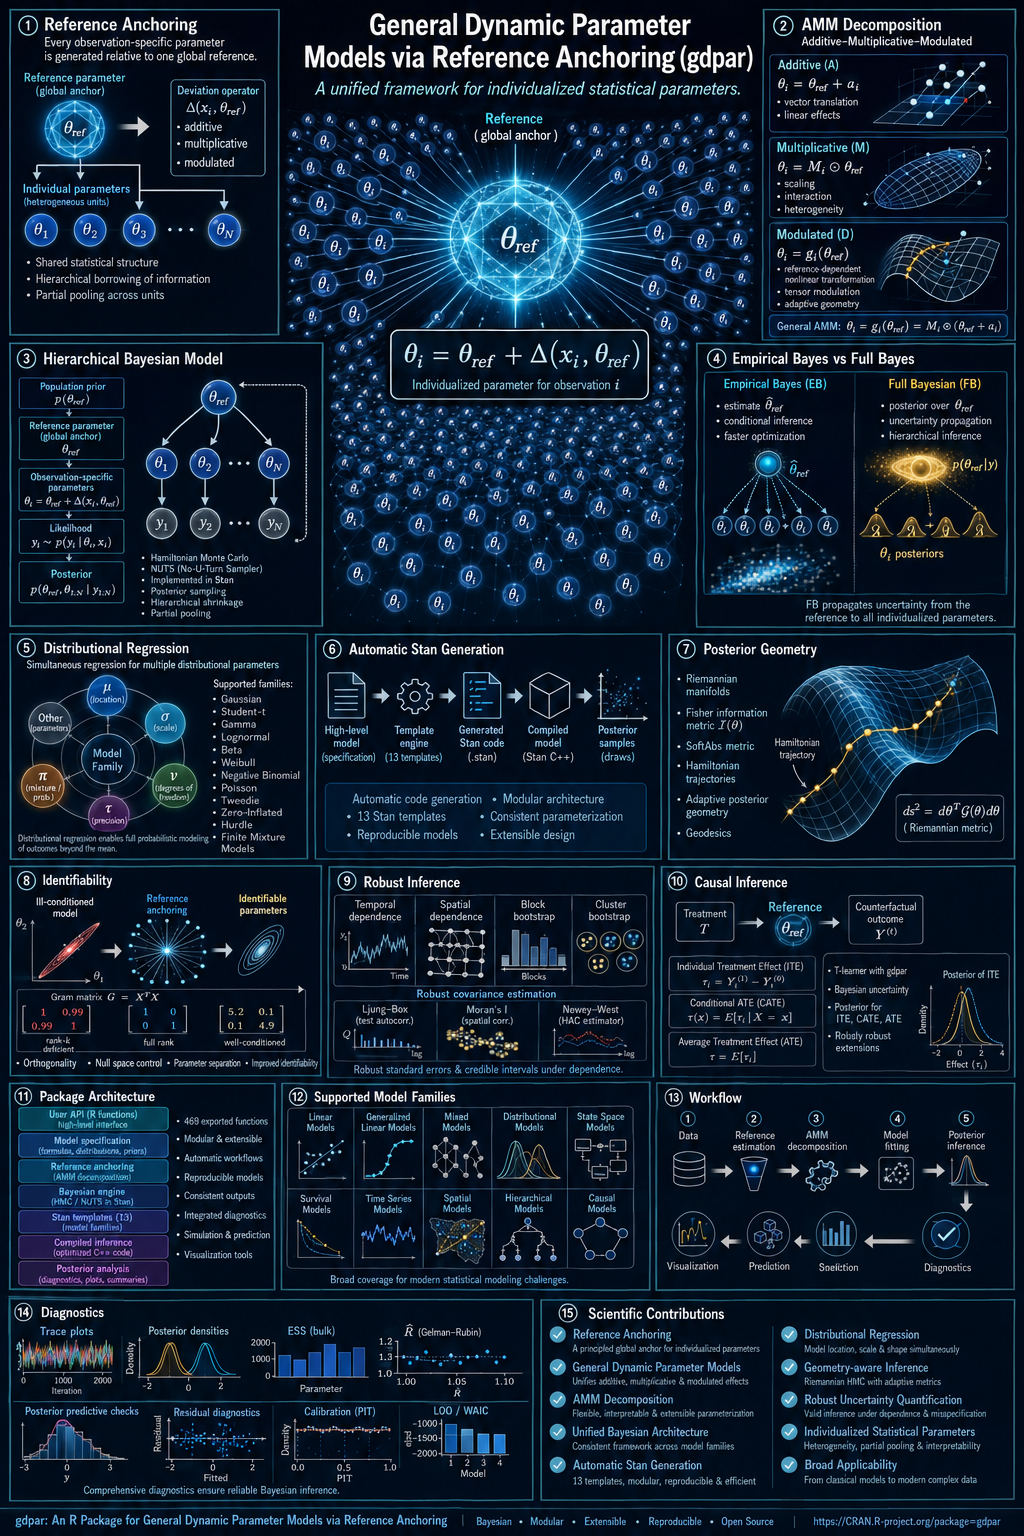
Pueden encontrar esta librería y su documentación en CRAN y descargargla directamente desde R y RStudio.
Además, también les recomendamos echarle un ojo al mapa mental resumen al final de este artículo para entender mejor la relación entre las funciones del paquete.
ESCUCHA ESTA PUBLICACIÓN COMO PODCAST
Conoce gdpar
En el cálculo fugaz de una decisión de dos segundos —adelantar un automóvil en una carretera estrecha— el cerebro humano realiza un notable truco estadístico. No construye desde cero un modelo del conductor que se aproxima. En su lugar, recupera una referencia de base: el conductor promedio, que representa tiempos de reacción típicos y un nivel modal de agresividad. En una fracción de segundo, interpreta las señales específicas del conductor real —velocidad relativa, tipo de vehículo, micromovimientos— y estima en qué medida este conductor específico se desvía de la referencia. La decisión de adelantar surge de esa síntesis.
Esta receta cognitiva —referencia poblacional + desviación individual— constituye el fundamento filosófico del paquete de R gdpar (General Dynamic Parameter models via Reference Anchoring) de José Mauricio Gómez Julián. El paquete toma esta intuición, la formaliza como una descomposición estadística rigurosa, demuestra las condiciones bajo las cuales es matemáticamente identificable, proporciona un motor bayesiano basado en Stan para estimarla y añade capas de inferencia causal, muestreo adaptativo a la geometría e inferencia robusta frente a la dependencia.
La anatomía de la desviación
Cada capa de gdpar constituye una elaboración de una única y elegante ecuación. Para cada observación $i$ con covariables $x_i$:
Se lee así: el parámetro del individuo $i$ es igual a una referencia poblacional, más una desviación que es, a su vez, función de las covariables del individuo y de la propia referencia.
Es en esa última cláusula donde la arquitectura se aparta de la estadística clásica. La desviación $\Delta$ no depende únicamente de quién sos (tus covariables $x_i$); depende de cuál es la referencia. Si trasladás el modelo a una nueva población, la función de desviación se comporta de manera diferente porque $\theta_{\text{ref}}$ es uno de sus argumentos. Esta dependencia estructural es la característica definitoria del «anclaje de referencia». Distingue a gdpar de los modelos de efectos aleatorios o de coeficientes variables, en los cuales la desviación está estructuralmente separada de la referencia.
Entonces, ¿qué forma tiene $\Delta$? El paquete distingue una forma funcional específica denominada descomposición Aditiva–Multiplicativa–Modulada (AMM):
Tres mecanismos, claramente separados e interpretables de forma independiente:
- $a(x)$ — Un desplazamiento puramente aditivo. Puede pensarse como un efecto fijo tradicional determinado por covariables.
- $b(x)\odot\theta_{\text{ref}}$ — Un escalamiento de la referencia dependiente de las covariables (mediante el producto de Hadamard o producto elemento a elemento). Aquí es donde «la desviación depende de la referencia» entra de manera multiplicativa.
- $W(\theta_{\text{ref}})\,x$ — Las covariables se combinan mediante una matriz $W$ que, a su vez, está ajustada por la referencia. Este es el canal explícito y estructuralmente dependiente de la referencia.
Los modelos estándar aparecen como casos particulares. Si se establece $\Delta \equiv 0$, se obtiene una regresión de efectos fijos. Si se establece $W \equiv 0$, se obtiene un modelo jerárquico con interacción multiplicativa. Si se establece $b \equiv 0$, se obtiene un modelo de coeficientes variables. La AMM es la familia natural mínima que contiene los tres casos y eleva la referencia al papel de argumento activo de la desviación.
Los tres motores de estimación
gdpar define tres motores complementarios para estimar $\Delta$. De manera crucial, solo uno es ejecutable en la versión actual: una decisión deliberada de plantear un alcance matemático que excede la superficie ejecutable y de declararlo con transparencia.
| Ruta | Motor | Representación | Estado |
|---|---|---|---|
| Ruta 1 | Bayesiano jerárquico (Stan) | AMM paramétrica | ✅ Operativa |
| Ruta 2 | Coeficientes variables (splines) | $\beta(z)$ suave | 🚧 Conceptual |
| Ruta 3 | Hiperrred / Red neuronal | La red genera $\theta_i$ | 🚧 Conceptual |
Las rutas 2 y 3 están documentadas con calidad de referencia —la Wiki desarrolla la teoría asintótica completa (tasas de contracción, Bernstein–von Mises)—, pero si se invocan terminan con gdpar_unsupported_feature_error. La Ruta 1 asigna distribuciones a priori a cada componente ($\theta_{\text{ref}}, a, b, W$) y muestrea la distribución posterior conjunta mediante HMC, produciendo de forma nativa incertidumbre basada en la posterior completa.
Historia de dos posteriores: EB frente a FB
Dentro de la Ruta 1, gdpar ofrece dos regímenes inferenciales. Bayes completo (FB), mediante gdpar(), muestrea la posterior conjunta y se mantiene como la opción más fiel a la analogía cognitiva. Bayes empírico (EB), mediante gdpar_eb(), estima los hiperparámetros maximizando una verosimilitud marginal mediante una aproximación de Laplace y, posteriormente, muestrea los parámetros restantes de manera condicional.
El comparador EB frente a FB
En lugar de imponer una elección, gdpar los trata como rutas paralelas. Incluye un comparador específico, gdpar_compare_eb_fb(), que cuantifica el grado de concordancia en $\theta_{\text{ref}}$ y en el vector de parámetros reducido $\xi$. La Wiki desarrolla la teoría con profundidad de primer nivel: las posteriores de nivel inferior de EB y FB coinciden asintóticamente (Teorema 7A), mientras que los intervalos EB presentan una cobertura insuficiente de orden $O(n^{-1})$ (Proposición 7B). Si alguna vez te has preguntado si EB es «suficientemente bueno» para tus datos, gdpar permite responderlo empíricamente.
Regresión distribucional: cada parámetro es una ranura
gdpar no está restringido a modelar la media. Una distribución de probabilidad posee múltiples parámetros —localización, escala, forma, índice de cola, probabilidad de inflación de ceros— y cada uno de ellos puede tener su propia descomposición AMM. El paquete los indexa mediante $k = 1, \dots, K$:
El repertorio incorporado abarca las familias gaussiana, Poisson, binomial negativa, Bernoulli, Beta, Gamma, Student-$t$, Tweedie, ZIP, ZINB y hurdle. Los modelos inflados en cero y hurdle reciben un tratamiento especialmente elegante: tanto la probabilidad de inflación de ceros $\pi_i$ como el parámetro de conteo $\theta_i$ quedan anclados a sus respectivas referencias, conformando un diseño de desviación dual.
El puente causal
Dado que la forma AMM produce parámetros individuales, los efectos individuales del tratamiento surgen de manera natural. gdpar_causal_bridge() implementa un T-learner: ajusta el modelo anclado por separado bajo tratamiento y control y, posteriormente, obtiene el efecto promedio condicional del tratamiento (CATE) en $x_i$ como la diferencia entre las predicciones individuales ancladas:
Una segunda capa, gdpar_compare_meta_learners(), compara el learner basado en AMM con meta-learners externos mediante adaptadores conectables: grf::causal_forest del lado de R y CausalForestDML de EconML del lado de Python (mediante reticulate). Las afirmaciones causales del marco se someten a comparación empírica; no se dan simplemente por sentadas.
Mecánica y engranajes
Varias decisiones de ingeniería elevan a gdpar de ejercicio teórico a entorno computacional serio:
- Generador de código Stan: Compone programas a partir de piezas canónicas —bloques AMM para $p=1$ y $p \geq 1$, bloques marginales/condicionales EB y bloques distribucionales-$K$— seleccionadas según la configuración resuelta $(K, p, \text{family}, W, \text{parametrization}, \text{group})$. La base de $W$ admite B-splines con evaluación Cox–de Boor del lado de Stan, garantizando diferenciabilidad dentro de HMC.
- Verificación previa de identificabilidad: Antes de cualquier muestreo,
gdpar_check_identifiability()ejecuta una comprobación de la matriz de Gram (Proposición 1C), una comprobación por coordenada entre componentes (C4-bis) para $p > 1$ y una comprobación anti-aliasing por grupo (C7). Si tu diseño no es identificable, lo sabrás antes de que el muestreador consuma tiempo de CPU, acompañado de ungdpar_identifiability_errorestructurado que identifica las direcciones dependientes. - Reparametrización guiada por los datos: Trata la parametrización de $b(x) \odot \theta_{\text{ref}}$ como una decisión previa al ajuste. Un breve piloto calcula una razón de información y deriva el problema hacia CP, NCP o —la solución de
gdpardirigida a la causa raíz— una reparametrización lineal que muestrea directamente el producto $\theta_{\text{ref}} \cdot b$, evitando por completo los embudos bilineales.
Herramientas avanzadas de activación opcional
Dos capacidades avanzadas están desactivadas por defecto y documentadas con el mismo nivel de detalle que la ruta principal.
1. Muestreo adaptativo a la geometría
Las posteriores AMM jerárquicas pueden presentar geometrías particularmente hostiles —embudos, cuasi-determinismo, colas pesadas—. El motor geométrico, de activación opcional, asciende por una jerarquía de métricas riemannianas: Euclidiana → Fisher/SoftAbs → subriemanniana → relativista/Finsler. Un orquestador certificador diagnostica la patología, selecciona una métrica, ajusta el integrador y emite un certificado. Si se certifica que el muestreo completo es inviable, un mecanismo alternativo de Laplace proporciona una posterior plug-in con un ELPD comparable al de mgcv-REML o INLA-Laplace.
2. Inferencia robusta frente a la dependencia
gdpar no modela la dependencia temporal o espacial dentro de su estructura puntual; en su lugar, hace que la inferencia sea robusta frente a la dependencia (un enfoque de independencia de trabajo + varianza sándwich, en el espíritu de Liang & Zeger, 1986). Se obtienen diagnósticos (Durbin–Watson, Ljung–Box, $I$ de Moran) y errores estándar robustos mediante bootstrap por bloques: bloques móviles o circulares en el tiempo (con longitud automática de bloque flat-top de Politis–White) y bloques espaciales en mosaico con origen aleatorizado. Las estimaciones puntuales permanecen intactas; únicamente la incertidumbre se vuelve más honesta.
⚠️ Limitaciones declaradas con transparencia
La Wiki es admirablemente explícita respecto del alcance. Solo la Ruta 1 es ejecutable en la versión 0.1.0. La dependencia no se modela: únicamente se hace robusta la inferencia frente a ella. El alcance matemático del paquete excede su superficie ejecutable por diseño. Conviene leer cuidadosamente las notas de «Estado de implementación» antes de depender de una determinada funcionalidad.
En resumen
gdpar toma una de las ideas más naturales de la predicción humana —predecir a un individuo como una desviación respecto de una referencia poblacional, donde la propia desviación depende de esa referencia— y la transforma en un marco de regresión bayesiana plenamente especificado, con comprobación de identificabilidad y respaldado por Stan. Es teóricamente riguroso, computacionalmente serio y excepcionalmente transparente respecto de lo que hace y de lo que todavía no hace. Si tu trabajo involucra heterogeneidad individual, regresión distribucional o estimación de efectos causales con incertidumbre fundamentada, gdpar merece una mirada detenida.
Leave a Comment/Deja un Comentario