
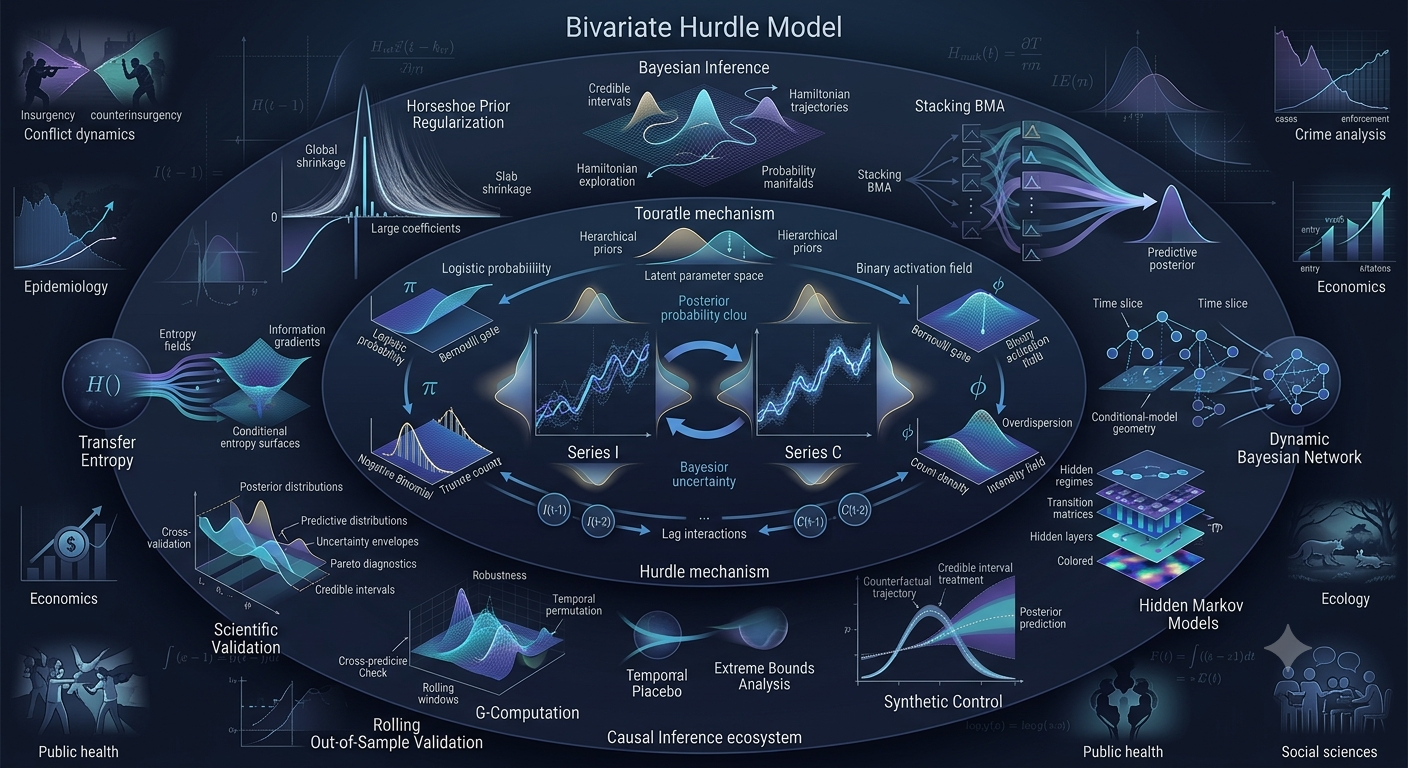
También puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.
ESCUCHA ESTE POST COMO PODCAST
Cuando dos series tienen demasiados ceros: una introducción a bivarhr
Un paquete de R que combina modelos hurdle bivariados, regularización horseshoe, comparación predictiva y múltiples estrategias de inferencia causal para uno de esos problemas que parecen sencillos hasta que uno intenta analizarlos de verdad.
Imaginemos que queremos estudiar dos procesos que evolucionan juntos en el tiempo. Podrían ser ataques insurgentes y operaciones contrainsurgentes, casos de una enfermedad y muertes asociadas, protestas y respuestas del gobierno, entradas y salidas de empresas o cualquier otro par de fenómenos registrados como conteos.
Hasta aquí nada parece especialmente extraño. Tenemos series temporales, tenemos conteos y tenemos una considerable caja de herramientas estadística. El problema comienza cuando los datos se parecen más al mundo real que a los ejemplos de un manual.
Puede ocurrir que durante la mayor parte del tiempo no suceda absolutamente nada: cero ataques, cero protestas, cero extinciones, cero nuevos casos. Después, cuando finalmente ocurre algo, el número observado puede variar enormemente. A eso se suma otra dificultad: las dos series pueden influenciarse predictivamente entre sí con rezagos, mientras docenas de variables adicionales compiten por entrar en el modelo.
bivarhr fue diseñado precisamente para trabajar en ese cruce de problemas.
En lugar de tratar por separado el exceso de ceros, la dinámica entre ambas series, la selección de variables, la incertidumbre sobre el modelo y la evidencia causal, bivarhr intenta integrarlos dentro de un único flujo de análisis reproducible.
Primero: ¿por qué tantos ceros son un problema?
Un modelo de Poisson convencional presupone una estructura relativamente simple para los conteos. La distribución binomial negativa permite mayor dispersión y suele funcionar mejor cuando la variabilidad excede lo que admitiría un Poisson.
Pero ninguna de esas decisiones resuelve automáticamente un conjunto de datos en el que, por ejemplo, el 60 %, 70 % u 80 % de las observaciones son exactamente cero.
Un modelo hurdle aborda el problema dividiéndolo conceptualmente en dos mecanismos.
- Primero pregunta si el proceso logra cruzar el “obstáculo”: ¿ocurrió algo o el resultado fue cero?
- Solamente después, condicionando a que ocurrió algo, pregunta: ¿cuánto ocurrió?
La primera parte puede modelarse mediante una distribución Bernoulli con
enlace logit. La segunda, en bivarhr, mediante una binomial
negativa truncada en cero.
Formalmente, para una de las series \(I\) en el instante \(t\):
mientras que, para un conteo positivo,
Aquí, \(\pi_{I,t}\) representa la probabilidad de observar un valor distinto de cero, \(\mu_{I,t}\) controla el conteo esperado una vez superado el hurdle y \(\phi_I\) gobierna la dispersión.
Esta separación es importante. El proceso que determina si sucede algo no tiene por qué ser el mismo que determina la intensidad de lo que sucede.
¿Y qué aporta que el modelo sea bivariado?
Supongamos que llamamos \(I\) y \(C\) a nuestras dos series. Analizarlas por separado perdería precisamente una de las preguntas más interesantes: ¿contiene el pasado de una información útil para predecir el futuro de la otra?
bivarhr permite introducir valores rezagados de
\(C\) en la ecuación correspondiente a \(I\), valores rezagados de
\(I\) en la de \(C\), ambas cosas simultáneamente o ninguna.
| Especificación | C → I | I → C | Lectura |
|---|---|---|---|
| A | Sí | No | C contiene información predictiva rezagada sobre I |
| B | No | Sí | I contiene información predictiva rezagada sobre C |
| C | Sí | Sí | Dinámica predictiva bidireccional |
| D | No | No | Sin efectos cruzados rezagados |
Esta comparación permite estudiar causalidad en el sentido de Granger: si conocer el pasado de una variable mejora sistemáticamente la predicción de otra una vez considerada la información pertinente.
La causalidad de Granger es una afirmación sobre
precedencia e información predictiva. No equivale, por sí
sola, a demostrar una relación causal estructural. Precisamente por eso
bivarhr no termina el análisis en los rezagos cruzados:
incorpora otras herramientas que permiten contrastar la misma hipótesis
desde ángulos diferentes.
Muchos predictores, pocos datos: el papel del horseshoe
Imaginemos ahora que, además de ambas series, disponemos de indicadores económicos, variables institucionales, condiciones climáticas, tendencias, cambios de régimen y distintas transformaciones de cada una.
El número de parámetros puede crecer rápidamente. Con una muestra relativamente pequeña, un modelo suficientemente flexible puede terminar aprendiendo ruido.
Para enfrentarse a este problema, bivarhr utiliza la
prior horseshoe regularizada.
La intuición es sencilla aunque su formulación matemática sea más rica: los coeficientes que no encuentran suficiente respaldo en los datos son fuertemente contraídos hacia cero, mientras que las señales verdaderamente importantes pueden escapar de esa contracción.
El mecanismo combina un parámetro global de contracción, \(\tau\), que controla el nivel general de esparsidad, con parámetros locales \(\lambda_j\), capaces de adaptarse a cada coeficiente. La versión regularizada empleada por el paquete sigue el enfoque de Piironen y Vehtari y limita además comportamientos excesivamente extremos de los coeficientes.
En términos prácticos, esto significa que el investigador no necesita convertir la selección manual de variables en una sucesión interminable de decisiones ad hoc.
El problema que viene después: ¿qué modelo elegimos?
Incluso después de definir la estructura general, queda una decisión incómoda. ¿Cuántos rezagos deberíamos utilizar? ¿Uno? ¿Dos? ¿Tres? ¿Qué grado de regularización es apropiado?
La respuesta habitual consiste en escoger el modelo que obtiene el mejor valor de algún criterio y descartar los demás.
bivarhr sigue otra filosofía. Combina modelos mediante
predictive stacking, asignándoles pesos según su capacidad
predictiva.
Los pesos se estiman buscando maximizar la densidad logarítmica predictiva esperada —ELPD—, evaluada mediante PSIS-LOO. En términos menos técnicos: los modelos que predicen mejor reciben más influencia y los que predicen peor reciben menos.
El resultado evita hacer depender toda la inferencia de una única decisión sobre el número exacto de rezagos o sobre un solo conjunto de hiperparámetros.
De la predicción a la causalidad: buscar evidencia convergente
Probablemente éste sea el aspecto más ambicioso del paquete.
bivarhr no propone que un único procedimiento estadístico
resuelva automáticamente el problema de la causalidad. En su lugar,
proporciona varias herramientas complementarias.
Entropía de transferencia
Pregunta cuánto reduce el pasado de una serie nuestra incertidumbre acerca de la otra, más allá de la información contenida en su propio pasado. A diferencia del Granger lineal tradicional, procede desde la teoría de la información.
Redes Bayesianas Dinámicas
Buscan aprender relaciones dirigidas entre variables situadas en distintos momentos, permitiendo distinguir conexiones directas de estructuras mediadas por otras variables.
Modelos Ocultos de Markov
Permiten investigar si ambas series parecen estar gobernadas por estados latentes, como períodos de calma, transición o escalada que no fueron etiquetados previamente.
VARX
Aporta una comprobación desde la tradición clásica de series temporales, incluyendo diagnósticos de estabilidad, autocorrelación, normalidad y efectos ARCH.
Análisis de sensibilidad
Siguiendo a Cinelli y Hazlett, cuantifica cuán potente tendría que ser un confusor no observado para explicar un efecto estimado.
Control sintético
Mediante series temporales estructurales bayesianas puede construir un escenario contrafactual y comparar lo observado con lo que habría ocurrido en ausencia de una intervención.
Ninguno de estos métodos convierte mágicamente una asociación en causalidad. Su utilidad reside en otra cosa: permiten preguntar si una conclusión sobrevive cuando el mismo problema se examina mediante representaciones y supuestos diferentes.
Un resultado no vale mucho si desaparece al tocar el modelo
Una parte importante de bivarhr está dedicada no a producir
resultados nuevos, sino a intentar destruir los resultados que ya
obtuvimos.
Ésa es una virtud.
Placebos temporales
Si se altera aleatoriamente el orden temporal de los datos y el modelo continúa funcionando igual de bien, existe un problema: quizá no estaba aprendiendo realmente la dinámica temporal.
Evaluación fuera de muestra
El paquete permite ajustar modelos en fracciones sucesivas de la muestra y evaluar sus pronósticos sobre las observaciones restantes. En lugar de preguntar solamente qué tan bien describe el modelo los datos conocidos, preguntamos qué tan bien funciona cuando tiene que enfrentarse a datos que no utilizó para estimarse.
Análisis de límites extremos
También puede reestimarse el modelo bajo distintas combinaciones de controles. Si un resultado fundamental cambia de signo o desaparece cada vez que modificamos ligeramente la especificación, tenemos razones para desconfiar de su robustez.
G-computation
Finalmente, la simulación posterior permite construir cantidades contrafactuales del tipo: ¿cómo cambiaría \(I\) si elimináramos determinados rezagos cruzados o variables de transición? Así es posible expresar los resultados en términos de efectos promedio del tratamiento bajo la especificación causal adoptada.
¿En qué campos puede resultar útil?
El paquete nació alrededor de un problema estadístico, no de una disciplina particular. Por eso su campo potencial de aplicación es amplio.
| Campo | Ejemplos de pares de procesos |
|---|---|
| Salud pública | Casos y mortalidad; hospitalizaciones y reingresos; vacunación y brotes. |
| Criminología | Delitos y respuestas policiales; incautaciones y sobredosis. |
| Economía | Entradas y salidas de empresas; patentes y citas; determinados conteos asociados a flujos comerciales. |
| Ecología | Depredadores y presas; aparición y desaparición de especies; colonización y extinción local. |
| Ciencia política | Protestas y respuestas gubernamentales; iniciativas legislativas y vetos. |
| Entornos digitales | Publicaciones de desinformación y actividad posterior de verificación. |
¿Qué ocurre bajo el capó?
Aunque el objetivo del paquete es ofrecer un flujo integrado, la infraestructura estadística es plenamente bayesiana allí donde se ajusta el modelo hurdle principal.
| Componente | Implementación |
|---|---|
| Muestreo | Stan NUTS mediante cmdstanr |
| Regularización | Horseshoe regularizado |
| Evaluación predictiva | PSIS-LOO y ELPD |
| Combinación de modelos | Pesos de predictive stacking |
| Convergencia | \(\hat{R}\), ESS y divergencias |
| Diagnóstico LOO | Valores de Pareto \(k\) |
El código Stan tampoco constituye una caja negra: puede inspeccionarse
mediante get_hurdle_model(), mientras que las cantidades
generadas permiten obtener log-verosimilitudes por observación,
predicciones posteriores y valores ajustados.
Empezar a utilizar bivarhr
El paquete puede instalarse desde GitHub, mientras que también dispone de distribución a través de CRAN.
# Instalación desde GitHub
devtools::install_github("isadorenabi/bivarhr")

# Instalar cmdstanr
install.packages(
  "cmdstanr",
  repos = c(
    "https://stan-dev.r-universe.dev",
    getOption("repos")
  )
)

cmdstanr::install_cmdstan()

# Paquetes opcionales para el conjunto completo
# de herramientas causales
install.packages(c(
  "RTransferEntropy",
  "bnlearn",
  "sensemakr",
  "CausalImpact",
  "vars",
  "openxlsx"
))
Un ajuste mínimo con dos rezagos y efectos cruzados en ambas direcciones puede escribirse de forma compacta:
fit <- fit_one(
  DT,
  k = 2,
  spec = "C",
  iter_warmup = 500,
  iter_sampling = 500,
  chains = 2
)

print(fit$fit$summary())
Si queremos comparar múltiples órdenes de rezago y configuraciones de la prior horseshoe, podemos construir una cuadrícula y dejar que el procedimiento de selección y stacking evalúe el conjunto:
hs_grid <- expand.grid(
  hs_tau0 = c(0.1, 0.5, 1.0),
  hs_slab_scale = c(1, 5),
  hs_slab_df = 4
)

bma_results <- select_by_bma(
  DT = DT,
  spec = "C",
  k_grid = 0:3,
  hs_grid = hs_grid,
  iter_warmup = 1000,
  iter_sampling = 1200,
  chains = 4,
  use_parallel = TRUE
)

print(bma_results$table)
El punto más interesante no es un modelo: es el flujo de trabajo
Es fácil describir bivarhr enumerando sus piezas: binomial
negativa hurdle, horseshoe, Stan, PSIS-LOO, stacking, entropía de
transferencia, redes bayesianas, modelos de Markov, VARX y análisis
contrafactual.
Pero hacer solamente esa lista oculta lo más interesante del proyecto.
Prácticamente ninguno de esos métodos existe únicamente dentro de
bivarhr. Lo particular es su intento de reunirlos alrededor de
una secuencia coherente de preguntas.
¿Los ceros forman parte central del proceso? Entonces hay que modelarlos explícitamente. ¿Las dos variables evolucionan conjuntamente? Entonces no conviene estimarlas como mundos separados. ¿Hay demasiados predictores? Regularicemos. ¿No sabemos qué especificación elegir? Incorporémoslo a la incertidumbre predictiva. ¿Queremos hablar de causalidad? No dependamos de una única evidencia. ¿Encontramos un efecto? Intentemos romperlo con placebos, cambios de especificación y evaluación fuera de muestra.
bivarhr es software de código abierto distribuido bajo licencia MIT. Disponible en CRAN y GitHub. Autor: José Mauricio Gómez Julián · ORCID.
Leave a Comment/Deja un Comentario