Marxist Philosophy of Science · Métodos cuantitativos
Construcción e Interpretación del Coeficiente Silueta en k-medias
Cohesión, separación y elección del número de grupos: fundamentos, cálculos y diagnóstico reproducible.
Publicación original:
Revisión:
La calidad de un agrupamiento no se comprende contando sus grupos. Se examina comparando las relaciones que acercan cada observación a su grupo y las que la vinculan con otras alternativas. La silueta convierte esa comparación en una medida interpretable, siempre que se expliciten su construcción y sus límites.
01. Qué se valida al formar grupos
Agrupar observaciones y justificar los grupos son tareas diferentes. Un algoritmo puede devolver una partición incluso cuando los datos no contienen agrupamientos útiles para la pregunta de investigación. Por eso conviene distinguir el resultado computacional, el criterio geométrico utilizado para evaluarlo y la interpretación del fenómeno estudiado.
El coeficiente silueta, introducido por Rousseeuw (1987), examina la relación entre la proximidad de una observación a su grupo y su proximidad a una alternativa. Ofrece un diagnóstico de la partición bajo las disimilitudes elegidas; no establece por sí solo que los grupos representen clases naturales.
| Enfoque | Pregunta | Ejemplo |
|---|---|---|
| Validación interna | ¿Qué estructura presenta la partición según los datos y las disimilitudes? | Silueta; índices de Calinski–Harabasz o Davies–Bouldin. |
| Validación externa | ¿Cómo se relaciona la partición con una clasificación de referencia independiente? | Índice de Rand ajustado cuando existen etiquetas comparables. |
| Comparación relativa | ¿Qué solución resulta preferible entre alternativas definidas? | Comparar la silueta para diferentes valores de k. |
Estas perspectivas pueden combinarse: una medida interna puede usarse para comparar soluciones. Las etiquetas externas tampoco constituyen automáticamente la verdad del fenómeno, ni conocerlas implica que el número de grupos geométricos deba coincidir con el número de clases.
02. Qué optimiza k-medias
Sean x1, …, xn vectores numéricos y C1, …, Ck una partición en grupos no vacíos. En k-medias estándar, cada centro μg es la media aritmética de las observaciones asignadas a su grupo. El objetivo es reducir la suma de cuadrados interna:
Los algoritmos usuales pueden terminar en óptimos locales. Las inicializaciones múltiples reducen la dependencia de una sola elección inicial, pero no ofrecen una garantía universal de óptimo global. En R, nstart permite intentar varios conjuntos iniciales de centros (Hartigan & Wong, 1979; R Documentation, s. f.-b).
Conviene separar los centroides aprendidos de las decisiones de configuración: k, la estrategia de inicialización, el número de intentos y el límite de iteraciones. La semilla controla la reproducibilidad de la aleatoriedad; no es una propiedad sustantiva de los datos.
La geometría euclidiana forma parte del k-medias estándar. Si se necesita otra disimilitud, hay que justificar un procedimiento compatible, por ejemplo k-medoides para determinadas matrices de disimilitud. Cambiar la distancia al evaluar una partición es posible, pero cambia la pregunta diagnóstica y debe declararse.
03. Construcción del coeficiente silueta
Fijemos una partición y una disimilitud d(i, j), no negativa, simétrica y nula en la diagonal. La construcción clásica usa disimilitudes entre pares; no requiere sustituir cada grupo por su centroide. Aquí se emplea la distancia euclidiana, que en una dimensión es la diferencia absoluta.
1. Disimilitud interna promedio: a(i)
Si C(i) es el grupo de la observación i y contiene al menos dos observaciones, se promedian sus disimilitudes con los demás integrantes. Se excluye la distancia de i consigo misma:
2. Disimilitud hacia cada grupo alternativo
Para cada grupo C que no contiene a i, calculamos un promedio independiente:
3. Elección del grupo vecino: b(i)
El menor de esos promedios define b(i). Primero se promedia dentro de cada grupo alternativo y después se toma el mínimo:
El grupo vecino depende de la observación i. No se obtiene necesariamente buscando el punto ajeno más cercano, el centroide más próximo ni el grupo más cercano al conjunto C(i). Si varios grupos empatan en el promedio mínimo, b(i) queda definido aunque la etiqueta del vecino pueda no ser única.
4. Normalización
La resta expresa la ventaja de la pertenencia actual frente a la alternativa; el denominador hace comparables los valores en una escala acotada. Para denominador positivo, una forma equivalente aclara el signo:
| Condición | Expresión equivalente | Lectura |
|---|---|---|
| a(i) < b(i) | s(i) = 1 − a(i)/b(i) | Mayor proximidad promedio al propio grupo. |
| a(i) = b(i) > 0 | s(i) = 0 | Igual disimilitud promedio hacia ambas opciones. |
| a(i) > b(i) | s(i) = b(i)/a(i) − 1 | Mayor proximidad promedio al grupo alternativo. |
La formulación y la convención para grupos unitarios corresponden a la silueta clásica implementada en cluster::silhouette() (R Documentation, s. f.-a).
Multiplicar todas las disimilitudes por una constante positiva deja s(i) inalterado: el mismo factor se cancela entre numerador y denominador. Escalar cada variable de manera diferente puede modificar tanto la partición como su evaluación.
04. Ejemplo manual: de las distancias al resultado
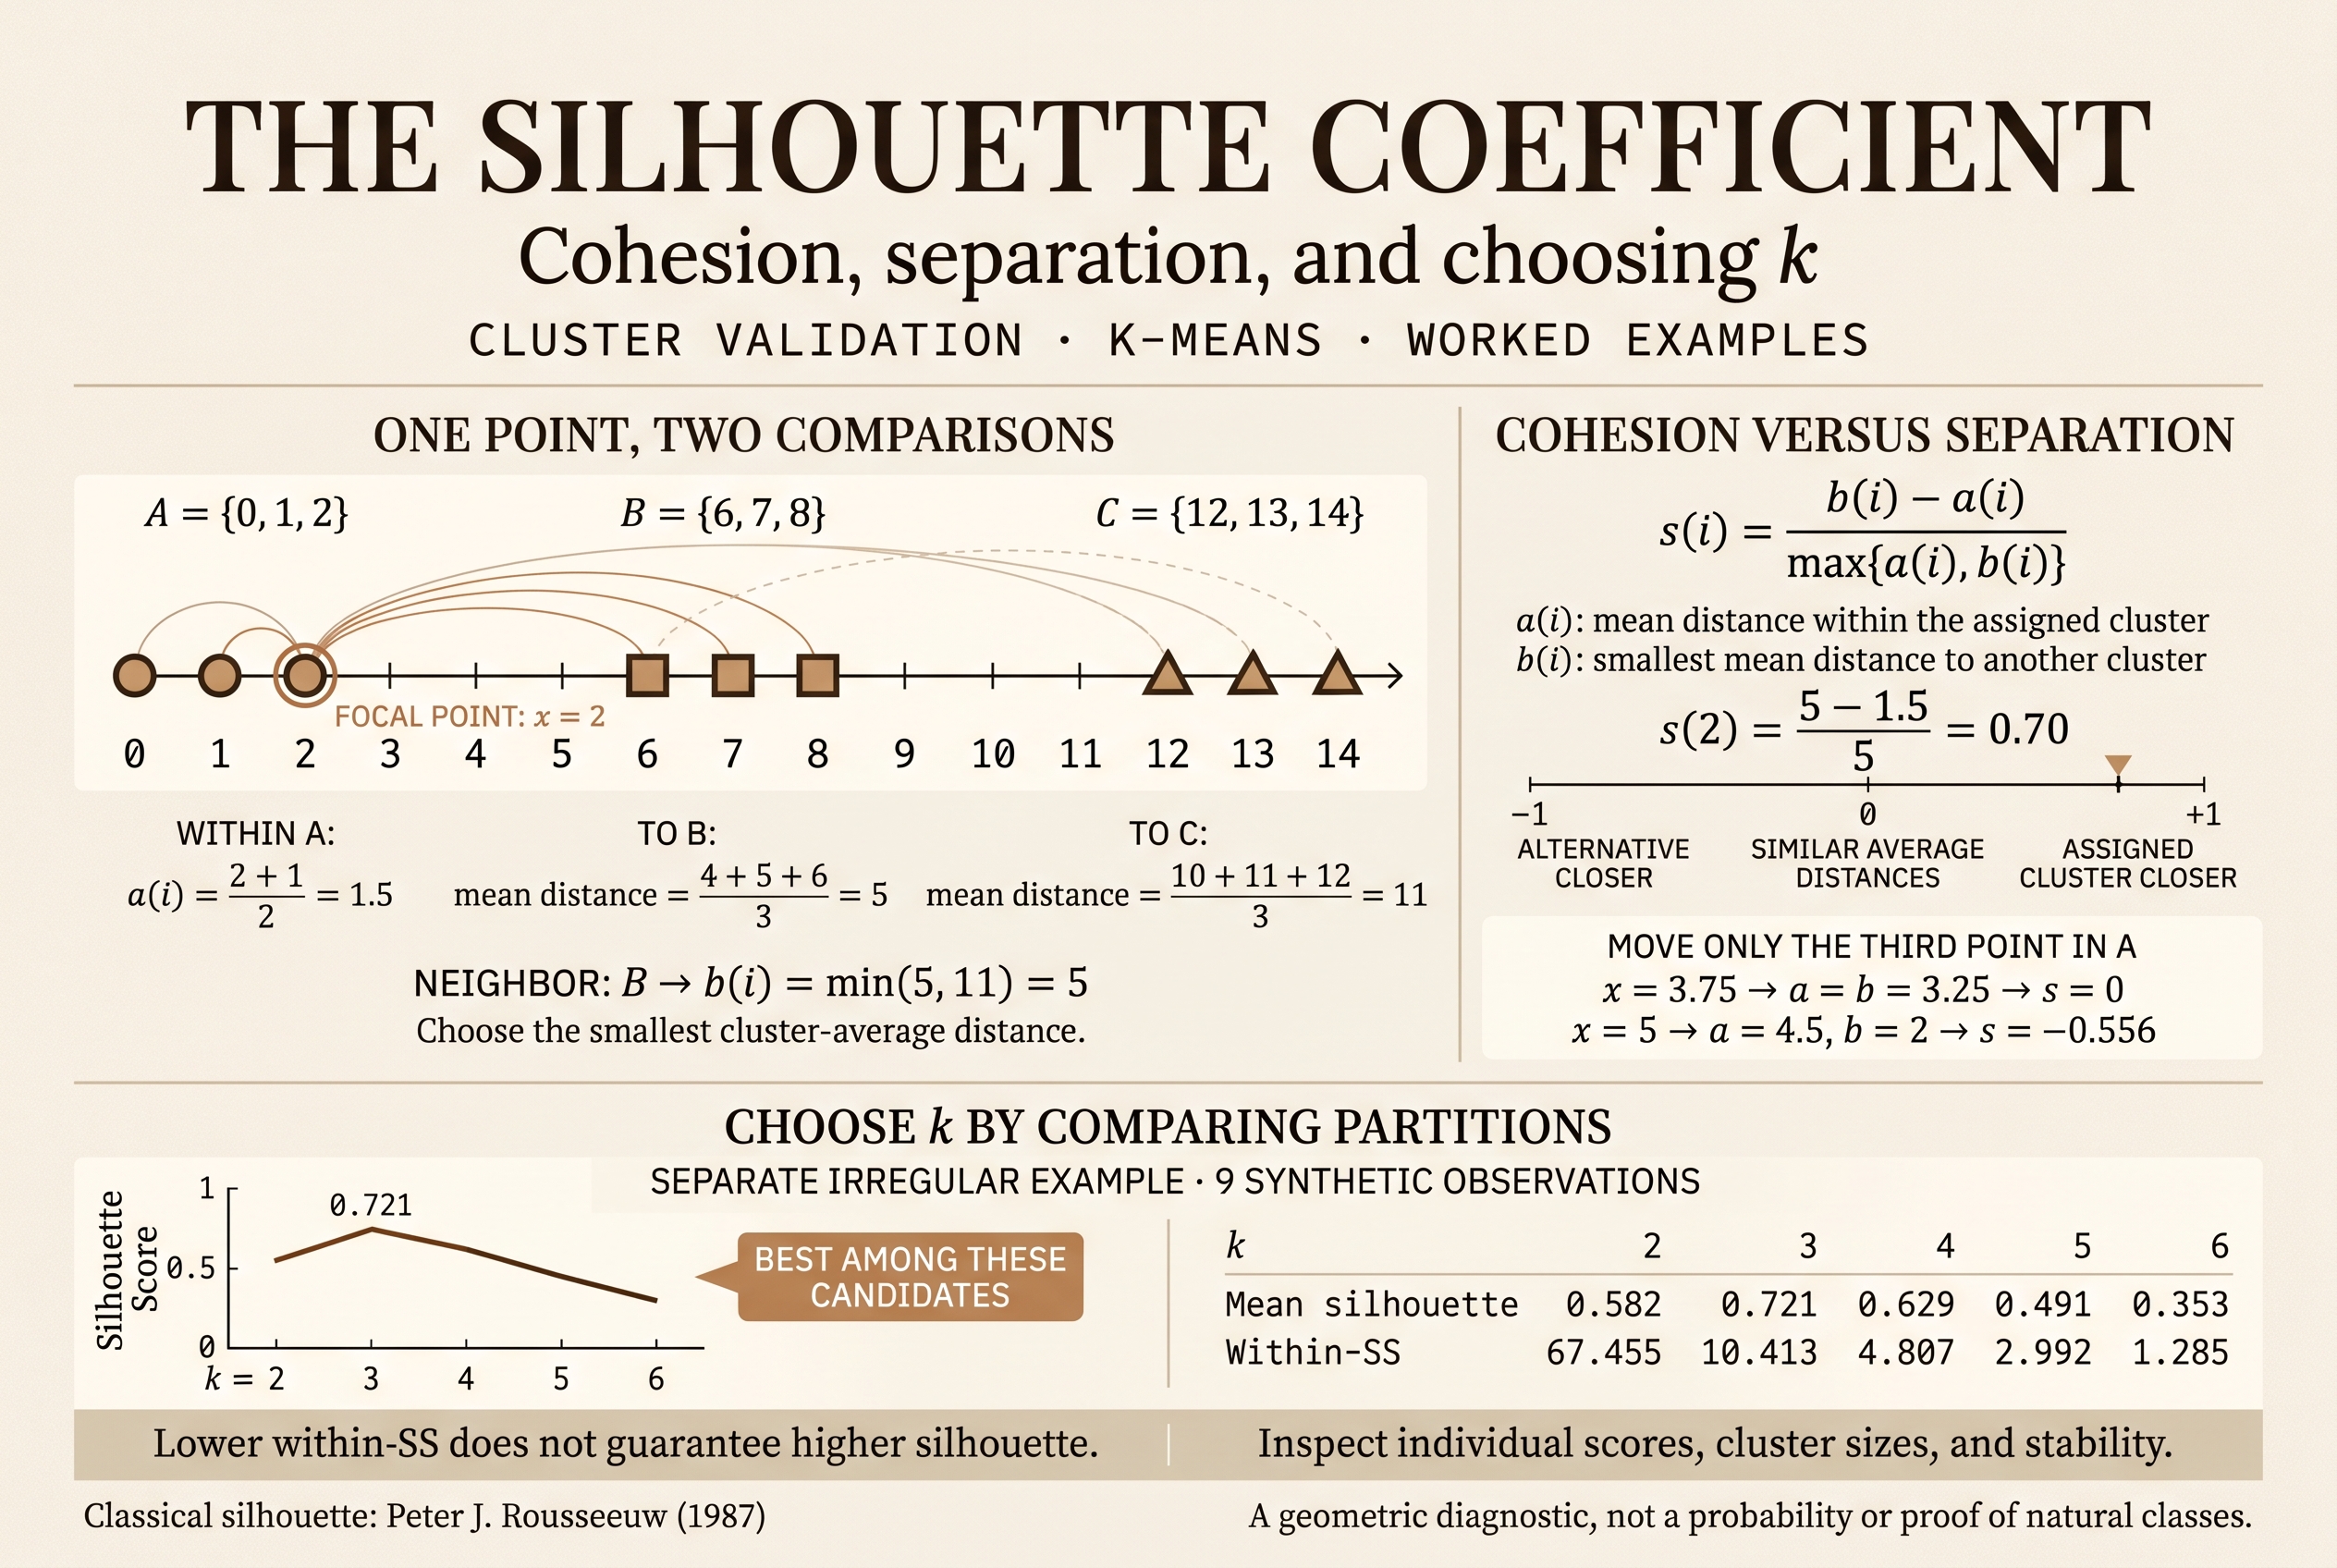
Consideremos nueve observaciones unidimensionales y una partición fijada para el cálculo: A = {0, 1, 2}, B = {6, 7, 8} y C = {12, 13, 14}. Estos números son datos sintéticos, sin significado empírico atribuido. Usamos d(i, j) = |xi − xj|.
Para x = 2, el grupo propio es A. Todas las distancias relevantes aparecen en la tabla:
| Destino | Observaciones | Distancias desde x = 2 | Promedio |
|---|---|---|---|
| A, sin el propio punto | 0, 1 | 2, 1 | a(i) = (2 + 1)/2 = 1.5 |
| B | 6, 7, 8 | 4, 5, 6 | d̄(i, B) = 15/3 = 5 |
| C | 12, 13, 14 | 10, 11, 12 | d̄(i, C) = 33/3 = 11 |
La observación tiene menor disimilitud promedio hacia su propio grupo que hacia B, su alternativa más próxima. El valor 0.70 expresa esa relación normalizada; no es una probabilidad de pertenencia ni una exactitud del 70 %.
Cómo aparecen el cero y los valores negativos
Ahora cambiemos solo el tercer punto de A: A = {0, 1, t}. B y C conservan sus valores. Cada fila siguiente corresponde a un conjunto modificado distinto, manteniendo las etiquetas fijadas:
| t | a(t) | b(t) | s(t) |
|---|---|---|---|
| 2 | 1.5 | 5 | 0.700000 |
| 3.75 | 3.25 | 3.25 | 0.000000 |
| 5 | 4.5 | 2 | −0.555556 |
En t = 3.75, las dos disimilitudes promedio relevantes son iguales. En t = 5, B es más próximo en promedio que A. Estos casos ilustran el diagnóstico de una partición dada; no se presentan como resultados de volver a ajustar k-medias.
05. Interpretación individual, por grupo y global
Un s(i) próximo a 1 indica cohesión relativa alta respecto del vecino; cerca de cero, las disimilitudes promedio son parecidas; un valor negativo señala que la alternativa es más próxima en promedio. Son lecturas condicionadas por los datos, las variables y la disimilitud elegida.
Una silueta negativa invita a revisar una observación. No demuestra por sí sola un error de programación ni obliga a reasignarla: el objetivo de k-medias y el criterio de la silueta son distintos. Tampoco establece que esa observación sea un valor atípico.
La media global pondera cada grupo por su tamaño. Promediar las medias grupales sin ponderación responde a otra pregunta y coincide con la media global solo en casos particulares, como grupos de igual tamaño.
| x | Grupo | a(i) | b(i) | s(i) |
|---|---|---|---|---|
| 0 | A | 1.5 | 7.0 | 0.785714 |
| 1 | A | 1.0 | 6.0 | 0.833333 |
| 2 | A | 1.5 | 5.0 | 0.700000 |
| 6 | B | 1.5 | 5.0 | 0.700000 |
| 7 | B | 1.0 | 6.0 | 0.833333 |
| 8 | B | 1.5 | 5.0 | 0.700000 |
| 12 | C | 1.5 | 5.0 | 0.700000 |
| 13 | C | 1.0 | 6.0 | 0.833333 |
| 14 | C | 1.5 | 7.0 | 0.785714 |
Las medias son s̄A = 0.773016, s̄B = 0.744444 y s̄C = 0.773016. Como los grupos tienen tres observaciones, s̄ = 481/630 ≈ 0.763492.
La lectura gráfica debe atender a la longitud de las barras, la presencia de negativos, el tamaño de cada grupo y las diferencias entre grupos. El gráfico ayuda a examinar la distribución que una sola media resume (Rousseeuw, 1987).
06. Comparar k sin convertir el máximo en una verdad
Para un conjunto de valores candidatos K, puede seleccionarse la partición con mayor silueta media:
La selección es relativa a K, a los datos, al preprocesamiento y al procedimiento de ajuste. No confirma que exista una estructura de grupos, ni resuelve la opción k = 1. Si varias soluciones tienen resultados próximos, conviene conservarlas para el examen gráfico y sustantivo.
Para evitar los empates simétricos del ejemplo manual, usemos ahora otro conjunto sintético: {0, 0.8, 2, 6, 7.3, 8, 12, 13.2, 15.5}. Todos los valores están en una misma unidad. La tabla corresponde a soluciones que minimizan W(k) en este pequeño problema unidimensional; el código incluye una comprobación exhaustiva entre particiones contiguas.
| k | W(k) | Silueta media | Tamaño mínimo | Grupos unitarios |
|---|---|---|---|---|
| 2 | 67.455000 | 0.582098 | 3 | 0 |
| 3 | 10.413333 | 0.721211 | 3 | 0 |
| 4 | 4.806667 | 0.628661 | 1 | 1 |
| 5 | 2.991667 | 0.491256 | 1 | 2 |
| 6 | 1.285000 | 0.353364 | 1 | 3 |
Para k = 3, los grupos son {0, 0.8, 2}, {6, 7.3, 8} y {12, 13.2, 15.5}. Aquí la reducción de W(k) obtenida al dividir aún más los datos no se acompaña de mayor silueta. Los grupos unitarios de las soluciones posteriores contribuyen con silueta cero por convención.
| Criterio | Qué examina | Cómo usarlo |
|---|---|---|
| Codo de W(k) | Ganancia marginal al aumentar el número de centroides. | Buscar cambios de pendiente; el quiebre puede ser ambiguo. |
| Silueta | Cohesión relativa frente al mejor grupo alternativo. | Comparar medias y distribuciones por grupo. |
| Sensibilidad a la inicialización | Variación del resultado al cambiar las semillas. | Repetir ajustes completos, manteniendo el preprocesamiento. |
| Estabilidad muestral e interpretación | Persistencia y relevancia de los grupos para el problema. | Examinar remuestreo, perfiles y conocimiento del dominio. |
Estos criterios aportan evidencia complementaria. La sensibilidad a la semilla y la estabilidad frente a cambios en la muestra son propiedades diferentes: repetir semillas no estima incertidumbre muestral.
07. Aplicación reproducible y auditada en R
El siguiente script contiene los datos, una implementación independiente de la fórmula, las verificaciones del ejemplo manual, el ajuste con múltiples inicializaciones y la comparación de k = 2, …, 6. Para cada k, kmeans() conserva el mejor ajuste según su suma de cuadrados, no según la silueta (R Documentation, s. f.-b).
El código verifica también la suma de cuadrados mínima por enumeración en este caso unidimensional pequeño. Esa auditoría aprovecha n = 9 y la estructura de la recta; no debe extrapolarse como estrategia eficiente a problemas multivariados grandes. Las etiquetas numéricas de los grupos pueden permutarse sin cambiar la partición.
# Coeficiente silueta: ejemplos resueltos y comparación de k-medias
# Artículo original: 2022-04-21 | Revisión: 2026-11-11
# Dependencia: install.packages("cluster") si el paquete no está instalado.
if (!requireNamespace("cluster", quietly = TRUE)) {
  stop('Install the cluster package first: install.packages("cluster")')
}

# Cálculo independiente desde una matriz completa de disimilitudes.
silhouette_manual <- function(labels, D) {
  D <- as.matrix(D)
  n <- length(labels)
  stopifnot(n >= 3L, !anyNA(labels), is.numeric(D),
            all(dim(D) == c(n, n)), all(is.finite(D)),
            all(D >= 0), max(abs(D - t(D))) < 1e-10,
            max(abs(diag(D))) < 1e-10)
  groups <- unique(labels)
  stopifnot(length(groups) >= 2L, length(groups) <= n - 1L)
  s <- numeric(n)
  for (i in seq_len(n)) {
    own <- which(labels == labels[i])
    if (length(own) == 1L) {
      s[i] <- 0
      next
    }
    a <- mean(D[i, setdiff(own, i)])
    other <- groups[groups != labels[i]]
    means <- vapply(other, function(g) mean(D[i, labels == g]), numeric(1))
    b <- min(means)
    s[i] <- if (max(a, b) == 0) 0 else (b - a) / max(a, b)
  }
  s
}

# 1. Ejemplo manual exacto; distancias como diferencias absolutas.
x_hand <- matrix(c(0, 1, 2, 6, 7, 8, 12, 13, 14), ncol = 1)
labels_hand <- rep(1:3, each = 3)
D_hand <- dist(x_hand, method = "euclidean")
s_hand <- cluster::silhouette(labels_hand, D_hand)
stopifnot(max(abs(silhouette_manual(labels_hand, D_hand) -
                  s_hand[, "sil_width"])) < 1e-12,
          abs(s_hand[3, "sil_width"] - 0.7) < 1e-12,
          abs(mean(s_hand[, "sil_width"]) - 481 / 630) < 1e-12)
print(data.frame(x = x_hand[, 1], cluster = labels_hand,
                 silhouette = round(s_hand[, "sil_width"], 6)))

# Mover solo el tercer punto genera los casos positivo, cero y negativo.
for (t in c(2, 3.75, 5)) {
  xt <- x_hand
  xt[3, 1] <- t
  actual <- cluster::silhouette(labels_hand, dist(xt))[3, "sil_width"]
  a <- mean(abs(t - c(0, 1)))
  b <- min(mean(abs(t - c(6, 7, 8))), mean(abs(t - c(12, 13, 14))))
  expected <- (b - a) / max(a, b)
  stopifnot(abs(actual - expected) < 1e-12)
  cat(sprintf("t = %.2f; a = %.2f; b = %.2f; s = %.6f\n", t, a, b, actual))
}

# Compruebe las convenciones para grupos unitarios, coincidencias y denominador cero.
for (case in list(
  list(x = c(0, 1, 10), labels = c(1L, 1L, 2L)),
  list(x = c(0, 0, 0, 0), labels = c(1L, 1L, 2L, 2L)),
  list(x = c(0, 0, 10, 10), labels = c(1L, 1L, 2L, 2L))
)) {
  dd <- dist(matrix(case$x, ncol = 1))
  reference <- cluster::silhouette(case$labels, dd)[, "sil_width"]
  stopifnot(all(is.finite(reference)),
            max(abs(silhouette_manual(case$labels, dd) - reference)) < 1e-12)
}

# 2. Datos sintéticos irregulares: evitan los empates del ejemplo manual.
x <- matrix(c(0, 0.8, 2, 6, 7.3, 8, 12, 13.2, 15.5), ncol = 1,
            dimnames = list(paste0("P", 1:9), "x"))
stopifnot(is.numeric(x), all(is.finite(x)), nrow(unique(x)) >= 6L)
# Todas las observaciones usan una unidad común; aquí no se requiere escalar.
# En datos multivariados, justifique la selección de variables y el escalamiento.
# x <- scale(x)  # Opcional; no estandarice columnas constantes.
D <- dist(x, method = "euclidean")
ks <- 2:6
models <- vector("list", length(ks))
silhouettes <- vector("list", length(ks))
rows <- vector("list", length(ks))
for (j in seq_along(ks)) {
  k <- ks[j]
  set.seed(20220421L + k)
  fit <- kmeans(x, centers = k, nstart = 100, iter.max = 100,
                algorithm = "Hartigan-Wong")
  if (!is.null(fit$ifault) && fit$ifault != 0L) stop("k-means did not converge")
  s <- cluster::silhouette(fit$cluster, D)
  stopifnot(max(abs(silhouette_manual(fit$cluster, D) -
                    s[, "sil_width"])) < 1e-12)
  models[[j]] <- fit
  silhouettes[[j]] <- s
  rows[[j]] <- data.frame(k = k, within_ss = fit$tot.withinss,
                          mean_silhouette = mean(s[, "sil_width"]),
                          negative_fraction = mean(s[, "sil_width"] < 0),
                          smallest_cluster = min(fit$size),
                          singleton_clusters = sum(fit$size == 1L))
}
results <- do.call(rbind, rows)
print(results, digits = 7, row.names = FALSE)
best <- which.max(results$mean_silhouette)
cat("Selected k among the candidates:", results$k[best], "\n")
print(summary(silhouettes[[best]]))

# Auditoría del ejemplo UNIDIMENSIONAL frente a todas las particiones contiguas.
# Esto es viable porque n = 9; no es un procedimiento general para datos grandes.
# En k-medias unidimensional ordenado existe un óptimo global contiguo.
x_sorted <- sort(x[, 1])
exact_sse <- vapply(ks, function(k) {
  cuts <- combn(seq_len(length(x_sorted) - 1L), k - 1L)
  min(apply(cuts, 2, function(cut) {
    starts <- c(1L, cut + 1L)
    ends <- c(cut, length(x_sorted))
    sum(vapply(seq_len(k), function(g) {
      z <- x_sorted[starts[g]:ends[g]]
      sum((z - mean(z))^2)
    }, numeric(1)))
  }))
}, numeric(1))
stopifnot(max(abs(results$within_ss - exact_sse)) < 1e-10,
          results$k[best] == 3L,
          abs(results$mean_silhouette[best] - 0.7212109713028838) < 1e-12)

# 3. Repita todo el procedimiento con semillas diferentes.
# Estos rangos describen sensibilidad a la inicialización, no incertidumbre muestral.
seeds <- 1:20
stability <- do.call(rbind, lapply(ks, function(k) {
  means <- vapply(seeds, function(seed) {
    set.seed(seed)
    fit <- kmeans(x, centers = k, nstart = 100, iter.max = 100)
    mean(cluster::silhouette(fit$cluster, D)[, "sil_width"])
  }, numeric(1))
  data.frame(k = k, minimum = min(means), median = median(means),
             maximum = max(means))
}))
print(stability, digits = 7, row.names = FALSE)

# 4. Exporte el análisis al directorio de trabajo actual.
write.csv(results, "silhouette_k_comparison.csv", row.names = FALSE)
write.csv(stability, "silhouette_initialization_sensitivity.csv", row.names = FALSE)
write.csv(data.frame(id = rownames(x), x = x[, 1],
                     cluster = models[[best]]$cluster,
                     silhouette = silhouettes[[best]][, "sil_width"]),
          "silhouette_individual_results.csv", row.names = FALSE)
paper <- "#fffdf7"
ink <- "#2c2418"
copper <- "#8b4513"
pdf("silhouette_diagnostics.pdf", width = 7, height = 6, bg = paper)
par(col = ink, col.axis = ink, col.lab = ink, col.main = ink,
    fg = ink, bg = paper)
plot(results$k, results$mean_silhouette, type = "b", pch = 19,
     col = copper, xlab = "Number of clusters (k)",
     ylab = "Mean silhouette", ylim = c(0, 1))
plot(silhouettes[[best]], col = copper, border = NA,
     main = paste("Silhouette | k =", results$k[best]))
abline(v = results$mean_silhouette[best], lty = 2, col = ink)
plot(results$k, results$within_ss, type = "b", pch = 19,
     col = copper, xlab = "Number of clusters (k)",
     ylab = "Within-cluster sum of squares")
dev.off()
writeLines(capture.output(sessionInfo()), "silhouette_session_info.txt")
Además de las tablas mostradas, el script escribe tres archivos CSV, un PDF con los gráficos diagnósticos y un archivo de información de sesión. Los archivos se crean en el directorio de trabajo de R. La repetición de veinte semillas describe sensibilidad a la inicialización en este ejemplo; no constituye un intervalo de confianza.
08. Limitaciones y decisiones que deben declararse
La silueta suele favorecer grupos convexos y separados bajo la geometría utilizada. Una estructura alargada, encadenada o definida por densidad puede recibir una evaluación poco favorable aunque sea relevante para el problema. Por eso la comparación entre algoritmos necesita una interpretación común de qué constituye un grupo (scikit-learn developers, s. f.).
- Variables y escalas. Las unidades y ponderaciones modifican las disimilitudes. Estandarizar supone una decisión analítica; no es una corrección automática válida para todo problema.
- Atípicos y tamaños desiguales. Examine cómo influyen en promedios y grupos pequeños. Reporte medias por grupo, tamaños y observaciones problemáticas junto con la media global.
- Alta dimensión. Evalúe si las distancias elegidas conservan contrastes útiles. Una proyección para visualizar no sustituye la geometría con la que se ajustó y evaluó el modelo.
- Candidatos y comparabilidad. Mantenga las mismas observaciones y la misma disimilitud para una comparación directa; documente cuando cambien.
- Costo computacional. Una matriz completa de distancias requiere memoria de orden n². Un muestreo puede abaratar el diagnóstico, pero hay que explicar si los promedios se calculan solo dentro de la submuestra o contra todos los datos.
- Ausencia de estructura. Compare con escenarios de referencia apropiados o examine estabilidad antes de atribuir significado a un máximo. Una partición siempre disponible no equivale a una estructura empírica confirmada.
Si se usan remuestreos, deben describirse la selección de observaciones, el nuevo ajuste y la comparación entre particiones. Las etiquetas son arbitrarias: comparar directamente sus números no mide estabilidad.
09. Nota matemática: geometría de grupos y topología
La revisión conserva la inquietud matemática del texto de Nabi (2022), pero precisa el vocabulario. La semejanza entre términos no autoriza a identificar sus definiciones.
| En agrupamiento | En topología o álgebra | Distinción necesaria |
|---|---|---|
| Cohesión o compacidad geométrica | Compacidad: todo cubrimiento abierto admite un subcubrimiento finito. | Todos los conjuntos finitos son compactos, incluso si sus puntos están muy alejados. |
| Separación entre grupos | Separabilidad: existencia de un subconjunto denso numerable. | No cuantifica la distancia entre grupos; ℝᵖ es separable con su topología usual. |
| Conectividad de vecindarios | Conexidad: imposibilidad de una separación en abiertos relativos disjuntos no vacíos. | Un grafo de vecinos y la topología del conjunto de observaciones son construcciones distintas. |
| Subconjunto de observaciones | Subespacio vectorial: contiene el cero y es cerrado bajo suma y multiplicación escalar. | Un grupo arbitrario de datos no satisface necesariamente estas condiciones. |
Dos ejemplos hacen visible la diferencia. {0, 1} y {0, 1000} son compactos como subconjuntos de ℝ, aunque sus diámetros sean 1 y 1000. Además, cualquier conjunto finito de puntos distintos de ℝᵖ tiene topología relativa discreta: una bola suficientemente pequeña aísla cada punto. Si contiene más de uno, es disconexo, aunque visualmente forme una nube muy apretada.
Para un subconjunto C de un espacio topológico, la separación relevante sería C = U ∪ V, con U y V abiertos en la topología relativa de C, no vacíos y disjuntos: U ∩ V = ∅. La unión recompone C; la intersección registra los elementos compartidos. C es conexo cuando tal separación no existe.
Una bola abierta euclidiana contiene los puntos cuya distancia al centro es menor que su radio; la esfera reúne los que están exactamente a esa distancia. Ninguna de estas definiciones convierte por sí misma un grupo estadístico en una región conexa.
Estas distinciones se apoyan en definiciones de espacios métricos y compacidad ({cite(‘lebl’,’Lebl, s. f.’)}). Para introducir conexiones rigurosas con topología, habría que definir expresamente un grafo, una unión de bolas o una estructura adicional y estudiar sus propiedades.
10. Cómo comunicar el resultado
Un reporte útil identifica los datos y variables, el preprocesamiento, el algoritmo y sus opciones, la disimilitud usada en la evaluación, los valores candidatos de k y la sensibilidad del resultado. Debe acompañar la media global con tamaños y resultados por grupo.
En nueve observaciones sintéticas unidimensionales, se compararon k = 2, …, 6 mediante k-medias y distancia euclidiana. La mayor silueta media entre los candidatos fue 0.721211 para k = 3. La elección se interpretó junto con la suma de cuadrados, los tamaños de los grupos y los diagnósticos individuales.
La conclusión expresa qué evidencia favorece la solución elegida y bajo qué condiciones. Su utilidad final depende de que los grupos ayuden a responder la pregunta de investigación.
11. Referencias
- Hartigan, J. A., & Wong, M. A. (1979). Algorithm AS 136: A k-means clustering algorithm. Journal of the Royal Statistical Society. Series C (Applied Statistics), 28(1), 100–108. https://doi.org/10.2307/2346830
- Lebl, J. (s. f.). Basic analysis: Introduction to real analysis (Vol. II). Recuperado el 11 de noviembre de 2026, de https://www.jirka.org/ra/
- Nabi, I. (2022). Construcción e interpretación del coeficiente silueta en agrupamientos por k-medias. Marxist Philosophy of Science. https://marxistphilosophyofscience.com/wp-content/uploads/2022/04/construccion-e-interpretacion-del-coeficiente-silueta-en-agrupamientos-por-k-medias-isadore-nabi-1.pdf
- R Documentation. (s. f.-a). Compute or extract silhouette information from clustering [Documentación de software]. Recuperado el 11 de noviembre de 2026, de https://stat.ethz.ch/R-manual/R-patched/library/cluster/html/silhouette.html
- R Documentation. (s. f.-b). K-means clustering [Documentación de software]. Recuperado el 11 de noviembre de 2026, de https://stat.ethz.ch/R-manual/R-patched/library/stats/html/kmeans.html
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7
- scikit-learn developers. (s. f.). Clustering [Documentación de software]. Recuperado el 11 de noviembre de 2026, de https://scikit-learn.org/stable/modules/clustering.html
Leave a Comment/Deja un Comentario