
Matemática · Programación en R · Sistemas dinámicos discretos
La conjetura de Collatz como función personalizada en R
Una introducción a funciones, iteración y recursión a partir de una regla matemática extraordinariamente sencilla cuyo comportamiento global continúa resistiéndose a una demostración general.
Un ejemplo particularmente agradable de función personalizada es una función construida para estudiar computacionalmente la célebre conjetura de Collatz. La elección resulta útil porque la regla matemática es muy sencilla, mientras que su comportamiento global no lo es: basta con distinguir entre números pares e impares y repetir siempre la misma transformación. Esa combinación permite concentrarse en la lógica de programación sin perder de vista el objeto matemático que se está programando.
La conjetura establece, en términos elementales, que si se parte de cualquier entero positivo y se divide entre dos cuando el número es par, o bien se multiplica por tres y se le suma uno cuando es impar, la sucesión obtenida llegará finalmente a la unidad. Es importante formularlo con cuidado: un programa puede comprobar que esto ocurre para un valor inicial concreto —o para una colección finita de valores—, pero esa comprobación computacional no constituye por sí misma una demostración de que ocurra para todos los enteros positivos. Precisamente ahí reside el problema matemático.
1. La regla de Collatz y qué significa comprobarla
Matemáticamente, la regla que genera las sucesivas imágenes puede expresarse mediante la siguiente función definida a trozos:
| Condición | Operación | Nueva imagen |
|---|---|---|
| n es par | Dividir entre 2 | T(n) = n/2 |
| n es impar | Multiplicar por 3 y sumar 1 | T(n) = 3n + 1 |
Tabla 1. La regla local de Collatz. Cada paso está completamente determinado por la paridad del estado presente.
Si se parte de un origen o valor semilla n0, la aplicación sucesiva de la función construye una órbita:
Esta notación permite introducir desde el inicio una distinción que después será importante en R. Si la órbita alcanza la unidad por primera vez tras k aplicaciones de la regla, entonces se han realizado k iteraciones o transiciones, pero el listado completo de estados contiene k + 1 valores, porque también se cuenta el valor inicial.
Puede llamarse tiempo total de parada al número de aplicaciones de T necesarias para alcanzar 1. Si se denota por τ(n), entonces la conjetura puede escribirse, de manera compacta, como: τ(n) < ∞ para todo entero positivo n.
Por consiguiente, lo que se programará a continuación no es una “prueba” de la conjetura en el sentido matemático de una demostración universal. Será, en cambio, un mecanismo capaz de generar y examinar órbitas particulares, registrar sus estados y contar cuántas transformaciones fueron necesarias para llegar a 1 cuando efectivamente se llegue a ese valor.
2. Una primera función personalizada en R
Para construir la regla anterior en R conviene recordar que una función personalizada permite tomar una entrada, someterla a determinadas instrucciones y devolver una salida. En este primer paso todavía no habrá iteración: únicamente se evaluará un número y se producirá su siguiente imagen de Collatz.
La condición fundamental es la paridad. En R, el operador %% devuelve el residuo de una división. Si n %% 2 == 0, el número es divisible entre dos y, por consiguiente, es par. Si el residuo es distinto de cero, es impar.
R · regla de un pasoFuncionDeCollatz <- function(n) {
  if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
    stop("n debe ser un entero positivo.")
  }

  if (n %% 2 == 0) {
    j <- n / 2
  } else {
    j <- 3 * n + 1
  }

  return(j)
}
La función recibe un entero positivo n, determina si es par o impar y guarda el resultado en j. La instrucción return(j) no significa, estrictamente, “imprimir j en la pantalla”; significa que j será el valor devuelto por la función. Cuando la función se ejecuta directamente en la consola interactiva de R, ese valor devuelto suele mostrarse automáticamente, lo que explica por qué ambas ideas pueden confundirse al comenzar a programar.
return(x) termina la función y entrega x como su resultado. print(x), en cambio, pide explícitamente que x sea impreso. Una función puede devolver un valor sin contener ninguna instrucción print().
Obsérvese también que no hace falta impedir que esta función sea evaluada en 1: según la regla estándar, 1 es impar y su siguiente imagen sería 4. Lo que hará el algoritmo que construiremos después será detener la órbita al alcanzar 1, es decir, no volverá a aplicar la regla una vez alcanzado el objetivo.
3. Del paso individual al algoritmo iterativo
La función anterior realiza solamente una transformación. Para obtener una órbita completa es necesario repetirla mientras el valor presente sea diferente de 1. Aquí aparece el bucle del tipo “mientras” —while-loop—, cuya lógica es exactamente la que su nombre indica: ejecutar un determinado bloque de instrucciones durante el tiempo en que una condición siga siendo verdadera.
Esta segunda función es, por tanto, iterativa. No es todavía recursiva, porque no se llama a sí misma; lo que hace es repetir explícitamente un bloque de código mediante while().
R · algoritmo iterativoAlgoritmoIterativoDeCollatz <- function(m, max_iter = 1000000L) {
  if (length(m) != 1L || !is.finite(m) || m < 1 || m != floor(m)) {
    stop("m debe ser un entero positivo.")
  }

  trayectoria <- m
  iteraciones <- 0L

  while (m != 1) {
    if (iteraciones >= max_iter) {
      stop("Se alcanzó max_iter antes de llegar a 1.")
    }

    m <- FuncionDeCollatz(m)
    trayectoria <- c(trayectoria, m)
    iteraciones <- iteraciones + 1L
  }

  return(trayectoria)
}
La lógica es sencilla. El vector trayectoria nace dentro de la propia función y contiene inicialmente el valor semilla. Después, cada vez que se ejecuta el bucle, m se reemplaza por su siguiente imagen y ese nuevo valor se agrega al final del vector. Cuando m llega a 1, la condición m != 1 deja de cumplirse y el bucle termina.
Se utiliza aquí la letra m simplemente para distinguir visualmente el argumento de esta segunda función del n empleado en la primera. No existe una necesidad sintáctica de hacerlo: los argumentos y objetos creados dentro de cada función poseen su propio ámbito local, por lo que dos funciones distintas pueden utilizar sin conflicto un argumento llamado n.
Definir el vector dentro de la función tiene una ventaja importante: cada ejecución conserva su propio estado y no depende de objetos previamente existentes en el entorno global de R. En otras palabras, si se ejecuta la función una vez con 27 y después con 8, la segunda órbita no hereda los valores de la primera.
El argumento max_iter no forma parte de la Matemática de Collatz; es una precaución computacional. Como el enunciado general que se desea demostrar no puede simplemente asumirse al escribir el programa, resulta prudente impedir que un bucle pueda continuar sin límite en caso de que se use con datos inesperados o con una implementación modificada.
| Objeto | Tipo | Papel |
|---|---|---|
| FuncionDeCollatz | function | Calcula una sola imagen de la regla de Collatz. |
| AlgoritmoIterativoDeCollatz | function | Repite la regla con while() y construye la trayectoria completa hasta 1. |
| trayectoria | numeric vector | Existe localmente durante una ejecución y almacena los estados visitados. |
Tabla 2. Equivalente conceptual de lo que se observaría en el entorno de R tras definir las funciones. El vector de trayectoria no necesita permanecer en el entorno global.
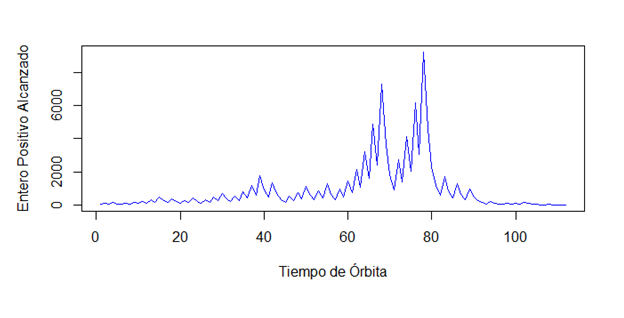
4. La órbita de 27: 112 estados y 111 iteraciones
Puede evaluarse ahora un número cualquiera en el algoritmo construido. Tomemos el ejemplo clásico de 27. La sucesión comienza 27, 82, 41, 124, 62, 31… y continúa con ascensos y descensos hasta alcanzar finalmente 1.
R · ejemploorbita_27 <- AlgoritmoIterativoDeCollatz(27)
length(orbita_27)
# 112

length(orbita_27) - 1L
# 111

max(orbita_27)
# 9232
Éste es un buen lugar para precisar el vocabulario. La órbita almacenada contiene 112 estados, porque incluye tanto el punto de partida 27 como el punto de llegada 1. Sin embargo, entre 112 estados existen solamente 111 transiciones. Por consiguiente, el tiempo total de parada de 27, entendido como número de aplicaciones de la regla necesarias para alcanzar la unidad, es 111.
| k=027 | k=182 | k=241 | k=3124 | k=462 | k=531 | k=694 | k=747 |
| k=8142 | k=971 | k=10214 | k=11107 | k=12322 | k=13161 | k=14484 | k=15242 |
| k=16121 | k=17364 | k=18182 | k=1991 | k=20274 | k=21137 | k=22412 | k=23206 |
| k=24103 | k=25310 | k=26155 | k=27466 | k=28233 | k=29700 | k=30350 | k=31175 |
| k=32526 | k=33263 | k=34790 | k=35395 | k=361186 | k=37593 | k=381780 | k=39890 |
| k=40445 | k=411336 | k=42668 | k=43334 | k=44167 | k=45502 | k=46251 | k=47754 |
| k=48377 | k=491132 | k=50566 | k=51283 | k=52850 | k=53425 | k=541276 | k=55638 |
| k=56319 | k=57958 | k=58479 | k=591438 | k=60719 | k=612158 | k=621079 | k=633238 |
| k=641619 | k=654858 | k=662429 | k=677288 | k=683644 | k=691822 | k=70911 | k=712734 |
| k=721367 | k=734102 | k=742051 | k=756154 | k=763077 | k=779232 | k=784616 | k=792308 |
| k=801154 | k=81577 | k=821732 | k=83866 | k=84433 | k=851300 | k=86650 | k=87325 |
| k=88976 | k=89488 | k=90244 | k=91122 | k=9261 | k=93184 | k=9492 | k=9546 |
| k=9623 | k=9770 | k=9835 | k=99106 | k=10053 | k=101160 | k=10280 | k=10340 |
| k=10420 | k=10510 | k=1065 | k=10716 | k=1088 | k=1094 | k=1102 | k=1111 |
Tabla 3. Órbita completa de 27. La etiqueta k indica cuántas aplicaciones de la regla se han realizado. El máximo, 9232, aparece en k = 77; la unidad aparece en k = 111.
La trayectoria muestra además una propiedad que hace tan sugestivo el problema: una regla determinista extraordinariamente simple no genera necesariamente una evolución visualmente simple. Que el sistema esté perfectamente determinado paso a paso no significa que su comportamiento global sea evidente.
Si se desea conservar el gráfico tradicional en R, puede generarse, por ejemplo, con:
R · visualización opcionalplot(
  orbita_27,
  type = "l",
  xlab = "Iteración k",
  ylab = "n_k"
)
La tabla presenta la órbita completa, de modo que cada estado pueda leerse directamente y seguirse paso a paso.
5. Una segunda solución: recursión
Existe otra forma de diseñar el algoritmo. Puede resultar algo menos intuitiva al imaginarla por primera vez, pero tiene una notable elegancia: en lugar de construir un bucle while(), la propia función vuelve a llamarse a sí misma después de calcular el siguiente valor.
El problema exige ahora una función con dos características principales: su entrada es un entero positivo representable por el sistema numérico que estemos utilizando; su salida contiene, por un lado, la trayectoria seguida y, por otro, el número de transformaciones efectuadas para alcanzar la unidad.
R · versión recursivaCollatzRecursivo <- function(n, v = NULL) {
  if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
    stop("n debe ser un entero positivo.")
  }

  v <- c(v, n)

  if (n == 1) {
    return(list(
      pasos = v,
      iteraciones = length(v) - 1L
    ))
  }

  if (n %% 2 == 0) {
    n <- n / 2
  } else {
    n <- 3 * n + 1
  }

  return(CollatzRecursivo(n, v))
}
Aquí sí se aplica recursión en el sentido preciso de la programación: dentro de la ejecución de CollatzRecursivo() aparece una nueva llamada a CollatzRecursivo(). Esa nueva llamada recibe un valor distinto de n y una copia ampliada del vector v.
La condición n == 1 es el caso base. Sin un caso base alcanzable, una definición recursiva continuaría produciendo llamadas adicionales hasta agotar los recursos disponibles. Cuando se llega a 1 ya no se crea una nueva llamada: se devuelve la lista que contiene la órbita y el número de iteraciones.
c() concatena elementos o vectores. list() construye una lista cuyos componentes pueden tener nombres y tipos distintos. length() devuelve el número de elementos de un objeto como un vector o una lista; no debe confundirse con dim(), que informa las dimensiones de objetos que poseen un atributo dimensional.
La expresión iteraciones = length(v) – 1L merece atención. Si v contiene tanto el valor inicial como la unidad final, su longitud cuenta estados, no transformaciones. Restar uno corrige exactamente esa diferencia.
| Semilla | Estados devueltos | Iteraciones |
|---|---|---|
| 8 | 8 → 4 → 2 → 1 | 3 |
| 27 | 112 estados desde 27 hasta 1 | 111 |
Tabla 4. La diferencia entre contar estados y contar aplicaciones de la función. En la trayectoria 8 → 4 → 2 → 1 hay cuatro valores, pero solamente tres pasos.
Es necesario agregar una salvedad práctica. La recursión es una excelente herramienta para comprender la estructura lógica del problema, pero no siempre es la forma más robusta de recorrer órbitas largas en R: cada llamada recursiva añade un nuevo marco de ejecución y la profundidad disponible es finita. Para trabajo computacional intensivo, la versión iterativa suele ser preferible; para comprender qué significa que una función se invoque a sí misma, la versión recursiva es particularmente transparente.
6. Cómo pensar matemáticamente la recursión
Antes de programar una solución recursiva conviene separar dos cosas que, aunque íntimamente relacionadas, no son idénticas: la dinámica matemática y la estructura de llamadas del programa. La función matemática fundamental sigue siendo T. Lo que cambia es la manera en que el programa organiza el cálculo de sus iteraciones.
El algoritmo puede pensarse de la siguiente manera:
| Paso lógico | Acción |
|---|---|
| 1 | Ingresar un entero positivo N. |
| 2 | Registrar N como un nuevo estado de la trayectoria. |
| 3 | Si N = 1, devolver la trayectoria y terminar. |
| 4a | Si N es par, asignar N ← N/2. |
| 4b | Si N es impar, asignar N ← 3N + 1. |
| 5 | Ejecutar nuevamente la misma función utilizando el nuevo valor de N. |
Tabla 5. Caso de uso de la solución recursiva. La recursión aparece en el último paso: la función vuelve a ejecutarse con una entrada nueva.
Matemáticamente, sin embargo, no hace falta definir una nueva función C(n) cuyo valor sea siempre 1 cuando la recursión termina. Esa escritura ocultaría el objeto que realmente interesa. Resulta más limpio conservar T como el mapa de Collatz y definir la órbita mediante iteraciones sucesivas:
El tiempo total de parada puede escribirse entonces como el primer índice en que la órbita toca la unidad:
Esta formulación hace visible la verdadera dificultad. Conocemos exactamente la regla local que lleva de un estado al siguiente. Lo que no se sigue automáticamente de esa definición es que τ(n) sea finito para todos los enteros positivos.
Tomemos n = 8:
| k = 0 | k = 1 | k = 2 | k = 3 | |||
|---|---|---|---|---|---|---|
| 8 | → | 4 | → | 2 | → | 1 |
Tabla 6. Desde 8 hasta 1 existen cuatro estados y tres aplicaciones de T. Por tanto, τ(8) = 3.
La función recursiva reproduce computacionalmente esta misma cadena, pero cada flecha corresponde ahora no sólo a una transformación matemática, sino también a una nueva llamada de función. La sucesión matemática avanza de 8 a 4, de 4 a 2 y de 2 a 1; el programa, mientras tanto, va creando niveles de ejecución hasta encontrar el caso base.
7. La pila de llamadas: por qué es LIFO
Para comprender qué ocurre durante la recursión puede utilizarse un ejemplo deliberadamente sencillo. Supóngase que existe un “Listado X” con estas instrucciones:
1. Ejecutar A1.
2. Ejecutar A2.
3. Ejecutar las instrucciones del Listado X.
4. Regresar e imprimir “Hola, Fernanda”.
Al llegar al paso 3 el programa inicia otra ejecución del mismo listado. Esa nueva ejecución llega a su propio paso 3 y crea otra, y así sucesivamente. Como no existe aquí un caso base, el paso 4 nunca llega a ejecutarse: antes se agotarán los recursos que el entorno permite dedicar a llamadas anidadas.
| Nivel | A1 | A2 | Paso 3 | Resultado |
|---|---|---|---|---|
| Listado X₀ | ejecuta | ejecuta | llama X₁ | queda pendiente |
| Listado X₁ | ejecuta | ejecuta | llama X₂ | queda pendiente |
| Listado X₂ | ejecuta | ejecuta | llama X₃ | queda pendiente |
| ⋮ | ⋮ | ⋮ | ⋮ | ⋮ |
Tabla 7. Estructura de las llamadas recursivas. Cada llamada queda suspendida mientras espera que termine la llamada creada dentro de ella.
Cuando sí existe un caso base, como ocurre en nuestro algoritmo al alcanzar 1, la situación cambia. La llamada más profunda termina primero; después puede terminar la que la creó; después la anterior, y así sucesivamente. Por eso la estructura natural de las llamadas anidadas es una stack o pila, organizada como LIFO: Last In, First Out, es decir, “el último en entrar es el primero en salir”.
| TOPE DE LA PILA · llamada con n = 1 · termina primero |
| llamada con n = 2 · espera el resultado de n = 1 |
| llamada con n = 4 · espera el resultado de n = 2 |
| BASE · llamada con n = 8 · fue creada primero |
Tabla 8. La pila de llamadas para 8 → 4 → 2 → 1. La llamada con 1 es la última en entrar y la primera que puede finalizar; después se resuelven las llamadas pendientes en orden inverso.
La analogía con una pila de platos continúa siendo útil: si se apilan varios platos uno sobre otro, el último colocado queda en la parte superior y es el primero que puede retirarse sin desarmar la pila. Sin embargo, conviene precisar la razón técnica: las llamadas recursivas se organizan de esta forma por la estructura anidada del control del programa. La relación con la localidad de memoria o con posibles efectos sobre la caché puede ser relevante en otros contextos de rendimiento, pero no es la causa que explica por qué la pila de llamadas es LIFO.
8. Qué nos enseña Collatz sobre Matemática y Computación
Hay todavía una cuestión conceptual que merece atención. Podría parecer, a primera vista, que la formulación matemática nos ofrece un proceso “continuo” mientras que el programa lo convierte en una colección de pasos discretos. Esa oposición, sin embargo, no describe correctamente este problema. La dinámica de Collatz es discreta desde su propia definición matemática: el tiempo de la iteración está indexado por 0, 1, 2, 3, … y cada estado pertenece, en su formulación usual, al conjunto de los enteros positivos.
Por tanto, la diferencia interesante no está entre una Matemática continua y una Computación discreta. Está en otra parte: entre definir una regla, calcular sus consecuencias para casos particulares y demostrar una propiedad global de todas sus órbitas.
| Nivel | Qué sabemos | Qué no se sigue automáticamente |
|---|---|---|
| Regla matemática | Para cada estado sabemos exactamente cuál es el siguiente. | No conocemos por esa sola razón el destino global de toda órbita posible. |
| Cálculo computacional | Podemos seguir paso a paso una órbita particular y comprobar si alcanza 1. | Un número finito de comprobaciones no equivale a una demostración universal. |
| Demostración matemática | Buscaría establecer una proposición válida para todos los enteros positivos. | No puede reemplazarse simplemente por enumerar más y más casos. |
Tabla 9. Tres niveles de conocimiento que Collatz obliga a distinguir: especificación local, experimentación computacional y demostración global.
Esta distinción permite formular de manera más precisa la reflexión epistemológica que hace atractivo al ejemplo. La Matemática no consiste necesariamente en colocar un fenómeno dentro de una forma analítica cuyo comportamiento ya sea conocido. Collatz muestra exactamente lo contrario: podemos poseer una regla perfectamente definida y, aun así, carecer de una caracterización completa de su comportamiento global.
Tampoco la Computación queda reducida a atender “particularidades” que la Matemática habría abstraído. En este caso ambas trabajan sobre el mismo objeto discreto, pero hacen preguntas diferentes. El programa permite ejecutar la regla, inspeccionar órbitas, medir tiempos de parada, descubrir regularidades y someter conjeturas auxiliares a prueba numérica. La demostración matemática pregunta, en cambio, qué puede afirmarse necesariamente para una clase infinita de casos.
Ésta es, probablemente, una de las enseñanzas más interesantes que puede extraerse del problema desde la perspectiva conjunta de la Matemática y las Ciencias de la Computación. En Collatz hay determinación local, computabilidad efectiva de cada paso y una enorme cantidad de evidencia para valores particulares; pero esas tres cosas no deben confundirse con una demostración universal.
9. Una precaución: los enteros de la Matemática no son los de la máquina
Finalmente, hay una diferencia adicional entre el objeto matemático y su implementación concreta que conviene hacer explícita. La expresión “cualquier N ∈ ℕ” describe un dominio matemático ilimitado. Una computadora, en cambio, representa números mediante estructuras finitas.
En R base existen, entre otras cosas, valores de tipo integer, cuyo rango es limitado, y valores numeric que normalmente utilizan aritmética de doble precisión. Estos últimos pueden representar exactamente todos los enteros sólo hasta cierto tamaño; por encima de 253, no todos los enteros consecutivos poseen una representación exacta como números de doble precisión.
La cuestión es particularmente relevante en Collatz porque una órbita puede crecer mucho por encima de su valor inicial antes de comenzar a descender. Por consiguiente, una implementación destinada a investigar números muy grandes debe utilizar aritmética entera exacta de mayor capacidad —por ejemplo, enteros de precisión arbitraria— y comprobar cuidadosamente posibles desbordamientos o pérdidas de exactitud.
Objeto matemático: T actúa sobre todos los enteros positivos.
Programa concreto: sólo puede actuar correctamente sobre los valores que su representación numérica y sus recursos de memoria permiten manipular de manera exacta.
Esto no invalida el uso pedagógico del código anterior. Para semillas pequeñas, como 8 o 27, la implementación es perfectamente adecuada. Lo que evita es atribuirle a una representación computacional finita el mismo dominio ilimitado que posee el objeto matemático abstracto.
Consideraciones finales
La conjetura de Collatz constituye un ejemplo extraordinariamente fértil para aprender a programar porque permite pasar, casi sin introducir artificios, desde una regla matemática elemental hasta varias ideas centrales de las Ciencias de la Computación. Primero se construye una función que decide entre dos operaciones; después se convierte esa operación en una iteración; luego se almacena la órbita; finalmente se reconstruye el mismo proceso mediante recursión y se observa cómo las llamadas anidadas quedan organizadas en una pila.
Pero el ejemplo es igualmente fértil por una razón más profunda. Una sucesión puede estar gobernada por una regla completamente determinista y, aun así, plantear enormes dificultades cuando se intenta establecer una propiedad global para todas sus trayectorias. El programa sabe qué hacer en cada paso. La dificultad matemática consiste en justificar qué ocurrirá después de todos los pasos necesarios, para cualquier punto de partida posible.
En este sentido, la programación no reemplaza la demostración ni la demostración vuelve innecesaria a la programación. La primera permite experimentar con el objeto, recorrerlo y producir evidencia concreta; la segunda busca establecer relaciones que no dependan de haber enumerado previamente cada caso. Collatz es un terreno particularmente limpio para observar esa diferencia porque no hay oscuridad alguna en la regla elemental: la dificultad emerge de la dinámica producida al repetirla.
Y justamente por ello una función personalizada en R resulta algo más que un ejercicio de sintaxis. Permite observar, en una escala pequeña y manejable, el tránsito entre definición, algoritmo, ejecución, representación numérica y razonamiento matemático; es decir, entre distintos niveles de una misma actividad científica que conviene mantener relacionados sin confundirlos.
Leave a Comment/Deja un Comentario