
Estadística matemática · Modelos lineales generalizados
Modelo logit o regresión logística
Sobre la especificación estadística, la transformación logit y el vínculo entre probabilidades, odds y predictores lineales
Como señalan Aldrich y Nelson (1984), toda inferencia estadística presupone alguna especificación del fenómeno que se pretende estudiar. No basta, por tanto, con disponer de un modelo matemáticamente elegante ni con poseer un procedimiento computacional capaz de estimarlo. El problema previo es otro: determinar si las propiedades matemáticas del modelo guardan una correspondencia científicamente defendible con las propiedades del objeto real que se investiga.
Ésta es una cuestión que antecede a la estimación. La teoría estadístico-matemática puede decirnos qué propiedades posee un estimador bajo determinadas condiciones; no puede, por sí sola, garantizar que esas condiciones describan adecuadamente el proceso material, económico, social o natural del cual proceden los datos. Cuando la especificación fracasa, también pueden fracasar las propiedades inferenciales sobre las cuales descansan nuestras conclusiones.
El modelo logit constituye un buen ejemplo de este problema general. Su utilidad no se deriva simplemente de que sea popular o de que los programas estadísticos permitan estimarlo con facilidad. Se deriva de la relación específica que establece entre una variable de respuesta dicotómica, una probabilidad condicionada y una función matemática capaz de transformar dicha probabilidad en una magnitud que puede ser representada mediante un predictor lineal.
La simplicidad constituye una buena hipótesis de partida cuando no existe conocimiento que obligue a hacer otra cosa. Pero allí donde la teoría o la evidencia indican una estructura distinta, la simplicidad deja de ser una justificación para imponerla.
1. El problema del modelo de probabilidad lineal
Supongamos una variable dicotómica \(Y_i\), que puede tomar únicamente los valores cero y uno. Podemos definir:
La esperanza condicional de una variable de Bernoulli coincide precisamente con su probabilidad de éxito:
Una primera posibilidad consiste en representar esa probabilidad mediante una función lineal de las variables explicativas:
El problema matemático aparece inmediatamente. Una probabilidad debe satisfacer:
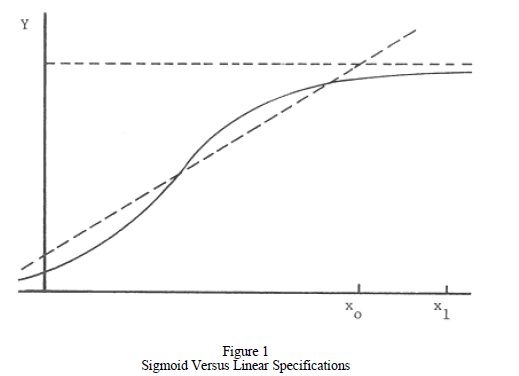
mientras que un predictor lineal como \(\beta_0+\beta_1X_{i1}+\cdots+\beta_kX_{ik}\) no posee, en general, tales límites. Puede producir números menores que cero o mayores que uno. Un modelo lineal de probabilidad puede ser útil en determinados contextos como aproximación y posee algunas ventajas interpretativas, pero esta incompatibilidad entre el rango del predictor lineal y el rango de una probabilidad constituye una razón fundamental para buscar otra especificación.
No necesitamos abandonar el predictor lineal. Lo que podemos hacer es transformar la probabilidad.
2. De la probabilidad a los odds y al logit
Si \(0<P_i<1\), podemos formar el cociente:
Esta cantidad recibe habitualmente el nombre de odds o razón de posibilidades. Compara la probabilidad de que ocurra el acontecimiento con la probabilidad de que no ocurra.
Por ejemplo, si \(P_i=0.75\):
Los odds son, por tanto, de 3 a 1 a favor del acontecimiento. Esta transformación elimina el límite superior de la probabilidad, pero no elimina todas las restricciones:
Los odds siguen siendo necesariamente positivos. Para obtener una magnitud capaz de recorrer toda la recta real se aplica el logaritmo natural:
Esta transformación es el logit de la probabilidad:
Ahora sí tenemos una cantidad cuyo dominio de valores es compatible con el de un predictor lineal. Podemos, entonces, especificar:
La probabilidad \(P_i\) pertenece al intervalo \((0,1)\); los odds \(P_i/(1-P_i)\) pertenecen a \((0,\infty)\); y los log-odds o logit pertenecen a toda la recta real \((-\infty,\infty)\). Son tres escalas distintas y no deben confundirse.
3. La función logística
Una vez establecida la relación anterior, podemos despejar \(P_i\). Partimos de:
Aplicando la función exponencial:
Mediante manipulación algebraica:
Hemos llegado a la función logística estándar. La transformación resuelve precisamente el problema que nos interesaba: \(Z_i\) puede adoptar cualquier valor real, pero el resultado de la función siempre se encuentra entre cero y uno.
Si \(Z_i\rightarrow-\infty\), entonces \(P_i\rightarrow0\).
Si \(Z_i=0\), entonces \(P_i=0.5\).
Si \(Z_i\rightarrow+\infty\), entonces \(P_i\rightarrow1\).
La función es continua, suave y monótonamente creciente. Su forma es la conocida curva sigmoidea o curva en S. La logística estándar posee además simetría rotacional alrededor del punto \((0,1/2)\).
Una expresión más general de la función logística es:
donde \(L\) determina el límite superior, \(k\) regula la rapidez del crecimiento y \(x_0\) determina la posición del punto medio. La función logística estándar empleada habitualmente para transformar un predictor lineal en una probabilidad corresponde a:
Conviene distinguir, además, la función logística utilizada aquí como inversa de la función enlace de la distribución logística. Ambos objetos están relacionados, pero no son sinónimos.
4. ¿Por qué una función logística?
Haber encontrado una función matemáticamente conveniente no resuelve por sí solo el problema de la especificación. Como observan Aldrich y Nelson (1984), existen muchas funciones capaces de transformar un predictor no restringido en una probabilidad. La logística no constituye la única posibilidad.
Entre los modelos alternativos más conocidos se encuentra el probit, que utiliza como inversa del enlace la función de distribución acumulada normal estándar. También existe, entre otros, el enlace complementary log-log. Cada elección impone una estructura matemática diferente a la relación entre el predictor y la probabilidad.
| Modelo | Función enlace | Rasgo principal |
|---|---|---|
| Logit | \(\log[p/(1-p)]\) | Interpretación natural mediante odds y odds ratios. |
| Probit | \(\Phi^{-1}(p)\) | Utiliza la distribución normal acumulada. |
| Complementary log-log | \(\log[-\log(1-p)]\) | Introduce una respuesta asimétrica respecto de la probabilidad. |
Logit y probit suelen producir resultados empíricos muy semejantes en una gran cantidad de aplicaciones, especialmente en la zona central de sus respectivas curvas. Esto no significa que sean matemáticamente idénticos ni que la elección pueda hacerse siempre de manera indiferente. El criterio correcto sigue siendo sustantivo y estadístico: qué estructura resulta justificable para el fenómeno, qué propiedades inferenciales necesitamos y qué aspectos de la respuesta interesa representar.
La existencia de un modelo estadístico disponible no constituye una prueba de que ese modelo corresponda al objeto. Elegir una función enlace es también formular una hipótesis acerca de la forma matemática de la relación estudiada.
5. El modelo estadístico
Hasta este punto hemos examinado principalmente la geometría de la transformación. Pero una regresión logística no consiste únicamente en dibujar una curva en S. Es un modelo probabilístico.
Cuando cada observación representa un resultado individual dicotómico, la formulación natural es:
con:
Si, en cambio, las observaciones están agrupadas y registramos \(Y_i\) éxitos dentro de \(n_i\) ensayos, podemos escribir:
Esta distinción es importante. No resulta preciso afirmar simplemente que «el conjunto de datos sigue una distribución binomial». La distribución probabilística se especifica para la variable de respuesta condicionada a las covariables y depende de la estructura de observación de los datos.
En el lenguaje de los modelos lineales generalizados, la regresión logística combina tres elementos:
Componente aleatorio: una respuesta Bernoulli o binomial.
Componente sistemático: el predictor lineal \(X_i\beta\).
Función enlace: \(g(P_i)=\log[P_i/(1-P_i)]\).
La función logística \(g^{-1}(Z)=1/(1+e^{-Z})\) es, por tanto, la inversa de ese enlace.
6. Estimación mediante máxima verosimilitud
Los coeficientes de una regresión logística no se obtienen habitualmente minimizando la suma de cuadrados de los residuos como en la regresión lineal ordinaria. Se estiman mediante máxima verosimilitud.
Para observaciones Bernoulli independientes condicionadas a las covariables, la contribución de cada observación a la verosimilitud puede escribirse como:
Para \(n\) observaciones:
El procedimiento busca los valores de los parámetros \(\beta\) que hacen más verosímiles los resultados efectivamente observados bajo el modelo especificado. En la práctica se maximiza normalmente el logaritmo de la verosimilitud:
No existe en general una fórmula cerrada equivalente a la de mínimos cuadrados ordinarios para obtener los coeficientes. La solución se obtiene mediante procedimientos numéricos iterativos.
7. Cómo interpretar los coeficientes
Éste es uno de los puntos que más confusión provoca cuando se pasa de la regresión lineal a la logística. Si:
entonces \(\beta_j\) no representa directamente el cambio en la probabilidad producido por una unidad adicional de \(X_j\). Representa el cambio en los log-odds, manteniendo constantes las demás variables del predictor.
Al exponenciar el coeficiente obtenemos una interpretación más intuitiva:
Éste es el factor por el cual se multiplican los odds cuando \(X_j\) aumenta en una unidad, ceteris paribus.
Si \(\beta_j=0.5\), entonces:
Una unidad adicional de \(X_j\) multiplica los odds por aproximadamente 1.65, es decir, los incrementa aproximadamente en un 65 %, manteniendo constantes las demás variables. Esto no significa que la probabilidad aumente 0.5 ni 50 puntos porcentuales.
El efecto sobre la probabilidad no es constante
La razón es que la relación entre \(Z_i=X_i\beta\) y \(P_i\) es no lineal. Para una variable continua \(X_j\), y en la especificación aditiva simple, el efecto marginal es:
Por tanto, un mismo coeficiente \(\beta_j\) puede corresponder a cambios diferentes en la probabilidad dependiendo del punto de la curva en que se encuentre cada observación. La respuesta es más sensible en la región central de la función logística y menos sensible cerca de sus extremos.
Ésta no es una dificultad accidental del modelo. Es una consecuencia directa de la estructura matemática que hemos decidido utilizar.
8. Evaluación y diagnóstico
Estimar un conjunto de coeficientes no termina el problema. Hay que preguntarse si el modelo describe suficientemente bien la información que se pretende explicar y, sobre todo, si las inferencias que deseamos extraer de él son defendibles.
Razón de verosimilitudes
Una comparación clásica consiste en enfrentar el modelo que contiene las variables explicativas con otro que contiene únicamente la constante. El estadístico de razón de verosimilitudes puede escribirse como:
y, bajo condiciones regulares, posee aproximadamente una distribución chi-cuadrado con grados de libertad correspondientes al número de restricciones contrastadas.
Este contraste puede indicarnos si el conjunto de predictores mejora el ajuste respecto de un modelo más restringido. No debe confundirse, sin embargo, con una evaluación completa de la utilidad científica del modelo.
La significancia no basta
Dependiendo del objetivo de la investigación conviene examinar también aspectos como:
- la calibración de las probabilidades estimadas;
- la capacidad de discriminación entre resultados;
- la deviance y los residuos apropiados para modelos lineales generalizados;
- la estabilidad de los coeficientes;
- la presencia de observaciones influyentes;
- el desempeño fuera de muestra cuando el objetivo es predictivo;
- y, sobre todo, la adecuación de la forma funcional y de los supuestos al problema científico.
9. La especificación vuelve al centro
Llegamos así nuevamente al problema con el cual comenzamos. La regresión logística resuelve elegantemente una dificultad matemática: permite relacionar un predictor no restringido con una probabilidad necesariamente comprendida entre cero y uno. Pero esta virtud matemática no convierte al logit en una elección automática para todo fenómeno dicotómico.
Su utilización presupone una determinada estructura. Entre otras cosas, conviene estudiar si el predictor lineal es una representación adecuada de los log-odds, si la dependencia entre observaciones ha sido correctamente modelada, si existen interacciones o no linealidades relevantes y si aparece separación completa o cuasicompleta, circunstancia capaz de producir estimaciones de máxima verosimilitud problemáticas o no finitas.
- ¿Existe una justificación científica para las variables incluidas y la forma en que entran en el predictor?
- ¿La relación aproximadamente lineal que se supone corresponde a los log-odds, o hacen falta transformaciones, términos no lineales o interacciones?
- ¿La estructura de dependencia de las observaciones está representada adecuadamente?
- ¿Hay suficiente información en los datos para identificar los parámetros?
- ¿El objetivo es explicativo, predictivo, descriptivo o causal?
La última pregunta merece especial atención. Una asociación obtenida mediante regresión logística no adquiere carácter causal por haber sido expresada mediante coeficientes, probabilidades u odds ratios. La causalidad exige supuestos y un diseño capaces de justificar esa interpretación.
Del mismo modo, un modelo puede ser una aproximación útil aun sin constituir una descripción literalmente exacta del proceso generador de los datos. El problema científico consiste entonces en determinar qué propiedades de la aproximación son suficientemente robustas para el propósito inferencial concreto.
La enseñanza más general no se limita, por tanto, a la regresión logística. Un modelo estadístico es un instrumento matemático que contiene una estructura específica: un espacio de resultados posibles, una distribución probabilística, una forma funcional, parámetros y supuestos acerca de las relaciones entre las magnitudes. Aplicarlo significa afirmar —explícita o implícitamente— que esas propiedades guardan alguna correspondencia relevante con el fenómeno estudiado.
Desde este punto de vista, el problema de la especificación posee un contenido genuinamente gnoseológico. La matemática no es una decoración colocada posteriormente sobre los datos. Tampoco los datos, por sí solos, determinan qué modelo debe emplearse. Entre el objeto real y la expresión matemática existe una mediación teórica que debe ser examinada, criticada y contrastada.
El logit constituye una solución particularmente elegante porque transforma una probabilidad restringida en una magnitud sin restricciones y permite recuperar posteriormente una probabilidad válida mediante la función logística:
Pero la elegancia de la transformación no sustituye a la investigación del objeto. Precisamente porque el modelo posee propiedades matemáticas determinadas, debemos preguntarnos cuándo esas propiedades son pertinentes. Allí se encuentra el punto de contacto entre estadística, matemática y conocimiento científico.
Referencias
Aldrich, J. H., & Nelson, F. D. (1984). Linear Probability, Logit, and Probit Models. Beverly Hills: Sage University Papers Series, Quantitative Applications in the Social Sciences.
Liao, T. F. (1994). Interpreting Probability Models: Logit, Probit, and Other Generalized Linear Models. Sage University Papers Series, Quantitative Applications in the Social Sciences.
McCullagh, P., & Nelder, J. A. (1989). Generalized Linear Models (2nd ed.). London: Chapman & Hall.
Leave a Comment/Deja un Comentario