ESTADÍSTICA MATEMÁTICA · ESTUDIO DE CASO · PARTE I
Regresión y Tratamiento del Agua
Dosis de sulfato de aluminio, concentración de aplicación y dosis de cal: modelos gaussianos y evaluación crítica de supuestos.
25 SEPTIEMBRE 2021 · REVISIÓN: 2 NOVIEMBRE 2026
1. El problema: del ensayo de jarras a la predicción
La dosificación de reactivos en una planta de tratamiento depende de un agua que cambia. La turbidez, el color, el pH y otras propiedades condicionan la selección experimental del tratamiento. La pregunta estadística consiste en determinar hasta qué punto esas mediciones permiten anticipar la dosis seleccionada en el laboratorio y con qué límites puede utilizarse esa predicción.
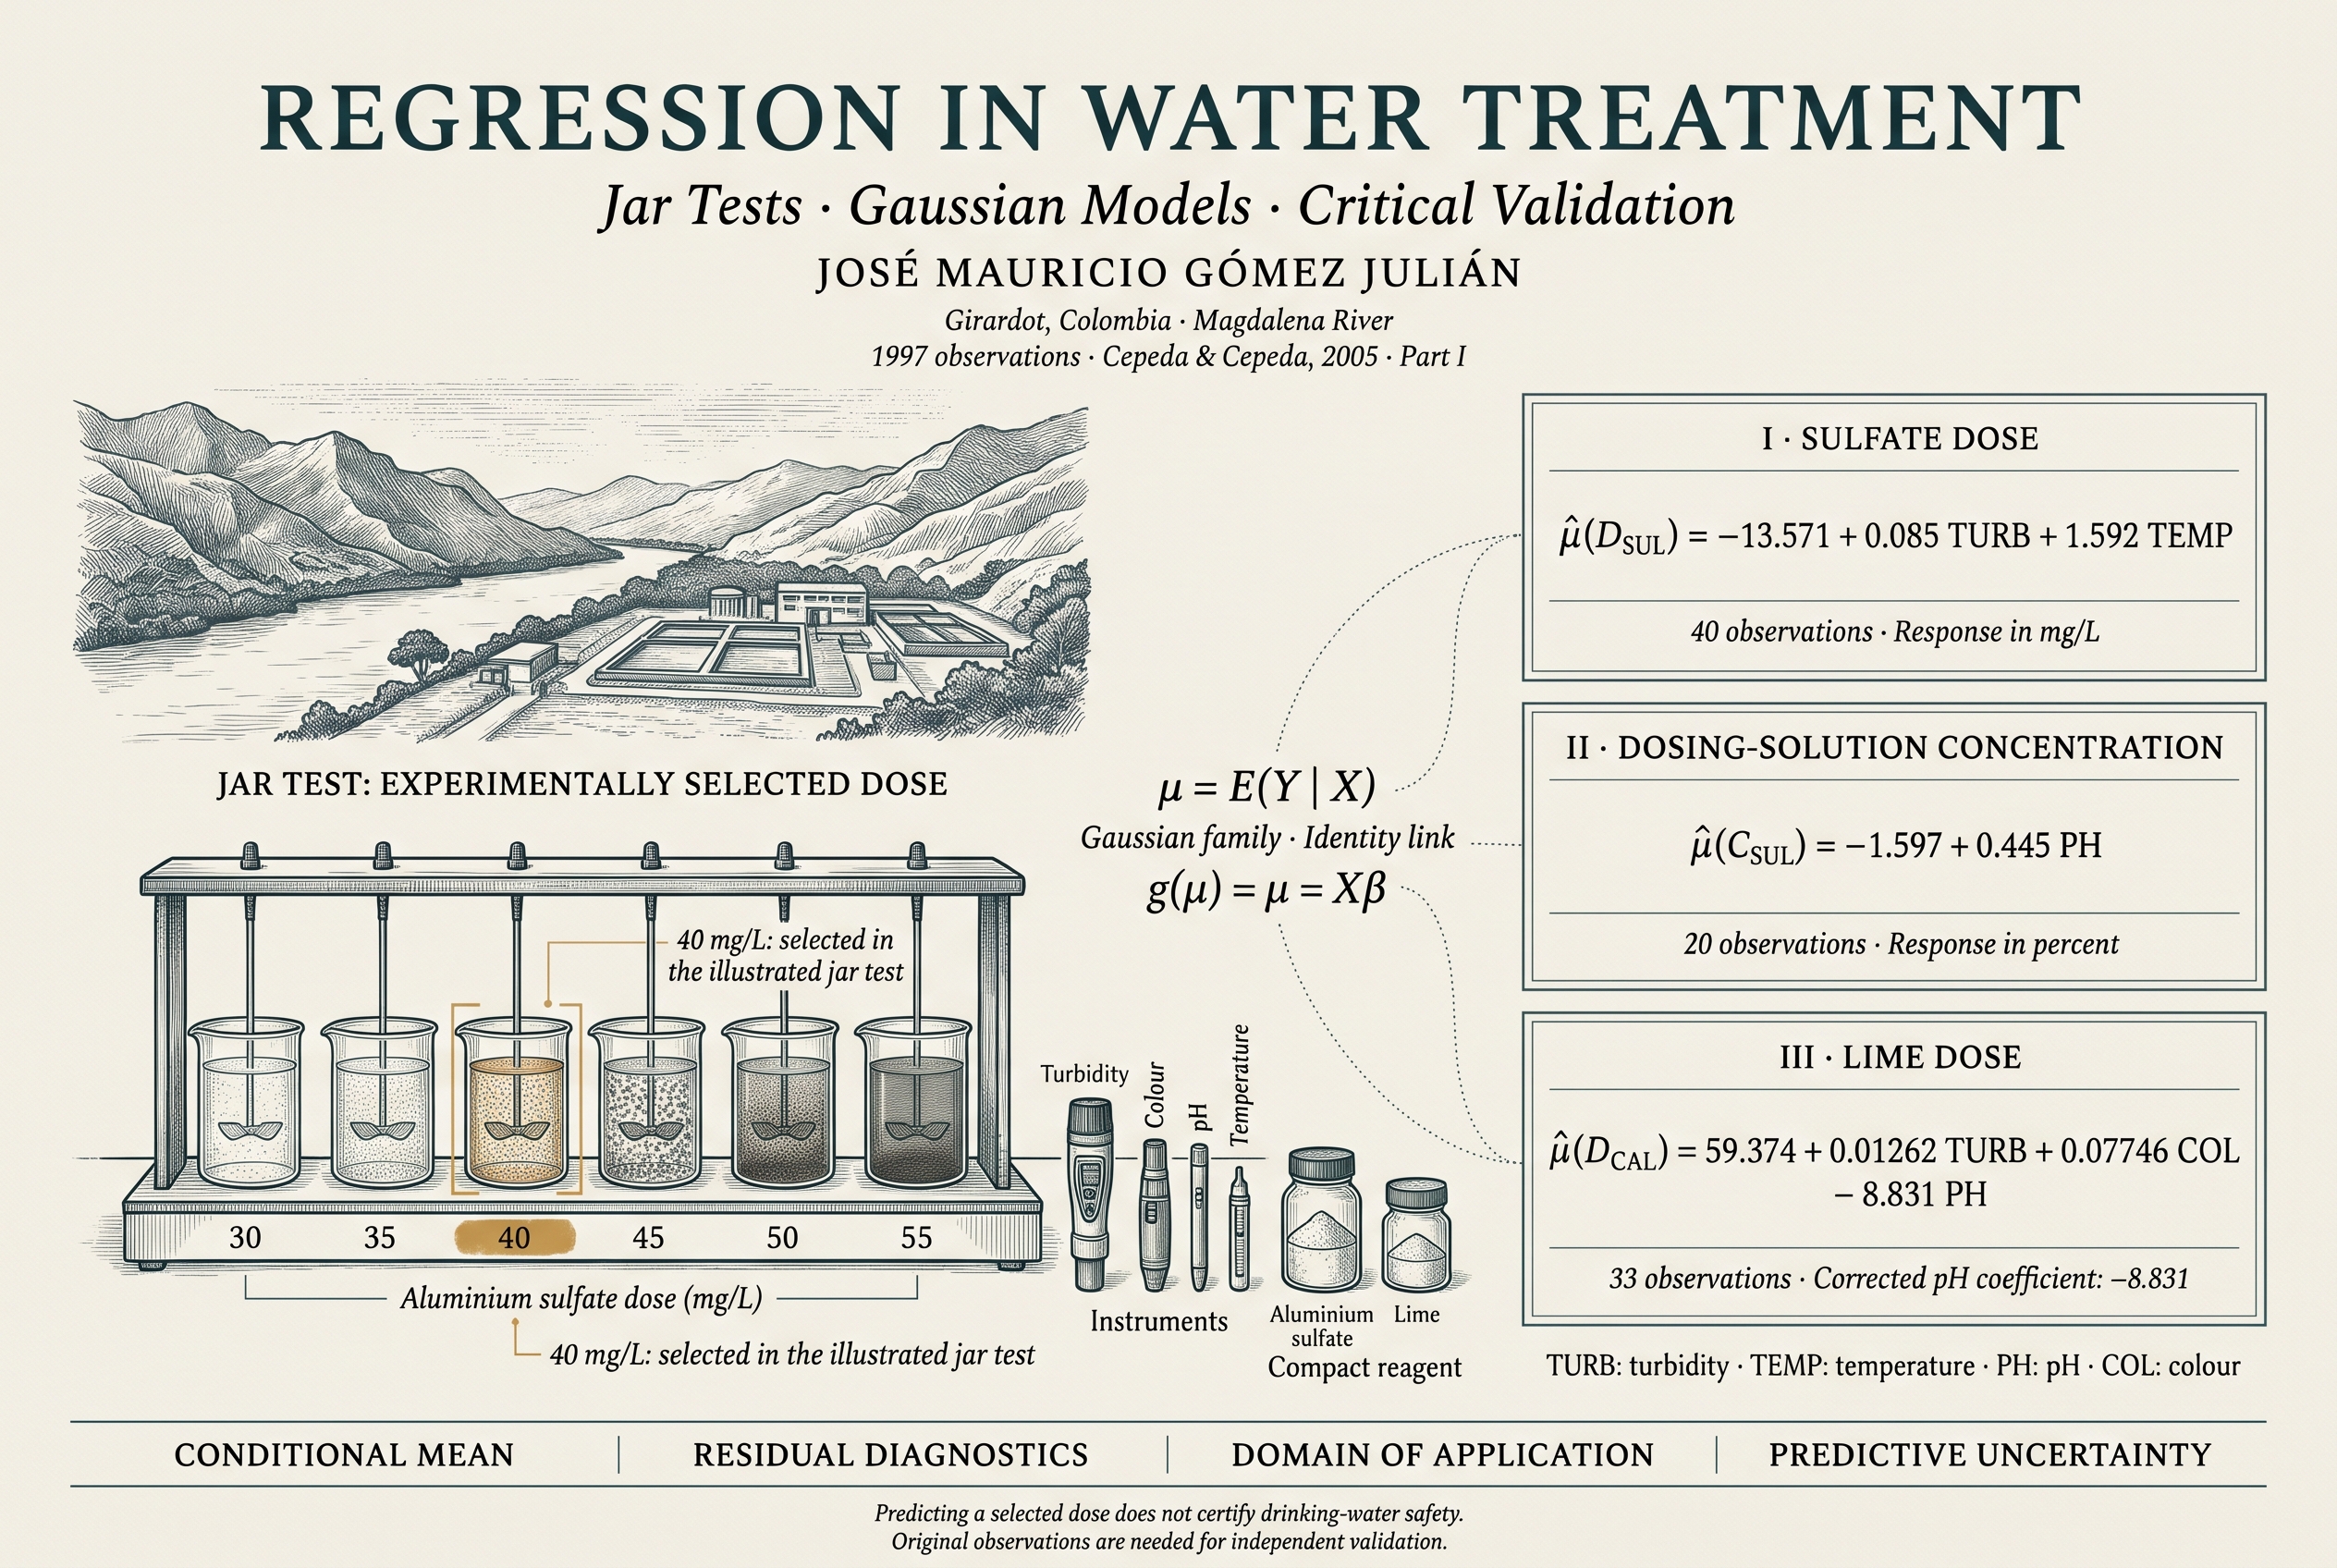
Este estudio de caso examina el trabajo de Zulma Cepeda y Edilberto Cepeda C., publicado en 2005 en la Revista Colombiana de Estadística, sobre una planta de Girardot, Colombia, abastecida por el río Magdalena. Los datos corresponden a 1997. Se estudian tres respuestas continuas: dosis de sulfato de aluminio, concentración de su solución de aplicación y dosis de cal. Las probabilidades de aplicar cal o polímero, analizadas mediante regresión logística en el estudio de referencia, quedan como continuidad temática para la segunda parte. [1]
La finalidad es doble: explicar las ecuaciones y evaluar qué permite sostener la documentación publicada. Se trata de una revisión crítica y didáctica; no de un nuevo ajuste con los registros originales, que no acompañan a los documentos examinados. Un resultado reproducido, una deducción matemática y una validación empírica constituyen niveles distintos de evidencia.
Una ecuación puede resumir un tratamiento observado; su utilidad científica depende también de cómo se obtuvo, dónde se aplica y cómo se evalúa.
2. El proceso físico y químico
La secuencia de tratamiento proporciona el contexto material de las variables. Sus etapas cumplen funciones diferentes y su configuración concreta depende de la planta y del agua de origen.
- Aireación. Favorece el intercambio de gases con el aire y, bajo condiciones apropiadas, la oxidación de determinados compuestos, incluidos hierro y manganeso disueltos. Los precipitados resultantes requieren separación posterior. No equivale a desinfección.
- Coagulación. La adición de un coagulante, como sulfato de aluminio, desestabiliza dispersiones coloidales. La hidrólisis del aluminio genera especies y precipitados que pueden favorecer la agregación y captura de partículas; su eficacia depende, entre otras condiciones, del pH y de la alcalinidad.
- Floculación. La mezcla controlada favorece el contacto y crecimiento de agregados. Los polímeros pueden ayudar a formar flóculos; coagulación y floculación son procesos relacionados, con mecanismos y condiciones de operación distinguibles.
- Sedimentación. Separa por gravedad una fracción de los sólidos. La concentración de sólidos, su velocidad de sedimentación y la turbidez describen propiedades diferentes. No corresponde medirlas todas como si fueran una única magnitud.
- Filtración. Retiene partículas mediante un medio filtrante y mecanismos físicos y fisicoquímicos. La eficiencia depende del medio y de su operación.
- Desinfección. Busca inactivar microorganismos mediante un proceso validado. La reducción de turbidez ayuda a su funcionamiento, pero una muestra visualmente clara no acredita por sí misma seguridad microbiológica.
La potabilidad requiere evaluar peligros microbiológicos y químicos, operación y distribución. Los criterios de aceptabilidad —apariencia, sabor u olor— tampoco sustituyen esa evaluación. Las guías de la OMS distinguen objetivos sanitarios, gestión del riesgo y vigilancia; sus recomendaciones deben relacionarse con la regulación aplicable y su fecha. [6]
Qué significa «óptimo» en este caso
El ensayo de jarras selecciona una combinación de reactivos bajo condiciones y criterios experimentales. La regresión predice esa respuesta seleccionada. Una optimización operacional completa requeriría, además, definir explícitamente el costo, las restricciones de calidad, la seguridad y la incertidumbre. Por ello, «dosis óptima» designa aquí la respuesta del procedimiento experimental, sin implicar una solución universal para cualquier agua.
3. Variables, medición y procedencia de los datos
| Símbolo | Propiedad | Rango comunicado | Interpretación |
|---|---|---|---|
| TURB | Turbidez | 200–1200 NTU | Respuesta óptica a partículas; no equivale directamente a mg/L de sólidos. |
| COL | Color | 50–250 UC | Precisar color verdadero o aparente y método de medición. |
| PH | pH | 7.1–8.33 | Magnitud adimensional relacionada con la actividad del ion hidrógeno. |
| ALCA | Alcalinidad | 43–55 mg/L como CaCO₃ | Capacidad de neutralización ácida; distinta del pH. |
| DUR | Dureza | 43–50, interpretados como mg/L como CaCO₃ | La fuente abrevia la unidad en el rango; el contexto la expresa como CaCO₃. |
| TEMP | Temperatura | 24–28 °C | Condición térmica del agua de entrada al estudio. |
Estos rangos describen el estudio; no son límites universales de potabilidad ni prueban que cualquier combinación de valores interiores haya sido observada. Los ejemplos de jarras del propio artículo incluyen alcalinidades de 40 y 58 mg/L como CaCO₃, fuera del rango general 43–55. Se conserva esta diferencia documental, sin corregirla mediante valores inventados. [1]
| Respuesta | Significado | Observaciones | Unidad o convención |
|---|---|---|---|
| D_SUL | Dosis de sulfato de aluminio | 40 | mg/L de reactivo aplicado al agua |
| C_SUL | Concentración de la solución de aplicación | 20, subconjunto de las 40 | Porcentaje de concentración de solución |
| D_CAL | Dosis de cal | 33 | Dosis; verificar la convención exacta en los registros |
| Aplicación de cal/polímero | Respuestas binarias de la parte II | 60 observaciones de registros, según el artículo | 0/1; no confundir con cantidad aplicada |
Precisiones de medición
El pH se define por el logaritmo decimal negativo de la actividad del ion hidrógeno: pH = −log₁₀ a(H⁺). En soluciones suficientemente diluidas puede usarse una aproximación basada en concentración referida al estado estándar. El pH no tiene unidades de mol/L: esas unidades corresponden a una concentración. La alcalinidad expresa capacidad de neutralización; la dureza se asocia principalmente con calcio y magnesio.
El color verdadero se determina tras remover la interferencia de partículas por un procedimiento definido; el aparente incluye esa contribución. La escala platino-cobalto (Pt-Co) y la medición instrumental no son alternativas excluyentes: una lectura instrumental puede expresarse respecto de esa escala. Una unidad Pt-Co se refiere al patrón equivalente a 1 mg/L de platino en la solución normalizada. La espectrofotometría UV-visible mide absorbancia en longitudes de onda especificadas; su empleo en biomoléculas ilustra un principio instrumental, pero no describe automáticamente el protocolo de color de esta agua.
La relación de Beer–Lambert, A = εℓc, vincula absorbancia A, coeficiente de absorción ε, longitud de trayecto ℓ y concentración c bajo sus condiciones de validez. No autoriza a identificar cualquier color ambiental con una sola biomolécula. La longitud de onda satisface λ = v/f: distancia espacial entre estados de igual fase, vinculada con velocidad de propagación y frecuencia.
Los umbrales de color o turbidez y los intervalos de pH citados en una publicación histórica deben identificarse como tales. Tampoco el intervalo de dureza 30–50 mg/L o una temperatura de 9–12 °C constituyen requisitos sanitarios universales. La OMS no fija un valor guía sanitario general para dureza por los niveles habitualmente presentes en el agua de consumo. [6]
El artículo sitúa las mediciones después de sedimentación, mientras denomina al material «agua cruda». Esta descripción requiere precisar el punto de muestreo en una réplica. Las observaciones de 1997 y la publicación de 2005 deben mantenerse diferenciadas. Las muestras fueron obtenidas por Cepeda y Cepeda; esta revisión no recolectó esos datos.
4. Cómo se construyen las respuestas experimentales
4.1. Dosis de sulfato de aluminio
El protocolo histórico utiliza un agitador de cuatro a seis paletas y vasos de 2000 mL. Se aplican dosis crecientes, con mezcla rápida alrededor de 100 rpm durante 30 segundos a 2 minutos; sigue una mezcla más lenta de floculación de 5 a 20 minutos y sedimentación de 5 a 10 minutos. Si se requiere alcalinización, se realiza antes del ensayo de coagulación. Tras medir turbidez y color residuales se selecciona una dosis. Estas condiciones describen el procedimiento de referencia, no un protocolo operacional universal. [1]

En el ejemplo, 40 mg/L es la primera dosis ensayada que cae por debajo de la línea de referencia de 5 NTU y coincide con el mínimo de los puntos representados. Las condiciones comunicadas son turbidez inicial de 200 NTU, color de 100 UC, pH 8.03, alcalinidad de 40 mg/L como CaCO₃ y temperatura de 24 °C. La línea es una referencia del ejemplo histórico: cruzarla no prueba por sí solo potabilidad. Tampoco esos pocos puntos localizan un óptimo continuo exacto entre las dosis ensayadas.
4.2. Polímero y cal
Para estudiar el polímero se modifica su dosis junto con la del sulfato, o se mantiene una fija mientras se varía la otra. Se evalúan turbidez, color, pH residual, tiempo de formación de flóculos e índice de Willcomb, indicador de características del flóculo. El objetivo puede incluir reducir costos bajo criterios de calidad. La expresión histórica «reducir en 75 %» es ambigua respecto de «reducir al 75 %»; una réplica necesita registrar la dosis inicial y final en unidades explícitas.
Para la cal, el procedimiento descrito toma 1000 mL de agua tratada con las dosis seleccionadas de sulfato y polímero. Si el pH es inferior a 7, añade cal hasta alcanzar ese valor. El pH anterior a esa adición corresponde al agua ya tratada; debe distinguirse del pH de entrada usado como predictor. La cantidad añadida define D_CAL en ese protocolo. La documentación debe especificar sustancia, pureza y conversión entre volumen de solución y masa aplicada.
4.3. Concentración de la solución de sulfato
C_SUL describe la concentración de la solución con la que se administra el reactivo; no es la concentración residual de sulfato en el agua final. Una solución de 10 g/L equivale a 1 % masa/volumen: 1 g por 100 mL de solución. Si se mantiene la dosis másica y cambia la concentración, también cambia el volumen de solución añadido.

El ejemplo comunica turbidez inicial de 500 NTU, alcalinidad de 58 mg/L como CaCO₃, pH 7.38 y 27 °C. Su mínimo representado se encuentra cerca de 2 %. La lista de concentraciones del texto original y los valores visibles en el eje no coinciden completamente; tampoco se identifican suficientemente todas las curvas. Ambas limitaciones se conservan como cuestiones documentales. No se reconstruyen datos ni se atribuye significancia estadística a la mera apariencia del gráfico.
5. De la regresión normal al modelo lineal generalizado
Un MLG combina una distribución condicional de la respuesta, un predictor lineal y un enlace. «Lineal» caracteriza la combinación de parámetros en el predictor; no obliga a que todas las relaciones físicas sean rectas ni convierte asociación en causalidad.
Yᵢ representa la respuesta de la observación i; xᵢ reúne sus explicativas; μᵢ es su media condicional; ηᵢ es el predictor; β₀ es el intercepto y βⱼ son los coeficientes. La función g conecta la media con el predictor y su inversa devuelve la media a la escala de la respuesta. El enlace no transforma directamente cada Yᵢ observado. [2]
Esta es una forma usual de la familia exponencial de dispersión: θᵢ es el parámetro canónico, φ controla la dispersión y las funciones a, b y c especifican la familia. En esa parametrización, μᵢ = b′(θᵢ) y Var(Yᵢ | xᵢ) = a(φ)b″(θᵢ). Pertenecer a la familia exponencial no significa necesariamente seguir una distribución exponencial.
En el caso gaussiano con enlace identidad, la media es directamente el predictor lineal. La escritura equivalente Yᵢ = xᵢᵀβ + εᵢ introduce el error aleatorio, con E(εᵢ | X) = 0. Si se postulan normalidad conjunta, independencia y varianza común, el vector satisface ε | X ∼ Nₙ(0, σ²Iₙ): Iₙ es la identidad n × n y σ²Iₙ, no σ² aislado, es la matriz de covarianza.
Con rango completo, mínimos cuadrados ordinarios proporciona β̂ = (XᵀX)⁻¹Xᵀy. Bajo el modelo normal homocedástico coincide con la estimación de máxima verosimilitud de β. La fórmula expresa cómo se proyecta la respuesta sobre el espacio generado por las columnas de X. En la práctica se prefieren métodos numéricos estables, como descomposición QR, a invertir explícitamente XᵀX.
El ajuste general de un MLG puede realizarse mediante mínimos cuadrados iterativamente ponderados —IRLS o IWLS—; en el caso normal con identidad, las ponderaciones se simplifican. La fuente de 2005 no detalla suficientemente el algoritmo de cómputo como para atribuirle aquí una implementación concreta. La documentación de R explica el algoritmo predeterminado de glm(). [3]
6. Modelo I: dosis de sulfato de aluminio
El modelo inicial considera cinco explicativas y un intercepto:
La dosis observada varía alrededor de una media que depende de las propiedades del agua. Después de una eliminación hacia atrás, el estudio comunica el siguiente modelo para esa media, con R² = 0.991. Se mantiene ese valor como resultado publicado, sujeto a la comprobación de consistencia de la sección 10. [1]
Turbidez. A temperatura constante, cada NTU adicional se asocia con 0.085 mg/L más de dosis estimada; 100 NTU corresponden a 8.5 mg/L. Temperatura. A turbidez constante, un incremento de 1 °C se asocia con 1.592 mg/L más. Son asociaciones condicionadas dentro del modelo, sin demostración causal independiente. Intercepto. −13.571 fija la posición de la superficie de regresión; TURB = 0 y TEMP = 0 quedan fuera de los rangos estudiados, por lo que no debe leerse como una dosis físicamente aplicable en ese punto.
Ejemplo didáctico, no observación recuperada: para TURB = 500 y TEMP = 26,
El resultado estima la media condicional de la dosis experimental, no una turbidez residual ni una probabilidad de potabilidad. El artículo interpreta la temperatura en términos de coagulación; esa lectura fisicoquímica necesita distinguirse del signo del coeficiente y de las condiciones térmicas y de mezcla concretas. No se deduce de la ecuación una ley universal según la cual enfriar el agua siempre mejore el tratamiento.
7. Modelo II: concentración de la solución de sulfato
La formulación inicial incorpora dureza, además de las cinco propiedades anteriores:
Se comunica R² = 0.530 para ese modelo y valores p individuales superiores a 0.05. Después de la reducción se publica:
El modelo reducido tiene R² = 0.413; se informan p = 0.133 para el intercepto y p = 0.003 para la pendiente. El cambio de significancia entre modelos no es una contradicción automática: al retirar regresoras cambian las estimaciones, su varianza y los contrastes condicionados. La fuente no detalla suficientemente toda la trayectoria de selección. [1]
Si C_SUL se expresa en porcentaje, un incremento de una unidad de pH se asocia con 0.445 puntos porcentuales, no con un aumento relativo de 44.5 %. Una unidad de pH representa un cambio de un factor diez en actividad de H⁺, lo que ayuda a entender que la escala del predictor es logarítmica.
Para PH = 8, el cálculo ilustrativo es:
El intervalo de pH documentado es 7.1–8.33. El modelo explica una parte de la variación observada; R² = 0.413 no representa una probabilidad de acierto de 41.3 %. La concentración predicha tampoco determina por sí sola cuánto reactivo se añade: hace falta combinar concentración y volumen.
El intercepto no se elimina simplemente porque su valor p exceda 0.05. Forzar la recta a pasar por el origen impone C_SUL = 0 cuando PH = 0, muy lejos del dominio de estudio y sin justificación física proporcionada. Retenerlo preserva una parametrización razonable para el intervalo observado; demostrar una mejora predictiva requeriría comparar modelos con datos.
8. Modelo III: dosis de cal y corrección de transcripción
La formulación inicial retoma las cinco explicativas:
La fuente comunica R² = 0.930 para el modelo inicial y R² = 0.915 para el reducido; este último retiene turbidez, color y pH, con valores p reportados inferiores a 0.01:
A igualdad de las otras explicativas, 100 NTU adicionales se asocian con 1.262 unidades más de dosis; 10 UC adicionales, con 0.7746 unidades; y un aumento de 0.1 en pH, con 0.8831 unidades menos. El signo negativo del pH es compatible con una menor necesidad de corrección alcalina cuando el agua de entrada tiene mayor pH, pero no sustituye el análisis del proceso ni del pH posterior a coagulación.
Para TURB = 500, COL = 100 y PH = 8:
El resultado se expresa en las unidades de dosis de D_CAL del registro. La fuente examinada no desarrolla con la misma claridad su convención de medición que la dosis de sulfato; no se añade aquí una conversión no documentada. Este ejemplo es aritmético, no una observación recuperada ni una recomendación de dosificación.
Una restricción física que la recta no impone
Con TURB = 200, COL = 50 y PH = 8.33, la ecuación devuelve −7.79123. Aunque cada valor pertenece a su rango marginal, no sabemos si esa combinación fue observada. Una cantidad negativa de cal carece de interpretación como adición física. El resultado señala límites del dominio o de la especificación; no demuestra que la muestra original contuviera dosis negativas.
Reemplazar automáticamente ese valor por cero crea una regla adicional que requiere justificación y validación. Si hubiera muchos ceros junto con dosis positivas, podría investigarse un modelo de dos etapas —probabilidad de aplicación y cantidad condicionada a aplicación—. Para respuestas estrictamente positivas podrían compararse familias y enlaces apropiados, como Gamma con enlace logarítmico. Son líneas de investigación, no modelos estimados aquí.
9. Selección de variables e inferencia
Contrastes individuales, globales y parciales
Un contraste individual evalúa, por ejemplo, H₀: βⱼ = 0 frente a H₁: βⱼ ≠ 0, condicionando por los demás términos incluidos. Un contraste global puede evaluar que todas las pendientes sean cero. Un contraste parcial también puede comparar un bloque de coeficientes, no únicamente uno.
En modelos gaussianos anidados, SSE_R y SSE_F son sumas de cuadrados residuales del modelo reducido y completo; p_R y p_F cuentan coeficientes, incluido el intercepto, y n es el número común de observaciones. El numerador mide el incremento de error por restricción, por coeficiente retirado; el denominador estima la varianza residual. Bajo las condiciones del modelo y la hipótesis nula, el estadístico sigue una F con p_F − p_R y n − p_F grados de libertad. Para una sola restricción, F = t² en el contraste equivalente. Comparar muestras diferentes invalida esta interpretación. [4]
Un valor p no es la probabilidad de que la hipótesis nula sea verdadera, ni el tamaño del efecto ni la probabilidad de acertar una predicción. Un resultado no significativo tampoco prueba que una variable carezca de relevancia química.
Alcance de la eliminación hacia atrás
El procedimiento empieza con un conjunto de términos y elimina algunos según un criterio. En el primer modelo se comunica un umbral de 0.01. La afirmación de que los valores p finales son menores que 0.01 corresponde a los parámetros retenidos, no debe trasladarse a las variables descartadas. En los otros modelos, la documentación no permite reconstruir todos los pasos o umbrales.
La expresión «sin pérdida de información» requiere precisar si se refiere a ajuste, contraste entre modelos, criterio de información o rendimiento predictivo. La selección puede producir inestabilidad y valores p posteriores demasiado optimistas si se ignora que el modelo fue elegido con los mismos datos. Conviene presentar magnitudes, incertidumbre y validación, además del umbral.
No se atribuye aquí el origen de los contrastes parciales a publicaciones de 2018: la fuente de 2005 ya usa esa expresión. Se retira como respaldo la referencia de Li y colaboradores (2009) sobre partial hypothesis re-ranking, porque allí las hipótesis son traducciones parciales candidatas dentro de un sistema de traducción automática, no contrastes parciales de regresión. [8]
10. Correlación, ajuste y una inconsistencia pendiente
| Variable | TURB | COL | ALCA | PH | TEMP |
|---|---|---|---|---|---|
| D_SUL | 0.978** | 0.517** | −0.196 | 0.133 | −0.266 |
| TURB | 1 | 0.485** | −0.119 | 0.156 | −0.337* |
| COL | — | 1 | −0.448** | 0.048 | −0.046 |
| ALCA | — | — | 1 | −0.207 | 0.181 |
| PH | — | — | — | 1 | −0.408* |
** y * identifican significancia bilateral de 0.01 y 0.05, respectivamente, según la fuente. Los guiones completan la parte triangular omitida; no representan correlaciones nulas. La tabla no incluye dureza.
La asociación simple más elevada con D_SUL es la de turbidez, r = 0.978. La correlación simple entre dosis y temperatura es −0.266, aunque el coeficiente de temperatura del modelo múltiple es positivo. Una correlación marginal resume la relación sin mantener otras variables constantes; un coeficiente parcial expresa una relación condicionada. La diferencia de signos puede aparecer al controlar la estructura conjunta y no prueba, por sí misma, error o causalidad.
Para mínimos cuadrados ordinarios con intercepto, SSE mide la variación que permanece en los residuos y SST la variación de la respuesta alrededor de su media. R² expresa la fracción de esa variación recogida por el ajuste. Al añadir regresoras, el R² ordinario no disminuye; por eso no basta para comparar complejidades ni para demostrar capacidad predictiva. Un R² alto puede coexistir con mala especificación, heterocedasticidad, dependencia o extrapolación. [5]
Comprobación algebraica reproducible
Si la tabla corresponde exactamente a las observaciones del modelo reducido de sulfato, ajustado por mínimos cuadrados ordinarios con intercepto y sin ponderaciones, el R² puede reconstruirse a partir de las correlaciones:
Aquí T representa turbidez y θ temperatura, solo para abreviar esta identidad. Al introducir 0.978, −0.266 y −0.337, se obtiene R² ≈ 0.961045, frente al 0.991 publicado. El cálculo es una deducción de las cifras impresas; no es una reestimación con microdatos. La diferencia no se explica simplemente por redondear el resultado a tres decimales.
Faltan los datos y la trazabilidad del ajuste para identificar su causa: errata, diferencias entre muestras, ponderaciones u otra particularidad. Se conserva 0.991 como valor publicado y se informa la incompatibilidad bajo las condiciones indicadas, sin sustituirlo por un resultado presentado como definitivamente validado.
El descenso de R² de 0.530 a 0.413 en concentración, y de 0.930 a 0.915 en cal, describe modelos distintos con respuestas distintas. No debe convertirse en un ranking directo de su utilidad operacional. Harían falta errores de predicción en las unidades de cada respuesta y criterios de uso explícitos.
11. Supuestos: qué está especificado y qué puede comprobarse
Una auditoría debe separar especificación —lo que el modelo supone—, evidencia presentada —lo que el artículo muestra— y reproducibilidad —lo que otro investigador puede comprobar con los materiales disponibles—. La ausencia de un diagnóstico publicado no prueba incumplimiento; una fórmula que postula normalidad tampoco acredita su cumplimiento.
| Aspecto | Formulación pertinente | Evaluación propuesta |
|---|---|---|
| Coherencia dimensional | No se requieren unidades iguales. Cada coeficiente convierte la escala de su predictor a la de la respuesta. | Documentar unidades y calibración; estandarizar solo si resulta útil y conservar la interpretación. |
| Identificabilidad | Para coeficientes únicos se requiere rango completo de X, incluida la columna del intercepto. | Rango o QR, VIF y condicionamiento; correlaciones por pares no descartan dependencias multivariadas. |
| Media condicional | μ(X) depende de X; no se exige que sea independiente de X. En el modelo aditivo, E(ε | X) = 0. | Justificación del diseño y variables relevantes; un contraste de correlación aislado no verifica exogeneidad. |
| Familia y dispersión | La hipótesis distribucional es sobre Y | X. En estos modelos: normalidad condicional y varianza constante. | Residuos frente a ajustados y explicativas; gráfico cuantiles normales, escala-localización y evaluación contextual. |
| Enlace y forma funcional | Se modela g(μ) = Xβ. La linealidad es en parámetros y puede incluir transformaciones justificadas. | Patrones residuales, términos no lineales o interacciones y comparación de modelos; RESET es una herramienta parcial. |
| Dependencia | El MLG ordinario postula independencia condicional entre observaciones; no resuelve por sí solo la autocorrelación. | Fechas, lotes, muestreo y gráficos temporales; si procede, ACF y modelos o errores estándar adecuados a la dependencia. |
| Tamaño y estabilidad | No hay una regla general del 20 % de unidades con menos de cinco observaciones. | Número efectivo de observaciones frente a parámetros, precisión, cobertura, influencia y validación. |
La matriz de correlaciones constituye evidencia descriptiva real y debe reconocerse como tal. Sin embargo, no proporciona todo el diseño, las respuestas individuales ni los residuos necesarios para una auditoría completa. Un chi-cuadrado de independencia no es una prueba genérica de rango completo de X. Spearman y Kendall describen asociaciones de orden, no verifican por sí solos independencia lineal ni exogeneidad.
En el modelo normal, los residuos e = y − ŷ permiten buscar patrones, pero no son los errores poblacionales observados. Incluso con errores independientes, sus restricciones por ajuste producen Cov(e | X) = σ²(I − H), donde H es la matriz de proyección. Por eso se examina estructura compatible con dependencia del proceso, sin exigir literalmente que todos los residuos ajustados sean independientes.
La condición de varianza constante sí forma parte de la especificación gaussiana simple aquí reproducida. Puede relajarse con una estructura de dispersión apropiada o métodos de inferencia adecuados, pero la palabra «generalizado» no valida automáticamente cualquier heterogeneidad. La normalidad de errores se refiere a inferencia normal exacta; calcular mínimos cuadrados no requiere que el histograma marginal de Y sea normal. [5]
Tamaño muestral y representatividad
El modelo inicial de concentración usa 20 observaciones para seis pendientes y un intercepto: si no hay datos perdidos y X tiene rango completo, quedan 13 grados de libertad residuales. Esa cuenta advierte sobre precisión e inestabilidad, pero no demuestra que el modelo sea inválido. Las inferencias normales pueden ser exactas con muestras pequeñas si se cumplen sus condiciones; otros MLG dependen más de aproximaciones asintóticas.
La regla de celdas con frecuencias esperadas pequeñas concierne a ciertas aproximaciones chi-cuadrado, no a «observaciones dentro de unidades muestrales» de toda regresión. [7] La representatividad depende del diseño y de la cobertura temporal y material; aumentar n no corrige automáticamente sesgos de selección.
En una repetición solicitaría identificador de muestra, fecha y orden, punto de captación, calibración, condiciones del ensayo, lote de reactivo, unidades y registros completos. Examinaría influencia y apalancamiento, además de residuos. Sin esa información, la conclusión proporcionada es que la validación independiente resulta incompleta.
12. Predicción, incertidumbre y uso operacional
Una predicción puntual debe acompañarse de una pregunta concreta: ¿se estima la media del proceso bajo ciertas condiciones o la respuesta de una nueva muestra? Para un modelo normal homocedástico con intercepto, pueden distinguirse:
x₀ contiene el intercepto y los predictores del nuevo caso, p cuenta coeficientes y s estima la desviación estándar residual. El primer intervalo cuantifica incertidumbre sobre la media. El segundo añade la variación de una observación nueva —el término 1— y es más amplio bajo las mismas condiciones. No incorporan automáticamente incertidumbre de selección de variables, medición ni cambios de proceso. [9]
Los coeficientes y R² impresos no bastan para construir esos intervalos: se necesita la varianza residual y la estructura del diseño o la covarianza de los estimadores. Tampoco permiten recuperar los residuos originales. Por ello, esta edición calcula ejemplos puntuales y deja explícito que sus intervalos no pueden reconstruirse con la documentación disponible.
La validación propuesta debe medir error absoluto y cuadrático en las unidades de la respuesta, calibración y estabilidad. Si las muestras se suceden en el tiempo, reservar periodos posteriores o utilizar particiones temporales evita evaluar como nueva información demasiado semejante a la usada en el ajuste. Toda selección y transformación debe realizarse dentro del conjunto de entrenamiento pertinente.
Los ensayos de jarras siguen proporcionando una referencia experimental ante cambios de agua y operación. Aplicar un modelo a otra planta exige revisar equipos, reactivos, calibración y dominio de predictores y validar con observaciones locales. La salida estadística es un elemento de apoyo a una decisión técnica documentada.
13. Medición, cantidad y cualidad
La relación entre cantidad y cualidad puede precisarse distinguiendo cuatro planos: el proceso material; el instrumento y su procedimiento de medición; la escala con que se expresa la lectura; y la clasificación u operación que se decide a partir de ella. El color del agua no es idéntico al número que entrega un instrumento, pero ese número tampoco es arbitrario: resulta de una interacción física sometida a calibración y convenciones explícitas.
Una variación cuantitativa puede alterar condiciones de coagulación, formación de flóculos o eficacia de un tratamiento. Sin embargo, cruzar un umbral administrativo de aceptabilidad no demuestra por sí mismo una transición de fase ni una ruptura topológica. Una tesis de ese alcance exigiría definir estados, relaciones y mecanismos que hagan pertinente esa descripción matemática.
La totalidad organizada condiciona el significado de sus componentes. En una distribución de probabilidad, los valores posibles y las probabilidades asignadas forman una estructura: conocer un valor aislado no determina su frecuencia ni su posición relativa. En una regresión ocurre algo relacionado, aunque no idéntico: el coeficiente parcial de temperatura depende del sistema de variables que se mantiene constante. Esto ayuda a interpretar la diferencia entre correlación simple y asociación condicionada sin convertir una analogía filosófica en prueba estadística.
El alcance epistemológico del caso reside en vincular objeto, medición, modelo y práctica. El conocimiento se vuelve más sólido cuando explicita tanto sus mediaciones como las condiciones que podrían refutar o limitar sus conclusiones.
14. Apéndice reproducible en R
El primer bloque evalúa las ecuaciones publicadas y el cálculo de consistencia de R². Los resultados son aritmética reproducible, sin ajuste nuevo. El bloque if (FALSE) es una plantilla desactivada: requiere las observaciones reales y no inventa un archivo ni una base de datos. La comprobación de rangos marginales tampoco verifica soporte conjunto.
# Aritmética didáctica: ecuaciones publicadas, sin reestimación.
predict_reported <- function(TURB, COL, PH, TEMP) {
  z <- list(TURB = TURB, COL = COL, PH = PH, TEMP = TEMP)
  valid <- vapply(z, function(v) is.numeric(v) &&
    length(v) == 1L && is.finite(v), logical(1))
  if (!all(valid)) {
    stop("Proporcione cuatro escalares numéricos finitos.")
  }
  marginal <- TURB >= 200 && TURB <= 1200 &&
    COL >= 50 && COL <= 250 &&
    PH >= 7.1 && PH <= 8.33 &&
    TEMP >= 24 && TEMP <= 28
  lime <- 59.374 + 0.01262*TURB + 0.07746*COL - 8.831*PH
  data.frame(
    sulfate_mg_L = -13.571 + 0.085*TURB + 1.592*TEMP,
    solution_percent = -1.597 + 0.445*PH,
    lime_recorded_units = lime,
    inside_marginal_ranges = marginal,
    negative_lime_prediction = lime < 0
  )
}
predict_reported(TURB = 500, COL = 100, PH = 8, TEMP = 26)
# 70.321 mg/L; 1.963 por ciento; 2.782 unidades de dosis de cal.
# Los rangos marginales no demuestran soporte conjunto.

# Reconstruir R cuadrado desde las correlaciones publicadas.
r_yx <- c(0.978, -0.266)
R_xx <- matrix(c(1, -0.337, -0.337, 1), nrow = 2)
drop(crossprod(r_yx, solve(R_xx, r_yx)))
# Aproximadamente 0.9610452, bajo las condiciones MCO indicadas.

# PLANTILLA: desactivada hasta disponer de observaciones reales.
if (FALSE) {
  # sulfate_data debe contener estas variables medidas.
  full <- lm(D_SUL ~ TURB + COL + ALCA + PH + TEMP,
             data = sulfate_data, na.action = na.fail)
  reduced <- update(full, . ~ TURB + TEMP)
  anova(reduced, full, test = "F")
  X <- model.matrix(full)
  c(rank = qr(X)$rank, columns = ncol(X))
  par(mfrow = c(2, 2))
  plot(reduced)
  new_case <- data.frame(TURB = 500, TEMP = 26)
  predict(reduced, new_case, interval = "confidence")
  predict(reduced, new_case, interval = "prediction")
  # Esta especificación reducida es ilustrativa; no interpretar
  # estos comandos como réplica de la selección no documentada.
}
Los gráficos y contrastes de la plantilla deben interpretarse junto con el diseño. Una futura réplica tendría que documentar la selección y validación desde el inicio, conservar los conjuntos de datos de cada respuesta y comunicar incertidumbre e influencia. Las instrucciones no constituyen una afirmación de que esos análisis se hayan ejecutado sobre los registros históricos.
15. Conclusiones y alcance de esta edición
El caso muestra cómo relacionar mediciones del agua con respuestas seleccionadas experimentalmente mediante modelos gaussianos con enlace identidad. Su utilidad pedagógica reside tanto en interpretar coeficientes como en examinar las condiciones de inferencia. Predecir una dosis, determinar experimentalmente una dosis y acreditar la seguridad del agua son tareas relacionadas con evidencias y criterios diferentes.
La revisión conserva los tres modelos, las figuras y la matriz de correlaciones; corrige el coeficiente de pH de la cal; distingue la media condicional de la respuesta observada; reconstruye la discusión de supuestos y explicita la inconsistencia condicionada de R². Los ejemplos nuevos y las propuestas de diagnóstico se identifican como tales. Sin los datos originales no se certifica la validez empírica de los ajustes ni se recuperan intervalos o residuos.
Nota editorial. Publicación original: 25 de septiembre de 2021. Revisión ampliada: 2 de noviembre de 2026. Autor: JOSÉ MAURICIO GÓMEZ JULIÁN. El PDF histórico aparece bajo el nombre Isadore Nabi. Se normalizan TEMP/TEM, se corrige «lima» por «cal», se renumeran figuras y se depuran repeticiones. La referencia histórica de APHA citada por Cepeda y Cepeda corresponde a 1985, no a 1995. Las referencias sobre splines no sustentan una prioridad histórica de los contrastes parciales; el trabajo de traducción automática se identifica por su función documental, sin usarlo como fundamento estadístico. Las fuentes posteriores a 2021 pertenecen a esta revisión.
Referencias y fuentes documentales
- Cepeda, Z. & Cepeda C., E. (2005). Application of Generalized Linear Models to Data Analysis in Drinking Water Treatment. Revista Colombiana de Estadística, 28(2), 233–242.https://distantreader.org/stacks/journals/estad/estad-28883.pdf
- R Core Team. Family Objects for Models. Documentación oficial: familias, enlaces y funciones de varianza.https://search.r-project.org/R/refmans/stats/html/family.html
- R Core Team. Fitting Generalized Linear Models. Documentación oficial.https://search.r-project.org/R/refmans/stats/html/glm.html
- R Core Team. ANOVA for Linear Model Fits. Comparación de modelos anidados.https://search.r-project.org/R/refmans/stats/html/anova.lm.html
- NIST/SEMATECH. e-Handbook of Statistical Methods, §4.4.4, “How can I tell if a model fits my data?”; véanse también “Regression Diagnostics”.https://www.itl.nist.gov/div898/handbook/pmd/section4/pmd44.htm
- World Health Organization (2026). Guidelines for drinking-water quality: fourth edition incorporating the first, second and third addenda. Complemento: Hardness chemical fact sheet.https://www.who.int/publications/i/item/9789240121225
- NIST/SEMATECH. e-Handbook of Statistical Methods, §1.3.5.15, “Chi-Square Goodness-of-Fit Test”.https://www.itl.nist.gov/div898/handbook/eda/section3/eda35f.htm
- Li, M., Duan, N., Zhang, D., Li, C.-H. & Zhou, M. (2009). Collaborative Decoding: Partial Hypothesis Re-ranking Using Translation Consensus between Decoders. ACL-IJCNLP, 585–592. Referencia documental de la corrección.https://aclanthology.org/P09-1066/
- R Core Team. Predict method for Linear Model Fits. Intervalos de confianza y predicción.https://search.r-project.org/R/refmans/stats/html/predict.lm.html
- Gómez Julián, J. M. (2021, publicado como Isadore Nabi). Un caso de estudio sobre las aplicaciones de los modelos de regresión lineal: análisis de tratamientos para potabilización del agua mediante modelos lineales generalizados, parte I. Ensayo histórico.https://marxistphilosophyofscience.com/wp-content/uploads/2021/09/un-caso-de-estudio-sobre-las-aplicaciones-de-los-modelos-lineales-generalizados-isadore-nabi.pdf
- Abril Díaz, N. y colaboradores. Espectrofotometría: espectros de absorción y cuantificación colorimétrica de biomoléculas. Universidad de Córdoba. Fuente instrumental histórica.https://www.uco.es/dptos/bioquimica-biol-mol/pdfs/08_ESPECTROFOTOMETRIA.pdf
- Pérez de la Cruz, F. J. & Urrea Mallebrera, M. A. Abastecimiento de aguas. Coagulación y floculación. Universidad Politécnica de Cartagena. Fuente histórica.https://ocw.bib.upct.es/pluginfile.php/6019/mod_resource/content/1/Tema_06_COAGULACION_Y_FLOCULACION.pdf
- Bermúdez Cabrera, X., Fleites Ramírez, M. & Contreras Moya, A. M. (2009). Estudio del proceso de coagulación-floculación de aguas residuales de la empresa textil “Desembarco del Granma” a escala de laboratorio. Tecnología Química, 29(3), 64–73. Contexto de procesos.https://www.redalyc.org/pdf/4455/445543760009.pdf
- Domènech, X. & Peral, J. (2006). Química ambiental de sistemas terrestres. Reverté. Referencia bibliográfica histórica.
- American Public Health Association (1985). Standard Methods for the Examination of Water and Wastewater. Edición citada por la fuente de 2005.
- World Health Organization (2009). Tratamiento de emergencia del agua potable en el lugar de consumo. Fuente histórica sobre etapas de tratamiento.http://bvsper.paho.org/share/ETRAS/AyS/texcom/desastres/opsguia5.pdf
- Gómez Julián, J. M. (2021, como Isadore Nabi). Modelos lineales generalizados. Antecedente del ensayo.https://marxistphilosophyofscience.com/wp-content/uploads/2021/08/modelos-lineales-generalizados-isadore-nabi.pdf
- Gómez Julián, J. M. (2021, como Isadore Nabi). Supuestos del modelo clásico de regresión lineal y de los modelos lineales generalizados. Antecedente histórico, sujeto a las precisiones de esta edición.https://marxianstatistics.com/2021/09/24/supuestos-del-modelo-clasico-de-regresion-lineal-y-de-los-modelos-lineales-generalizados/
- NIST. Regression Diagnostics. Multicolinealidad y herramientas de evaluación.https://itl.nist.gov/div898/software/dataplot/refman1/auxillar/regrdiag.htm
Leave a Comment/Deja un Comentario