Marxist Philosophy of Science · Estadística matemática
Supuestos del Modelo Clásico de Regresión Lineal y de los Modelos Lineales Generalizados
Fundamentos, Garantías, Diagnóstico y Ejemplos Reproducibles en R
01Qué suponen los modelos y qué permiten concluir
Un modelo de regresión conecta una pregunta sobre la realidad con una representación matemática de la distribución de una respuesta. Sus supuestos establecen las condiciones bajo las cuales ciertas conclusiones son justificables. Comprenderlos exige distinguir la existencia de un ajuste, las propiedades de los estimadores, la validez de la inferencia y la capacidad predictiva.
Este artículo desarrolla el modelo clásico de regresión lineal y los modelos lineales generalizados (MLG) desde sus fundamentos geométricos, algebraicos y probabilísticos. Integra el diagnóstico aplicado con una precaución metodológica: ningún procedimiento estadístico convierte por sí solo una asociación en una explicación causal. El tipo de medición, el diseño de investigación y las condiciones históricas y materiales del fenómeno siguen formando parte del problema científico.
Una variable explicativa puede ser continua, categórica o una transformación de otra variable. La respuesta también puede adoptar formas distintas. La tarea consiste en hacer compatibles la pregunta, el soporte de los datos, la función de media y la incertidumbre que se atribuye al proceso.
02De Galton a la inferencia contemporánea
Francis Galton empleó la regresión para estudiar semejanzas de estatura entre generaciones. Sus trabajos de 1886, Regression towards mediocrity in hereditary stature y Family likeness in stature, preceden a Natural Inheritance (1889). En este contexto, «mediocridad» alude a la posición media, no a una valoración de las personas. El fenómeno relevante es que, al seleccionar progenitores de estaturas extremas, la estatura media de sus descendientes puede ser menos extrema. [1]
La regresión hacia la media no exige que cada descendiente se acerque al promedio ni constituye una ley de progreso biológico. En variables estandarizadas conjuntamente normales, la media condicional tiene la forma E(ZY|ZX=z)=ρz: cuando |ρ|<1, su magnitud es menor que |z|. Esta identidad ilustra el mecanismo bajo ese modelo; no generaliza automáticamente a cualquier distribución.
Karl Pearson y Alice Lee ampliaron el estudio cuantitativo de la herencia. Ronald A. Fisher desarrolló herramientas de estimación, diseño experimental y pruebas de significación; Jerzy Neyman y Egon Pearson formularon un enfoque de contraste orientado al control de errores en muestreo repetido. Sus diferencias metodológicas importan más aquí que las anécdotas personales.
La sigla NHST corresponde a null hypothesis significance testing. Perezgonzalez analiza críticamente las combinaciones habituales de las tradiciones de Fisher y de Neyman–Pearson. Conviene atribuir esa interpretación y distinguir un valor p, un nivel α y la potencia, en lugar de tratarlos como objetos intercambiables. [2]
03Población, muestra y notación
Una distribución poblacional describe variación posible; una muestra contiene realizaciones observadas. Un parámetro pertenece al modelo poblacional; un estimador es una función de la muestra; una estimación es su valor calculado. Un estadístico no es necesariamente un estadístico de prueba: la media muestral también es un estadístico.
| Símbolo | Significado |
|---|---|
| n | Número de observaciones. |
| p | Número total de coeficientes de regresión, incluido el intercepto. |
| X, xiT | Matriz de diseño n × p y su fila i. |
| β, β̂ | Vector poblacional de coeficientes y su estimador. |
| ui, ûi | Perturbación no observada y residuo calculado. |
| μi, ηi | Media condicional y predictor lineal. |
| σ², φ, Ω | Varianza escalar, dispersión de un MLG y matriz de covarianzas de los errores. |
La matriz X incorpora la codificación de factores, las potencias y las interacciones que se hayan especificado. Una variable categórica con varios niveles suele aportar varias columnas; por eso el número de variables originales no coincide necesariamente con p. Cuando hay intercepto, una columna de X está formada por unos.
04Modelo, pérdida, estimación y algoritmo
La regresión modela alguna característica de Y condicionada a información X. En el caso lineal de media, la formulación compacta es:
Y es el vector de respuestas aleatorias; Xβ representa su media condicional bajo la especificación; u reúne las desviaciones respecto de esa media. Escribir una ecuación no identifica automáticamente un mecanismo causal. La perturbación puede reflejar variabilidad individual, medición imperfecta y factores no incorporados, pero su relación con X debe justificarse.
Un criterio de pérdida valora discrepancias. MCO minimiza la suma de residuos al cuadrado. La regresión por desviaciones absolutas minimiza su suma absoluta; en el problema poblacional sin restricciones, la pérdida cuadrática apunta a una media condicional y la absoluta a una mediana condicional. Bajo restricciones paramétricas, se obtiene la mejor aproximación dentro de la clase especificada.
La estimación puede basarse en mínimos cuadrados, máxima verosimilitud, momentos, cuasiverosimilitud o métodos bayesianos. Un algoritmo, como QR o una iteración de Newton, permite calcular el resultado. Dos algoritmos pueden resolver el mismo criterio, y un modelo puede estimarse con distintos criterios.
Unir los puntos extremos, promediar pendientes entre pares o equilibrar la cantidad de puntos por encima y por debajo son construcciones geométricas posibles, pero no aseguran identificación, estabilidad ni buenas propiedades estadísticas. La condición de equilibrar signos tampoco determina por sí sola una recta única. Para hablar de «mejor ajuste» siempre hay que declarar respecto de qué pérdida y con qué restricciones.
‖r‖∞ = maxi|ri|(02)
L2(r)=∑ri2=‖r‖22(03)
Aquí r es un vector de residuos y q es el orden de la norma, distinto del número p de coeficientes. La raíz 1/q es parte de la definición de norma. La suma de cuadrados es el cuadrado de la norma euclídea: no es una norma, aunque ambas tengan los mismos minimizadores. Para 0<q<1 la expresión correspondiente no satisface, en general, la desigualdad triangular de una norma.
Sumar discrepancias supone que las unidades y las ponderaciones resultan comparables. La independencia no es un requisito para definir una norma; sí puede ser una condición del modelo probabilístico usado para justificar un procedimiento inferencial. Tampoco todo criterio de discrepancia de un MLG es una norma o una distancia métrica.
05Qué significa «lineal»
En una regresión simple, el intercepto β0 es la altura de la media cuando x=0, si ese valor pertenece al dominio pertinente. La pendiente β1 indica el cambio de la media por unidad de x:
La definición general de modelo lineal se refiere a sus coeficientes. El siguiente modelo describe una parábola y sigue siendo lineal en β:
Sus columnas de diseño son 1, x y x². También son admisibles log x, indicadores de grupos e interacciones, siempre que las transformaciones estén definidas y los coeficientes entren linealmente. Una función con intercepto es, estrictamente, afín en las variables; el uso estadístico de «lineal» incluye ese intercepto.
En cambio, una media β0+exp(β1x) es no lineal en β1. Los mínimos cuadrados no lineales constituyen otro problema de optimización. La diferencia se refiere a la parametrización, no a si la gráfica parece una curva.
La tercera situación de la figura muestra por qué una correlación lineal pequeña puede coexistir con una asociación intensa y curva. Un ajuste lineal en las variables originales puede ser inadecuado, mientras que uno polinómico, todavía lineal en parámetros, capture la forma de la media. Elegir términos adicionales requiere teoría y validación, no solo inspección del ajuste muestral.
06MCO: optimización, proyección y verosimilitud
El problema que se minimiza
Para cada candidato b se calculan predicciones xiTb, se restan de los valores observados y se suman los cuadrados. Elevar al cuadrado evita la cancelación de signos y penaliza más las desviaciones grandes. La derivada de ‖y−Xb‖² respecto de b es −2XT(y−Xb). Igualarla a cero produce las ecuaciones normales:
β̂ = (XTX)−1XTy(07)
La expresión con inversa requiere rango columna completo: rank(X)=p. Es una fórmula analítica, no una recomendación de programación. En cálculo numérico, QR y SVD evitan formar o invertir innecesariamente XTX, operación que empeora el condicionamiento. [3]
La interpretación geométrica
XTû = 0(08)
El vector ajustado es la proyección ortogonal de y sobre el espacio generado por las columnas de X. H es la matriz de proyección y û=y−ŷ. La ortogonalidad XTû=0 resulta del criterio de MCO: no demuestra independencia probabilística ni exogeneidad. Con intercepto, se obtiene además ∑ûi=0.
En cada observación, la desviación respecto de la media se descompone en componente ajustado y residuo. Al elevar al cuadrado y sumar, el término cruzado se anula por ortogonalidad. Con intercepto y MCO no ponderado, SST=∑(yi−ȳ)², SSR=∑(ŷi−ȳ)² y SSE=∑ûi². Las abreviaturas varían entre textos; aquí quedan definidas explícitamente.
Se requiere SST>0. R² resume ajuste dentro de la muestra; no verifica causalidad, exogeneidad ni capacidad predictiva. Añadir columnas a modelos anidados sobre la misma muestra no aumenta SSE y, por tanto, no reduce R². El R² ajustado aplica una penalización por grados de libertad, pero tampoco sustituye la validación externa.
Cuándo coincide con máxima verosimilitud
Si, condicionalmente a X, los errores son normales independientes con varianza común σ², la log-verosimilitud es:
− [1/(2σ2)] ∑i=1n(yi − xiTb)2(11)
Para σ² fija y positiva, maximizar ℓ en b equivale a minimizar SSE, porque el resto es constante respecto de b y su coeficiente es negativo. Al estimar conjuntamente σ² se mantiene la solución MCO para β, siempre que el máximo regular exista. En el caso normal, su estimación de máxima verosimilitud es SSE/n, mientras que SSE/(n−p) corrige el sesgo para la varianza. La distinción importa.
07Exogeneidad: el significado de la media condicional nula
Las regresoras pueden considerarse fijas en un diseño experimental o aleatorias cuando se muestrean junto con la respuesta. Condicionar en X permite analizar ambas situaciones con una estructura común, pero una X fija no elimina por sí sola una media de error mal especificada. Para el argumento clásico de insesgamiento se exige E(u|X)=0.
Esta condición dice que, conocida la matriz de diseño completa, las perturbaciones no presentan una desviación media sistemática. No exige que todos los errores observados sean cero ni que cada submuestra tenga promedio exactamente nulo. Si el diseño es aleatorio, implica E(u)=0 por esperanza iterada y, con momentos apropiados, ortogonalidad respecto de las funciones de X.
La primera igualdad se obtiene sustituyendo y=Xβ+u en la fórmula de MCO. Una vez condicionamos en X, la matriz que multiplica a u es fija; por ello su esperanza es cero. Así, la media de β̂ sobre repeticiones del muestreo coincide con β. Nada en esta demostración requiere homocedasticidad o normalidad.
Independencia, covarianza y media condicional
La independencia entre X y U, junto con E(U)=0, implica E(U|X)=0. Sin embargo, una covarianza cero no implica independencia ni media condicional nula. El siguiente contraejemplo lo hace visible:
Cov(X,U)=0, E(U|X)=X2−1/3 ≠ 0(13)
Por simetría, E(X)=E(X³)=0 y E(X²)=1/3, de modo que la covarianza es cero. Aun así, U depende determinísticamente de X y su esperanza condicional cambia con X. Es posible que una pendiente concreta resulte insesgada bajo condiciones más débiles; eso no convierte covarianza cero e independencia en conceptos equivalentes.
Cómo puede fallar y cómo se investiga
Una variable omitida relacionada con X, la determinación simultánea de respuesta y explicativas, ciertos errores de medición o la selección de observaciones pueden generar endogeneidad. Las consecuencias dependen de la estructura concreta. En series temporales, E(u|X)=0 condiciona en todo el diseño y suele ser más fuerte que una condición contemporánea E(ut|xt)=0.
Los gráficos de residuos pueden revelar incompatibilidades de forma funcional; no verifican que estén ausentes todos los factores omitidos. La exogeneidad se sostiene con argumentos de diseño, temporalidad, medición y teoría. Instrumentos, experimentos u otras estrategias de identificación requieren supuestos adicionales; cambiar los errores estándar no resuelve la endogeneidad.
08Gauss–Markov, precisión e inferencia
Una formulación condicional del teorema reúne las siguientes condiciones, con σ² positiva y finita:
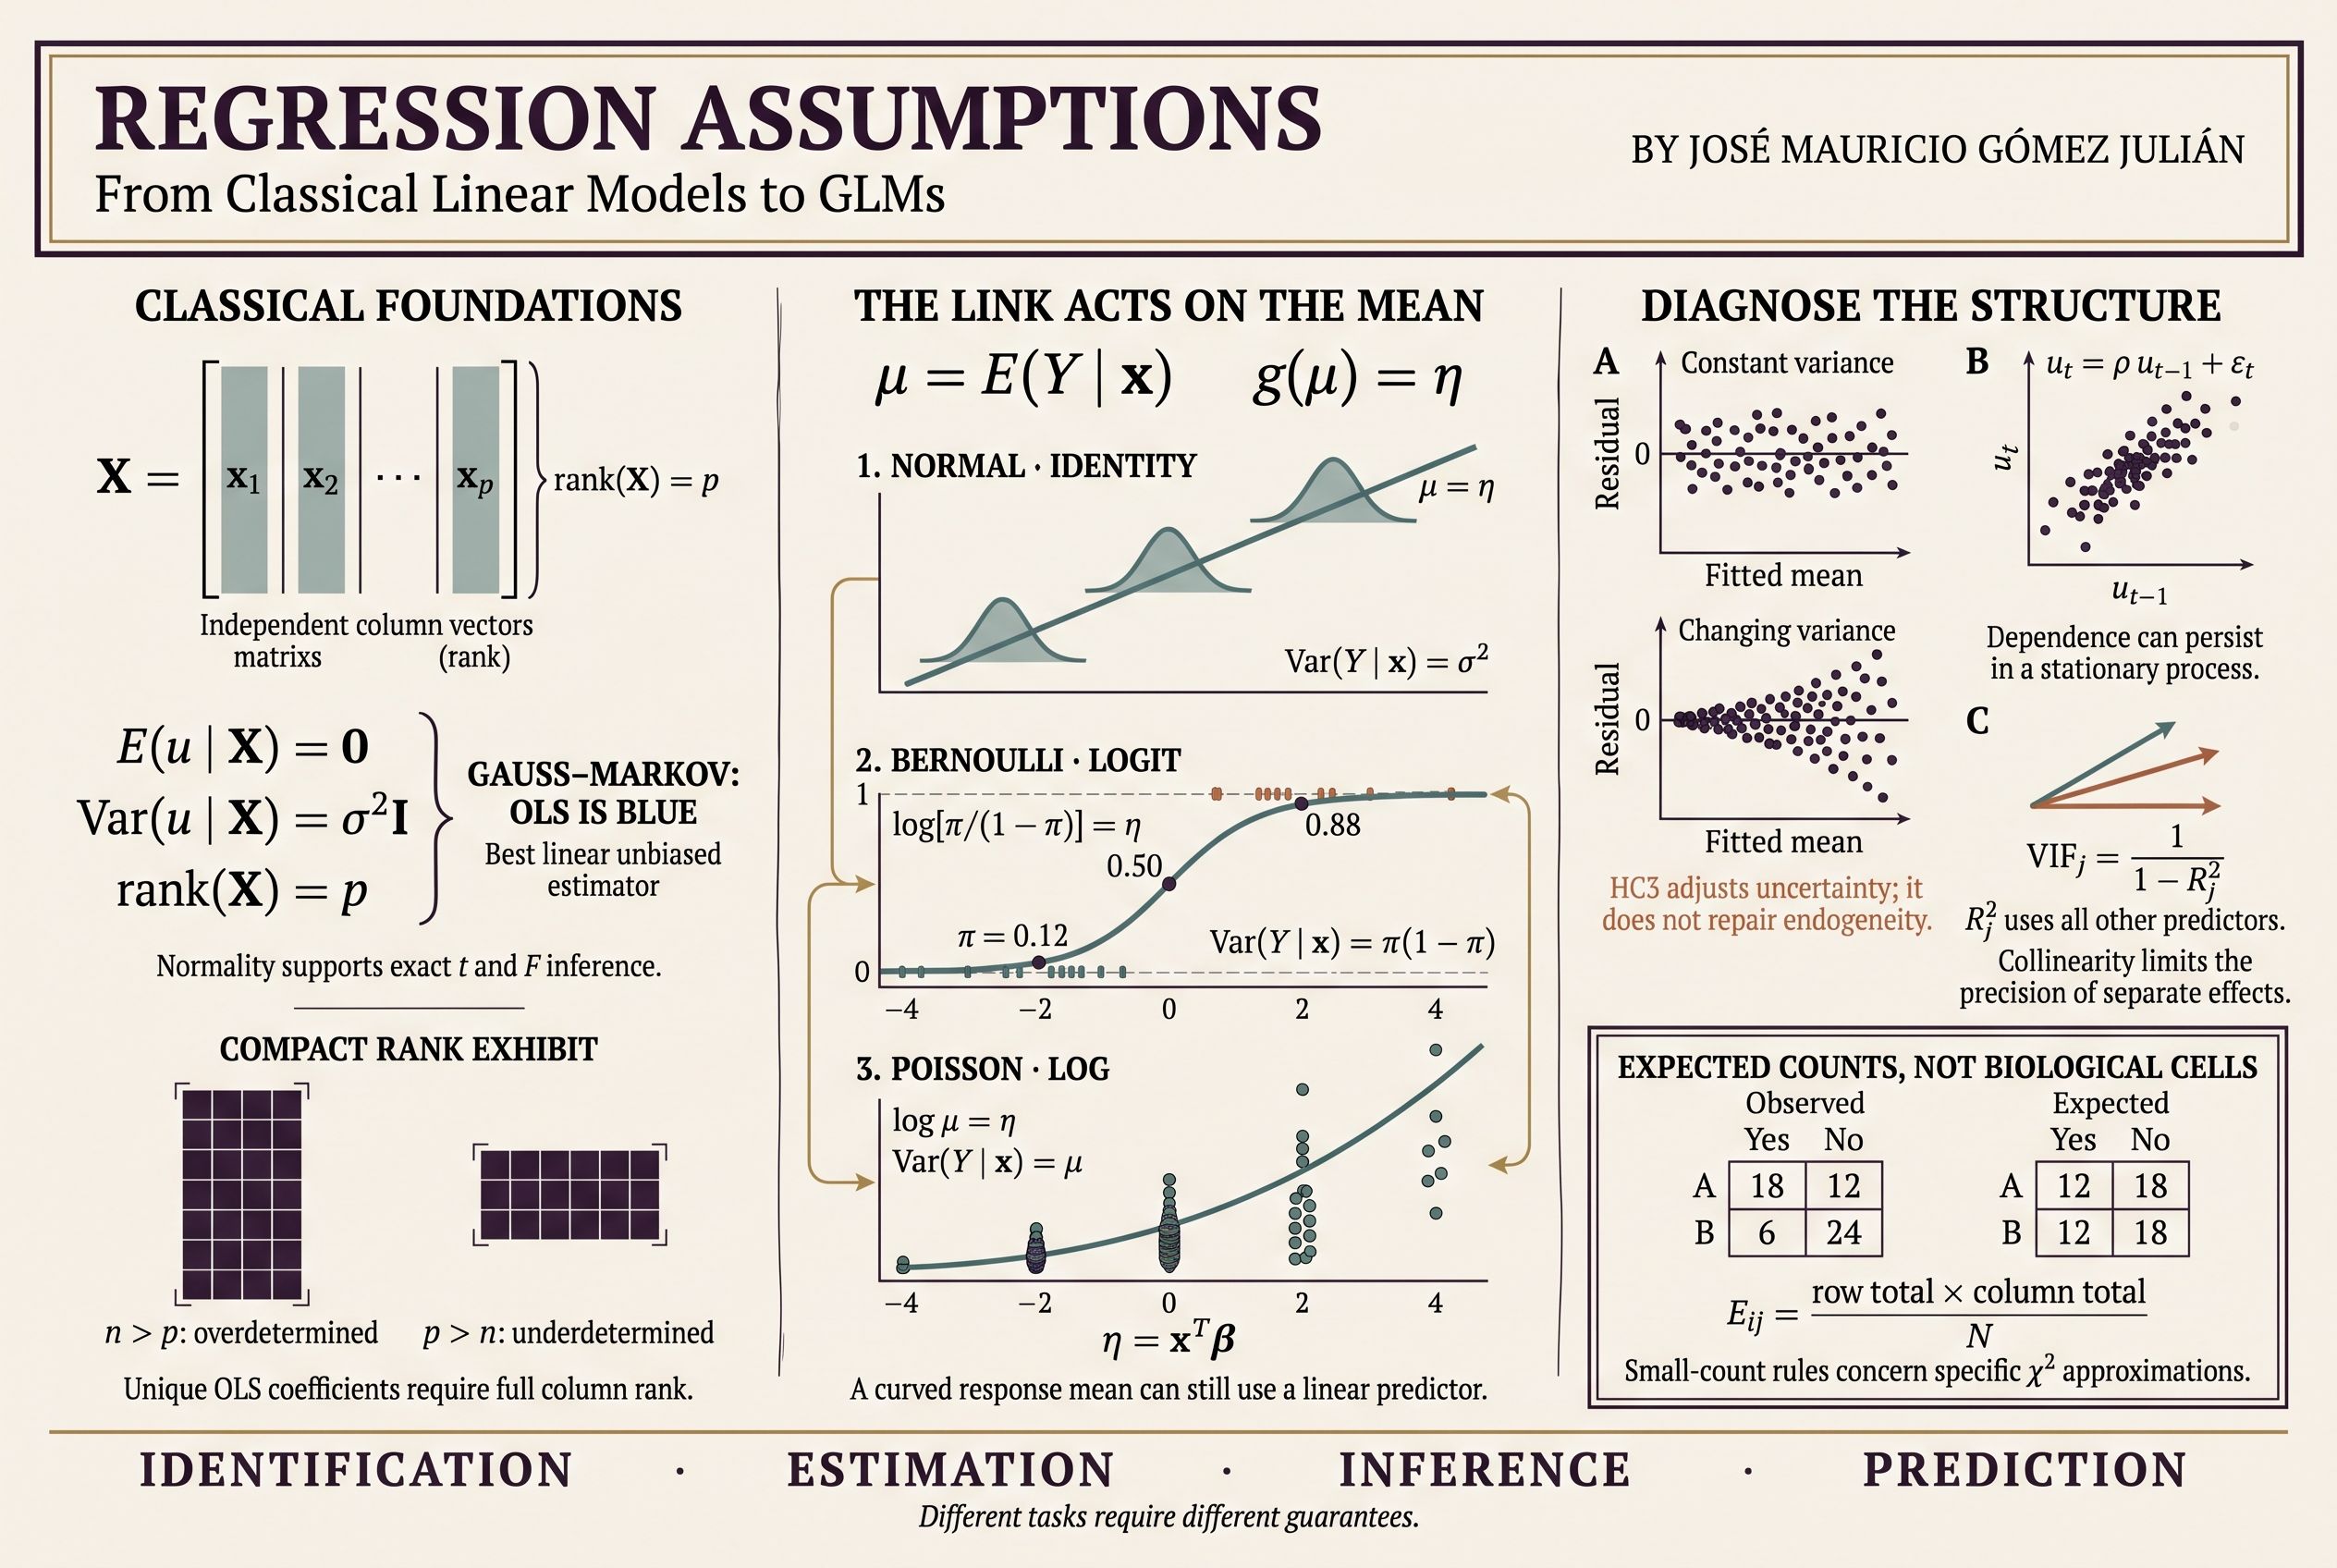
Rango completo garantiza un vector único de coeficientes MCO. La media condicional nula garantiza insesgamiento. La matriz σ²I reúne homocedasticidad y ausencia de covarianzas entre errores distintos. Bajo estas condiciones, MCO es MELI: mejor estimador lineal insesgado, o BLUE por sus siglas inglesas. «Lineal» describe aquí la dependencia del estimador respecto de Y, dado X. [4]
La varianza depende tanto del ruido σ² como de la información que contiene X. Ser eficiente dentro de la clase lineal insesgada no asegura errores estándar pequeños: un diseño poco informativo puede dejar una incertidumbre considerable incluso al mejor estimador de esa clase.
Por qué aparece la propiedad de mínimo
Var(ÃY|X)−Var(AY|X)=σ2CCT ⪰ 0(16)
Cualquier otro estimador lineal condicionalmente insesgado puede escribirse como ÃY, con ÃX=I. Su diferencia respecto de la matriz de MCO es C, que satisface CX=0. Al calcular las covarianzas, los términos cruzados desaparecen y queda σ²CCT, una matriz semidefinida positiva. Para cualquier combinación lineal de los coeficientes, esa diferencia no puede reducir la varianza. Este es el sentido preciso de «mejor».
Normalidad y contrastes exactos
La normalidad conjunta condicional u|X∼N(0,σ²I) no forma parte del argumento anterior. Al añadirla, con n>p, se obtienen las distribuciones exactas t y F del modelo normal clásico:
SSE mide el residuo total; n−p descuenta las dimensiones utilizadas para ajustar los coeficientes. El numerador del estadístico t compara la estimación con el valor nulo βj,0; el denominador expresa la incertidumbre estimada bajo el modelo. Las pruebas F comparan restricciones lineales conjuntas. Si cambia la estructura de covarianzas, debe cambiar la justificación de esos errores estándar y contrastes.
Sin normalidad puede haber inferencia asintótica bajo condiciones de momentos, diseño y dependencia que permitan leyes de grandes números y teoremas centrales del límite. Un n grande no repara automáticamente endogeneidad, falta de identificación, observaciones dominantes o dependencia mal tratada.
09Homocedasticidad y heterocedasticidad
La homocedasticidad exige que Var(ui|X)=σ² para todas las observaciones. La varianza es constante, no nula. Una varianza cero eliminaría la variación condicional del error y constituiría un caso degenerado. La heterocedasticidad permite que esa varianza cambie con las observaciones o con la información condicionante.
Ocho situaciones que requieren interpretación
- Aprendizaje. Con más práctica de mecanografía podrían disminuir tanto el promedio de errores como su variabilidad. Son dos características diferentes: una tendencia en la media no demuestra heterocedasticidad.
- Escala económica. Hogares con ingresos altos pueden presentar una dispersión mayor del ahorro. Hay que estudiar la varianza del ahorro condicional al ingreso y a las demás explicativas.
- Calidad de medición. Instituciones con sistemas de registro distintos pueden tener precisiones diferentes. El error de medición de una regresora puede ocasionar además endogeneidad.
- Observaciones atípicas. Un residuo grande merece examen, pero puede provenir de la misma distribución. Atipicidad de respuesta, apalancamiento e influencia no son sinónimos.
- Variables omitidas y mezclas. Combinar grupos con medias o varianzas diferentes puede generar patrones aparentes. Se debe revisar la especificación antes de atribuirlos al ruido.
- Regresoras asimétricas. La concentración del ingreso puede afectar la cobertura de X y el apalancamiento. La asimetría de X no implica por sí sola una varianza condicional del error cambiante.
- Transformaciones. Logaritmos u otras transformaciones pueden estabilizar, mantener o empeorar la dispersión; la respuesta depende del mecanismo de variación.
- Forma funcional. Ajustar una recta a una media curva puede generar estructura en los residuos. Esto es inicialmente un problema de media y no prueba de heterocedasticidad genuina.
Qué se conserva y qué deja de estar garantizado
Var(β̂|X)=BXTΩXB(18)
Ω representa la matriz de covarianzas condicionales del error. Cuando solo hay heterocedasticidad y los errores están incorrelacionados, es diagonal. Si E(u|X)=0 y hay rango completo, MCO sigue siendo lineal e insesgado. Su consistencia requiere condiciones asintóticas adicionales. Lo que se pierde es la garantía general MELI y la validez de la fórmula convencional s²(XTX)−1. Perder la garantía no significa probar ineficiencia en todo diseño posible.
Los errores estándar convencionales pueden ser demasiado pequeños o demasiado grandes. Por ello pueden alterarse los intervalos y los contrastes; no existe una dirección universal del error inferencial.
Diagnóstico y respuestas posibles
Los gráficos de residuos frente a ajustados o explicativas ayudan a detectar cambios de dispersión. Pruebas como Breusch–Pagan y White contrastan hipótesis específicas y también pueden reaccionar a mala especificación. No rechazar una prueba no certifica homocedasticidad.
V̂HC3=B[∑ixixiT ûi2/(1−hii)2]B(19)
Esta estimación robusta HC3 usa hii, el apalancamiento de la observación i, para ajustar su contribución residual. Mantiene los coeficientes MCO y modifica la covarianza estimada; no corrige una media equivocada ni demuestra exogeneidad. Su justificación es aproximada y requiere condiciones apropiadas, en particular sobre dependencia y observaciones dominantes.
β̂GLS=M−1XTΩ−1y(20)
Si Ω es conocida, simétrica y definida positiva, los mínimos cuadrados generalizados incorporan su inversa como ponderación. Con Ω diagonal se obtienen mínimos cuadrados ponderados. Estimar Ω conduce a MCG factibles, cuya calidad depende del modelo de varianza. No debe confundirse generalized least squares (GLS) con generalized linear models (GLM).
Lo que realmente hace un logaritmo
La aproximación de primer orden usa la derivada de log μ, igual a 1/μ. Si la desviación estándar de Y es aproximadamente proporcional a su media positiva, dividir la varianza por μ² puede estabilizarla. Si la dispersión relativa cambia de otra manera, el efecto puede ser diferente. El logaritmo comprime los valores altos de la variable transformada; transformar Y no desplaza los puntos horizontalmente en X.
Debe respetarse Y>0, y cambiar la escala cambia el objeto modelado: E(log Y|X) no es log E(Y|X) en general. Exponenciar una predicción de log Y no produce automáticamente una estimación de la media de Y. La retransformación exige considerar la distribución o una corrección adecuada. [5]
10Autocorrelación, dependencia y tiempo
La ausencia de autocorrelación exige Cov(ut,us|X)=0 cuando t≠s. Para varianzas positivas finitas, esto equivale a correlación cero, no a independencia en distribuciones generales. Un proceso puede ser aleatorio y tener memoria. Por tanto, «estocástico» no significa «sin estructura temporal».
γ(h)=σε2ρ|h|/(1−ρ2)(22)
En el proceso AR(1) estacionario, εt son innovaciones independientes de media cero y varianza σ²ε. La covarianza γ(h) depende del rezago h. Cuando ρ≠0 hay autocorrelación aunque la media y la varianza no cambien con el tiempo. La estacionariedad débil exige media constante y covarianzas que dependan de la distancia temporal, no de la fecha absoluta.
Mecanismos que pueden generar estructura residual
- Persistencia e inercia. Ajustes graduales después de una recesión, ciclos o choques persistentes pueden producir dependencia si no se modelan adecuadamente.
- Variables excluidas. Un factor omitido con evolución temporal deja su patrón en el residuo. Si se relaciona con las regresoras, puede haber además sesgo de especificación.
- Forma funcional incorrecta. Una tendencia o estacionalidad omitida puede parecer dependencia del error. Corregir la media es una cuestión distinta de cambiar su covarianza.
- Telaraña económica. La oferta agrícola puede responder a precios anteriores porque producir toma tiempo. Esto motiva ecuaciones dinámicas, sin demostrar automáticamente autocorrelación en toda especificación.
- Rezagos. La influencia del pasado sobre el presente exige elegir variables y estructura temporal pertinentes. Incluir una respuesta rezagada modifica las condiciones de exogeneidad.
- Agregación y suavizamiento. Los promedios móviles solapados comparten observaciones y pueden inducir dependencia. Promediar bloques disjuntos de errores independientes no la produce necesariamente.
- Diferenciación. Transformar datos cambia su estructura de covarianza. Incluso diferenciar ruido blanco puede introducir correlación serial.
- No estacionariedad. Tendencias estocásticas pueden producir regresiones espurias. Variables no estacionarias también pueden estar cointegradas, con una combinación estacionaria; eso requiere otro análisis.
Si εt es ruido blanco independiente, los términos vt y vt−1 comparten εt−1 con signos opuestos, lo que explica la covarianza negativa. Este ejemplo muestra por qué una transformación no debe evaluarse solo por cómo suaviza una gráfica.
Consecuencias y decisiones
Bajo E(u|X)=0, MCO conserva el insesgamiento aun con covarianzas no diagonales; la consistencia depende de condiciones adicionales de dependencia y diseño. En modelos dinámicos no debe afirmarse automáticamente ninguna de las dos propiedades. La covarianza general de β̂ sigue siendo la expresión con Ω presentada anteriormente.
La inferencia convencional puede fallar, pero no hay una regla universal que obligue a subestimar cada varianza o a inflar siempre R². Las regresiones espurias son un riesgo concreto, distinto de cualquier autocorrelación en una serie estacionaria.
Se inspeccionan residuos en orden temporal, función de autocorrelación y diagnósticos acordes con el modelo. Breusch–Godfrey permite contrastar determinadas formas de correlación serial; Durbin–Watson tiene un ámbito más restringido. HAC estima covarianzas robustas frente a heterocedasticidad y dependencia temporal bajo condiciones apropiadas; su elección de rezagos importa. Datos agrupados requieren considerar errores por conglomerados, con cautela cuando hay pocos grupos. Ninguna de estas correcciones reemplaza una especificación temporal o una identificación causal adecuada.
11Observaciones, rango, restricciones e identificación
Contar observaciones y coeficientes es necesario, pero no basta. Si dos columnas de X son duplicadas, aumentar n no identifica sus efectos separados mientras la duplicación persista. El criterio de unicidad de los coeficientes MCO es rank(X)=p.
| Dimensiones | Qué puede concluirse |
|---|---|
| n>p | Sistema sobredeterminado. Puede ser compatible; MCO tiene coeficientes únicos si X tiene rango columna completo. |
| n=p | Con X invertible existe interpolación única. Los grados de libertad residuales son cero. |
| n<p | Sistema subdeterminado. X no tiene rango columna completo y los coeficientes MCO sin restricciones no son únicos. |
La condición para una solución exacta de Xb=y es:
La matriz ampliada [X|y] añade la respuesta como columna. Si aumenta el rango, y queda fuera del espacio columna de X y no existe solución exacta. Aun así, el problema de mínimos cuadrados tiene al menos un minimizador. Los coeficientes pueden no ser únicos cuando falta rango, pero el vector ajustado, como proyección sobre ese espacio, sí es único.
Un ejemplo de rectas y datos
Una observación (x1,y1) deja infinitas parejas intercepto-pendiente. Dos observaciones con x distintos determinan una recta única, pero no permiten estimar una varianza residual con dos parámetros libres. Con tres o más observaciones y x no constante puede estimarse esa varianza, aunque una muestra mínima siga ofreciendo muy poca precisión.
Los grados de libertad residuales cuentan dimensiones que quedan fuera del espacio ajustado. Si se imponen q restricciones lineales independientes y compatibles sobre un vector inicialmente identificable de p coeficientes, la dimensión libre puede pasar a p−q y los grados residuales a n−p+q. Esto no debe confundirse con reducir los grados residuales.
Fijar en cero un parámetro, como un diámetro mínimo en un modelo físico, reduce parámetros libres solo si se mantiene fijo durante la estimación. Su justificación debe proceder del problema científico, no del deseo de obtener una solución. Las restricciones también pueden identificar problemas inicialmente deficientes de rango, pero deben eliminar específicamente las direcciones no identificadas.
Pseudoinversa y regularización
La pseudoinversa de Moore–Penrose selecciona el minimizador MCO de menor norma euclídea. Seleccionar una solución no demuestra que los datos hayan identificado individualmente todos los coeficientes. Sus valores dependen también de la parametrización y las unidades.
En ridge se penalizan los coeficientes de pendiente; el intercepto b0 se deja sin penalizar en esta formulación. λ controla el compromiso entre ajuste y contracción. Estandarizar las regresoras puede ser necesario para comparar penalizaciones. La regularización puede mejorar predicción con muchos predictores, pero cambia el estimador e introduce sesgo; su intensidad se elige dentro del entrenamiento, usualmente por validación.
12Sobreajuste, subajuste y error predictivo
El sobreajuste ocurre cuando el procedimiento captura particularidades del entrenamiento que perjudican su desempeño ante datos nuevos del objetivo relevante. El subajuste ocurre cuando la clase de funciones o el ajuste no capturan relaciones relevantes. Ninguno es sinónimo de una configuración algebraica determinada.
Un modelo puede subajustar con muchas variables si omite una interacción decisiva o impone una forma equivocada. También puede sobreajustar con n>p, especialmente tras una búsqueda intensa de especificaciones. No debe atribuirse alta capacidad de generalización al subajuste: ambos extremos pueden predecir mal.
La identidad supone Y0=f(x0)+ε0, con error nuevo de media condicional cero e independiente del entrenamiento. La esperanza de la izquierda promedia sobre muestras de entrenamiento y respuestas nuevas en x0. El primer término es ruido irreducible; el segundo es el cuadrado de E[f̂(x0)]−f(x0); el tercero mide cuánto cambia la predicción entre entrenamientos. El sesgo puede ser cero: no es inevitablemente positivo.
Aumentar flexibilidad suele reducir sesgo de aproximación y aumentar variabilidad en escenarios clásicos, pero no es una ley monótona universal para todos los algoritmos. En modelos modernos pueden aparecer comportamientos más complejos. La decisión práctica requiere evaluar el procedimiento completo y el uso previsto. [6]
Entrenamiento, validación y prueba
Se ajustan parámetros en entrenamiento, se eligen hiperparámetros o especificaciones mediante validación y se reserva una prueba final para evaluar el procedimiento seleccionado. Una búsqueda de modelos también forma parte del aprendizaje. Estandarización, imputación y selección de variables deben aprenderse dentro de cada partición; hacerlas antes puede filtrar información.
En series temporales se respeta el orden temporal y se usan cortes o ventanas pertinentes. En datos agrupados puede ser necesario separar grupos completos. Una división aleatoria que mezcla observaciones dependientes puede medir una tarea más fácil que la predicción real.
13Multicolinealidad, precisión y micronumerosidad
La ausencia de multicolinealidad perfecta exige independencia lineal de las columnas de X. No exige independencia estadística de las variables. Con intercepto, incluir todos los indicadores de una variable categórica genera la conocida trampa de las variables ficticias: su suma reproduce la columna de unos.
Con colinealidad perfecta, una dirección no nula c satisface Xc=0. Entonces β y β+c generan la misma media ajustada y sus coeficientes no pueden separarse sin restricciones. Una fórmula 0/0 en un caso simple es una manifestación de esta falta de identificación, no su definición general.
Factores que pueden reducir información independiente
- Diseño o cobertura restringida. Observar un rango estrecho de ingresos puede dejar poca variación útil, con independencia del tamaño nominal de muestra.
- Estructura de la población. El ingreso y el tamaño de vivienda pueden estar fuertemente relacionados al explicar consumo eléctrico.
- Construcción del modelo. Potencias e interacciones pueden producir columnas muy correlacionadas. Centrar puede mejorar la parametrización sin cambiar el espacio ajustado.
- Alta dimensión. Si p>n necesariamente falta rango columna completo; esta situación es subdeterminada, no sobredeterminada.
- Tendencias comunes. Explicativas que crecen juntas pueden aportar poca variación separable y, en series, requerir análisis de estacionariedad.
El factor de inflación de varianza
Var(β̂j|X) = σ2 / [∑i(xij−x̄j)2(1−Rj2)](28)
Rj² corresponde a una regresión auxiliar de la explicativa j sobre todas las demás explicativas, con intercepto en la formulación habitual. La segunda expresión se refiere a una pendiente bajo errores esféricos. Se necesita rango completo y variación no nula en esa columna. Con solo dos explicativas, Rj² coincide con el cuadrado de su correlación; con más columnas esa sustitución puede ser incorrecta. [7]
Un VIF de 10 multiplica por 10 la varianza respecto del factor de referencia de la fórmula y por √10 el error estándar, manteniendo los demás componentes. El umbral 10 es una orientación, no una frontera universal de validez. Las variables con varios grados de libertad requieren diagnósticos adecuados, como versiones generalizadas del VIF.
Qué consecuencias tiene
La colinealidad alta pero imperfecta puede aumentar incertidumbre, sensibilidad de coeficientes y amplitud de intervalos, aun manteniéndose insesgamiento y MELI bajo los demás supuestos. Pueden coexistir un contraste global significativo, R² alto y contrastes individuales débiles. La predicción dentro de la región observada puede ser razonable mientras la extrapolación o la atribución separada resulten inestables.
La distinción entre colinealidad sistemática y errática ayuda a discutir estructuras de variables y limitaciones muestrales o numéricas, pero no sustituye los conceptos de rango, condicionamiento y precisión. En esta discusión Goldberger empleó «micronumerosidad» como parodia metodológica: pocos datos y poca variación independiente también limitan la información disponible. Salmerón Gómez y colaboradores desarrollan esa conexión. [8]
Las posiciones de Leamer, Achen, Blanchard y Kennedy recogidas por Gujarati y Porter expresan una advertencia común: los remedios automáticos no fabrican información. Conviene conservar esa discusión, diferenciando la gravedad práctica según la pregunta y los datos. Obtener observaciones más informativas, reformular contrastes o usar conocimiento sustantivo puede ser mejor que eliminar mecánicamente una variable. Omitir un confusor relevante puede introducir sesgo; ridge cambia el objetivo inferencial. Eficiencia, precisión y estabilidad computacional son dimensiones relacionadas, pero distintas. [9]
14Los tres componentes de un modelo lineal generalizado
Un MLG combina una distribución condicional para la respuesta, un predictor lineal y una función de enlace. «Generalizado» no significa libre de supuestos: amplía las distribuciones y las relaciones de media admitidas, manteniendo una estructura explícita. El modelo lineal normal con enlace identidad es uno de sus casos.
μi es la media de Yi dada su información explicativa; ηi suma los efectos especificados en la escala del enlace. El enlace transforma la media condicional. No se aplica necesariamente a cada respuesta observada. La distinción permite incluir ceros en Poisson y respuestas 0/1 en logística sin calcular log 0 o logit 0 sobre los datos. [10]
Distribución y familia exponencial
Esta forma comprende densidades o funciones de masa respecto de la medida adecuada. θi es el parámetro canónico; b controla los momentos; ai incorpora dispersión y ponderaciones conocidas; c normaliza la distribución. Bajo regularidad de la familia exponencial, se obtienen:
En la última igualdad se usa ai(φ)=φ/wi, con wi>0 conocidos. En casos sin ponderación, wi=1. Para proporciones binomiales, el número de ensayos desempeña ese papel. La forma de la varianza no se elige arbitrariamente después de ajustar la media.
| Modelo | Respuesta y media | Enlace ilustrativo | Varianza |
|---|---|---|---|
| Normal | Continua; μ∈ℝ | g(μ)=μ | σ² |
| Bernoulli | Y∈{0,1}; μ=π | log[π/(1−π)] | π(1−π) |
| Binomial, conteo | Y∈{0,…,m}; μ=mπ | logit(μ/m) | mπ(1−π) |
| Poisson | Conteo no negativo; μ>0 | log μ | μ |
| Gamma | Continua positiva; μ>0 | log μ, entre otros | φμ² |
La Gamma admite también enlace inverso; el logarítmico de la tabla es una opción habitual y no su enlace canónico. La distribución exponencial es un caso de Gamma. La multinomial puede integrarse mediante extensiones con respuesta vectorial y varios predictores lineales; no debe introducirse en una fórmula escalar sin esa aclaración. [11]
Logística y Poisson
En logística, πi es la probabilidad de éxito. El enlace logit permite un predictor η sin restricciones reales y devuelve probabilidades entre cero y uno. exp(βj) expresa una razón de odds por unidad de la explicativa j, manteniendo el resto y respetando las interacciones; no es automáticamente un riesgo relativo.
En Poisson, exp(βj) multiplica la media por unidad de cambio, bajo la misma precisión sobre interacciones. La varianza es igual a la media condicional: la variación de esta con X es parte del modelo. Una varianza muestral global mayor que la media global no demuestra sobredispersión condicional.
Si las observaciones tienen exposiciones ti>0 distintas, como tiempos de seguimiento, log ti entra como offset con coeficiente fijo igual a uno. Entonces exp(xiTβ) modela una tasa. Comparar conteos sin considerar exposiciones puede confundir duración con intensidad.
Independencia y estructura condicional
En el MLG independiente básico, las respuestas son independientes condicionalmente al diseño y a los parámetros. Compartir unidades, escuelas, hogares o mediciones repetidas puede violar esa estructura. La intercambiabilidad significa invariancia ante permutaciones y permite dependencia: no reemplaza sin más a la independencia. Modelos mixtos generalizados o ecuaciones de estimación generalizadas abordan otras estructuras con objetivos diferentes.
No se exige que todas las regresoras tengan la misma escala ni que las desviaciones sean independientes de la media. Se exige coherencia de medición y una distribución condicional correctamente especificada para la inferencia de verosimilitud correspondiente. En un MLG, la magnitud de las desviaciones puede cambiar con μ según V(μ).
15Estimación, dispersión y bondad de ajuste en los MLG
La máxima verosimilitud y sus condiciones
Con respuestas condicionalmente independientes, la verosimilitud multiplica sus distribuciones y la log-verosimilitud suma contribuciones. Los coeficientes se estiman maximizando esa suma bajo el enlace y la familia elegidos. La máxima verosimilitud no exige, para definirse, una muestra grande; muchas aproximaciones usadas para sus errores estándar y contrastes sí son asintóticas.
La existencia de un máximo finito no está garantizada. En logística, la separación completa o cuasicompleta puede llevar coeficientes hacia infinito; el algoritmo puede emitir avisos o devolver valores muy grandes. Rango completo no basta para excluir ese problema. Se requieren diagnóstico y, según el objetivo, métodos penalizados u otros procedimientos específicamente justificados.
Mínimos cuadrados iterativamente reponderados
Wii=(dμi/dηi)2/Var(Yi|xi)(35)
En la iteración m, se calculan medias μ, derivadas dμ/dη, una respuesta de trabajo z y pesos W. Después se resuelve un problema ponderado en la escala del predictor. Las expresiones mostradas suponen ausencia de offset; con offset se incorpora el término conocido correspondiente. Las matrices deben tener el rango apropiado y las derivadas y varianzas deben permitir el cálculo.
El algoritmo IRLS no convierte cualquier MLG en MCO sobre una transformación fija de los datos: z y W se actualizan. En la normal con identidad y varianza común, la actualización recupera el ajuste de mínimos cuadrados. En R, glm() emplea este tipo de procedimiento por defecto. [12]
Devianza y comparación de modelos
ℓsat es la log-verosimilitud del modelo saturado, que ajusta una media por observación; ℓfit corresponde al modelo considerado. Se compara con la misma dispersión cuando corresponde. D* denota devianza escalada y D la no escalada en la convención utilizada aquí. Algunas fuentes usan otros nombres: debe comprobarse la definición, no solo la etiqueta.
En la normal con dispersión σ², D=SSE y D*=SSE/σ². En Poisson, φ=1 y ambas coinciden:
La convención del término con y=0 procede del límite de y log y. No hace falta modificar arbitrariamente los ceros para calcular esta discrepancia. Su expresión depende de la distribución y no es simplemente una norma euclídea. El modelo saturado es una referencia para medir discrepancia, no una recomendación predictiva.
La expresión de Pearson mostrada corresponde a respuestas sin ponderaciones, con Var(Y|X)=φV(μ). En Poisson, V(μ)=μ. Con n>p, la razón puede servir como estimador o diagnóstico aproximado de dispersión, según el modelo. Un valor elevado puede indicar sobredispersión, dependencia, datos influyentes o una media incorrecta; no identifica por sí solo la causa.
Un MLG Poisson estricto fija φ=1. La sobredispersión respecto de él debe abordarse: cuasi-Poisson permite Var(Y|X)=φμ; una binomial negativa introduce otra relación media-varianza; modelos mixtos pueden representar heterogeneidad compartida. Son alternativas con distintos supuestos. En datos Bernoulli individuales la varianza está determinada por la probabilidad; una escala libre requiere interpretar con cuidado el mecanismo de variación o agrupación.
La aproximación de razón de verosimilitudes exige modelos anidados, la misma respuesta y muestra, identificabilidad y regularidad, incluyendo la posición interior de los parámetros y condiciones asintóticas apropiadas. q es la diferencia de dimensiones. Fronteras, separación y datos escasos pueden invalidar la referencia habitual. AIC usa k parámetros estimados, incluidos parámetros de dispersión cuando corresponde, y se compara entre verosimilitudes comparables.
Las familias cuasi no definen necesariamente una verosimilitud completa; no corresponde usar sin más el AIC ordinario o una prueba de razón de verosimilitudes como si la definieran. Tampoco D≈χ² es una regla universal para toda combinación de distribución, observaciones individuales y tamaño muestral. Se distinguen el contraste de ajuste absoluto y la comparación entre modelos anidados.
16Frecuencias esperadas: qué significa una celda
En tablas de contingencia, cell significa celda o casilla. La recomendación sobre conteos esperados pequeños se refiere a la calidad de determinadas aproximaciones chi-cuadrado. No trata de células biológicas ni exige que cada unidad muestral contenga cinco observaciones. Tampoco es un supuesto universal de todos los MLG.
Considérese esta tabla ilustrativa, sin pretensión de representar un estudio real:
| Grupo | Resultado sí | Resultado no | Total |
|---|---|---|---|
| A | 18 | 12 | 30 |
| B | 6 | 24 | 30 |
| Total | 24 | 36 | 60 |
Bajo independencia entre fila y columna, la probabilidad conjunta se factoriza. Multiplicar por N y estimar las probabilidades marginales produce Eij. Para la primera celda: 30×24/60=12; para la segunda: 30×36/60=18. Los esperados son 12,18 en ambas filas. No son los observados 18,12 y 6,24.
La suma de Pearson es 10 y, con un grado de libertad y sin corrección de continuidad, su referencia chi-cuadrado da aproximadamente p=0,001565. Es un ejemplo del cálculo, no una conclusión sustantiva sobre grupos reales.
Una orientación clásica para ciertas tablas evita esperados menores que 1 y una proporción elevada —frecuentemente 20 %— de celdas con esperados menores que 5. Es una heurística contextual, no una frontera matemática exacta. Su pertinencia depende del esquema de muestreo, las dimensiones, la dispersión de frecuencias y el estadístico. [13]
Cuando la aproximación es pobre pueden considerarse procedimientos exactos o simulaciones apropiadas. El test exacto de Fisher en una tabla 2×2 usa una distribución condicional con márgenes fijados; no es un reemplazo automático para cualquier tabla o diseño. Fusionar categorías requiere sentido sustantivo y cambia la pregunta. Datos pareados o agrupados necesitan métodos que respeten su dependencia.
17De los supuestos al diagnóstico aplicado
Un diagnóstico útil comienza por la pregunta y el diseño. Las pruebas auxiliares aportan evidencia parcial: no son certificados globales de validez. Antes de elegir un remedio se identifica si el problema afecta la media, la varianza, la dependencia, la identificación o la tarea predictiva.
| Aspecto | Evidencia a examinar | Respuesta posible |
|---|---|---|
| Media y enlace | Residuos, conocimiento científico, patrones por grupo. | Reespecificar términos, interacciones o enlace y validar. |
| Varianza | Dispersión condicional, residuos estandarizados, pruebas específicas. | HC, ponderaciones justificadas o familia/varianza apropiada. |
| Dependencia | Orden temporal, ACF, unidades repetidas, estructura de grupos. | Dinámica, HAC, conglomerados, modelos mixtos o GEE según el objetivo. |
| Rango y colinealidad | Columnas redundantes, QR/SVD, VIF, condicionamiento. | Reparametrizar, obtener información o restringir con justificación. |
| Influencia | Apalancamiento, residuos studentizados, distancia de Cook. | Verificar registros y hacer análisis de sensibilidad. |
| Generalización | Error fuera de muestra y estabilidad por periodos o grupos. | Validación acorde con el uso y selección dentro de entrenamiento. |
| Identificación causal | Diseño, confusores, selección, temporalidad. | Argumento causal explícito y estrategia de identificación. |
Los residuos tampoco son los errores originales
Incluso con errores esféricos, los residuos ajustados no son independientes ni tienen varianzas idénticas: la proyección que estima los coeficientes introduce covarianzas y hace que su varianza dependa del apalancamiento. Esto justifica estandarizarlos y evita exigirles literalmente todas las propiedades postuladas para u.
Un gráfico Q–Q evalúa compatibilidad distributiva y puede detectar colas o atípicos, pero su lectura debe considerar tamaño de muestra, leverage y estructura. La ausencia de normalidad marginal de Y o de X no constituye, por sí sola, una violación de normalidad condicional del error. Tampoco se exige normalidad de Y en logística o Poisson.
Una observación de alto apalancamiento tiene valores explicativos poco habituales; una de gran residuo se aparta de la predicción; una influyente modifica sustancialmente el ajuste al retirarla. No deben eliminarse observaciones solo porque incomodan al modelo. Se verifica su origen y se reporta sensibilidad, preservando la pregunta científica.
18Laboratorio reproducible en R
Los diez experimentos siguientes usan únicamente R base y el paquete stats incluido con R. Cada bloque es independiente, fija su semilla cuando genera aleatoriedad y utiliza datos simulados o una tabla ilustrativa. Los coeficientes poblacionales conocidos permiten contrastar qué calcula el procedimiento. Las comprobaciones verifican identidades matemáticas; no certifican la validez de un estudio real.
A. Una curva que sigue siendo un modelo lineal
Se simula una media cuadrática y se comparan una recta, un polinomio lineal en coeficientes y el MLG normal equivalente. El aumento de R² muestra ajuste muestral; la igualdad de coeficientes comprueba la coincidencia normal-identidad entre lm() y glm().
set.seed(240901)
n <- 180
x <- runif(n, -2, 2)
y <- 1 + 0.8*x + 0.6*x^2 + rnorm(n, sd = 0.7)
dat <- data.frame(x, y)
line <- lm(y ~ x, data = dat)
curve <- lm(y ~ x + I(x^2), data = dat)
normal_glm <- glm(y ~ x + I(x^2), data = dat,
                  family = gaussian(link = "identity"))
stopifnot(max(abs(coef(curve)-coef(normal_glm))) < 1e-8)
print(round(coef(curve), 4))
print(c(line_R2 = summary(line)$r.squared,
        curve_R2 = summary(curve)$r.squared,
        df = df.residual(curve)))
par(mfrow = c(1, 2))
plot(fitted(line), resid(line), main = "Linear mean")
abline(h = 0, lty = 2)
plot(fitted(curve), resid(curve), main = "Quadratic mean")
abline(h = 0, lty = 2)
par(mfrow = c(1, 1))
B. Heterocedasticidad y covarianza HC3
La desviación estándar crece con x. Se mantienen los coeficientes MCO al calcular HC3. Los pesos del segundo ajuste usan la varianza generadora conocida: esto es una demostración de ponderación correcta en simulación, no un procedimiento que conozca automáticamente esa varianza en datos reales.
set.seed(240902)
n <- 220
x <- runif(n, 0, 4)
sigma <- 0.25 + 0.65*x
y <- 2 + 1.5*x + rnorm(n, sd = sigma)
fit <- lm(y ~ x)
X <- model.matrix(fit)
h <- hatvalues(fit)
stopifnot(fit$rank == ncol(X), all(h < 1))
# A maps y to OLS coefficients; QR avoids inverting X'X.
A <- qr.coef(qr(X), diag(n))
B <- sweep(A, 2, resid(fit)/(1-h), FUN = "*")
V_HC3 <- tcrossprod(B)
weighted <- lm(y ~ x, weights = 1/sigma^2)
print(cbind(estimate = coef(fit),
            conventional_SE = sqrt(diag(vcov(fit))),
            HC3_SE = sqrt(diag(V_HC3))))
print(coef(weighted))
stopifnot(all(eigen(V_HC3, symmetric=TRUE)$values > 0))
C. Residuos con memoria
Las explicativas se generan independientemente de un error AR(1). La ACF de residuos permite observar persistencia. El bloque ilustra el diagnóstico; la inferencia temporal requiere una covarianza o especificación adecuada adicional.
set.seed(240903)
n <- 240
x <- rnorm(n)
u <- as.numeric(arima.sim(model = list(ar = 0.7), n = n))
y <- 1 + 0.8*x + u
fit <- lm(y ~ x)
acf1 <- acf(resid(fit), plot = FALSE)$acf[2]
print(c(residual_lag1_ACF = acf1))
par(mfrow = c(1, 2))
plot(resid(fit), type="l", xlab="Time", ylab="Residual")
acf(resid(fit), main="Residual ACF")
par(mfrow = c(1, 1))
# This is a dependence diagnostic, not a HAC correction.
D. Columna redundante y grados de libertad
La tercera columna duplica una dirección ya presente. R informa un coeficiente no estimable, mientras el rango permite calcular los grados de libertad correctos. El segundo ajuste interpola dos puntos y deja cero grados residuales.
x <- 1:6
y <- c(2.1, 2.9, 4.2, 4.8, 6.1, 7.2)
X <- cbind(intercept=1, x=x, double_x=2*x)
fit <- lm(y ~ x + I(2*x))
print(c(n=nrow(X), p=ncol(X), rank=qr(X)$rank,
        residual_df=df.residual(fit)))
print(coef(fit))
stopifnot(fit$rank == 2, df.residual(fit) == 4,
          anyNA(coef(fit)))
# Two observations, two coefficients: interpolation, no residual df.
saturated <- lm(c(2, 5) ~ c(0, 1))
print(c(residual_df=df.residual(saturated)))
stopifnot(df.residual(saturated) == 0)
E. VIF con todas las demás explicativas
La regresión auxiliar incluye el conjunto restante, no solo una correlación por pares. Se muestran VIF y número de condición: este último también depende de las unidades y de la parametrización.
set.seed(240904)
n <- 250
x1 <- rnorm(n)
x2 <- 0.98*x1 + 0.15*rnorm(n)
x3 <- rnorm(n)
Z <- data.frame(x1, x2, x3)
vif <- sapply(names(Z), function(target) {
  aux <- lm(reformulate(setdiff(names(Z), target),
                        response=target), data=Z)
  1/(1-summary(aux)$r.squared)
})
print(round(vif, 3))
print(c(condition_number=kappa(model.matrix(~., Z), exact=TRUE)))
stopifnot(all(vif >= 1), vif["x1"] > 10, vif["x3"] < 2)
F. Probabilidades e intervalos en logística
La inferencia aproximada se construye en la escala del enlace y se transforma con la inversa del logit. Los intervalos son para probabilidades condicionales, no intervalos predictivos de una respuesta individual binaria. Los valores exp(β̂) se interpretan como odds ratios en esta especificación sin interacciones.
set.seed(240905)
n <- 400
x <- rnorm(n)
prob <- plogis(-0.4 + 1.1*x)
y <- rbinom(n, size=1, prob=prob)
fit <- glm(y ~ x, family=binomial(link="logit"))
new <- data.frame(x=c(-1, 0, 1))
pred <- predict(fit, newdata=new, type="link", se.fit=TRUE)
z <- qnorm(0.975)
result <- data.frame(x=new$x, probability=plogis(pred$fit),
  lower=plogis(pred$fit-z*pred$se.fit),
  upper=plogis(pred$fit+z*pred$se.fit))
print(round(result, 4))
print(exp(coef(fit)))
stopifnot(fit$converged, all(result$probability > 0),
          all(result$probability < 1))
# Intervals target conditional probabilities, not new 0/1 outcomes.
G. Conteos, exposición y cuasi-Poisson
Duplicar exposición manteniendo x duplica el conteo medio, no la tasa. La razón de Pearson es diagnóstica. Con el mismo enlace y datos, Poisson y cuasi-Poisson dan aquí los mismos coeficientes, pero difieren en el tratamiento de la dispersión; el AIC ordinario de la familia cuasi no está definido.
set.seed(240906)
n <- 320
x <- rnorm(n)
exposure <- runif(n, 0.5, 3)
mu <- exposure*exp(0.2 + 0.5*x)
y <- rpois(n, lambda=mu)
dat <- data.frame(y, x, exposure)
fit <- glm(y ~ x + offset(log(exposure)), data=dat,
           family=poisson(link="log"))
quasi <- glm(y ~ x + offset(log(exposure)), data=dat,
             family=quasipoisson(link="log"))
phi <- sum(residuals(fit, type="pearson")^2)/df.residual(fit)
print(c(Pearson_dispersion=phi, Poisson_AIC=AIC(fit),
        quasi_AIC=AIC(quasi)))
new <- data.frame(x=c(0, 0), exposure=c(1, 2))
means <- predict(fit, newdata=new, type="response")
print(means)
stopifnot(fit$converged,
  max(abs(coef(fit)-coef(quasi))) < 1e-7,
  abs(means[2]/means[1]-2) < 1e-8, is.na(AIC(quasi)))
H. Respuesta positiva con Gamma
La simulación tiene media exp(0,7+0,6x), forma Gamma 4 y dispersión 1/4. Se estiman la media y la dispersión. No se espera recuperar exactamente cada valor poblacional en una muestra finita.
set.seed(240907)
n <- 260
x <- runif(n, -1, 1)
mu <- exp(0.7 + 0.6*x)
y <- rgamma(n, shape=4, scale=mu/4)
fit <- glm(y ~ x, family=Gamma(link="log"))
print(round(coef(fit), 4))
print(c(estimated_dispersion=summary(fit)$dispersion))
stopifnot(fit$converged, all(fitted(fit) > 0))
I. Observados, esperados y dos referencias inferenciales
Se calcula la tabla esperada bajo independencia, se reproduce X²=10 y se muestra el test de Fisher para distinguir una referencia asintótica de una condicional exacta. No se usa corrección de continuidad en la prueba de Pearson de este ejemplo.
observed <- matrix(c(18,12,6,24), nrow=2, byrow=TRUE,
  dimnames=list(group=c("A","B"), outcome=c("yes","no")))
expected <- outer(rowSums(observed), colSums(observed))/sum(observed)
pearson <- chisq.test(observed, correct=FALSE)
print(expected)
print(c(X2=unname(pearson$statistic), p=pearson$p.value,
        fraction_expected_below5=mean(expected < 5)))
print(fisher.test(observed))
stopifnot(all(expected == pearson$expected),
          abs(unname(pearson$statistic)-10) < 1e-10)
J. Ajuste y validación no cuentan la misma historia
Se comparan grados 1, 3 y 12 ante una media cúbica. El error de entrenamiento no aumenta al ampliar estos espacios anidados, pero la evaluación nueva puede empeorar. La simulación ilustra un resultado concreto; no demuestra un orden universal de desempeño. Usar esta validación para elegir el grado exige una prueba final independiente para reportar desempeño.
set.seed(240908)
signal <- function(x) 0.8 + 0.7*x - 0.5*x^2 + 0.6*x^3
train <- data.frame(x=runif(45, -1.5, 1.5))
train$y <- signal(train$x) + rnorm(nrow(train), sd=0.5)
validation <- data.frame(x=runif(1200, -1.5, 1.5))
validation$y <- signal(validation$x) + rnorm(nrow(validation), sd=0.5)
results <- do.call(rbind, lapply(c(1,3,12), function(d) {
  fit <- lm(y ~ poly(x, degree=d), data=train)
  data.frame(degree=d,
    train_MSE=mean(resid(fit)^2),
    validation_MSE=mean((validation$y-predict(fit, validation))^2))
}))
print(results)
stopifnot(all(is.finite(as.matrix(results))),
  all(diff(results$train_MSE) <= 1e-10))
# Choose on validation; assess the selected procedure on a fresh test set.
Valores de control de la ejecución
Con las semillas indicadas y R 4.3.3 se obtuvieron los siguientes valores redondeados. Sirven para reconocer el resultado de cada bloque, no para exigir igualdad con parámetros poblacionales en una muestra finita.
| Ejemplo | Resultado |
|---|---|
| Normal cuadrático | β̂ ≈ (1,0072; 0,8449; 0,5637). |
| Pendiente heterocedástica | SE convencional ≈ 0,09744; HC3 ≈ 0,11037. |
| VIF | 43,469; 43,475; 1,002. |
| Poisson | Dispersión de Pearson ≈ 1,00086. |
| Tabla 2×2 | X²=10; p≈0,0015654 sin corrección de continuidad. |
| Validación, grados 1 / 3 / 12 | ECM ≈ 0,4951 / 0,2722 / 0,4042. |
19Qué garantiza cada condición: síntesis operativa
| Condición | Garantía o función | No demuestra |
|---|---|---|
| rank(X)=p | Unicidad de coeficientes MCO. | Exogeneidad o generalización. |
| E(u|X)=0 y rango completo | Insesgamiento condicional de MCO. | Eficiencia sin condiciones de covarianza. |
| Var(u|X)=σ²I y condiciones anteriores | Propiedad MELI de MCO. | Precisión alta en cualquier diseño. |
| Normalidad condicional conjunta y n>p | Inferencia t/F exacta con el resto del modelo normal. | Causalidad ni ausencia de mala especificación. |
| Familia, enlace y estructura condicional de un MLG | Un modelo de media y variación compatible con el soporte. | Existencia automática de un máximo finito. |
| Regularidad inferencial y muestra informativa | Aproximaciones asintóticas justificables. | Una regla universal sobre conteos o tamaño. |
| Validación compatible con el uso | Evidencia sobre predicción en la tarea evaluada. | Transferencia garantizada a otra población. |
El modelo ofrece una mediación matemática entre mediciones y preguntas científicas. Una distribución o un parámetro no sustituye el fenómeno: selecciona aspectos de su variación bajo condiciones determinadas. La acumulación económica, la organización institucional o la historicidad de un proceso pueden orientar la especificación, pero deben conectarse con mecanismos observables y un diseño que sostenga las inferencias.
Estimar una relación, medir su incertidumbre, predecir y explicar causalmente son tareas relacionadas que exigen justificaciones diferentes.
Un informe responsable explicita la respuesta y su escala, el diseño y la muestra, la función de media, la distribución o covarianza, el estimador, los diagnósticos, la incertidumbre y el ámbito de generalización. La evaluación multidimensional consiste en mantener conectadas esas dimensiones, en lugar de reducir la validez a un único valor p o a un R² alto.
20Glosario de distinciones esenciales
- Error / residuo
- Desviación respecto del modelo poblacional / diferencia respecto del ajuste calculado.
- Insesgamiento / consistencia
- Propiedad de la esperanza en muestreo repetido / convergencia hacia el objetivo al crecer la información bajo un régimen asintótico especificado.
- Eficiencia / precisión
- Comparación de varianzas dentro de una clase / magnitud concreta de incertidumbre.
- Independencia / incorrelación
- Factorización de la distribución conjunta / covarianza cero cuando existe; la segunda no implica la primera.
- Linealidad / rectitud
- Dependencia lineal en coeficientes / forma geométrica de una gráfica en variables elegidas.
- Enlace / transformación de la respuesta
- Función aplicada a la media condicional / función aplicada al valor observado; sus objetivos no son generalmente equivalentes.
- Sobredeterminación / sobreajuste
- Más ecuaciones que incógnitas / adaptación al entrenamiento que perjudica la predicción pertinente.
- Parámetro / estadístico
- Característica del modelo poblacional / función calculada de observaciones, incluida pero no limitada a una función de prueba.
- MLG / MCG
- Modelo lineal generalizado / mínimos cuadrados generalizados; familia probabilística y método de estimación no son sinónimos.
- Celda / unidad muestral
- Entrada de una tabla de frecuencias / elemento seleccionado según el diseño de muestreo.
21Referencias y fuentes
Las referencias siguientes sostienen la exposición revisada. Las figuras son reconstrucciones didácticas originales y simulaciones; no son reproducciones de las láminas de Greene o Gujarati y Porter.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. Journal of the Anthropological Institute, 15, 246–263. Consultar.
- Perezgonzalez, J. D. (2015). Fisher, Neyman–Pearson or NHST? A tutorial for teaching data testing. Frontiers in Psychology, 6, 223. Consultar.
- University of Illinois Urbana–Champaign, CS 357. Least Squares Fitting. Consultar.
- Taboga, M. (2021). Gauss Markov theorem. Lectures on Probability Theory and Mathematical Statistics. Consultar.
- NIST/SEMATECH. Transformations to Improve Fit and Equalize Variances. e-Handbook of Statistical Methods, §4.6.2.4. Consultar.
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning, with Applications in R. 2nd ed. Springer. Consultar.
- Penn State University, STAT 462. 10.7 — Detecting Multicollinearity Using Variance Inflation Factors. Consultar.
- Salmerón Gómez, R., Blanco Izquierdo, V., & García García, C. (2016). Micronumerosidad aproximada y regresión lineal múltiple. Anales de ASEPUMA, 24, 1–17. Consultar.
- Gujarati, D. N., & Porter, D. C. (2010). Econometría. 5.ª ed. McGraw-Hill.
- McCullagh, P. (1992). Introduction to Nelder and Wedderburn (1972): Generalized Linear Models. In Breakthroughs in Statistics, vol. II, 543–546. Consultar.
- R Core Team. Family Objects for Models. Documentation for stats::family. Consultar.
- R Core Team. Fitting Generalized Linear Models. Documentation for stats::glm. Consultar.
- Penn State University, STAT 504. Advanced Topics II: sparse tables and chi-squared approximations. Consultar.
- Greene, W. H. (2012). Econometric Analysis. 7th ed. Pearson.
- McCullagh, P., & Nelder, J. A. (1989). Generalized Linear Models. 2nd ed. Chapman & Hall.
- JOSÉ MAURICIO GÓMEZ JULIÁN (2021; publicado originalmente como Isadore Nabi). Supuestos del modelo clásico de regresión lineal y de los modelos lineales generalizados. Consultar.
- MIT CSAIL. Solving over- and under-determined sets of equations. Consultar.
- Penn State University, STAT 462. 12.4 — Generalized Linear Models. Consultar.
- R Core Team. Predict Method for GLM Fits. Consultar.
Fuentes complementarias conservadas del artículo de 2021
Se conservan para trazabilidad bibliográfica. Los foros y textos divulgativos no sustituyen las definiciones ni las condiciones matemáticas desarrolladas arriba. Algunos enlaces históricos pueden haber cambiado.
- Banerjee, A. (2019). Intuition behind model fitting: Overfitting v/s Underfitting.
- Bhuptani, R. (2020). What is the difference between linear regression and least squares? Quora.
- Cross Validated (2018). Will log transformation always mitigate heteroskedasticity?
- Guanga, A. (2018). Machine Learning: Bias VS. Variance.
- Nabi, I. (2021). Modelos lineales generalizados.
- Penn State University, STAT 462. 10.4 — Multicollinearity.
- Penn State University, STAT 504. Introduction to Generalized Linear Models. Enlace citado en 2021.
- ResearchGate (2014). How it can be possible to fit the four-parameter Fedlund model by only 3 PSD points?
- ResearchGate (2019). Is there a rule for how many parameters I can fit to a model, depending on the number of data points I use for the fitting?
- Simon Fraser University (2011). The Classical Model.
- Cross Validated (2017). “Least Squares” and “Linear Regression”, are they synonyms?
- Wikipedia (2021). Overdetermined system.
- Zhao, J. (2017). More features than data points in linear regression?
Leave a Comment/Deja un Comentario