Sobre el Análisis de Componentes Principales (PCA)
Intuición geométrica, fundamentos algebraicos, interpretación estadística y alcance epistemológico de la reducción de dimensionalidad
Representar un fenómeno mediante muchas variables permite describirlo con riqueza, pero también puede dificultar la identificación de sus principales relaciones. El análisis de componentes principales —PCA, por su denominación inglesa, Principal Component Analysis— construye coordenadas nuevas para estudiar la variación conjunta de esas variables. La pregunta decisiva es cómo reducir la complejidad de una representación sin perder de vista qué se conserva, qué se descarta y bajo qué condiciones resulta legítima su interpretación.
Este ensayo desarrolla el PCA desde cuatro perspectivas conectadas: como transformación geométrica de una nube de observaciones; como problema de optimización con restricciones; como descomposición matricial; y como instrumento de exploración e interpretación científica. Se mantienen los ejemplos de expresión génica y evaluación financiera, los criterios de retención de componentes, los diagnósticos gráficos, la distancia de Mahalanobis, la discusión de NIPALS y la comparación con regresión lineal. Se amplían la derivación matemática, la reproducibilidad y las condiciones de validez de las inferencias.
Nota de edición. Se conservan todos los ejes temáticos y las 51 figuras del documento de 2021. Las formulaciones que requerían precisión se revisan en el desarrollo; las imágenes originales se reúnen, sin recortes, en el archivo visual y mantienen sus atribuciones. El PDF histórico permanece disponible al final.
I. Variables, atributos y dimensionalidad
Un conjunto de datos organiza observaciones de determinadas unidades de estudio: personas, animales, empresas, territorios, productos o estados de un sistema físico. Cada unidad se describe mediante variables. Si se registran p variables numéricas sobre n unidades, la representación habitual es una matriz X de tamaño n × p: las filas corresponden a observaciones y las columnas a variables. Cada fila puede interpretarse como un punto del espacio de características ℝp.
La palabra atributo exige una precisión. En ciencia de datos puede designar una característica medida; en R también nombra metadatos asociados a un objeto, como sus dimensiones, nombres o clase. La observación de Adler sobre la importancia de los atributos de los objetos de R es pertinente para comprender su representación informática, pero esos metadatos no deben identificarse automáticamente con las variables estadísticas de una investigación. Un atributo de clase puede modificar cómo interpreta R un objeto sin añadir una dimensión al fenómeno medido. [1]
La dimensionalidad de la representación es el número de coordenadas utilizadas. La dimensionalidad intrínseca, en cambio, se refiere a los grados de libertad necesarios para describir la estructura subyacente, según el modelo considerado. Una nube situada aproximadamente sobre un plano puede tener muchas coordenadas y, sin embargo, admitir una representación aproximadamente bidimensional. Con ruido, la dimensionalidad efectiva depende además de la tolerancia de aproximación. No existe siempre un único número mínimo independiente del propósito del análisis.
Selección de variables y extracción de componentes
Reducir dimensiones admite estrategias diferentes. La selección de variables conserva un subconjunto de las columnas originales; la extracción de características construye variables nuevas a partir de ellas. El PCA pertenece a la segunda familia: una componente puede combinar información de todas las variables iniciales. No consiste, por definición, en identificar cuáles columnas deben eliminarse ni en resolver una búsqueda combinatoria entre subconjuntos. Tales problemas pueden vincularse al PCA, pero tienen una formulación distinta.
Esta distinción también delimita el significado de «información esencial». En el PCA ordinario, el criterio operativo es la varianza representada por un subespacio lineal. Que esa variación sea esencial para una explicación biológica, económica o social requiere un argumento adicional sobre las mediciones, la escala, el contexto y la pregunta de investigación.
II. Bellman, Pearson y el problema de la representación
La expresión maldición de la dimensionalidad, asociada a Richard Bellman, reúne dificultades que aparecen al aumentar el número de dimensiones: crecimiento del costo de ciertos procedimientos, escasez relativa de observaciones, pérdida de eficacia de algunas nociones de vecindad y necesidad de imponer estructura al problema. En una malla con diez posiciones por eje, explorar sistemáticamente p dimensiones produce 10p combinaciones. Es una ilustración de crecimiento exponencial, no una ley universal que obligue a todo método estadístico a requerir exactamente esa cantidad de datos. [3]
La dificultad depende del problema, la distribución, la regularidad y las relaciones entre variables. Por eso conviene distinguir el espacio de características del espacio muestral de la teoría de la probabilidad: el primero organiza coordenadas observables; el segundo contiene los resultados posibles del experimento. Pueden relacionarse mediante variables aleatorias, pero no son conceptos intercambiables.
En 1901, Karl Pearson estudió líneas y planos de mejor ajuste a sistemas de puntos. Su enfoque geométrico permite aproximar una nube mediante una recta o un plano minimizando la suma de los cuadrados de las distancias ortogonales. La posterior formulación de Hotelling contribuyó a consolidar el análisis de componentes principales como técnica multivariada. Esta genealogía es anterior al vocabulario contemporáneo del aprendizaje automático. [11] [22]
El documento original caracteriza políticamente a Pearson como marxista. Se conserva aquí la cuestión de la relación entre biografía intelectual, historia de la estadística y filosofía de la ciencia, pero esa clasificación requiere una investigación histórica específica y no se utiliza como premisa de la derivación del PCA. La validez matemática del método y la evaluación histórica de su autor pertenecen a planos de argumentación que deben fundamentarse por separado.
La línea de Pearson proporciona una intuición útil: una nube alargada puede describirse con relativa precisión mediante una coordenada sobre su dirección dominante. Sin embargo, identificar esa dirección no implica demostrar una causa del fenómeno. El ajuste describe una estructura de variación de las mediciones; su explicación exige teoría y evidencia adicionales.
III. Definición y optimización del PCA
Sean x un vector aleatorio de p variables, μ su media y Σ su matriz de covarianza, suponiendo segundos momentos finitos. La primera componente principal es una combinación lineal de las variables centradas cuya varianza es máxima, bajo una restricción de normalización de sus coeficientes. En el análisis de una muestra sustituimos la covarianza poblacional por su estimación S.
maximizar aTΣa, sujeto a aTa = 1.
El vector a₁ define una dirección; la componente es la variable obtenida al proyectar sobre ella. La restricción unitaria impide aumentar artificialmente la varianza multiplicando todos los coeficientes por una constante.
Sin esa restricción, multiplicar a por un número arbitrariamente grande incrementaría sin límite la varianza de la combinación. La normalización hace comparable la variación de distintas direcciones. La segunda componente maximiza la varianza restante, con un vector de coeficientes unitario y ortogonal al primero. El procedimiento continúa de manera sucesiva.
sujeto a aTa = 1 y aTaℓ = 0 para ℓ < k.
Cada nueva dirección se elige en el complemento ortogonal de las anteriores. Esta formulación caracteriza la solución, con independencia del algoritmo usado para calcularla.
La función de Lagrange para la primera dirección es L(a, λ) = aTΣa − λ(aTa − 1). La condición de estacionariedad conduce a Σa = λa. Por tanto, las direcciones principales son autovectores de la matriz de covarianza y sus varianzas son los autovalores correspondientes. La primera dirección se asocia al mayor autovalor; las restantes se ordenan en sentido decreciente. Si existen autovalores repetidos, una base particular del subespacio asociado puede no ser única.
La interpretación matemática tiene dos niveles. Los autovectores especifican cómo combinar las coordenadas originales; los autovalores cuantifican la variación a lo largo de esas combinaciones. Las puntuaciones de las observaciones muestran dónde queda cada unidad de estudio en el nuevo sistema de coordenadas. Mantener separados estos tres objetos evita confundir pesos, observaciones y cantidades de variación.
La dirección indica cómo mirar los datos; la puntuación sitúa una observación en esa mirada; el autovalor mide cuánta variación aparece en ella.
IV. Dos genes y seis ratones
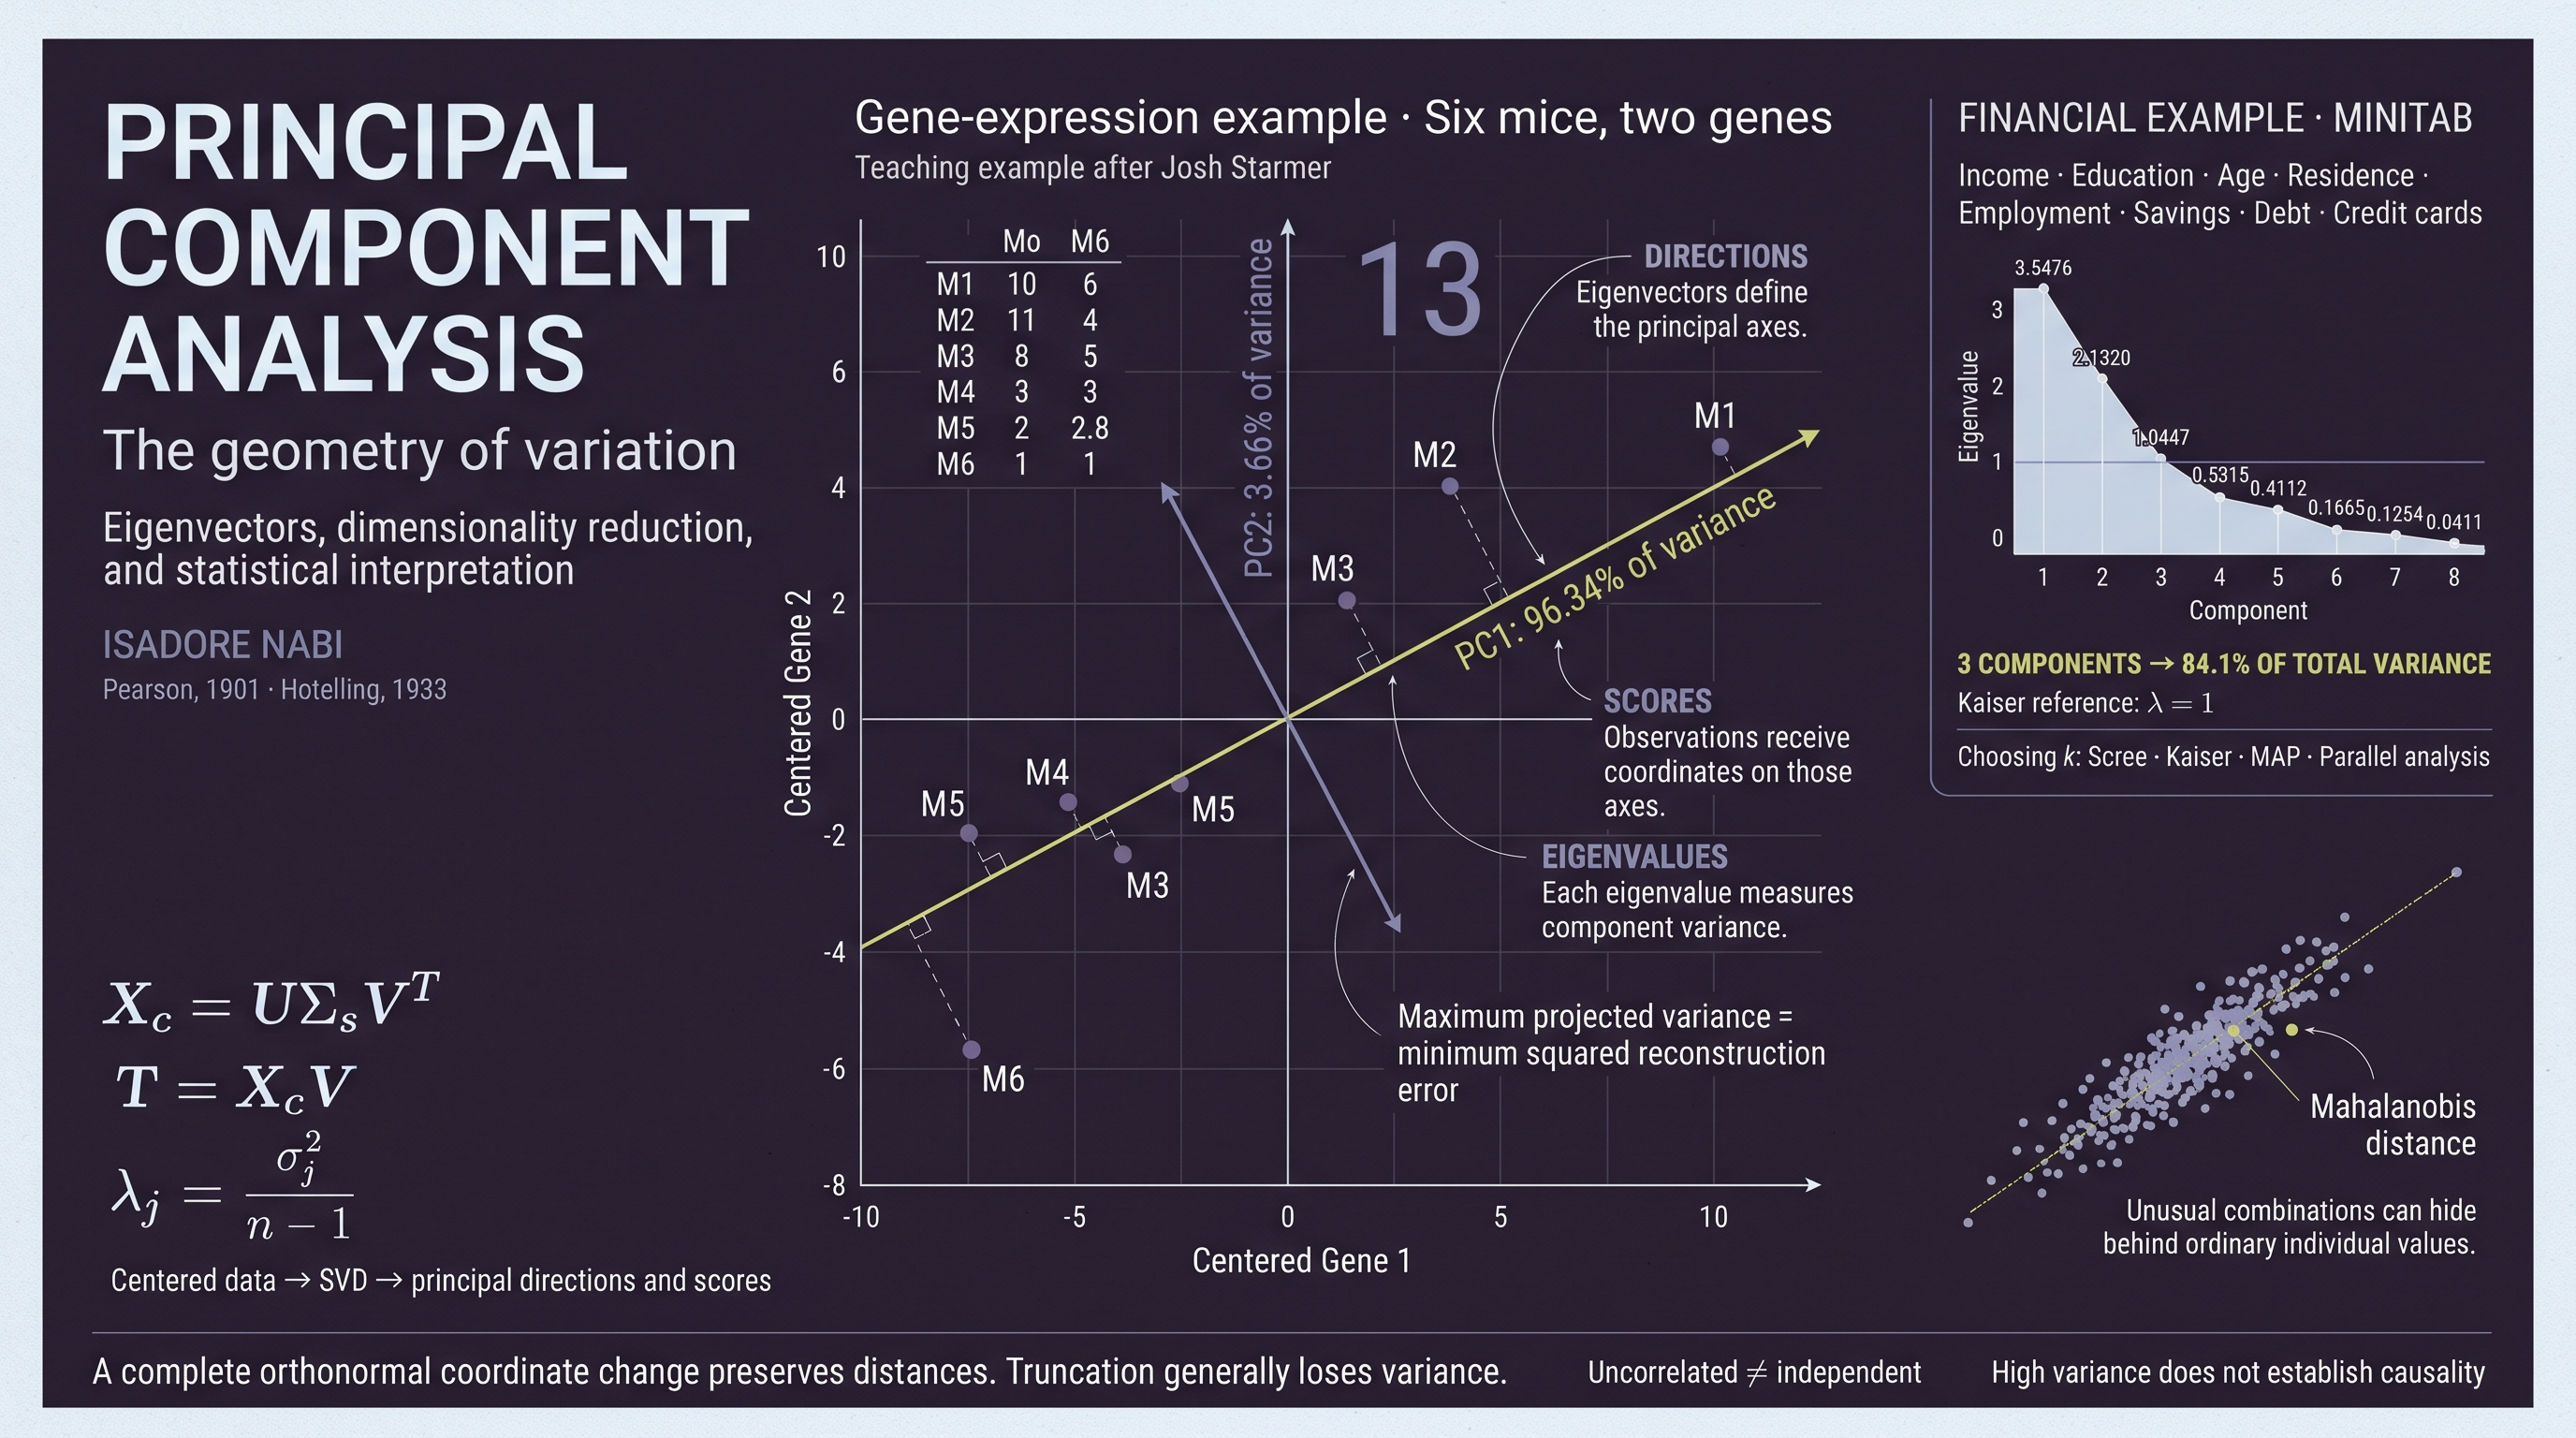
Siguiendo el ejemplo pedagógico de Josh Starmer utilizado en el documento original, consideremos seis ratones descritos mediante medidas de expresión de dos genes. Las unidades de estudio son los ratones y las variables son los genes. La transcripción es la síntesis de ARN a partir de ADN; debe distinguirse de la traducción que produce proteínas. Las cantidades se mantienen como valores didácticos: no se les atribuye una unidad experimental ni una precisión biológica que el ejemplo no documenta. [13]
| Ratón | Gen 1 | Gen 2 |
|---|---|---|
| 1 | 10 | 6 |
| 2 | 11 | 4 |
| 3 | 8 | 5 |
| 4 | 3 | 3 |
| 5 | 2 | 2,8 |
| 6 | 1 | 1 |
En un gráfico bidimensional, cada ratón ocupa la posición definida por sus dos mediciones. Los primeros tres presentan valores relativamente altos en ambos genes y los restantes valores menores. La nube permite formular preguntas sobre covariación y agrupamientos, sin que una figura por sí sola establezca diferencias poblacionales o mecanismos causales.
El primer paso del PCA centrado consiste en restar a cada variable su media. Para estos valores, la media del gen 1 es aproximadamente 5,8333 y la del gen 2 es 3,6333. El centroide se traslada al origen; las diferencias entre pares de observaciones permanecen intactas.
Xc = X − 1x̄T.
El superíndice c denota centrado; 1 es un vector columna de n unos. Centrar no equivale a dividir por desviaciones estándar.
La secuencia original de Starmer se conserva íntegramente en el archivo visual. La nueva figura muestra los mismos seis puntos centrados, con la dirección principal calculada a partir de la tabla y los residuos ortogonales que intervienen en el criterio de ajuste.

El ejemplo sirve para aprender la mecánica geométrica. Un estudio real de expresión génica exige considerar el proceso de medición, profundidad de secuenciación, transformaciones apropiadas, efectos de lote, replicación e incertidumbre. El PCA de una tabla de conteos sin preparar puede reflejar magnitudes técnicas antes que diferencias biológicas de interés.
V. Transformaciones, estructura y conservación
Una transformación es una aplicación entre espacios. Puede ser lineal, afín o de otra naturaleza. No tiene por qué llevar un dominio al mismo conjunto: en general se escribe f: D → C y su imagen es el conjunto de valores efectivamente alcanzados en el codominio. Para el PCA ordinario importan especialmente las traslaciones, los cambios ortogonales de coordenadas y las proyecciones sobre subespacios.
| Transformación | Caracterización | Qué conviene distinguir |
|---|---|---|
| Traslación | x ↦ x + b | Preserva distancias y diferencias entre puntos; generalmente no es lineal porque no fija el origen. |
| Rotación | x ↦ Qx, con QTQ = I y det Q = 1 | Preserva productos internos, normas, ángulos y distancias. |
| Reflexión | Transformación ortogonal con cambio de orientación | También conserva distancias. Una matriz ortogonal puede combinar rotaciones y reflexiones. |
| Dilatación o contracción uniforme | x ↦ cx | Multiplica todas las distancias por |c|; es isometría solo cuando |c| = 1. |
| Estiramiento en uno o varios ejes | x ↦ Dx, con D diagonal | Modifica la geometría relativa cuando los factores de escala son distintos. |
| Cizallamiento | Deformación lineal que desplaza coordenadas según otras | Puede preservar áreas o volúmenes en casos específicos, pero generalmente altera ángulos y longitudes. |
| Proyección ortogonal | x ↦ Px, con PT = P y P² = P | Generalmente no es invertible; al reducir dimensiones puede contraer distancias y hacer coincidir puntos diferentes. |
Isomorfismo, homeomorfismo e isometría
Un isomorfismo preserva la estructura que se haya especificado: por ejemplo, suma y multiplicación por escalares en espacios vectoriales. Un homeomorfismo es una biyección continua con inversa continua. Una isometría preserva distancias; cuando además es sobreyectiva, establece una equivalencia de espacios métricos. Estas nociones se relacionan, pero ninguna debe emplearse como sustituto indiscriminado de las otras.
Conservar la topología no implica conservar la norma ni la métrica: multiplicar todas las coordenadas por dos proporciona un contraejemplo elemental. La transformación es un homeomorfismo de ℝp y altera todas las distancias no nulas. Asimismo, una traslación preserva distancias sin ser un isomorfismo lineal para las operaciones vectoriales originales, salvo que sea la traslación nula.
En un espacio con producto interno, la norma euclidiana se define por ‖x‖ = √⟨x,x⟩ y la distancia inducida por d(x,y) = ‖x − y‖. La norma mide longitud de vectores; la métrica mide distancia entre puntos. Los espacios de Hilbert generalizan este marco a espacios completos con producto interno. Estas extensiones ayudan a situar el PCA en un paisaje matemático amplio, pero no autorizan a trasladar sin demostración sus propiedades a cualquier espacio normado.
La discusión filosófica de materia y forma
La reflexión original sobre Aristóteles y Platón puede mantenerse como una pregunta por el vínculo entre los elementos de un sistema y las relaciones que lo organizan. Conviene, sin embargo, distinguir esa interpretación filosófica de la definición matemática de estructura. Clasificar objetos «salvo isomorfismo» significa agruparlos según una equivalencia estructural especificada; no significa que pertenezcan a cualquier clasificación ni que no pertenezcan a ninguna.
Desde una perspectiva materialista, la abstracción matemática puede examinarse como una operación que selecciona propiedades de fenómenos concretos para estudiar relaciones determinadas. La exigencia crítica es declarar qué se abstrae y qué se conserva. En el PCA se conservan exactamente ciertas propiedades al cambiar una base ortonormal completa; otras solo se aproximan cuando se descartan coordenadas. El análisis filosófico gana precisión cuando parte de esa diferencia.
VI. Proyección ortogonal y reconstrucción
Sea a un vector unitario que define una recta por el origen y sea z una observación centrada escrita como vector columna. Su coordenada sobre esa recta es t = aTz. Su proyección en el espacio original es ẑ = aaTz. La diferencia e = z − ẑ es perpendicular a la dirección de proyección.
‖z‖² = ‖ẑ‖² + ‖e‖².
El teorema de Pitágoras expresa la descomposición de la longitud al cuadrado en una parte representada y una residual.
Para una nube centrada fija, la suma de ‖z‖² sobre todas las observaciones es constante. Por eso maximizar la suma de las longitudes proyectadas al cuadrado equivale a minimizar la suma de los residuos ortogonales al cuadrado. La equivalencia depende de la misma geometría, del mismo conjunto de datos y de comparar subespacios de igual dimensión.
Las dos formulaciones no distinguen un PCA «analítico» de otro «numérico». Son objetivos matemáticamente equivalentes que pueden resolverse con distintos algoritmos.
El cuadrado es esencial. Minimizar la suma de distancias sin elevar al cuadrado define, en general, un problema diferente y puede conducir a otra solución. Tampoco es necesario calcular los componentes mediante desigualdades de Minkowski o de Cauchy–Schwarz: esas herramientas permiten demostrar propiedades de normas y productos internos, pero no sustituyen una especificación del procedimiento de optimización.
La proyección es una transformación lineal que puede definirse sin elegir coordenadas. Una vez elegida una base, admite una representación matricial precisa; no existe una oposición entre proyección «puramente matemática» y matriz «meramente computacional». Para un subespacio con columnas ortonormales reunidas en Vk, la matriz de proyección es Pk = VkVkT.
La discusión original de geometría proyectiva se conserva como contexto, con una delimitación: la proyección ortogonal del PCA pertenece aquí a la geometría euclidiana y al álgebra lineal. No necesita confundirse con toda la geometría proyectiva, cuyo desarrollo histórico es colectivo y no puede atribuirse sin más a Lobachevski.
En varias dimensiones, el criterio se escribe como la minimización de la norma de Frobenius de los residuos de reconstrucción. La aproximación mediante los primeros k componentes es óptima entre las aproximaciones de rango a lo sumo k bajo esa pérdida cuadrática. «Óptima» siempre significa óptima respecto de un criterio declarado; no respecto de toda finalidad científica posible.
‖Xc − X̂c,k‖F² = (n − 1) ∑j>k λj.
La igualdad usa autovalores de la covarianza muestral con divisor n − 1. Para reconstruir en las coordenadas originales se añade la media; si se estandarizó, también se revierte el escalamiento.
VII. Pendiente, vectores unitarios y componentes
La explicación geométrica original utiliza una recta con pendiente 0,25, representada por un desplazamiento de cuatro unidades en el primer eje y una en el segundo. Su vector director es (4,1)T. La longitud de ese vector es √17 ≈ 4,1231; al dividir sus coordenadas por esa longitud se obtiene una dirección unitaria.
a2 = (−1,4)T/√17 ≈ (−0,2425; 0,9701)T.
Los vectores tienen norma uno y producto interno nulo. Los valores redondeados 0,97 y 0,242 del material original ilustran esta normalización.
La recta puede escribirse como y = 0,25x; su pendiente coincide con la derivada de esa función lineal. Pero los coeficientes de la dirección principal no son, en general, «las derivadas del fenómeno». Aquí la pendiente es el cociente entre las coordenadas del vector director. El autovector unitario contiene una representación normalizada de esa dirección y se determina por la estructura de covarianza de los datos.
Normalizar (4,1) no consiste en estandarizar cada observación ni en convertir los datos en una distribución normal. Tampoco hace que la media de una nube sea cero. Produce un vector de longitud unitaria. Con esa dirección, la primera coordenada de una observación centrada sería aproximadamente t1 = 0,9701x1c + 0,2425x2c; la segunda sería t2 = −0,2425x1c + 0,9701x2c.
La dirección (4,1) pertenece a la explicación gráfica del original. Los ejes calculados exactamente a partir de la tabla de seis ratones pueden diferir de esa pendiente didáctica. Para mantener trazabilidad, la figura nueva y la tabla numérica de esta edición utilizan la SVD de los valores transcritos, mientras el archivo visual conserva la construcción original.
La desigualdad de Cauchy–Schwarz garantiza que |⟨x,a⟩| ≤ ‖x‖‖a‖ y permite controlar la longitud de una proyección. La desigualdad de Minkowski expresa la desigualdad triangular para normas Lp, con p ≥ 1. Pitágoras proporciona una identidad exacta cuando los componentes son ortogonales en un espacio con producto interno. Estas relaciones cumplen funciones diferentes; no son tres algoritmos alternativos para «encontrar» los componentes.
VIII. Autovalores, autovectores y SVD
Para la matriz centrada Xc, con observaciones en filas, la covarianza muestral es S = XcTXc/(n − 1). Es una matriz real, simétrica y semidefinida positiva. Por el teorema espectral admite una base ortonormal de autovectores, reunidos como columnas de V. Sus autovalores son reales y no negativos.
Λ = diag(λ1, …, λp), λ1 ≥ ⋯ ≥ λp ≥ 0
T = XcV, Cov(T) = Λ.
V describe las direcciones y T contiene las puntuaciones. La matriz diagonal Λ concentra las varianzas y expresa la incorrelación muestral entre componentes distintos.
La descomposición en valores singulares de la matriz de datos proporciona la misma solución del PCA centrado. En su forma reducida, si el rango es r, se escribe Xc = UΣsVrT, con U de tamaño n × r, Vr de tamaño p × r y Σs diagonal de tamaño r × r. El subíndice distingue los valores singulares de la covarianza poblacional.
λj = σj²/(n − 1), σj = √((n − 1)λj).
Los valores singulares de Xc son raíces cuadradas de los autovalores de XcᵀXc. Para obtener las varianzas de los componentes debe incluirse el divisor n − 1.
Qué diferencia a ambas descomposiciones
La SVD existe para cualquier matriz real rectangular o cuadrada. Una diagonalización por semejanza exige una matriz cuadrada y no siempre es posible; para matrices generales, los autovalores pueden ser complejos y una base de autovectores puede no ser ortogonal. Sin embargo, esas advertencias generales no describen una dificultad de la matriz de covarianza del PCA: su simetría garantiza una diagonalización ortogonal y su semidefinición positiva garantiza autovalores no negativos.
En una diagonalización general A = PDP−1, las matrices laterales son inversas. En una SVD A = UΣVT, las matrices U y V tienen papeles diferentes y no son, en general, inversas entre sí. Si son rectangulares, ni siquiera tiene sentido atribuirles una inversa bilateral. En sus versiones cuadradas completas representan transformaciones ortogonales; una SVD reducida contiene bases ortonormales de subespacios.
El vínculo entre autovectores y vectores singulares es especialmente directo en el PCA, porque los vectores singulares derechos de Xc son autovectores de S. No estamos ante dos teorías incompatibles, sino ante dos formulaciones conectadas que permiten calcular la misma representación bajo las mismas convenciones de centrado y escala. [2] [4]
Varianza explicada y varianza descartada
Ck = ∑j=1k ρj, Rk = 1 − Ck.
ρj es la proporción explicada por el componente j; Ck es la acumulada en los primeros k; Rk es la fracción de varianza excluida de esa representación. Se supone varianza total positiva.
El autovalor de un componente retenido representa variación conservada en ese eje, no «información perdida». La pérdida de reconstrucción se relaciona con la suma de los autovalores descartados. Esta relación cuadrática no convierte la varianza en una medida universal de significado, causalidad o información en el sentido de Shannon.
IX. Centrado, estandarización y elección de matriz
El centrado resta la media. La estandarización por puntuaciones z resta la media y divide por la desviación estándar de cada variable. La normalización de un vector, en el sentido usado antes, divide por su norma. Son operaciones diferentes, aunque todas pueden describirse informalmente como cambios de escala.
R = ZTZ/(n − 1).
Si sj se calcula con el divisor n − 1, la covarianza muestral de Z es la matriz de correlaciones R de las variables originales. Las columnas constantes requieren tratamiento previo.
La transformación z produce media cero y varianza unitaria según la convención usada. No impone normalidad: una distribución asimétrica sigue siendo asimétrica después de una transformación afín con escala positiva. El PCA descriptivo puede calcularse sin suponer una distribución normal multivariada; ciertos contrastes, intervalos o límites de control sí exigen supuestos adicionales.
| Base del análisis | Interpretación | Decisión sustantiva |
|---|---|---|
| Covarianzas | Se analizan las variables centradas en sus escalas de medición. | Puede ser apropiado cuando las unidades son comparables y las diferencias de varianza tienen significado. |
| Correlaciones | Se analiza la covarianza de variables estandarizadas. | Da a cada variable la misma varianza inicial; suele ser pertinente con unidades heterogéneas, aunque también puede amplificar variables poco fiables. |
Una variable medida en miles puede dominar a otra medida en fracciones si el cambio de unidades incrementa su varianza. Pero el tamaño de la media no determina, por sí solo, la varianza de una variable. La decisión de escalar exige examinar dispersión, unidades y propósito, no solo valores absolutos grandes o pequeños.
La estandarización modifica el problema geométrico: establece una ponderación diferente de las coordenadas originales. No debe presentarse como una operación neutral que siempre mejora el análisis. También importa declarar si la desviación estándar utiliza n o n − 1. En una misma muestra, aplicar coherentemente uno u otro divisor a todas las variables solo introduce un factor común entre las dos estandarizaciones; las direcciones y proporciones de varianza coinciden, pero las magnitudes de las puntuaciones y varianzas cambian.
La relación con el ensayo sobre reescalamiento del mismo autor sigue siendo pertinente. La versión web debe conservar ese enlace y enfatizar estas distinciones para que ambos textos se apoyen sin reproducir la confusión entre estandarizar y normalizar una distribución. [9]
X. Ortogonalidad, incorrelación y rango
Dos vectores no nulos con producto interno cero son ortogonales y, por ello, linealmente independientes. La recíproca no es cierta: dos vectores pueden ser linealmente independientes sin ser perpendiculares. «Ortogonal» y «perpendicular» no designan propiedades reservadas respectivamente a tres y dos dimensiones; la noción de ortogonalidad se aplica en cualquier dimensión dentro del marco de un producto interno.
Para los coeficientes de componentes distintos, ajTak = 0. Para las variables principales, la covarianza es ajTΣak = 0. Estas igualdades se conectan por la ecuación de autovalores. No deben confundirse con la independencia estadística, que exige la factorización de la distribución conjunta.
Si U tiene distribución uniforme en [−1,1], las variables U y U² tienen covarianza cero por simetría, pero U² está completamente determinada por U. La ausencia de correlación lineal no elimina la dependencia. En el caso de una distribución conjunta normal, la incorrelación entre componentes sí permite concluir independencia.
El número de componentes con varianza positiva es el rango de la matriz centrada. Para n observaciones y p variables, ese rango no supera min(n − 1, p). Una descomposición completa de la covarianza puede proporcionar p autovectores, pero algunos autovalores serán cero cuando exista dependencia lineal o insuficiente rango muestral.
Si se conserva una base ortonormal completa de ℝp, el cambio de coordenadas preserva distancias euclidianas. Si se retienen todos los componentes de varianza positiva, también se reconstruye exactamente la nube centrada observada. Con menos componentes, la aproximación generalmente deja residuos; esos residuos desaparecen solo cuando los datos ya pertenecen al subespacio retenido.
El orden de los ejes está fijado por los autovalores, salvo empates; su orientación de signo es arbitraria. Cambiar simultáneamente aj por −aj y las puntuaciones por sus opuestas describe la misma solución. Por ello no se comparan signos aislados entre programas sin alinear primero sus convenciones.
XI. Cuántos componentes conservar
Retener componentes es una decisión metodológica. Depende del objetivo, la calidad de las mediciones y el costo de descartar variación. Un plano puede ser útil para visualizar y resultar insuficiente para otra tarea. El documento original reúne Kaiser, Cattell, MAP, Bartlett, Horn y Lawley; se mantienen todos, precisando sus ámbitos. [15]
Varianza acumulada y error de reconstrucción
Puede elegirse el menor k que alcance una proporción de varianza previamente justificada. Umbrales como 80 %, 90 % o 95 % son decisiones convencionales, no garantías de suficiencia científica. Para una aplicación predictiva, la selección debe contrastarse con desempeño fuera de muestra; para reconstrucción puede justificarse mediante un error tolerable en las unidades pertinentes.
Kaiser (1960): autovalores mayores que uno
En un PCA sobre correlaciones, cada variable estandarizada aporta varianza uno y el promedio de los p autovalores es uno. La regla conserva componentes con λ > 1, es decir, que explican más variación que una variable estandarizada promedio. Ese fundamento no se traslada automáticamente a una covarianza con unidades arbitrarias. La regla puede retener demasiados o demasiado pocos componentes y no debe funcionar como decisión automática.
Cattell (1966): gráfico de sedimentación
El scree test busca un cambio de pendiente entre los primeros autovalores y una cola más plana. Aporta una lectura visual de rendimientos decrecientes. La presencia de un «codo» puede ser ambigua; distintas personas pueden señalar cortes diferentes y algunos espectros no muestran una inflexión clara. La propuesta original de examinar una línea base en la cola puede conservarse como ayuda gráfica, explicitando su componente interpretativo.
Velicer (1976): mínimo promedio parcial (MAP)
El criterio MAP examina la correlación residual entre variables después de retirar sucesivamente componentes y normalizar los residuos para obtener correlaciones parciales. Se busca un mínimo del promedio de sus cuadrados fuera de la diagonal. La intuición es detenerse cuando retirar más componentes deja de reducir de manera útil la asociación residual y empieza a extraer estructura específica o ruido.
El MAP no debe confundirse con la selección de un porcentaje de varianza ni con un contraste universal de causalidad latente. La recomendación citada en el original de contar con varias variables de peso alto puede ser útil para una interpretación estable, pero no es una identidad matemática que defina al criterio. Existen implementaciones accesibles, como las documentadas en psych, por lo que la dificultad práctica de acceso debe actualizarse. [24]
Bartlett (1950, 1951): contraste sobre autovalores restantes
La familia de pruebas mencionada en el original evalúa hipótesis sobre la estructura de los autovalores restantes, como su igualdad, bajo supuestos de distribución y aproximaciones específicas. No equivale al conocido contraste de esfericidad aplicado a la matriz de correlación completa. Cuando se usa secuencialmente, deben declararse la hipótesis exacta, los grados de libertad, el tamaño muestral y el criterio de parada.
No rechazar una hipótesis no demuestra que sea verdadera: también puede reflejar baja potencia. Tampoco toda significación estadística obliga a añadir una dimensión útil. La interpretación debe distinguir el contraste de estructura poblacional de la decisión práctica sobre una representación.
Horn (1965): análisis paralelo
El análisis paralelo compara los autovalores observados con los obtenidos bajo una referencia aleatoria del mismo tamaño n × p. La simulación o permutación reproduce un escenario de asociación ausente según un mecanismo explícito. Se retienen los componentes cuyos autovalores superan el valor de referencia correspondiente. Es necesario declarar si se compara con medias o con un cuantil, por ejemplo el percentil 95, y cuántas réplicas se emplean.
La lógica corrige una limitación de Kaiser: aun cuando la correlación poblacional sea la identidad, los autovalores muestrales fluctúan y no serán todos exactamente uno. También debe especificarse si el análisis paralelo se plantea para componentes o para factores comunes, pues las matrices y comparaciones no son idénticas. [25]
Lawley (1940): razón de verosimilitudes y análisis factorial
Los procedimientos de razón de verosimilitudes asociados al análisis factorial por máxima verosimilitud evalúan si un número de factores permite reproducir adecuadamente una estructura de covarianzas o correlaciones bajo un modelo probabilístico. Se mantienen aquí como parte del panorama original, pero no se presentan como una propiedad automática del PCA descriptivo.
Un modelo de factores comunes distingue variación compartida y variación específica; el PCA descompone la variación total de las variables analizadas. Confundir componentes con factores puede llevar a aplicar criterios o interpretaciones fuera de su marco. Cuando un programa ofrece ambos procedimientos, debe comprobarse cuál se ha ejecutado.
Conviene informar el criterio principal, contrastarlo con otro de naturaleza distinta, examinar la estabilidad de los resultados y justificar las diferencias. Ninguna regla sustituye el juicio científico. Si el objetivo cambia de visualización a predicción o a un modelo de factores latentes, también puede cambiar la elección apropiada de dimensiones.
XII. Interpretación del ejemplo financiero
El documento utiliza una salida de Minitab basada en ocho variables: ingresos, educación, edad, residencia, empleo, ahorros, deuda y tarjetas de crédito. Se reproduce la tabla de autovalores y la matriz completa de coeficientes que figuran en esa salida. Las etiquetas requieren consultar cómo se midió o codificó cada variable; «residencia», por ejemplo, no identifica por sí sola si se trata de duración, condición de vivienda u otra medida. [6]
| PC | Autovalor | Proporción | Acumulado |
|---|---|---|---|
| PC1 | 3,5476 | 0,443 | 0,443 |
| PC2 | 2,1320 | 0,266 | 0,710 |
| PC3 | 1,0447 | 0,131 | 0,841 |
| PC4 | 0,5315 | 0,066 | 0,907 |
| PC5 | 0,4112 | 0,051 | 0,958 |
| PC6 | 0,1665 | 0,021 | 0,979 |
| PC7 | 0,1254 | 0,016 | 0,995 |
| PC8 | 0,0411 | 0,005 | 1,000 |
| Variable | PC1 | PC2 | PC3 | PC4 | PC5 | PC6 | PC7 | PC8 |
|---|---|---|---|---|---|---|---|---|
| Ingresos | 0,314 | 0,145 | -0,676 | -0,347 | -0,241 | 0,494 | 0,018 | -0,030 |
| Educación | 0,237 | 0,444 | -0,401 | 0,240 | 0,622 | -0,357 | 0,103 | 0,057 |
| Edad | 0,484 | -0,135 | -0,004 | -0,212 | -0,175 | -0,487 | -0,657 | -0,052 |
| Residencia | 0,466 | -0,277 | 0,091 | 0,116 | -0,035 | -0,085 | 0,487 | -0,662 |
| Empleo | 0,459 | -0,304 | 0,122 | -0,017 | -0,014 | -0,023 | 0,368 | 0,739 |
| Ahorros | 0,404 | 0,219 | 0,366 | 0,436 | 0,143 | 0,568 | -0,348 | -0,017 |
| Deuda | -0,067 | -0,585 | -0,078 | -0,281 | 0,681 | 0,245 | -0,196 | -0,075 |
| Tarjetas de crédito | -0,123 | -0,452 | -0,468 | 0,703 | -0,195 | -0,022 | -0,158 | 0,058 |
Los tres primeros componentes tienen autovalores mayores que uno y reúnen aproximadamente el 84,1 % de la variación. Los dos primeros reúnen cerca del 71,0 %. Por tanto, representar únicamente PC1 y PC2 deja fuera alrededor del 29 % de la variación total: un gráfico bidimensional es informativo, pero no agota el resultado de una solución con tres componentes.
Los coeficientes positivos relativamente altos de edad, residencia, empleo y ahorros en PC1 motivan la interpretación de estabilidad financiera de largo plazo presentada en el original. PC2 contrapone, entre otras contribuciones, educación y ahorros a deuda y tarjetas de crédito. El signo elegido hace que estas últimas aparezcan con coeficientes negativos; invertir el eje conserva la misma estructura. PC3 recoge un contraste diferente, con coeficientes negativos importantes de ingresos, educación y tarjetas.
Los nombres «estabilidad», «historial crediticio» o «calificaciones académicas y de ingresos» son resúmenes interpretativos, no variables directamente observadas ni constructos automáticamente validados. Para sostenerlos hay que examinar todas las cargas, la codificación y el conocimiento del dominio. Un componente no se convierte en un indicador válido de riesgo, solvencia o conducta por recibir una etiqueta plausible.
Cómo se calcula una puntuación
Como el ejemplo utiliza una matriz de correlaciones, sus coeficientes se aplican a las variables estandarizadas. Para una observación concreta, la primera puntuación se obtiene mediante:
+ 0,484zEdad + 0,466zResidencia
+ 0,459zEmpleo + 0,404zAhorros
− 0,067zDeuda − 0,123zTarjetas.
La fórmula emplea coeficientes publicados con tres decimales; pueden aparecer diferencias menores frente al cálculo interno del programa con mayor precisión.
Como comprobación didáctica añadida, una observación hipotética situada una desviación estándar por encima de la media en edad, residencia, empleo y ahorros, y exactamente en la media de las otras variables, tendría una puntuación aproximada de 0,484 + 0,466 + 0,459 + 0,404 = 1,813. No es una nueva observación del conjunto de Minitab: ilustra cómo sustituir valores en la combinación lineal.
Las puntuaciones corresponden a observaciones; los coeficientes pertenecen a las direcciones. No son elementos de una misma matriz con nombres diferentes. Si las direcciones están en las columnas de V, la transformación para todas las observaciones se calcula como T = ZV. El espacio principal es el subespacio generado por las direcciones retenidas; no debe identificarse sin precisión con una matriz particular que lo representa.
XIII. Distancia de Mahalanobis
Una observación puede ser poco extraña en cada variable por separado y, sin embargo, resultar inusual por la combinación de sus valores. Si dos variables suelen crecer juntas, un punto con valor alto en una y bajo en la otra puede alejarse del patrón conjunto aunque ninguno de sus valores marginales sea extremo. Esa es la intuición del ejemplo original.
DM(x) = √DM²(x).
La fórmula supone una covarianza invertible. En datos muestrales se sustituyen μ y Σ por estimaciones, y la interpretación de los umbrales depende de cómo se obtuvieron.
Mahalanobis pondera la desviación respecto del centro teniendo en cuenta la escala y la covariación. En coordenadas principales, si todos los autovalores son positivos, la distancia al cuadrado es la suma de las puntuaciones al cuadrado divididas por sus varianzas.
Una desviación modesta en una dirección de muy baja varianza puede resultar más inusual que una desviación mayor en una dirección de alta varianza.
Si la covarianza es singular, la inversa ordinaria no existe. Puede considerarse una pseudoinversa, una regularización o un modelo en un subespacio, pero cada opción cambia qué desviaciones detecta el diagnóstico. La pseudoinversa ignora direcciones del núcleo; por eso un diagnóstico restringido al subespacio debe complementarse con la inspección de residuos cuando interese detectar puntos fuera de él.
La distancia clásica utiliza estimaciones de media y covarianza que pueden ser afectadas por los mismos valores atípicos que se pretende detectar. No es universalmente «más potente» bajo cualquier contaminación o distribución. Su ventaja conceptual sobre una revisión marginal es incorporar el patrón multivariado, pero su desempeño depende del estimador y del modelo.
Con parámetros poblacionales conocidos y normalidad multivariada, la distancia al cuadrado sigue una distribución chi-cuadrado con grados de libertad iguales a la dimensión. Al estimar parámetros con la misma muestra, los límites apropiados pueden requerir correcciones distintas. No conviene aplicar una línea de corte sin declarar su fundamento.
XIV. Gráfica de sedimentación
La gráfica de sedimentación ordena los autovalores de mayor a menor y los representa frente al número de componente. Es una representación del espectro de la covarianza o de la correlación analizada. Debe indicarse si el eje vertical muestra autovalores, proporciones de varianza o alguna transformación de esas magnitudes.

En el ejemplo financiero existe un descenso importante durante los primeros componentes y una cola posterior de menor contribución. La interpretación original de retener tres componentes es compatible con Kaiser y con una acumulación cercana al 84,1 %. No demuestra que los cinco componentes restantes carezcan de toda relevancia: podrían contener contrastes importantes para un objetivo específico.
Un espectro aproximadamente uniforme sugiere que ninguna dirección concentra gran parte de la variación; en ese caso, una reducción fuerte pierde una fracción considerable. Un autovalor dominante sugiere una dirección de variación común, pero no prueba por sí mismo la existencia de una sola causa. La forma del espectro depende también del escalamiento y del ruido.
XV. Gráfica de puntuaciones
Una gráfica de puntuaciones representa observaciones en las coordenadas de dos o más componentes. En el plano PC1–PC2, cada punto es una unidad de estudio, no una variable original. Los ejes deben indicar la proporción de variación que representan; de ese modo el lector sabe cuánto de la nube queda visible.
Se examinan agrupamientos, gradientes, separaciones, posiciones extremas y observaciones próximas al centro. La figura del original señala un punto en una esquina inferior como candidato a investigación. La proximidad a un extremo del plano no permite declarar automáticamente un error, un grupo nuevo o un caso atípico significativo.
La distribución alrededor del origen resulta del centrado de las puntuaciones. No constituye una prueba de normalidad ni implica que la nube tenga forma circular. Cada componente tiene su propia varianza; una representación con escala gráfica desigual puede alterar visualmente ángulos y distancias. Cuando la geometría de la figura sea relevante deben declararse las escalas de los ejes y, preferiblemente, mantener una relación de aspecto apropiada.
Si dos puntos están separados en el plano, también difieren en el espacio completo. Si se ven próximos, podrían diferir en componentes no representados. De forma análoga, un agrupamiento proyectado puede ser útil para explorar y no bastar para establecer conglomerados estables, categorías naturales o diferencias entre poblaciones.
Colorear las observaciones con etiquetas experimentales conocidas puede ayudar a interpretar la representación, pero esas etiquetas no intervienen en el cálculo ordinario del PCA. Si se busca explícitamente separar grupos conocidos, debe evaluarse una técnica supervisada pertinente y validarla fuera de muestra.
XVI. Gráfica de cargas o influencias
La gráfica denominada de «influencias» en el documento corresponde al loading plot: representa las coordenadas asociadas a variables en dos componentes. Es preferible acompañar el nombre tradicional con «gráfica de cargas» para evitar confundirla con un diagnóstico de influencia de observaciones en regresión.
El término carga no tiene una convención universal. Algunos programas muestran coeficientes unitarios de los autovectores; otros muestran coeficientes multiplicados por la raíz del autovalor o correlaciones variable–componente. El tipo de representación debe declararse antes de comparar magnitudes, interpretar longitudes o utilizar umbrales.
Para variables estandarizadas: Corr(zℓ, PCj) = √λj aℓj.
Estas igualdades usan una componente sin blanqueamiento y convenciones coherentes de covarianza y escala.
Un coeficiente unitario cercano a cero indica una contribución pequeña a esa combinación lineal concreta; no declara que la variable carezca de importancia en todo el análisis. Puede contribuir a otros componentes o a una pregunta no recogida por la varianza principal. Los coeficientes de un autovector están entre −1 y 1, pero en muchas dimensiones todos pueden ser bastante menores que uno sin que exista un componente irrelevante.
En el ejemplo financiero, edad, residencia y empleo se orientan hacia PC1; deuda y tarjetas tienen peso notable en la dirección negativa de PC2. Se interpreta el patrón conjunto de signos y magnitudes, incluyendo las cargas menores cuando aportan un contraste relevante. La consistencia de una interpretación debe examinarse frente a cambios razonables en observaciones, escala o selección de variables.
XVII. Gráfica de doble proyección o biplot
El biplot reúne en una misma figura marcadores de observaciones y de variables. Su fundamento es una factorización de la aproximación de rango reducido de la matriz, no una superposición arbitraria de dos gráficos con unidades distintas. A partir de X̂c,k = UkΣs,kVkT, existen diferentes maneras de repartir los valores singulares entre ambos conjuntos de marcadores.
X̂c,k = GHT.
La elección de α modifica la escala de observaciones y variables. Debe consultarse la convención del programa antes de interpretar distancias o ángulos.
Las posiciones de las observaciones ayudan a identificar patrones; los vectores o marcadores de variables ayudan a relacionarlos con las mediciones originales. Bajo escalas adecuadas, los productos internos permiten reconstruir aproximadamente valores centrados; ciertas orientaciones de las variables pueden aproximar correlaciones. Estas lecturas dependen de la normalización y de la calidad de la aproximación en los ejes visibles.
En la figura financiera se mantienen las lecturas originales de PC1 y PC2 y la sugerencia de investigar el punto apartado. Se añade que PC3 también tiene una contribución apreciable y no aparece en el plano. La cercanía aparente entre una flecha y un punto no debe interpretarse como una distancia ordinaria entre objetos del mismo tipo.
Un biplot debería informar: matriz de partida, preprocesamiento, componentes mostrados, varianza representada y escalamiento de sus marcadores. Sin esos datos, una figura visualmente convincente puede admitir interpretaciones incompatibles.
XVIII. Gráfica de valores atípicos
La gráfica original representa, para cada observación, una distancia de Mahalanobis y una referencia de detección. En ella ningún punto supera el límite mostrado. Se conserva ese resultado específico, evitando convertirlo en una prueba de que el conjunto carece de cualquier anomalía posible: el diagnóstico se refiere a una métrica y un umbral concretos.
Una observación por encima de una línea de referencia es una señal para investigar. Puede reflejar un error de registro, una falla de medición, una unidad perteneciente a otra población, una condición excepcional o un acontecimiento real y científicamente importante. Eliminarla de manera automática puede borrar precisamente la variación que requiere explicación.
Es útil distinguir dos posiciones: lejos del centro dentro del subespacio retenido y lejos del subespacio mismo. La primera puede examinarse mediante una distancia ponderada de puntuaciones; la segunda mediante un residuo de reconstrucción, frecuentemente resumido por una suma de cuadrados residual.
Un límite para Dk² no sustituye un límite para Q. Sus distribuciones de referencia y correcciones dependen del modelo y del tipo de aplicación.
La práctica defendible es verificar la procedencia del dato, corregir errores demostrados, documentar decisiones y comparar resultados con y sin casos discutidos cuando corresponda. Si hay múltiples observaciones examinadas, también importa considerar que una serie de umbrales marginales puede producir falsas alarmas acumuladas.
XIX. Cálculo numérico y NIPALS
La formulación variacional define qué solución buscamos; el algoritmo determina cómo la calculamos. Es posible obtener el PCA mediante descomposición espectral de la covarianza, SVD de la matriz preparada, métodos iterativos o aproximaciones diseñadas para matrices grandes. El descenso de gradiente es una posibilidad para ciertas formulaciones, no el mecanismo obligatorio que «orquesta» todo PCA.
| Procedimiento | Idea | Consideración principal |
|---|---|---|
| Descomposición espectral | Diagonalizar S o R. | Formar XTX puede amplificar problemas de condicionamiento; útil cuando el tamaño de la matriz de variables es manejable. |
| SVD directa | Descomponer la matriz centrada o estandarizada. | Evita formar explícitamente la covarianza y conecta directamente direcciones, puntuaciones y reconstrucción. |
| Métodos iterativos truncados | Aproximar solo los primeros componentes. | Requieren tolerancias y control de convergencia; resultan útiles cuando se desean pocos ejes. |
| SVD aleatorizada | Aproximar el subespacio dominante mediante proyecciones y refinamiento. | Su precisión depende del espectro y de parámetros como sobremuestreo e iteraciones; debe fijarse la semilla si se requiere repetibilidad. |
| NIPALS | Extraer componentes sucesivamente mediante actualizaciones alternadas y deflación. | Las implementaciones pueden incorporar tratamiento de faltantes; deben declararse convergencia y supuestos. |
| PCA incremental | Actualizar una aproximación por lotes. | Reduce memoria, pero los detalles del algoritmo y de los lotes afectan la aproximación. |
NIPALS, paso a paso
NIPALS significa Non-linear Iterative Partial Least Squares, habitualmente traducido como mínimos cuadrados parciales iterativos no lineales. El nombre histórico del algoritmo no convierte automáticamente la representación producida en un PCA no lineal. En su uso para PCA, busca sucesivamente aproximaciones de rango uno de la matriz residual. La discusión original sigue siendo útil para comprender cargas y puntuaciones. [4]
- Preparar los datos y definir una matriz residual inicial E = Xc, o E = Z si se estandarizó.
- Elegir una columna no nula de E para inicializar un vector de puntuaciones t.
- Actualizar la dirección mediante p = ETt/(tTt) y normalizar p a longitud uno.
- Actualizar las puntuaciones mediante t = Ep y repetir hasta cumplir una tolerancia declarada.
- Guardar t y p, retirar su contribución con E ← E − tpT y continuar con otro componente si corresponde.
La secuencia anterior describe el caso de datos completos. Algunas implementaciones ajustan los productos y actualizaciones sobre valores observados para trabajar con faltantes. No basta con sustituirlos por ceros, ni puede suponerse que cualquier patrón de ausencia sea inocuo. La identificabilidad, el porcentaje de información disponible y el mecanismo de ausencia condicionan el resultado.
La extracción secuencial permite detener el cálculo cuando se han obtenido suficientes componentes. La deflación y el redondeo también pueden acumular errores numéricos; por ello conviene controlar ortogonalidad, convergencia y residuo de reconstrucción. La afirmación de que «la mayoría de los programas utiliza NIPALS» debe tratarse como una observación histórica de la fuente consultada, no como una propiedad general de los programas actuales.
En un informe reproducible se declara el algoritmo efectivamente utilizado. Decir únicamente «se realizó PCA en Python» o «en R» no indica la matriz de partida, el centrado, la escala, el tratamiento de faltantes ni el criterio de retención. Los programas facilitan el cálculo, pero no resuelven por sí solos las decisiones de diseño.
XX. PCA y regresión lineal
La comparación del original con regresión lineal permite precisar dos sentidos de «recta de mejor ajuste». En una regresión ordinaria de y sobre x, se eligen coeficientes para minimizar errores en la variable de respuesta, medidos verticalmente en la representación habitual. En el PCA bidimensional, se busca una recta que minimice la suma de distancias ortogonales al cuadrado, tratando conjuntamente las coordenadas conforme a la métrica elegida.
PCA de rango uno: min‖a‖=1 ∑i ‖zi − aaTzi‖².
La primera formulación selecciona una respuesta. La segunda aproxima una nube centrada sin designar una variable dependiente.
Por tanto, la diferencia no consiste en que la regresión «carezca de toda ortogonalidad». En mínimos cuadrados, el vector residual es ortogonal al espacio generado por las columnas del diseño, bajo las condiciones usuales. Esa propiedad algebraica no equivale a medir distancias geométricas perpendiculares desde cada punto a una recta en el plano de variables.
El PCA puede relacionarse con regresión ortogonal o mínimos cuadrados totales, pero aplicar una interpretación de errores en todas las variables requiere supuestos sobre sus escalas y precisiones de medición. La simetría del criterio no vuelve irrelevantes las unidades: cambiar la escala de un eje puede cambiar la recta principal.
También existe la regresión sobre componentes principales, que utiliza puntuaciones como predictores. En ella, escoger componentes solo por su varianza puede descartar una dirección de pequeña variación que sea informativa para la respuesta. El número de componentes debe seleccionarse considerando la tarea predictiva y validación independiente.
Una asociación geométrica tampoco establece causalidad. La distinción entre descripción, predicción y explicación debe mantenerse aunque ambas técnicas compartan herramientas algebraicas o representaciones mediante rectas y planos.
XXI. Tres genes y dimensiones superiores
El ejemplo original incorpora un tercer gen manteniendo los mismos seis ratones. Los datos de la primera tabla tridimensional son los siguientes. Se añade la tercera coordenada para mostrar cómo una estructura apenas visible en un plano puede hacerse más clara al examinar otra variable.
| Ratón | Gen 1 | Gen 2 | Gen 3 |
|---|---|---|---|
| 1 | 10 | 6 | 12 |
| 2 | 11 | 4 | 9 |
| 3 | 8 | 5 | 10 |
| 4 | 3 | 3 | 2,5 |
| 5 | 2 | 2,8 | 1,3 |
| 6 | 1 | 1 | 2 |
Ahora cada unidad ocupa un punto de ℝ³. PC1 señala la dirección de mayor variación; PC2 se elige en su complemento ortogonal, y PC3 completa una base ortonormal. El plano formado por PC1 y PC2 proporciona la mejor aproximación bidimensional bajo el criterio cuadrático euclidiano aplicado a los datos preparados.
Los ratones 1, 2 y 3 tienen valores mayores del tercer gen que los ratones 4, 5 y 6. Ese patrón puede contribuir a una separación en las coordenadas principales. Pero un componente combina las tres variables: no se identifica necesariamente con el eje de un gen particular. Examinar sus coeficientes permite describir cuánto participa cada medición en la dirección obtenida.
Las figuras finales de Starmer incluidas en el documento también presentan variantes ilustrativas donde cambian los valores del tercer gen. Se conservan esas variantes en el archivo visual. Los porcentajes rotulados en ellas —por ejemplo, 91 % y 4 %, o 79 %, 15 % y 6 %— corresponden a las escenas didácticas en las que aparecen; no deben trasladarse a otra tabla o a otro preprocesamiento como si fueran resultados universales.
Para evitar esa mezcla, los resultados numéricos añadidos aquí se recalculan exclusivamente a partir de las tablas transcritas y con PCA sobre covarianzas, es decir, centrando sin estandarizar. El código posterior permite verificar la diferencia si se decide trabajar con correlaciones.
| Datos | PC | Autovalor | Varianza (%) | Acumulado (%) |
|---|---|---|---|---|
| Dos genes | PC1 | 21,284012 | 96,3368 | 96,3368 |
| Dos genes | PC2 | 0,809321 | 3,6632 | 100,0000 |
| Tres genes | PC1 | 42,455970 | 95,7509 | 95,7509 |
| Tres genes | PC2 | 1,357664 | 3,0619 | 98,8129 |
| Tres genes | PC3 | 0,526366 | 1,1871 | 100,0000 |
| Ratón | PC1 | PC2 |
|---|---|---|
| 1 | 4,719998 | -0,826949 |
| 2 | 4,988861 | 1,392896 |
| 3 | 2,500152 | -0,558086 |
| 4 | -2,881249 | -0,356784 |
| 5 | -3,890244 | -0,504866 |
| 6 | -5,437518 | 0,853790 |
Convención de signo: primer coeficiente de cada dirección no negativo. En el caso de dos genes, a₁ ≈ (0,941711; 0,336424)ᵀ y a₂ ≈ (0,336424; −0,941711)ᵀ. Cambiar el signo de una dirección y sus puntuaciones conserva el resultado.
El mismo argumento se generaliza a p genes, aunque no sea posible dibujar el espacio original. Una tabla con miles de variables y pocas observaciones admite un cálculo de PCA, pero su rango muestral está limitado por n − 1. La existencia de componentes calculables no garantiza que las direcciones estimadas sean estables ni que reproduzcan fielmente las de una población.
Las separaciones observadas pueden ser compatibles con diferencias biológicas, pero también con diferencias técnicas o de preparación. Identificar al gen 3 como «responsable» de un agrupamiento exige distinguir contribución geométrica de mecanismo causal. El PCA ayuda a descubrir preguntas e hipótesis; el diseño y la validación permiten decidir qué explicaciones están sustentadas.
XXII. Alcance científico y lectura multidimensional
El interés del PCA excede una receta de reducción de datos. Permite estudiar cómo una multiplicidad de mediciones puede organizarse mediante relaciones que no coinciden con las variables aisladas. Ese paso de coordenadas originales a combinaciones nuevas puede ser filosóficamente fértil, siempre que no convierta una construcción estadística en una esencia ontológica demostrada.
Relaciones, totalidad y mediación
Desde una lectura materialista, las variables son mediciones producidas en prácticas concretas y los datos expresan aspectos de procesos naturales o sociales. El análisis de sus covariaciones puede revelar regularidades que una inspección marginal no muestra. Sin embargo, la totalidad de un fenómeno no se agota en una matriz de covarianza: pueden importar relaciones no lineales, temporalidad, heterogeneidad, condiciones históricas y mecanismos de interacción.
La idea de «relaciones esenciales» debe tratarse como una hipótesis interpretativa que requiere investigación. Un autovector resume una estructura matemática de variación; atribuirle el carácter de relación fundamental del sistema exige conectar esa estructura con teoría sustantiva y evidencia independiente. Esta separación fortalece la discusión filosófica porque hace explícitas sus mediaciones.
Seis dimensiones de evaluación
| Dimensión | Pregunta de control |
|---|---|
| Matemática | ¿Qué objetivo se optimiza, con qué restricciones y bajo qué métrica? |
| Geométrica | ¿Se está cambiando de coordenadas o descartando direcciones? ¿Qué distancias se conservan? |
| Estadística | ¿La muestra, las mediciones y la estabilidad respaldan las regularidades observadas? |
| Computacional | ¿Qué algoritmo, tolerancias y tratamiento de datos producen la solución? |
| Sustantiva | ¿La interpretación del componente tiene sentido en biología, economía o el dominio investigado? |
| Epistemológica | ¿Se está describiendo, prediciendo o explicando? ¿Qué salto inferencial requiere evidencia adicional? |
Aplicaciones y límites
En biología, el PCA puede explorar patrones conjuntos de expresión o morfología. En economía puede resumir series o indicadores relacionados. En procesos industriales puede ayudar a vigilar comportamientos multivariados. En imágenes puede aproximar variación mediante una base de menor dimensión. En cada caso, la utilidad depende del objetivo, la preparación de los datos y la interpretación de sus componentes.
Los principales límites incluyen sensibilidad a observaciones extremas, dependencia de unidades y escalamiento, incapacidad del modelo lineal para describir por completo estructuras curvas y falta de un objetivo explícito de separación de clases. El PCA ordinario tampoco distingue automáticamente señal de ruido, ni identifica por sí mismo variables causales o constructos latentes.
La validación puede incluir sensibilidad al preprocesamiento, remuestreo para examinar estabilidad, contraste entre submuestras, revisión de residuos y evaluación fuera de muestra. Cuando los autovalores son muy próximos, direcciones individuales pueden cambiar notablemente con pequeñas perturbaciones mientras el subespacio conjunto permanece más estable. En ese caso conviene evaluar el subespacio y no aferrarse al nombre de un eje aislado.
Finalmente, una representación de baja dimensión no debe utilizarse para naturalizar clasificaciones de personas o grupos. El ejemplo financiero ilustra una operación estadística; cualquier uso decisorio exige una validación adecuada al contexto, al significado de las variables y a las consecuencias de las decisiones.
El PCA muestra las direcciones de mayor variación lineal de una representación elegida. El conocimiento científico requiere además explicar por qué esa representación es pertinente, qué relaciones puede captar y qué evidencia permite interpretar sus patrones.
XXIII. Implementación reproducible en Python y R
La reproducibilidad exige conservar datos, orientación de la matriz, transformaciones, algoritmo y convenciones. Los siguientes ejemplos recalculan los resultados de las tablas de genes. El código en Python utiliza NumPy y una SVD directa; el de R emplea prcomp. Ninguno presupone etiquetas de grupo ni utiliza los porcentajes de las capturas como entradas.
En ambos casos se distingue entre centrar sin escalar y centrar con estandarización muestral. El divisor de la covarianza es n − 1. Los signos de los componentes pueden diferir entre implementaciones; para comparar coordenadas se alinean primero sus direcciones. En presencia de empates espectrales debe compararse el subespacio, no necesariamente cada columna.
Python: cálculo y verificaciones
"""PCA del ejemplo de seis ratones. Requiere Python y NumPy."""
import numpy as np

X = np.array([
    [10, 6], [11, 4], [8, 5],
    [3, 3], [2, 2.8], [1, 1]
], dtype=float)
X3 = np.column_stack((X, [12, 9, 10, 2.5, 1.3, 2]))

def pca_svd(datos, estandarizar=False):
    """Filas: observaciones. Escala muestral ddof=1."""
    x = np.asarray(datos, dtype=float)
    if x.ndim != 2 or x.shape[0] < 2:
        raise ValueError("Se requieren al menos dos observaciones.")
    if not np.isfinite(x).all():
        raise ValueError("Resolver los valores faltantes/no finitos antes del PCA.")
    media = x.mean(axis=0)
    escala = x.std(axis=0, ddof=1) if estandarizar else np.ones(x.shape[1])
    if np.any(escala == 0):
        raise ValueError("No estandarizar columnas constantes.")
    z = (x - media) / escala
    _, singular, vt = np.linalg.svd(z, full_matrices=False)
    direcciones = vt.T.copy()
    # Convención de signo reproducible: primer coeficiente no negativo.
    signos = np.where(direcciones[0, :] < 0, -1.0, 1.0)
    direcciones *= signos
    puntuaciones = z @ direcciones
    autovalores = singular**2 / (x.shape[0] - 1)
    total = autovalores.sum()
    if total <= 0:
        raise ValueError("La variación total debe ser positiva.")
    proporciones = autovalores / total
    return dict(z=z, media=media, escala=escala,
                direcciones=direcciones, puntuaciones=puntuaciones,
                autovalores=autovalores, proporciones=proporciones)

if __name__ == "__main__":
    np.set_printoptions(precision=6, suppress=True)
    for nombre, datos in [("Dos genes", X), ("Tres genes", X3)]:
        for escalar in (False, True):
            r = pca_svd(datos, estandarizar=escalar)
            v, t, lam = r["direcciones"], r["puntuaciones"], r["autovalores"]
            print(nombre, "correlaciones" if escalar else "covarianzas")
            print("Autovalores:", lam)
            print("Varianza explicada (%):", 100 * r["proporciones"])
            print("Direcciones (columnas):\n", v)
            print("Puntuaciones:\n", t)
            # Propiedades independientes para verificar el resultado publicado.
            assert np.allclose(v.T @ v, np.eye(v.shape[1]))
            assert np.allclose(np.cov(t, rowvar=False), np.diag(lam))
            assert np.allclose(t @ v.T, r["z"])
            assert np.isclose(lam.sum(), np.var(r["z"], axis=0, ddof=1).sum())
            for k in range(1, v.shape[1] + 1):
                aproximacion = t[:, :k] @ v[:, :k].T
                error = np.sum((r["z"] - aproximacion)**2)
                assert np.isclose(error, (datos.shape[0] - 1) * lam[k:].sum())
    # Verificación de la distinción entre incorrelación e independencia.
    # Si U es uniforme en [-1,1], Cov(U,U²)=0 por simetría,
    # aunque U² está determinada por U; no se exige un test simulado.
Las verificaciones comprueban ortonormalidad de direcciones, covarianza diagonal de puntuaciones, reconstrucción con todos los componentes y coincidencia entre la variación descartada y el error cuadrático. Estas identidades permiten detectar errores de transposición o de escala que una figura plausible puede ocultar.
R: la misma convención muestral
# PCA de los mismos datos. Requiere R base.
X <- matrix(c(10,6, 11,4, 8,5, 3,3, 2,2.8, 1,1),
            ncol = 2, byrow = TRUE)
colnames(X) <- c("Gen1", "Gen2")
rownames(X) <- paste0("Raton", 1:6)
X3 <- cbind(X, Gen3 = c(12, 9, 10, 2.5, 1.3, 2))
for (datos in list(X, X3)) {
  for (escalar in c(FALSE, TRUE)) {
    ajuste <- prcomp(datos, center = TRUE, scale. = escalar)
    print(ajuste$sdev^2)                  # autovalores muestrales
    print(100 * ajuste$sdev^2 / sum(ajuste$sdev^2))
    print(ajuste$rotation)                # direcciones
    print(ajuste$x)                       # puntuaciones
    reconstruccion <- ajuste$x %*% t(ajuste$rotation)
    stopifnot(max(abs(reconstruccion -
                      scale(datos, center=TRUE, scale=escalar))) < 1e-8)
  }
}
# Los signos pueden diferir de Python sin cambiar la solución.
# Para análisis paralelo, instalar psych si se desea:
# set.seed(2026)
# psych::fa.parallel(X3, fa="pc", n.iter=1000, quant=.95)
# Con seis observaciones esto es una ilustración, no una recomendación empírica.
El ejemplo de análisis paralelo queda comentado porque requiere el paquete adicional psych. La función distingue explícitamente componentes mediante fa="pc". Una muestra didáctica de seis unidades no debe utilizarse para recomendar conclusiones empíricas estables sobre agrupamientos o dimensionalidad poblacional.
Aplicar el modelo a observaciones nuevas
Para transformar un dato nuevo se utilizan las medias, escalas y direcciones ajustadas en los datos de entrenamiento. No se recalculan con el conjunto de prueba. Si el PCA es parte de un proceso predictivo, su ajuste y todo preprocesamiento aprendido deben ejecutarse dentro de cada partición de entrenamiento de la validación cruzada. De otro modo se filtra información del conjunto de evaluación.
D contiene las desviaciones utilizadas al ajustar el modelo. Sin estandarización, D es la identidad.
En implementaciones como sklearn.decomposition.PCA, el centrado y el escalamiento son operaciones distintas: no se debe inferir que PCA estandariza automáticamente. Si se usa StandardScaler, su convención de varianza por defecto utiliza divisor n; conviene declararlo al comparar magnitudes exactas con R o con el código anterior. El blanqueamiento es otra transformación: divide las coordenadas principales por una medida de su dispersión y modifica las varianzas de salida.
XXIV. Archivo íntegro de las 51 figuras originales
Este archivo conserva todos los elementos gráficos extraídos de las 49 páginas del PDF, en su orden de aparición y sin recortar su contenido. Se incluyen la figura histórica de Pearson, la tabla de transformaciones, la secuencia de Starmer, los esquemas de Dunn y los resultados y gráficos de Minitab y de la Universidad Carlos III de Madrid. La presentación cromática se integra al artículo mediante un filtro visual; el enlace de cada figura permite consultar el original en color dentro del PDF.
Las capturas conservan las etiquetas y convenciones del documento original. Cuando presentan una suma de cuadrados como «eigenvalue», debe distinguirse el autovalor de la matriz de productos cruzados de la varianza de un componente. Cuando describen como «standardizing» una división por la hipotenusa, se trata de normalización vectorial en ese paso. Las aclaraciones del desarrollo prevalecen para interpretar la notación. Los porcentajes de escenas diferentes no se combinan entre sí.
A. Pearson y transformaciones geométricas · figuras 1–5


B. Centrado, ajuste y proyección · figuras 6–15


C. Sumas de cuadrados y dirección principal · figuras 16–25


D. Segunda componente y coordenadas · figuras 26–35


E. Ejemplo financiero y diagnósticos · figuras 36–43


F. Tres genes y extensión geométrica · figuras 44–51


XXV. Glosario y correspondencia con el documento
| Término | Definición en esta edición |
|---|---|
| Observación | Unidad de estudio representada por una fila de X y, después de transformar, por una fila de T. |
| Variable original | Medición que corresponde a una columna de X. |
| Dirección principal | Autovector unitario de la covarianza o correlación elegida. |
| Componente principal | Variable obtenida como combinación lineal centrada según una dirección principal. |
| Puntuación | Valor de una observación en una componente. |
| Carga | Coeficiente o asociación variable–componente, según la convención declarada. |
| Autovalor | Varianza de una componente cuando se refiere a la covarianza o correlación correspondiente. |
| Valor singular | Magnitud no negativa de la SVD; su cuadrado es un autovalor de XcTXc. |
| Subespacio principal | Espacio generado por las direcciones retenidas. |
| Proyección | Aproximación ortogonal de una observación en el subespacio. |
| Residuo | Diferencia entre la observación preparada y su reconstrucción. |
| Dimensionalidad efectiva | Número de direcciones considerado suficiente bajo un criterio de aproximación declarado. |
| Contenido del PDF de 2021 | Desarrollo en esta versión |
|---|---|
| I. Generalidades conceptuales y matemáticas | I–III, VIII–X: atributos, dimensionalidad, Bellman, Pearson, combinaciones lineales, restricciones y espectro. |
| II. Intuición geométrica y marco conceptual | IV–X: genes, centrado, transformaciones, estructura, topología, proyecciones, normas, pendientes, SVD y ortogonalidad. |
| III.I–III.III. Resultados, autovalores, criterios y componentes | XI–XII: todos los criterios originales, tabla financiera completa, cargas y puntuaciones. |
| III.IV. Distancia de Mahalanobis | XIII: definición, geometría, equivalencia espectral, singularidad y supuestos de umbrales. |
| III.V–III.IX. Sedimentación, puntuaciones, influencias, doble proyección y atípicos | XIV–XVIII: los cinco diagnósticos, su lectura y sus condiciones de interpretación. |
| III.X. Consideraciones finales | XIX–XX: NIPALS, otros algoritmos y comparación con regresión lineal. |
| IV. Intuición geométrica en ℝ³ | XXI: tres genes, seis ratones, variantes gráficas y extensión a dimensiones mayores. |
| V. Referencias | XXVI: todas las entradas bibliográficas originales, con depuración editorial y ampliaciones técnicas. |
| Figuras del documento | XXIV: archivo de las 51 figuras, con página de procedencia y acceso al PDF histórico. |
| Desarrollos añadidos | Derivaciones, reconstrucción, estabilidad, epistemología, código y trazabilidad en XXII–XXIII y en notas de los apartados anteriores. |
El recorrido mantiene la ambición multidisciplinaria del ensayo: relacionar intuición, formalización, cálculo e interpretación. La precisión de sus distinciones permite que esas perspectivas se complementen sin atribuir a una fórmula resultados que pertenecen a otro nivel de análisis.
XXVI. Referencias y documento completo
Se conserva el repertorio bibliográfico del documento original. Se corrigen la grafía de Jolliffe y la presentación editorial de las entradas; las fuentes enciclopédicas y los foros permanecen como apoyos históricos o didácticos. Las ampliaciones incorporan documentación técnica y trabajos académicos adicionales. Una referencia incluida en el original no se presenta como verificada de nuevo en su totalidad ni como respaldo automático de todas sus afirmaciones.
- Adler, J. (2012). R in a Nutshell (2.ª ed.). O’Reilly Media.
- Alger, N. (2013, 4 de marzo). Intuitively, what is the difference between Eigendecomposition and Singular Value Decomposition? Respuesta en Mathematics Stack Exchange. Consulta y respuestas.
- Bellman, R. (1972). Dynamic Programming (impresión consultada en el original). Princeton University Press. Publicación original: 1957.
- Dunn, K. G. (2021). Process Improvement Using Data. Capítulo 6: métodos de variables latentes; sección sobre PCA. Libro del autor. Documento PDF.
- Jolliffe, I. T. (2002). Principal Component Analysis (2.ª ed.). Springer.
- Minitab. (2019, referencia del original). Interpretar todos los estadísticos y gráficas para Análisis de componentes principales. Documentación en español. Página técnica en inglés consultada para contrastar la tabla.
- Massachusetts Institute of Technology. (2011; consulta de 2021 en el original). Linear transformations and their matrices. MIT OpenCourseWare, Linear Algebra. Curso y materiales.
- Nabi, I. (2020). Sobre los estimadores de Bayes, el análisis de grupos y las mixturas gaussianas. Documento inédito citado en la versión original.
- Nabi, I. (2021, 3 de abril). ¿Por qué se realiza un ajuste por re-escalamiento, normalización o estandarización sobre los datos en el contexto del aprendizaje automático? Marxist Philosophy of Science. Entrada relacionada.
- Nabi, I. (2021, 2 de abril). Una interpretación multidisciplinaria de los espacios característicos, vectores característicos y valores característicos. Documento completo.
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 2(11), 559–572. https://doi.org/10.1080/14786440109462720.
- Mathematics Stack Exchange. (2015, 13 de marzo). Understanding proof of isometry implies isomorphism. Discusión citada en el original. Su alcance depende de las estructuras y de las hipótesis de sobreyectividad especificadas.
- Starmer, J. (2018, 2 de abril, según la referencia original). Principal Component Analysis (PCA). StatQuest. Video citado. Índice de materiales del autor. Fuente de las secuencias didácticas de expresión génica.
- Universidad Carlos III de Madrid. (2006, 7 de noviembre, según la referencia original). Análisis de componentes principales. Material docente citado.
- Universitat de Girona. (2002, 24 de enero, según la referencia original). Número de factores a conservar. Material sobre análisis factorial. Dirección histórica citada. Se conserva la referencia; la discusión revisada distingue componentes de factores comunes.
- Weisstein, E. W. (consulta de 2021). Projection. MathWorld, Wolfram Research. Artículo de referencia.
- Weisstein, E. W. (consulta de 2021). Transformation. MathWorld, Wolfram Research. Artículo de referencia.
- Wikipedia. (2020, versión citada en el original). Curse of dimensionality. Entrada enciclopédica.
- Wikipedia. (2020, versión citada en el original). Isomorfismo. Entrada en español.
- Wikipedia. (2021, versión citada en el original). Isomorphism. Entrada en inglés.
- Wikipedia. (2021, versión citada en el original). Transcripción genética. Entrada enciclopédica. La transcripción sintetiza ARN a partir de ADN; la traducción es el proceso que produce una cadena polipeptídica a partir del ARN mensajero.
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology. Referencia histórica complementaria.
- Jolliffe, I. T., y Cadima, J. (2016). Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A, 374, 20150202. DOI. Texto completo de acceso abierto.
- Revelle, W. VSS: Very Simple Structure, MAP, and other criteria. Documentación del paquete psych. Documentación del autor. Incluye la referencia a Velicer (1976), Determining the number of components from the matrix of partial correlations, Psychometrika, 41, 321–327.
- Revelle, W. fa.parallel: Scree plots of data or correlation matrix compared to random matrices. Documentación del paquete psych. Documentación del autor. Incluye la referencia a Horn (1965), A rationale and test for the number of factors in factor analysis, Psychometrika, 30, 179–185.
- Scikit-learn developers. PCA. Documentación oficial. Algoritmos, centrado, atributos y convenciones.
- Scikit-learn developers. StandardScaler. Documentación oficial. Estandarización y convención de varianza.
- R Core Team. prcomp: Principal Components Analysis. Documentación de R, paquete stats. Cálculo mediante SVD, escalamiento y puntuaciones.
El documento histórico permite consultar la composición original, las capturas a color y el desarrollo tal como fue publicado en 2021. Esta edición web amplía su exposición y precisa sus distinciones matemáticas, estadísticas y filosóficas, manteniendo trazabilidad entre ambas versiones.
JOSÉ MAURICIO GÓMEZ JULIÁN · Documento original de 49 páginas
Edición web revisada y ampliada
Leave a Comment/Deja un Comentario