Espartaco

“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”

Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290

28,796 views since December 2020

28,796 visitas desde diciembre de 2020

EnglishEspañol

Categoría: GitHub

  • ¿POR QUÉ SE REALIZA UN AJUSTE POR RE-ESCALAMIENTO, NORMALIZACIÓN O ESTANDARIZACIÓN SOBRE LOS DATOS EN EL CONTEXTO DEL APRENDIZAJE AUTOMÁTICO?

    ¿POR QUÉ SE REALIZA UN AJUSTE POR RE-ESCALAMIENTO, NORMALIZACIÓN O ESTANDARIZACIÓN SOBRE LOS DATOS EN EL CONTEXTO DEL APRENDIZAJE AUTOMÁTICO?

    Marxist Philosophy of Science
    Estadística · Métodos · Aprendizaje automático

    Reescalamiento, normalización y estandarización

    ¿Por qué transformar las escalas de los datos en el aprendizaje automático?

    ISADORE NABI
    Publicado el
    Edición revisada y ampliada ·

    Una diferencia de unidades puede convertirse, inadvertidamente, en una diferencia de importancia para un algoritmo. Si una característica se expresa en años y otra en miles de unidades monetarias, sus contribuciones a una distancia numérica pueden ser muy desiguales. El problema no reside en que una de ellas sea necesariamente más informativa, sino en que el procedimiento de cálculo responde a la representación numérica elegida.

    Reescalar los datos permite intervenir sobre esa representación. Sin embargo, la transformación adecuada depende del problema: puede modificar la geometría de las observaciones, facilitar la optimización o cambiar el efecto de una penalización. Comprender esas diferencias es más útil que aplicar una regla universal de preprocesamiento.

    01 / ConceptosTransformaciones que conviene distinguir

    Sea X una matriz de datos: cada fila representa una observación y cada columna una característica. Escribiremos xij para el valor de la característica j en la observación i. Esta distinción entre filas y columnas es decisiva: no todas las operaciones llamadas «normalización» actúan sobre el mismo objeto.

    Reescalamiento: el término general

    En este texto, «reescalamiento» designa el cambio de escala de una representación numérica. Muchas transformaciones habituales por característica tienen la forma x′ij = ajxij + bj, con constantes fijadas para cada columna. Si existe una traslación distinta de cero, se trata de una transformación afín; solo cuando esa traslación es nula es estrictamente lineal.

    Convertir grados Celsius a Fahrenheit es un ejemplo afín. Expresar un ingreso en miles de unidades monetarias es un cambio puramente multiplicativo. Ninguno de los dos añade observaciones: cambia la forma de expresarlas.

    Escalamiento mínimo–máximo

    La transformación mínimo–máximo lleva los valores de cada característica al intervalo [0, 1] del conjunto con el que se ajusta. Para una columna no constante:

    x′ij = (xij − mj) / (Mj − mj) mⱼ: mínimo de la columna j · Mⱼ: máximo de esa columna · parámetros estimados en entrenamiento.

    Un valor situado a mitad del rango pasa a 0,5. La operación conserva el orden y las proporciones entre diferencias dentro de una misma columna, pero modifica la comparación entre columnas. Los datos posteriores pueden quedar fuera de [0, 1] si exceden los extremos usados al ajustar el escalador; limitar esos valores mediante recorte es una decisión adicional.[2]

    Estandarización: centrar y expresar en desviaciones estándar

    La estandarización habitual resta la media de cada característica y divide por su desviación estándar:

    zij = (xij − μj) / σj μⱼ: media de entrenamiento · σⱼ: desviación estándar de entrenamiento, distinta de cero.

    Así, z = 2 significa que el valor está dos desviaciones estándar por encima de la media de referencia. En las columnas no constantes del conjunto de ajuste se obtiene media cero y varianza uno, usando la misma convención para calcular la varianza. StandardScaler emplea el divisor n, equivalente a ddof=0.[1]

    Normalización por norma: transformar cada observación

    En otro uso del término, normalizar significa dividir cada vector de observación no nulo por su norma. Para la norma euclidiana:

    ui = xi / ‖xi‖2 xᵢ: vector de la fila i · ‖xᵢ‖₂ = √(xᵢ₁² + ⋯ + xᵢₚ²) · requiere una norma distinta de cero.

    Esta operación lleva cada fila a longitud uno y conserva su dirección, descartando la magnitud global del vector. Puede ser útil en representaciones de texto y comparaciones mediante similitud coseno. No pone, por sí sola, las distintas columnas en escalas comparables; además, exige que la norma tenga sentido para la representación elegida.[3]

    02 / EjemploLas unidades pueden cambiar al vecino más cercano

    Consideremos cuatro observaciones ficticias. El ingreso se expresa en unidades monetarias por mes. Utilizaremos las cuatro filas como conjunto de referencia para ilustrar las transformaciones; todavía no estamos evaluando un modelo predictivo.

    Tabla 1 · Datos originales
    ObservaciónEdad (años)Ingreso mensual
    A202 000
    B223 000
    C402 100
    D505 000
    Datos sintéticos de elaboración propia. La combinación directa de años e ingreso se usa para mostrar el problema, no para proponer una medida sustantiva de semejanza.

    Si se aplica directamente la distancia euclidiana a los números originales, la distancia de A a B es aproximadamente 1 000,002; de A a C, 101,980. C resulta más cercana a A, aunque difiera veinte años en edad, porque la diferencia de ingreso domina el cálculo.

    Para mínimo–máximo, el rango de edad es 30 y el de ingreso 3 000. Para estandarizar, las medias son 33 y 3 025; las desviaciones estándar, calculadas con divisor 4, son aproximadamente 12,530 y 1 204,938.

    Tabla 2 · Dos transformaciones de las mismas columnas
    FilaEdad
    mín.–máx.
    Ingreso
    mín.–máx.
    Edad
    z
    Ingreso
    z
    A0,00000,0000−1,0375−0,8507
    B0,06670,3333−0,8779−0,0207
    C0,66670,03330,5587−0,7677
    D1,00001,00001,35671,6391
    Valores redondeados a cuatro decimales. Los cálculos de distancia se realizan antes del redondeo.

    Después del escalamiento mínimo–máximo, las distancias de A a B y de A a C son:

    d′(A, B) = √[(2/30)² + (1 000/3 000)²]
    ≈ 0,3399
    d′(A, C) = √[(20/30)² + (100/3 000)²]
    ≈ 0,6675
    A D: d′(A, D) ≈ 1,4142. Entre las otras tres observaciones, B pasa a ser la más cercana a A.

    El vecino más cercano cambió de C a B. No cambiaron las personas ni sus atributos originales: cambió la regla numérica de comparación. El ejemplo demuestra sensibilidad a la escala; no demuestra que la segunda vecindad sea científicamente superior. Eso exige justificar qué significa «parecido» en el problema estudiado.

    03 / FundamentosTres razones distintas para escalar

    Geometría: decidir cómo se mide la proximidad

    Si cada coordenada se transforma como x′j = (xj − bj)/sj, con sj > 0, la distancia euclidiana al cuadrado entre dos observaciones se convierte en:

    d′(x, y)² = ∑j=1p (xj − yj)² / sj² p: número de características · sⱼ: divisor de escala de la característica j. La traslación común bⱼ se cancela al restar.

    La identidad muestra que escalar equivale a introducir una ponderación por coordenada: cada diferencia al cuadrado recibe el factor 1/sj². Esto afecta a K vecinos más cercanos cuando utiliza una métrica sensible a la escala, y a K-means con su objetivo euclidiano habitual. La estandarización iguala varianzas marginales en el conjunto de ajuste; no iguala la información que aporta cada variable ni elimina sus correlaciones.[4]

    Optimización: facilitar el recorrido hacia una solución

    En problemas ajustados mediante gradiente, las escalas muy diferentes pueden producir curvaturas desiguales en la función objetivo. Una tasa de aprendizaje suficientemente pequeña para una dirección puede hacer lento el avance en otra. Un escalamiento adecuado puede mejorar el condicionamiento y favorecer la convergencia, aunque no elimina toda dificultad numérica ni garantiza una aceleración determinada.[5]

    Conviene distinguir el modelo del algoritmo que lo ajusta: una misma familia de modelos puede estimarse mediante procedimientos numéricos diferentes. Por eso, «mejora el entrenamiento» y «cambia la solución estadística» no son afirmaciones equivalentes.

    Regularización: las unidades también afectan a las penalizaciones

    En un predictor lineal, multiplicar una característica por una constante permite dividir su coeficiente por esa constante sin cambiar su contribución a la predicción. Sin embargo, una penalización L1 o L2 sobre los coeficientes sí cambia bajo esa reparametrización si se mantiene su forma y fuerza. De ahí que la escala importe en Ridge, Lasso y regresión logística regularizada.[6]

    La razón para escalar no se reduce, por tanto, al uso explícito de distancias. En mínimos cuadrados sin penalización, con intercepto y una transformación afín invertible de las características, el espacio de predicciones ajustadas se conserva en aritmética exacta; aun así, el comportamiento numérico puede variar.

    Elegir una escala es elegir cómo se comparan las diferencias.

    04 / Caso particularPCA: ¿qué variabilidad queremos conservar?

    El análisis de componentes principales busca direcciones de máxima varianza mediante combinaciones lineales de las características. Trabajar con datos centrados en sus unidades originales da un PCA de la matriz de covarianzas; estandarizar previamente, con una convención coherente de varianza, conduce al PCA de la matriz de correlaciones.

    Las diferencias de unidades pueden hacer que una característica con gran varianza numérica domine ciertos componentes. Pero un valor medio elevado no implica gran varianza: una variable puede tener valores grandes y variar muy poco. Lo relevante para el PCA es la dispersión y la estructura de covariación.

    Estandarizar antes del PCA es una decisión analítica. Puede justificarse cuando las unidades son heterogéneas y se pretende comparar la variación relativa de las características. Si todas comparten unidades y las diferencias de varianza tienen significado sustantivo, eliminarlas puede ocultar información relevante.[4]

    Tampoco debe identificarse el PCA con el descenso de gradiente. Su cálculo habitual utiliza descomposición en valores singulares de los datos centrados o descomposición espectral de la matriz de covarianzas. En scikit-learn, PCA centra las características, pero no las estandariza automáticamente.[7]

    05 / CriterioCómo elegir una transformación

    El punto de partida debe ser el mecanismo del modelo, la distribución observada y el significado de las variables. Las siguientes opciones son hipótesis de trabajo para contrastar, no garantías de superioridad:

    Tabla 3 · Guía de elección
    SituaciónOpción a evaluarPrecaución
    Comparar diferencias en unidades de dispersiónEstandarizaciónLa media y la desviación son sensibles a extremos.
    Usar un intervalo de referencia acotadoMínimo–máximoValores futuros pueden superar el intervalo; los extremos comprimen el resto.
    Reducir la influencia de extremos sobre los parámetros de escalaMediana y rango intercuartílicoNo elimina observaciones atípicas ni vuelve robusto todo el modelo.
    Comparar dirección o composición del vectorNormalización por normaDescarta su magnitud global.
    Árboles con cortes por una característicaConservar la escala originalVerificar las necesidades de los demás pasos del proceso.
    La elección y sus hiperparámetros deben contrastarse en validación, manteniendo reservado el conjunto final de prueba.

    Valores atípicos y escalamiento robusto

    Cuando unos pocos extremos alteran mucho la media, la desviación o el rango, conviene considerar una referencia menos sensible. Una transformación habitual es:

    rij = [xij − mediana(Xj)] / [Q3,j − Q1,j] Q₁ y Q₃: cuartiles primero y tercero de entrenamiento · su diferencia es el rango intercuartílico, que debe ser distinto de cero para esta fórmula.

    RobustScaler aplica este criterio por defecto. «Robusto» se refiere aquí a cómo se estiman el centro y la escala: un extremo puede seguir muy alejado después de transformar y todavía influir sobre el estimador posterior.[8]

    Casos en que escalar suele aportar poco

    Los árboles convencionales que dividen una característica mediante umbrales conservan, en aritmética exacta, las mismas particiones posibles bajo transformaciones afines de pendiente positiva. El orden de sus valores no cambia. Por eso, el escalamiento no suele ser necesario para esos árboles ni para conjuntos que se basan exclusivamente en ellos; pueden existir diferencias de implementación o precisión numérica.[11]

    Una cadena que incluya selección por distancias, PCA u otro paso sensible a la escala puede necesitarlo aunque su predictor final sea un árbol. La evaluación debe considerar el procedimiento completo.

    06 / AplicaciónTransformar sin anticipar información

    Los parámetros del escalamiento se aprenden de los datos: medias, desviaciones, extremos o cuantiles. Si se calculan con el conjunto completo antes de separar entrenamiento y prueba, se permite que la prueba influya en la construcción del modelo. Esa fuga de información puede producir una evaluación demasiado optimista.

    La regla operativa es sencilla: ajustar el escalador solo con entrenamiento y reutilizar sus parámetros en los demás datos. Dentro de validación cruzada, el ajuste debe repetirse en la parte de entrenamiento de cada partición. Una Pipeline permite realizar ese procedimiento conjuntamente con el estimador.[9]

    Ejemplo reproducible · Python / scikit-learn
    from sklearn.datasets import load_iris
    from sklearn.model_selection import (
        StratifiedKFold,
        cross_val_score,
        train_test_split,
    )
    from sklearn.neighbors import KNeighborsClassifier
    from sklearn.pipeline import make_pipeline
    from sklearn.preprocessing import StandardScaler
    
    X, y = load_iris(return_X_y=True)
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.25,
        stratify=y, random_state=42,
    )
    
    modelo = make_pipeline(
        StandardScaler(),
        KNeighborsClassifier(n_neighbors=5),
    )
    cv = StratifiedKFold(
        n_splits=5, shuffle=True, random_state=42,
    )
    
    # El escalador se ajusta dentro de cada partición.
    scores = cross_val_score(
        modelo, X_train, y_train,
        cv=cv, scoring="accuracy",
    )
    print(f"Exactitud media en CV: {scores.mean():.3f}")
    
    # Ajuste final solo con entrenamiento.
    modelo.fit(X_train, y_train)
    print(f"Exactitud en prueba: {modelo.score(X_test, y_test):.3f}")
    Iris permite ejecutar el ejemplo sin descargar un archivo externo. La prueba se usa al final; si se comparan escaladores o hiperparámetros, esa comparación corresponde a la validación dentro de entrenamiento.

    El ejemplo ilustra la separación correcta entre ajuste y evaluación; no pretende demostrar que estandarizar siempre mejore Iris. En datos temporales, agrupados por persona o con otras dependencias, también debe elegirse una partición que respete esa estructura.

    Al aplicar el modelo a observaciones futuras se conserva el escalador aprendido. Reajustarlo independientemente sobre cada lote cambia las coordenadas de entrada y rompe la correspondencia con el modelo entrenado.

    07 / AlcanceLo que el escalamiento no resuelve

    Escalar forma parte del preprocesamiento, pero no sustituye la limpieza ni la evaluación de la calidad de los datos. No corrige errores de medición, duplicados, sesgos de selección o etiquetas equivocadas; tampoco imputa automáticamente los valores faltantes.

    • Columnas constantes. Si el rango o la desviación son cero, las fórmulas correspondientes requieren un tratamiento específico. Conviene detectar esas columnas y decidir si se conservan.
    • Datos dispersos. Restar la media puede convertir ceros en valores no nulos y elevar mucho el consumo de memoria. StandardScaler(with_mean=False) evita el centrado cuando se necesita preservar la dispersión.[1]
    • Variables categóricas. Asignarles números no establece automáticamente un orden o una distancia legítimos. Su codificación requiere una decisión separada.
    • Interpretación. Un coeficiente expresado por desviación estándar responde a una pregunta distinta de uno expresado por año o por unidad monetaria. La escala elegida debe quedar documentada.

    La cuestión metodológica decisiva es qué diferencias del fenómeno se desea conservar y cuáles provienen únicamente de sus unidades de representación. El conocimiento del objeto de estudio orienta esa elección; la validación permite contrastar sus consecuencias predictivas. Así entendido, el escalamiento es una decisión explícita de modelización.

    08 / Aparato críticoReferencias y notas

    Las llamadas numéricas remiten a documentación primaria de las herramientas y a material universitario. Los datos y cálculos del ejemplo de edad e ingreso son de elaboración propia. Documentación consultada el 26 de octubre de 2026.

    1. Scikit-learn developers. (s. f.). StandardScaler. Documentación de scikit-learn.
    2. Scikit-learn developers. (s. f.). MinMaxScaler. Documentación de scikit-learn.
    3. Scikit-learn developers. (s. f.). Normalizer. Documentación de scikit-learn.
    4. Scikit-learn developers. (s. f.). Importance of Feature Scaling. Ejemplos de scikit-learn.
    5. Scikit-learn developers. (s. f.). Stochastic Gradient Descent. Guía de usuario de scikit-learn.
    6. Scikit-learn developers. (s. f.). Linear Models. Guía de usuario de scikit-learn. Véanse los apartados sobre Ridge, Lasso y regresión logística.
    7. Scikit-learn developers. (s. f.). PCA. Documentación de scikit-learn.
    8. Scikit-learn developers. (s. f.). RobustScaler. Documentación de scikit-learn.
    9. Scikit-learn developers. (s. f.). Common pitfalls and recommended practices. Guía de usuario de scikit-learn.
    10. The Pennsylvania State University. (s. f.). SLR Model Assumptions. STAT 501: Regression Methods.
    11. Scikit-learn developers. (s. f.). Decision Trees. Guía de usuario de scikit-learn.

  • UNA METODOLOGÍA EMPÍRICA PARA LA DETERMINACIÓN DE LA MAGNITUD DE LAS INTERRELACIONES SECTORIALES DENTRO DE LA MATRIZ INSUMO-PRODUCTO DESDE LOS CUADROS DE PRODUCCIÓN Y USOS PARA EL CASO DE ESTADOS UNIDOS 1997-2019

    UNA METODOLOGÍA EMPÍRICA PARA LA DETERMINACIÓN DE LA MAGNITUD DE LAS INTERRELACIONES SECTORIALES DENTRO DE LA MATRIZ INSUMO-PRODUCTO DESDE LOS CUADROS DE PRODUCCIÓN Y USOS PARA EL CASO DE ESTADOS UNIDOS 1997-2019

    Marxist Philosophy of Science
    Economía política · Métodos cuantitativos
    Investigación empírica · Estados Unidos

    Medir la interrelación sectorial de la economía estadounidense

    Una metodología empírica con cuadros de producción y usos, 1997–2019

    La producción social enlaza actividades que, consideradas aisladamente, parecen independientes. Una industria transforma mercancías elaboradas por otras; sus propios productos ingresan, a su vez, en nuevos procesos de producción. Estudiar esa articulación exige conectar el análisis de la estructura económica con instrumentos que hagan observables sus relaciones.

    Resumen

    Este artículo presenta una estrategia para organizar cuadros anuales de producción y usos en series comparables y construir un indicador descriptivo de asociación entre producción e insumos. El estudio original empleó información del BEA para 71 industrias estadounidenses entre 1997 y 2019, procesamiento en R y dos niveles de ponderación de correlaciones absolutas. Esta edición explicita la notación, distingue productos e industrias y conserva las cifras publicadas como resultados históricos sujetos a verificación.

    1997–2019Período de estudio
    71Industrias
    23Observaciones anuales
    por serie completa

    01 / MotivaciónEl problema económico

    Desde la economía política marxista, el estudio de las ramas productivas adquiere sentido dentro del proceso de reproducción del conjunto social. La división del trabajo multiplica las especializaciones, pero también las conexiones materiales necesarias para que cada actividad pueda sostenerse.

    La pregunta que orienta esta investigación es cómo aproximar empíricamente la articulación de la producción utilizando información contable desagregada. Las cuentas insumo-producto ofrecen una base especialmente útil: permiten examinar qué se produce, qué se utiliza como insumo y cómo se distribuyen los usos de las mercancías.

    El antecedente teórico central es la discusión de Kuroki sobre la igualación de la tasa de ganancia y la interdependencia técnica, en el volumen editado por Semmler. La referencia corresponde a la publicación de 1986 de las actas de una conferencia celebrada en 1985.[1] Su conexión con un indicador empírico requiere explicar qué relación se observa y cómo se vincula con las categorías del modelo.

    La tarea empírica consiste en hacer explícito el vínculo entre una categoría económica y la operación estadística empleada para estudiarla.

    Por eso conviene distinguir tres planos: la existencia de flujos productivos, su importancia relativa y la asociación temporal entre sus magnitudes. Se complementan, pero cada uno responde a una pregunta diferente.

    02 / Base estadísticaDatos y unidades de análisis

    Para leer correctamente los archivos es necesario identificar el marco contable. El BEA distingue las tablas de producción y usos del sistema make–use de las tablas del sistema supply–use. En particular, una tabla de oferta incorpora importaciones y no debe tratarse automáticamente como sinónimo de producción doméstica.[2]

    Cuadro 1. Orientación del marco make–use utilizado en esta exposición
    ObjetoFilasColumnasContenido
    Producción, VIndustrias jProductos kProducción de cada producto por cada industria.
    Usos intermedios, UProductos kIndustrias jInsumos de cada producto utilizados por cada industria.
    Producción industrial, xUna observación por industriaVectorSuma de la producción de todos los productos de una industria.

    Fuente: estructura descrita en el manual de cuentas insumo-producto del BEA. Debe verificarse la orientación de cada exportación antes de operar con sus totales.

    Denotemos por vjkt la producción del producto k realizada por la industria j en el año t, y por ukjt el uso intermedio del producto k por esa industria. Con esta orientación, la producción industrial se obtiene sumando la fila de la industria en el bloque de productos:

    xjt = ∑k vjkt (1) Producción bruta de la industria j en el año t.

    La fila inferior de totales de una tabla de producción con esta orientación suma productos, mientras que los totales por industria se obtienen por fila. Elegir una posición de la hoja de cálculo sin comprobar su significado puede cambiar la variable analizada.[3]

    Las capturas originales identifican cuadros after redefinitions y usos a precios de productor. Al replicar, deben mantenerse la misma base de valoración, clasificación y tratamiento de las redefiniciones en ambos cuadros y a lo largo del tiempo. La actualización de una base estadística puede revisar retrospectivamente sus cifras.

    03 / PreparaciónDe las tablas anuales a las series

    El trabajo de preparación consiste en alinear identificadores y observaciones. Un año aporta una sección transversal; la sucesión de años permite construir una base con dimensión temporal e industrial. Cada industria dispone entonces de una serie de producción y de una serie por cada categoría de insumo.

    1. Seleccionar cuadros compatibles.

      Identificar la edición de los datos, las unidades monetarias, el nivel de agregación y el tratamiento de las redefiniciones. Separar los bloques productivos de las filas y columnas de totales, valor agregado y demanda final.

    2. Obtener la producción por industria.

      Construir el vector x de cada año a partir de los totales industriales verificados. Mantener los códigos como identificadores; los nombres sirven como descripción.

    3. Reorientar el bloque de usos cuando resulte útil.

      La transposición de U sitúa las industrias en las filas y los productos en las columnas. Facilita combinar registros, pero conserva el significado de cada flujo: cambia su posición, no su naturaleza económica.

    4. Apilar los años y alinear las claves.

      Construir una tabla con una fila por combinación de industria y año. Comprobar que cada combinación aparece una sola vez y que los insumos mantienen la misma clasificación.

    5. Construir las series comparables.

      Para cada industria, reunir la producción y cada insumo sobre los mismos años. Registrar ausencias, ceros, cambios de clasificación y series constantes antes de calcular correlaciones.

    6. Calcular, ponderar y conservar las salidas.

      Guardar los coeficientes con signo, sus valores absolutos, las observaciones utilizadas, los pesos y los indicadores agregados. La validación debe poder rastrear cada resultado hasta sus datos de entrada.

    Cuadro 2. Estructura de trabajo, con valores representados simbólicamente
    AñoIndustriaProducciónInsumo 1Insumo 2…
    1997jxj,1997u1j,1997u2j,1997…
    1998jxj,1998u1j,1998u2j,1998…
    ⋮⋮⋮⋮⋮⋱
    2019jxj,2019u1j,2019u2j,2019…

    Una serie completa tiene 23 observaciones. Un archivo balanceado con 71 industrias y una fila por industria–año contiene 1.633 filas; el número de columnas depende del bloque de insumos seleccionado.

    04 / MediciónLa asociación temporal producto–insumo

    Para cada pareja formada por una industria y un producto utilizado como insumo, se calcula la correlación de Pearson entre las dos series. El índice temporal recorre los años comparables; no representa una correlación entre industrias dentro de un solo año.

    rjk = corrt(xjt, ukjt) (2) Asociación lineal temporal entre producción industrial y uso del producto k.

    El signo distingue movimientos concordantes y opuestos. Para resumir únicamente su intensidad se utiliza ajk = |rjk|. Conviene conservar ambas matrices: un valor negativo de gran magnitud contiene información económica que desaparece al tomar el valor absoluto.

    Una serie constante no tiene una correlación de Pearson definida. Un flujo nulo durante todos los años tampoco debe convertirse automáticamente en una correlación igual a cero. Si existen datos faltantes, hay que indicar cuántas observaciones sustentan cada coeficiente y mantener un criterio de comparación explícito.

    05 / AgregaciónLos dos niveles de ponderación

    La ponderación incorpora la importancia económica de los flujos. En el primer nivel se resume la asociación de cada industria con sus insumos; en el segundo se agregan los resultados industriales.

    Primer nivel: composición de los insumos

    Sj = ∑k wjk |rjk| (3) wjk ≥ 0 y ∑k wjk = 1 para cada industria j.

    Como cada correlación resume varios años, los pesos deben representar una distribución temporal expresamente definida. Se puede elegir un año de referencia, promediar participaciones anuales o calcular participaciones sobre flujos acumulados. Esas opciones pueden producir resultados diferentes.

    Una convención posible para una nueva réplica es utilizar participaciones sobre los flujos acumulados del período:

    wjk = ∑t ukjt∑t ∑h uhjt (4) Convención ilustrativa de pesos fijos; no se atribuye al script original. Requiere flujos admisibles no negativos y un denominador positivo.

    Cuando una correlación no está definida y su insumo tiene peso positivo, debe revisarse la serie o explicitarse la exclusión y la renormalización de los pesos restantes. Eliminar valores ausentes sin ajustar el denominador modifica el indicador.

    Segundo nivel: participación industrial

    S = ∑j qj Sj (5) qj ≥ 0 y ∑j qj = 1. Debe declararse la variable económica que determina la participación industrial.

    Por ejemplo, se podría definir qj como la participación de la producción bruta acumulada de la industria en la producción bruta acumulada de todas las industrias incluidas. Esta elección también debe documentarse y distinguirse de una ponderación por valor agregado.

    Las ecuaciones anteriores precisan una familia de indicadores. La aplicación exacta depende de los pesos elegidos y de la cobertura de datos. Con pesos no negativos normalizados, los indicadores sectoriales y globales necesariamente pertenecen al intervalo [0, 1].

    06 / Ejemplo didácticoCómo se interpreta la ponderación

    Supongamos una industria con dos categorías de insumo. La primera tiene una correlación de 0,90 con la producción y representa el 80 % de sus insumos; la segunda tiene una correlación de −0,20 y representa el 20 % restante.

    SA = 0,80 × |0,90| + 0,20 × |−0,20| = 0,76 Ejemplo inventado para explicar la operación; no corresponde a una estimación del BEA.

    La media simple de las dos magnitudes sería 0,55. El resultado ponderado es mayor porque la asociación más alta corresponde al insumo de mayor participación. La ponderación expresa una elección económica; su aumento no constituye, por sí solo, una mejora de la evidencia.

    Si otra industria obtiene 0,40 y las participaciones industriales son 0,60 y 0,40, respectivamente, el indicador del conjunto es:

    S = 0,60 × 0,76 + 0,40 × 0,40 = 0,616 El resultado permanece entre los dos indicadores industriales que se agregan.

    07 / Evidencia publicadaResultados y nota de verificación

    Las salidas de R reproducidas en la publicación original muestran las siguientes cifras. Se transcriben para conservar la trazabilidad documental; esta edición no recalcula la base ni certifica su reproducción.

    Cuadro 3. Cifras reportadas en las capturas de 2021
    EtapaValor reportadoLectura documental
    Media de correlaciones absolutas0,6837338Resumen previo a las ponderaciones económicas.
    Media de los indicadores industriales0,7351034Salida asociada a la primera ponderación.
    Agregado con ponderación industrial0,7778624Salida final reportada.

    Fuentes: primera salida, segunda salida y salida final de la publicación original.

    También debe distinguirse la correlación r del coeficiente de determinación R2. Un promedio de correlaciones absolutas no puede presentarse como proporción de varianza explicada. La relación habitual R2 = r2 corresponde a una regresión lineal simple con intercepto, no a este agregado de múltiples parejas.[4]

    Finalmente, calificar una correlación como «fuerte» requiere un criterio contextual. Si se elige 0,70 como referencia descriptiva, su distancia respecto de 0,6837338 es 0,0162662 unidades del indicador. La proximidad a ese umbral no reemplaza la validación del cálculo ni establece una conclusión económica.

    08 / DiscusiónInterpretación y alcance

    Qué permite estudiar esta estrategia

    Una vez validados los datos y los cálculos, el procedimiento permite comparar perfiles industriales de asociación temporal y estudiar cómo cambia su síntesis al introducir ponderaciones económicas. Su utilidad reside también en hacer trazable el paso desde los cuadros contables hasta las series y los indicadores.

    Qué comprobaciones fortalecerían la inferencia

    • Precios y tendencias. Revisar cuánto de la asociación entre magnitudes monetarias responde a variaciones de precios o tendencias comunes. Según la pregunta, contrastar niveles, series deflactadas, tasas de crecimiento o especificaciones temporales justificadas.
    • Dependencia temporal y estabilidad. Examinar autocorrelación, observaciones influyentes y posibles rupturas. Los contrastes estadísticos deben respetar la estructura temporal de los datos.
    • Decisiones de agregación. Comparar pesos y cobertura, conservar la información de los signos y documentar el tratamiento de los productos vinculados al propio sector.
    • Contenido estructural. Contrastar el indicador con medidas basadas en flujos y requerimientos productivos. La coincidencia temporal y la intensidad técnica de un vínculo son dimensiones distintas.

    Estas comprobaciones son extensiones propuestas. No se presentan como pruebas ya realizadas en el estudio de 2021.

    Las correlaciones entre series con tendencias pueden inducir interpretaciones engañosas; las técnicas de series temporales ayudan a distinguir esos movimientos de relaciones más estables.[4] Asimismo, la producción bruta incorpora los insumos intermedios dentro de una identidad contable. Esa conexión debe formar parte de la interpretación económica del resultado.

    La relación con la discusión marxista

    La investigación empírica puede contribuir al debate sobre reproducción, competencia y articulación de las ramas productivas. Para conectar este indicador con la dinámica de la tasa de ganancia, hay que justificar el paso entre la asociación observada y la interdependencia técnica pertinente para el modelo.

    El caso estadounidense ofrece un ámbito de investigación relevante. Su análisis no establece por sí solo una regularidad universal ni verifica todas las condiciones de un resultado teórico sobre estabilidad. La comparación con otros períodos, países y medidas estructurales permitiría evaluar la generalidad de la hipótesis.

    La fuerza de una investigación aumenta cuando sus datos, sus operaciones y el alcance de sus conclusiones pueden examinarse por separado.

    El aporte que conviene desarrollar es una estrategia reproducible para organizar información productiva y someter una hipótesis de articulación económica a examen. La revisión del cálculo publicado y las pruebas de robustez constituyen los siguientes pasos para consolidar esa contribución.

    09 / MaterialesReplicación y trazabilidad

    El archivo de materiales enlazado al final corresponde al recurso facilitado por los autores en la entrada original. Para una réplica completa conviene conservar tanto los archivos descargados como las transformaciones que produce el código.

    1. Registrar el origen: fecha de descarga, edición, cuadros, unidades, valoración y códigos industriales y de productos.
    2. Verificar la alineación: claves únicas, cobertura anual, cambios de clasificación y correspondencia entre producción y usos.
    3. Auditar los coeficientes: variación de las series, número de observaciones, valores ausentes y rango de cada correlación.
    4. Auditar las ponderaciones: definición temporal, denominadores positivos, pesos no negativos y suma igual a uno en cada nivel.
    5. Publicar las salidas: matrices con signo y en valor absoluto, pesos, resultados sectoriales y agregado final, junto con la versión de R y sus paquetes.

    Los controles de rango son especialmente útiles: un indicador de la forma descrita debe permanecer entre cero y uno. Si una salida incumple esa propiedad, corresponde detener la interpretación y localizar la operación que la genera.

    10 / FuentesReferencias y lecturas

    Fuentes de esta edición
    1. [1] Kuroki, R. (1986). The equalization of the rate of profit reconsidered. En W. Semmler (Ed.), Competition, instability, and nonlinear cycles (pp. 35–50). Springer. Registro editorial. Conferencia celebrada en marzo de 1985; año de publicación corregido según el editor.
    2. [2] U.S. Bureau of Economic Analysis. (s. f.). Guide to the interactive industry input-output accounts tables. Consultar guía.
    3. [3] U.S. Bureau of Economic Analysis. (2006). Concepts and methods of the U.S. input-output accounts. Manual metodológico.
    4. [4] Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3.ª ed.). OTexts. Capítulo 7: modelos de regresión con series temporales. Consultar capítulo.
    5. [5] U.S. Bureau of Economic Analysis. (s. f.). Input-output. Acceso a los cuadros y a las correspondencias de códigos. Consultar datos.
    Bibliografía del debate y fuentes consignadas en la publicación original

    Se conserva como orientación bibliográfica del artículo de 2021; las obras enumeradas no se presentan como una revisión exhaustiva del estado actual de la investigación.

    • Cockshott, P., & Cottrell, A. (2005). Robust correlations between prices and labor values. Cambridge Journal of Economics, 309–316.
    • Cockshott, P., Cottrell, A., & Valle Baeza, A. (2014). The empirics of the labour theory of value: Reply to Nitzan and Bichler. Investigación Económica, 115–134.
    • Cockshott, P., Cottrell, A., & Zachariah, D. (2019). Against the Kliman theory. Documento enlazado en el original.
    • Kliman, A. (2002). The law of value and laws of statistics: Sectoral values and prices in the US economy, 1977–97. Cambridge Journal of Economics, 299–311.
    • Kliman, A. (2005). Reply to Cockshott and Cottrell. Cambridge Journal of Economics, 317–323.
    • Kliman, A. (2014). What is spurious correlation? A reply to Díaz and Osuna. Journal of Post Keynesian Economics, 345–356.
    • Mindrila, D., & Balentyne, P. (s. f.). Scatterplots and correlation. University of West Georgia. Apuntes enlazados en el original.
    • Nabi, I. (2021). Sobre la metodología del U.S. Bureau of Economic Analysis para la redefinición y reasignación de productos en la matriz insumo-producto de Estados Unidos. Entrada relacionada.
    • Sánchez, C., & Ferràndez, M. N. (2010). Valores, precios de producción y precios de mercado a partir de los datos de la economía española. Investigación Económica, 87–118.
    • Sánchez, C., & Montibeler, E. E. (2015). La teoría del valor trabajo y los precios en China. Economia e Sociedade, 329–354.
    • U.S. Bureau of Economic Analysis. (2021). The make of commodities by industries, after redefinitions; The use of commodities by industries, after redefinitions (producers’ prices). Cuadros utilizados en el estudio original.
    • Zachariah, D. (2006). Labour value and equalisation of profit rates: A multi-country study. Indian Development Review, 4, 1–20.
    Código y datos originales ↗

    Recurso enlazado por los autores en la publicación de 2021.
    Economía política · Evidencia empírica · Replicación

  • LA CONJETURA DE COLLATZ COMO FUNCIÓN PERSONALIZADA EN RSTUDIO

    LA CONJETURA DE COLLATZ COMO FUNCIÓN PERSONALIZADA EN RSTUDIO

    Matemática · Programación en R · Sistemas dinámicos discretos

    La conjetura de Collatz como función personalizada en R

    Una introducción a funciones, iteración y recursión a partir de una regla matemática extraordinariamente sencilla cuyo comportamiento global continúa resistiéndose a una demostración general.


    Un ejemplo particularmente agradable de función personalizada es una función construida para estudiar computacionalmente la célebre conjetura de Collatz. La elección resulta útil porque la regla matemática es muy sencilla, mientras que su comportamiento global no lo es: basta con distinguir entre números pares e impares y repetir siempre la misma transformación. Esa combinación permite concentrarse en la lógica de programación sin perder de vista el objeto matemático que se está programando.

    La conjetura establece, en términos elementales, que si se parte de cualquier entero positivo y se divide entre dos cuando el número es par, o bien se multiplica por tres y se le suma uno cuando es impar, la sucesión obtenida llegará finalmente a la unidad. Es importante formularlo con cuidado: un programa puede comprobar que esto ocurre para un valor inicial concreto —o para una colección finita de valores—, pero esa comprobación computacional no constituye por sí misma una demostración de que ocurra para todos los enteros positivos. Precisamente ahí reside el problema matemático.

    1. La regla de Collatz y qué significa comprobarla

    Matemáticamente, la regla que genera las sucesivas imágenes puede expresarse mediante la siguiente función definida a trozos:

    T(n) =
    CondiciónOperaciónNueva imagen
    n es parDividir entre 2T(n) = n/2
    n es imparMultiplicar por 3 y sumar 1T(n) = 3n + 1

    Tabla 1. La regla local de Collatz. Cada paso está completamente determinado por la paridad del estado presente.

    Si se parte de un origen o valor semilla n0, la aplicación sucesiva de la función construye una órbita:

    n0,   n1 = T(n0),   n2 = T(n1),   … ,   nk = Tk(n0).

    Esta notación permite introducir desde el inicio una distinción que después será importante en R. Si la órbita alcanza la unidad por primera vez tras k aplicaciones de la regla, entonces se han realizado k iteraciones o transiciones, pero el listado completo de estados contiene k + 1 valores, porque también se cuenta el valor inicial.

    Distinción útil

    Puede llamarse tiempo total de parada al número de aplicaciones de T necesarias para alcanzar 1. Si se denota por τ(n), entonces la conjetura puede escribirse, de manera compacta, como: τ(n) < ∞ para todo entero positivo n.

    Por consiguiente, lo que se programará a continuación no es una “prueba” de la conjetura en el sentido matemático de una demostración universal. Será, en cambio, un mecanismo capaz de generar y examinar órbitas particulares, registrar sus estados y contar cuántas transformaciones fueron necesarias para llegar a 1 cuando efectivamente se llegue a ese valor.

    · · ·

    2. Una primera función personalizada en R

    Para construir la regla anterior en R conviene recordar que una función personalizada permite tomar una entrada, someterla a determinadas instrucciones y devolver una salida. En este primer paso todavía no habrá iteración: únicamente se evaluará un número y se producirá su siguiente imagen de Collatz.

    La condición fundamental es la paridad. En R, el operador %% devuelve el residuo de una división. Si n %% 2 == 0, el número es divisible entre dos y, por consiguiente, es par. Si el residuo es distinto de cero, es impar.

    R · regla de un pasoFuncionDeCollatz <- function(n) {
      if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
        stop("n debe ser un entero positivo.")
      }
    
      if (n %% 2 == 0) {
        j <- n / 2
      } else {
        j <- 3 * n + 1
      }
    
      return(j)
    }

    La función recibe un entero positivo n, determina si es par o impar y guarda el resultado en j. La instrucción return(j) no significa, estrictamente, “imprimir j en la pantalla”; significa que j será el valor devuelto por la función. Cuando la función se ejecuta directamente en la consola interactiva de R, ese valor devuelto suele mostrarse automáticamente, lo que explica por qué ambas ideas pueden confundirse al comenzar a programar.

    Return y print no son lo mismo

    return(x) termina la función y entrega x como su resultado. print(x), en cambio, pide explícitamente que x sea impreso. Una función puede devolver un valor sin contener ninguna instrucción print().

    Obsérvese también que no hace falta impedir que esta función sea evaluada en 1: según la regla estándar, 1 es impar y su siguiente imagen sería 4. Lo que hará el algoritmo que construiremos después será detener la órbita al alcanzar 1, es decir, no volverá a aplicar la regla una vez alcanzado el objetivo.

    3. Del paso individual al algoritmo iterativo

    La función anterior realiza solamente una transformación. Para obtener una órbita completa es necesario repetirla mientras el valor presente sea diferente de 1. Aquí aparece el bucle del tipo “mientras” —while-loop—, cuya lógica es exactamente la que su nombre indica: ejecutar un determinado bloque de instrucciones durante el tiempo en que una condición siga siendo verdadera.

    Esta segunda función es, por tanto, iterativa. No es todavía recursiva, porque no se llama a sí misma; lo que hace es repetir explícitamente un bloque de código mediante while().

    R · algoritmo iterativoAlgoritmoIterativoDeCollatz <- function(m, max_iter = 1000000L) {
      if (length(m) != 1L || !is.finite(m) || m < 1 || m != floor(m)) {
        stop("m debe ser un entero positivo.")
      }
    
      trayectoria <- m
      iteraciones <- 0L
    
      while (m != 1) {
        if (iteraciones >= max_iter) {
          stop("Se alcanzó max_iter antes de llegar a 1.")
        }
    
        m <- FuncionDeCollatz(m)
        trayectoria <- c(trayectoria, m)
        iteraciones <- iteraciones + 1L
      }
    
      return(trayectoria)
    }

    La lógica es sencilla. El vector trayectoria nace dentro de la propia función y contiene inicialmente el valor semilla. Después, cada vez que se ejecuta el bucle, m se reemplaza por su siguiente imagen y ese nuevo valor se agrega al final del vector. Cuando m llega a 1, la condición m != 1 deja de cumplirse y el bucle termina.

    Se utiliza aquí la letra m simplemente para distinguir visualmente el argumento de esta segunda función del n empleado en la primera. No existe una necesidad sintáctica de hacerlo: los argumentos y objetos creados dentro de cada función poseen su propio ámbito local, por lo que dos funciones distintas pueden utilizar sin conflicto un argumento llamado n.

    Definir el vector dentro de la función tiene una ventaja importante: cada ejecución conserva su propio estado y no depende de objetos previamente existentes en el entorno global de R. En otras palabras, si se ejecuta la función una vez con 27 y después con 8, la segunda órbita no hereda los valores de la primera.

    El argumento max_iter no forma parte de la Matemática de Collatz; es una precaución computacional. Como el enunciado general que se desea demostrar no puede simplemente asumirse al escribir el programa, resulta prudente impedir que un bucle pueda continuar sin límite en caso de que se use con datos inesperados o con una implementación modificada.

    ObjetoTipoPapel
    FuncionDeCollatzfunctionCalcula una sola imagen de la regla de Collatz.
    AlgoritmoIterativoDeCollatzfunctionRepite la regla con while() y construye la trayectoria completa hasta 1.
    trayectorianumeric vectorExiste localmente durante una ejecución y almacena los estados visitados.

    Tabla 2. Equivalente conceptual de lo que se observaría en el entorno de R tras definir las funciones. El vector de trayectoria no necesita permanecer en el entorno global.

    · · ·

    4. La órbita de 27: 112 estados y 111 iteraciones

    Puede evaluarse ahora un número cualquiera en el algoritmo construido. Tomemos el ejemplo clásico de 27. La sucesión comienza 27, 82, 41, 124, 62, 31… y continúa con ascensos y descensos hasta alcanzar finalmente 1.

    R · ejemploorbita_27 <- AlgoritmoIterativoDeCollatz(27)
    length(orbita_27)
    # 112
    
    length(orbita_27) - 1L
    # 111
    
    max(orbita_27)
    # 9232

    Éste es un buen lugar para precisar el vocabulario. La órbita almacenada contiene 112 estados, porque incluye tanto el punto de partida 27 como el punto de llegada 1. Sin embargo, entre 112 estados existen solamente 111 transiciones. Por consiguiente, el tiempo total de parada de 27, entendido como número de aplicaciones de la regla necesarias para alcanzar la unidad, es 111.

    k=027k=182k=241k=3124k=462k=531k=694k=747
    k=8142k=971k=10214k=11107k=12322k=13161k=14484k=15242
    k=16121k=17364k=18182k=1991k=20274k=21137k=22412k=23206
    k=24103k=25310k=26155k=27466k=28233k=29700k=30350k=31175
    k=32526k=33263k=34790k=35395k=361186k=37593k=381780k=39890
    k=40445k=411336k=42668k=43334k=44167k=45502k=46251k=47754
    k=48377k=491132k=50566k=51283k=52850k=53425k=541276k=55638
    k=56319k=57958k=58479k=591438k=60719k=612158k=621079k=633238
    k=641619k=654858k=662429k=677288k=683644k=691822k=70911k=712734
    k=721367k=734102k=742051k=756154k=763077k=779232k=784616k=792308
    k=801154k=81577k=821732k=83866k=84433k=851300k=86650k=87325
    k=88976k=89488k=90244k=91122k=9261k=93184k=9492k=9546
    k=9623k=9770k=9835k=99106k=10053k=101160k=10280k=10340
    k=10420k=10510k=1065k=10716k=1088k=1094k=1102k=1111

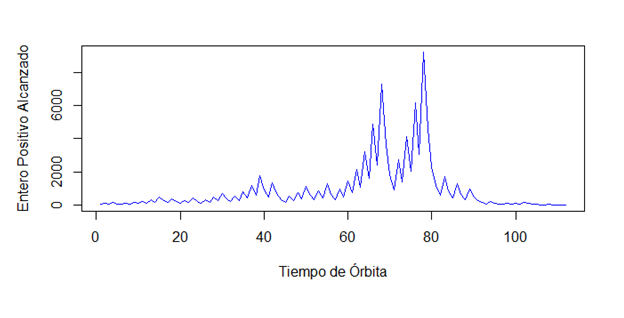
    Tabla 3. Órbita completa de 27. La etiqueta k indica cuántas aplicaciones de la regla se han realizado. El máximo, 9232, aparece en k = 77; la unidad aparece en k = 111.

    La trayectoria muestra además una propiedad que hace tan sugestivo el problema: una regla determinista extraordinariamente simple no genera necesariamente una evolución visualmente simple. Que el sistema esté perfectamente determinado paso a paso no significa que su comportamiento global sea evidente.

    Si se desea conservar el gráfico tradicional en R, puede generarse, por ejemplo, con:

    R · visualización opcionalplot(
      orbita_27,
      type = "l",
      xlab = "Iteración k",
      ylab = "n_k"
    )

    La tabla presenta la órbita completa, de modo que cada estado pueda leerse directamente y seguirse paso a paso.

    5. Una segunda solución: recursión

    Existe otra forma de diseñar el algoritmo. Puede resultar algo menos intuitiva al imaginarla por primera vez, pero tiene una notable elegancia: en lugar de construir un bucle while(), la propia función vuelve a llamarse a sí misma después de calcular el siguiente valor.

    El problema exige ahora una función con dos características principales: su entrada es un entero positivo representable por el sistema numérico que estemos utilizando; su salida contiene, por un lado, la trayectoria seguida y, por otro, el número de transformaciones efectuadas para alcanzar la unidad.

    R · versión recursivaCollatzRecursivo <- function(n, v = NULL) {
      if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
        stop("n debe ser un entero positivo.")
      }
    
      v <- c(v, n)
    
      if (n == 1) {
        return(list(
          pasos = v,
          iteraciones = length(v) - 1L
        ))
      }
    
      if (n %% 2 == 0) {
        n <- n / 2
      } else {
        n <- 3 * n + 1
      }
    
      return(CollatzRecursivo(n, v))
    }

    Aquí sí se aplica recursión en el sentido preciso de la programación: dentro de la ejecución de CollatzRecursivo() aparece una nueva llamada a CollatzRecursivo(). Esa nueva llamada recibe un valor distinto de n y una copia ampliada del vector v.

    La condición n == 1 es el caso base. Sin un caso base alcanzable, una definición recursiva continuaría produciendo llamadas adicionales hasta agotar los recursos disponibles. Cuando se llega a 1 ya no se crea una nueva llamada: se devuelve la lista que contiene la órbita y el número de iteraciones.

    Tres funciones estándar utilizadas

    c() concatena elementos o vectores. list() construye una lista cuyos componentes pueden tener nombres y tipos distintos. length() devuelve el número de elementos de un objeto como un vector o una lista; no debe confundirse con dim(), que informa las dimensiones de objetos que poseen un atributo dimensional.

    La expresión iteraciones = length(v) – 1L merece atención. Si v contiene tanto el valor inicial como la unidad final, su longitud cuenta estados, no transformaciones. Restar uno corrige exactamente esa diferencia.

    SemillaEstados devueltosIteraciones
    88 → 4 → 2 → 13
    27112 estados desde 27 hasta 1111

    Tabla 4. La diferencia entre contar estados y contar aplicaciones de la función. En la trayectoria 8 → 4 → 2 → 1 hay cuatro valores, pero solamente tres pasos.

    Es necesario agregar una salvedad práctica. La recursión es una excelente herramienta para comprender la estructura lógica del problema, pero no siempre es la forma más robusta de recorrer órbitas largas en R: cada llamada recursiva añade un nuevo marco de ejecución y la profundidad disponible es finita. Para trabajo computacional intensivo, la versión iterativa suele ser preferible; para comprender qué significa que una función se invoque a sí misma, la versión recursiva es particularmente transparente.

    · · ·

    6. Cómo pensar matemáticamente la recursión

    Antes de programar una solución recursiva conviene separar dos cosas que, aunque íntimamente relacionadas, no son idénticas: la dinámica matemática y la estructura de llamadas del programa. La función matemática fundamental sigue siendo T. Lo que cambia es la manera en que el programa organiza el cálculo de sus iteraciones.

    El algoritmo puede pensarse de la siguiente manera:

    Paso lógicoAcción
    1Ingresar un entero positivo N.
    2Registrar N como un nuevo estado de la trayectoria.
    3Si N = 1, devolver la trayectoria y terminar.
    4aSi N es par, asignar N ← N/2.
    4bSi N es impar, asignar N ← 3N + 1.
    5Ejecutar nuevamente la misma función utilizando el nuevo valor de N.

    Tabla 5. Caso de uso de la solución recursiva. La recursión aparece en el último paso: la función vuelve a ejecutarse con una entrada nueva.

    Matemáticamente, sin embargo, no hace falta definir una nueva función C(n) cuyo valor sea siempre 1 cuando la recursión termina. Esa escritura ocultaría el objeto que realmente interesa. Resulta más limpio conservar T como el mapa de Collatz y definir la órbita mediante iteraciones sucesivas:

    nk+1 = T(nk),    k = 0, 1, 2, …

    El tiempo total de parada puede escribirse entonces como el primer índice en que la órbita toca la unidad:

    τ(n) = min { k ≥ 0 : Tk(n) = 1 }, cuando tal k existe.

    Esta formulación hace visible la verdadera dificultad. Conocemos exactamente la regla local que lleva de un estado al siguiente. Lo que no se sigue automáticamente de esa definición es que τ(n) sea finito para todos los enteros positivos.

    Tomemos n = 8:

    k = 0k = 1k = 2k = 3
    8→4→2→1

    Tabla 6. Desde 8 hasta 1 existen cuatro estados y tres aplicaciones de T. Por tanto, τ(8) = 3.

    La función recursiva reproduce computacionalmente esta misma cadena, pero cada flecha corresponde ahora no sólo a una transformación matemática, sino también a una nueva llamada de función. La sucesión matemática avanza de 8 a 4, de 4 a 2 y de 2 a 1; el programa, mientras tanto, va creando niveles de ejecución hasta encontrar el caso base.

    7. La pila de llamadas: por qué es LIFO

    Para comprender qué ocurre durante la recursión puede utilizarse un ejemplo deliberadamente sencillo. Supóngase que existe un “Listado X” con estas instrucciones:

    Listado X

    1. Ejecutar A1.
    2. Ejecutar A2.
    3. Ejecutar las instrucciones del Listado X.
    4. Regresar e imprimir “Hola, Fernanda”.

    Al llegar al paso 3 el programa inicia otra ejecución del mismo listado. Esa nueva ejecución llega a su propio paso 3 y crea otra, y así sucesivamente. Como no existe aquí un caso base, el paso 4 nunca llega a ejecutarse: antes se agotarán los recursos que el entorno permite dedicar a llamadas anidadas.

    NivelA1A2Paso 3Resultado
    Listado X₀ejecutaejecutallama X₁queda pendiente
    Listado X₁ejecutaejecutallama X₂queda pendiente
    Listado X₂ejecutaejecutallama X₃queda pendiente
    ⋮⋮⋮⋮⋮

    Tabla 7. Estructura de las llamadas recursivas. Cada llamada queda suspendida mientras espera que termine la llamada creada dentro de ella.

    Cuando sí existe un caso base, como ocurre en nuestro algoritmo al alcanzar 1, la situación cambia. La llamada más profunda termina primero; después puede terminar la que la creó; después la anterior, y así sucesivamente. Por eso la estructura natural de las llamadas anidadas es una stack o pila, organizada como LIFO: Last In, First Out, es decir, “el último en entrar es el primero en salir”.

    TOPE DE LA PILA · llamada con n = 1 · termina primero
    llamada con n = 2 · espera el resultado de n = 1
    llamada con n = 4 · espera el resultado de n = 2
    BASE · llamada con n = 8 · fue creada primero

    Tabla 8. La pila de llamadas para 8 → 4 → 2 → 1. La llamada con 1 es la última en entrar y la primera que puede finalizar; después se resuelven las llamadas pendientes en orden inverso.

    La analogía con una pila de platos continúa siendo útil: si se apilan varios platos uno sobre otro, el último colocado queda en la parte superior y es el primero que puede retirarse sin desarmar la pila. Sin embargo, conviene precisar la razón técnica: las llamadas recursivas se organizan de esta forma por la estructura anidada del control del programa. La relación con la localidad de memoria o con posibles efectos sobre la caché puede ser relevante en otros contextos de rendimiento, pero no es la causa que explica por qué la pila de llamadas es LIFO.

    Una llamada A que invoca a B no puede continuar más allá de ese punto hasta que B haya terminado; y si B invoca a C, B tampoco puede continuar hasta que C termine. De ahí surge naturalmente el orden C → B → A.
    · · ·

    8. Qué nos enseña Collatz sobre Matemática y Computación

    Hay todavía una cuestión conceptual que merece atención. Podría parecer, a primera vista, que la formulación matemática nos ofrece un proceso “continuo” mientras que el programa lo convierte en una colección de pasos discretos. Esa oposición, sin embargo, no describe correctamente este problema. La dinámica de Collatz es discreta desde su propia definición matemática: el tiempo de la iteración está indexado por 0, 1, 2, 3, … y cada estado pertenece, en su formulación usual, al conjunto de los enteros positivos.

    Por tanto, la diferencia interesante no está entre una Matemática continua y una Computación discreta. Está en otra parte: entre definir una regla, calcular sus consecuencias para casos particulares y demostrar una propiedad global de todas sus órbitas.

    NivelQué sabemosQué no se sigue automáticamente
    Regla matemáticaPara cada estado sabemos exactamente cuál es el siguiente.No conocemos por esa sola razón el destino global de toda órbita posible.
    Cálculo computacionalPodemos seguir paso a paso una órbita particular y comprobar si alcanza 1.Un número finito de comprobaciones no equivale a una demostración universal.
    Demostración matemáticaBuscaría establecer una proposición válida para todos los enteros positivos.No puede reemplazarse simplemente por enumerar más y más casos.

    Tabla 9. Tres niveles de conocimiento que Collatz obliga a distinguir: especificación local, experimentación computacional y demostración global.

    Esta distinción permite formular de manera más precisa la reflexión epistemológica que hace atractivo al ejemplo. La Matemática no consiste necesariamente en colocar un fenómeno dentro de una forma analítica cuyo comportamiento ya sea conocido. Collatz muestra exactamente lo contrario: podemos poseer una regla perfectamente definida y, aun así, carecer de una caracterización completa de su comportamiento global.

    Tampoco la Computación queda reducida a atender “particularidades” que la Matemática habría abstraído. En este caso ambas trabajan sobre el mismo objeto discreto, pero hacen preguntas diferentes. El programa permite ejecutar la regla, inspeccionar órbitas, medir tiempos de parada, descubrir regularidades y someter conjeturas auxiliares a prueba numérica. La demostración matemática pregunta, en cambio, qué puede afirmarse necesariamente para una clase infinita de casos.

    Conocer de manera exacta la ley que gobierna cada paso no equivale a conocer de antemano el comportamiento global del sistema.

    Ésta es, probablemente, una de las enseñanzas más interesantes que puede extraerse del problema desde la perspectiva conjunta de la Matemática y las Ciencias de la Computación. En Collatz hay determinación local, computabilidad efectiva de cada paso y una enorme cantidad de evidencia para valores particulares; pero esas tres cosas no deben confundirse con una demostración universal.

    9. Una precaución: los enteros de la Matemática no son los de la máquina

    Finalmente, hay una diferencia adicional entre el objeto matemático y su implementación concreta que conviene hacer explícita. La expresión “cualquier N ∈ ℕ” describe un dominio matemático ilimitado. Una computadora, en cambio, representa números mediante estructuras finitas.

    En R base existen, entre otras cosas, valores de tipo integer, cuyo rango es limitado, y valores numeric que normalmente utilizan aritmética de doble precisión. Estos últimos pueden representar exactamente todos los enteros sólo hasta cierto tamaño; por encima de 253, no todos los enteros consecutivos poseen una representación exacta como números de doble precisión.

    La cuestión es particularmente relevante en Collatz porque una órbita puede crecer mucho por encima de su valor inicial antes de comenzar a descender. Por consiguiente, una implementación destinada a investigar números muy grandes debe utilizar aritmética entera exacta de mayor capacidad —por ejemplo, enteros de precisión arbitraria— y comprobar cuidadosamente posibles desbordamientos o pérdidas de exactitud.

    Matemática frente a implementación

    Objeto matemático: T actúa sobre todos los enteros positivos.
    Programa concreto: sólo puede actuar correctamente sobre los valores que su representación numérica y sus recursos de memoria permiten manipular de manera exacta.

    Esto no invalida el uso pedagógico del código anterior. Para semillas pequeñas, como 8 o 27, la implementación es perfectamente adecuada. Lo que evita es atribuirle a una representación computacional finita el mismo dominio ilimitado que posee el objeto matemático abstracto.

    · · ·

    Consideraciones finales

    La conjetura de Collatz constituye un ejemplo extraordinariamente fértil para aprender a programar porque permite pasar, casi sin introducir artificios, desde una regla matemática elemental hasta varias ideas centrales de las Ciencias de la Computación. Primero se construye una función que decide entre dos operaciones; después se convierte esa operación en una iteración; luego se almacena la órbita; finalmente se reconstruye el mismo proceso mediante recursión y se observa cómo las llamadas anidadas quedan organizadas en una pila.

    Pero el ejemplo es igualmente fértil por una razón más profunda. Una sucesión puede estar gobernada por una regla completamente determinista y, aun así, plantear enormes dificultades cuando se intenta establecer una propiedad global para todas sus trayectorias. El programa sabe qué hacer en cada paso. La dificultad matemática consiste en justificar qué ocurrirá después de todos los pasos necesarios, para cualquier punto de partida posible.

    En este sentido, la programación no reemplaza la demostración ni la demostración vuelve innecesaria a la programación. La primera permite experimentar con el objeto, recorrerlo y producir evidencia concreta; la segunda busca establecer relaciones que no dependan de haber enumerado previamente cada caso. Collatz es un terreno particularmente limpio para observar esa diferencia porque no hay oscuridad alguna en la regla elemental: la dificultad emerge de la dinámica producida al repetirla.

    Y justamente por ello una función personalizada en R resulta algo más que un ejercicio de sintaxis. Permite observar, en una escala pequeña y manejable, el tránsito entre definición, algoritmo, ejecución, representación numérica y razonamiento matemático; es decir, entre distintos niveles de una misma actividad científica que conviene mantener relacionados sin confundirlos.

  • ESTIMADORES DE BAYES, ANÁLISIS DE CLÚSTERES Y MIXTURAS GAUSSIANAS

    ESTIMADORES DE BAYES, ANÁLISIS DE CLÚSTERES Y MIXTURAS GAUSSIANAS

    Probabilidad · Teoría estadística · Aprendizaje no supervisado

    De los estimadores de Bayes a las mezclas gaussianas

    Una lectura guiada del estudio de José Mauricio Gómez Julián de 2020 sobre teoría bayesiana de la decisión, análisis de conglomerados, estimación de densidades, el algoritmo EM y agrupamiento basado en modelos en R.

    Investigación realizada en 2020 José Mauricio Gómez Julián Lectura aprox. de 15 minutos

    La estadística suele volverse difícil no porque una idea aislada sea imposible de entender, sino porque de pronto hay que mantener varias ideas conectadas al mismo tiempo. Una distribución de probabilidad conduce a un estimador; un estimador conduce a una función de pérdida; una función de pérdida conduce a un problema de optimización; un problema de optimización conduce a un algoritmo; y el algoritmo termina produciendo algo que en la pantalla parece engañosamente sencillo: un puñado de conglomerados. El estudio de Gómez Julián de 2020, Sobre los estimadores de Bayes, el análisis de conglomerados y las mezclas gaussianas, es, en esencia, un intento por reconstruir toda esa cadena de razonamiento antes de pedirle a R que haga el cálculo.

    Su destino es el análisis de conglomerados basado en modelos mediante mezclas gaussianas finitas. Pero el artículo toma deliberadamente el camino largo. Antes de llegar a las mezclas gaussianas y a la rutina Mclust(), recorre la probabilidad posterior, los estimadores bayesianos, las funciones de pérdida, el error cuadrático medio, los criterios de información, la minería de datos, el aprendizaje automático, el aprendizaje supervisado y no supervisado, la estimación de densidades, k-means, el algoritmo de esperanza-maximización, las distribuciones categórica y de Dirichlet, la optimización, los parámetros y los hiperparámetros. El objetivo no es simplemente enumerar definiciones, sino mostrar por qué todos estos conceptos se encuentran dentro de una misma maquinaria estadística.

    Nota de lectura · qué hará este artículo

    El estudio original de 2020 es mucho más amplio que un tutorial convencional de software. Por ello, esta lectura guiada se concentra en su arquitectura estadística principal: cómo encajan entre sí el razonamiento bayesiano, el análisis de conglomerados, los modelos de mezclas gaussianas, el algoritmo EM y la selección de modelos basada en BIC, y qué ocurre cuando este marco se aplica en R.

    · · ·

    01 · Contexto Por qué se escribió este estudio de 2020

    La motivación inmediata es la investigación educativa. Gómez Julián parte de un estudio doctoral de Villegas Barahona centrado en el rendimiento académico, las dimensiones latentes, las variables estudiantiles observadas directamente, la descomposición matricial CUR y la construcción de un modelo estadístico capaz de apoyar la toma de decisiones académicas y administrativas. Ese proyecto anterior aporta el problema práctico; el estudio de 2020 pregunta qué teoría estadística debe comprenderse para seguir la maquinaria que se utiliza.

    Esto importa porque un paquete estadístico puede hacer que un procedimiento difícil parezca trivial. Un investigador puede escribir un comando, obtener una clasificación, observar un gráfico y seguir adelante. Sin embargo, el comando presupone silenciosamente respuestas a preguntas difíciles. ¿Qué se está estimando? ¿Qué significa que las observaciones pertenezcan a grupos distintos? ¿Qué ocurre cuando esas pertenencias no se observan? ¿Cómo deben elegirse el número y la geometría de los grupos? ¿Qué cantidad maximiza el algoritmo? ¿Y cuánta incertidumbre queda después de asignar un punto a un conglomerado?

    No son meras preguntas de programación. Son preguntas sobre probabilidad, inferencia, geometría y toma de decisiones. La estrategia distintiva del artículo es, por tanto, fundacional: en lugar de tratar los modelos de mezclas gaussianas como una caja negra, reconstruye la escalera conceptual que conduce hasta ellos.

    Un conglomerado en la pantalla de una computadora es el resultado visible final de un argumento mucho más largo sobre probabilidad, estructura oculta, estimación y optimización.

    Resumen conceptual del marco de Gómez Julián de 2020

    Hay otra razón por la cual este enfoque es útil fuera de la estadística. Politólogos, economistas, sociólogos e investigadores de políticas públicas trabajan con frecuencia con poblaciones heterogéneas. Países, hogares, empresas, votantes o estudiantes pueden aparecer en un mismo conjunto de datos y, sin embargo, pertenecer en realidad a varias subpoblaciones estadísticamente distintas. Si esas subpoblaciones no vienen etiquetadas directamente, la tarea analítica ya no consiste simplemente en estimar un promedio, sino en inferir la estructura oculta que pudo haber generado las observaciones.

    Es ahí donde finalmente entran el análisis de conglomerados y los modelos de mezclas gaussianas. Pero Gómez Julián comienza una capa más abajo: con Bayes y la lógica de actualizar el conocimiento cuando llega nueva evidencia.

    · · ·

    02 · Fundamentos bayesianos Bayes como regla para aprender de la evidencia

    En su forma más simple, el teorema de Bayes nos dice cómo debe cambiar una probabilidad cuando adquirimos información relevante. Supongamos que tenemos una hipótesis \(H\) y observamos unos datos \(D\). La actualización bayesiana conecta cuatro cantidades:

    \( P(H\mid D)=\dfrac{P(D\mid H)\,P(H)}{P(D)} \) posterior = verosimilitud × previa / probabilidad marginal de los datos

    La previa, \(P(H)\), representa el estado de información antes de incorporar la nueva evidencia. La verosimilitud, \(P(D\mid H)\), nos indica qué tan compatible es la evidencia observada con la hipótesis. El denominador \(P(D)\) normaliza el cálculo. El resultado, \(P(H\mid D)\), es la posterior: la probabilidad condicionada a haber observado la nueva evidencia.

    Para lectores provenientes de la economía hay una analogía útil. Imaginemos que partimos de un conjunto de creencias acerca de la situación probable de una economía y luego recibimos nueva información sobre empleo, inflación o producción. La actualización bayesiana no implica que la información anterior desaparezca. Más bien, la información previa y la nueva evidencia se combinan mediante una regla probabilística precisa. La posterior pasa entonces a ser el punto de partida informativo para la decisión siguiente.

    La intuición clave

    El teorema de Bayes todavía no es un algoritmo de agrupamiento. Su importancia aquí es más fundamental: los modelos de mezclas gaussianas plantean repetidamente preguntas de probabilidad condicional. Dado un punto observado, ¿qué tan probable es que provenga del componente 1, del componente 2, del componente 3, y así sucesivamente? Una vez que la pertenencia a los grupos está oculta en lugar de observarse directamente, las probabilidades posteriores se convierten en un lenguaje natural para razonar sobre esa incertidumbre.

    Este es uno de los puentes conceptuales que da coherencia al artículo. Lo que comienza como una discusión abstracta sobre probabilidad condicional reaparecerá después de forma muy concreta: cada observación puede tener una probabilidad de pertenencia a cada componente gaussiano posible. Esto ya constituye una diferencia importante entre un modelo de mezcla gaussiana y la conocida asignación dura producida por el k-means ordinario.

    03 · Toma de decisiones estadísticas De la probabilidad posterior a un estimador de Bayes

    Actualizar probabilidades es solo una parte de la historia. En algún momento, el analista debe hacer algo con la distribución posterior. Debe estimarse un parámetro, producirse una predicción, seleccionarse un modelo o asignarse una observación —quizá provisionalmente— a un grupo.

    Por eso el estudio de Gómez Julián de 2020 pasa del teorema de Bayes a la teoría de la decisión. Una vez que existen varias estimaciones o acciones posibles, el problema estadístico puede expresarse como una cuestión de consecuencias: si la cantidad desconocida es realmente \(\theta\), ¿cuál es el costo de reportar cierta estimación \(\hat{\theta}\)?

    Ese costo se representa mediante una función de pérdida. La forma exacta de la función depende de qué tipos de errores sean relevantes en el problema estudiado. Un caso particularmente importante, y el que destaca el artículo, es la pérdida por error cuadrático:

    \( L(\theta,\hat{\theta})=(\hat{\theta}-\theta)^2 \) una mayor distancia entre la estimación y el parámetro desconocido produce una pérdida desproporcionadamente mayor

    Elevar el error al cuadrado tiene dos consecuencias inmediatas. Primero, las desviaciones positivas y negativas dejan de cancelarse entre sí. Segundo, los errores grandes reciben una penalización mayor que los pequeños. Por ello, la pérdida esperada asociada está estrechamente conectada con el conocido error cuadrático medio.

    \( \mathrm{MSE}(\hat{\theta}) = E_{\theta}\!\left[(\hat{\theta}-\theta)^2\right] \) error cuadrático medio como medida esperada del error de estimación

    La teoría bayesiana de la decisión añade un ingrediente decisivo: en lugar de evaluar la pérdida tratando al parámetro como un objeto fijo desconocido fuera del cálculo probabilístico, se utiliza la distribución posterior para promediar las posibles consecuencias de una decisión. La cantidad relevante pasa a ser la pérdida posterior esperada.

    \( \rho(a\mid x)=\int_{\Theta} L(\theta,a)\,p(\theta\mid x)\,d\theta \) pérdida posterior esperada: consecuencias promediadas sobre la incertidumbre actual acerca del parámetro

    Una regla de decisión bayesiana selecciona la acción que minimiza esta cantidad. Bajo pérdida por error cuadrático ocurre algo especialmente elegante: la estimación óptima es la media posterior.

    \( \hat{\theta}(x)=E(\theta\mid x)=\int_{\Theta}\theta\,p(\theta\mid x)\,d\theta \) estimador de Bayes bajo pérdida cuadrática

    La intuición es sencilla. La distribución posterior describe qué valores de \(\theta\) siguen siendo plausibles después de observar los datos. Si lo que queremos minimizar es la distancia al cuadrado, entonces la media posterior es el punto que minimiza la distancia cuadrática promedio a todos esos valores posibles.

    Una distinción útil

    La actualización bayesiana nos dice cómo cambia la incertidumbre después de observar evidencia. La teoría bayesiana de la decisión nos dice cómo convertir esa incertidumbre actualizada en una acción. La primera produce una distribución posterior; la segunda combina esa posterior con una función de pérdida.

    Esta distinción será importante más adelante. Un modelo de mezcla gaussiana no se limita a calcular probabilidades. Utiliza probabilidades como parte de un problema iterativo de estimación en el que deben inferirse conjuntamente las pertenencias desconocidas a los componentes y los parámetros desconocidos de esos componentes.

    El estudio también discute la idea estadística más amplia de riesgo de Bayes: la pérdida esperada asociada con una regla de decisión cuando la incertidumbre acerca del parámetro se representa ella misma probabilísticamente. Dentro del marco de teoría de la decisión adoptado en el artículo, un estimador de Bayes es el estimador elegido porque minimiza la pérdida esperada pertinente.

    La probabilidad describe la incertidumbre; una función de pérdida le da consecuencias a esa incertidumbre.

    El puente entre inferencia y teoría de la decisión
    · · ·

    04 · Aprendizaje no supervisado Por qué el agrupamiento es distinto de la clasificación

    El artículo cambia entonces de escala. Pasa de la estimación de un parámetro desconocido a una pregunta más amplia de aprendizaje automático: ¿cómo puede descubrirse estructura en un conjunto de datos cuando las observaciones no vienen acompañadas de etiquetas de clase conocidas?

    Este es el escenario definitorio del aprendizaje no supervisado. En el aprendizaje supervisado, los datos de entrenamiento contienen un resultado o una etiqueta que el algoritmo debe reproducir o predecir. Por ejemplo, un modelo puede aprender si un solicitante de crédito incurrió en impago, por qué partido votó un encuestado o qué valor numérico tomó una variable dependiente.

    En el aprendizaje no supervisado no existe tal clave de respuestas. El algoritmo recibe observaciones y sus características medidas, pero no una declaración previa de que la observación 17 pertenece al tipo A y la observación 18 al tipo B. La propia estructura debe inferirse a partir de patrones presentes en los datos.

    Clasificación frente a agrupamiento

    En la clasificación, las clases se conocen durante el entrenamiento y el modelo aprende a asignarles nuevas observaciones. En el agrupamiento, los grupos no se proporcionan de antemano. El método intenta descubrir una agrupación útil a partir de similitudes, diferencias y estructura distribucional dentro de los datos observados.

    Gómez Julián sitúa el análisis de conglomerados en el centro de este problema de aprendizaje no supervisado. En su forma más general, agrupar significa particionar observaciones según características compartidas, de manera que las observaciones dentro de un conglomerado sean relativamente similares y las pertenecientes a conglomerados distintos sean relativamente disímiles.

    La formulación parece simple, pero oculta una de las dificultades más profundas del agrupamiento: no siempre existe una única manera obvia de dividir un conjunto de datos. La misma nube de puntos puede describirse plausiblemente como dos grupos amplios, varios subgrupos más estrechos o una jerarquía en la que grupos mayores contienen otros menores.

    El estudio utiliza esta ambigüedad para distinguir dos grandes familias. El agrupamiento particional divide las observaciones en grupos no superpuestos a un nivel seleccionado. El agrupamiento jerárquico, en cambio, organiza grupos dentro de grupos y produce una estructura anidada que con frecuencia puede representarse como un árbol.

    Esto es más que una distinción técnica. Nos recuerda que un conglomerado no es simplemente un objeto que espera dentro de los datos a ser fotografiado. Un procedimiento de agrupamiento incorpora una definición de qué significa similitud, cómo se mide la distancia, qué geometría se permite y a qué escala las diferencias se consideran importantes.

    Preguntar cuántos grupos hay en un conjunto de datos ya implica preguntar qué cuenta como grupo.

    Por qué el agrupamiento es fundamentalmente un problema de modelización

    Esto es particularmente importante para economistas y politólogos. Supongamos que representamos países mediante desempleo, alfabetización, pobreza y gasto público en educación. Un algoritmo de agrupamiento puede detectar configuraciones estadísticamente distintas de esas variables. Pero los grupos resultantes no deben tratarse automáticamente como “tipos” políticos o económicos sustantivos. La agrupación estadística es evidencia acerca de una estructura; su interpretación todavía requiere teoría y conocimiento del fenómeno estudiado.

    Antes de agrupar, el artículo también subraya la importancia del preprocesamiento de los datos. Los valores atípicos, las distintas escalas de medición, las variables irrelevantes y los valores faltantes pueden alterar la geometría aparente del conjunto de datos. La normalización puede ser importante cuando la distancia es central para el algoritmo, mientras que la reducción de variables puede resultar útil cuando dimensiones irrelevantes oscurecen, en vez de aclarar, la estructura.

    · · ·

    05 · Un primer modelo de agrupamiento Lo que k-means realmente supone

    Para entender por qué las mezclas gaussianas son útiles, Gómez Julián introduce primero uno de los algoritmos de agrupamiento más conocidos: k-means.

    La idea básica es geométrica. Se elige un número de grupos, \(K\). A cada grupo se le asocia un centro, o centroide. Después se asigna cada observación al grupo cuyo centroide está más cerca. Los centroides se actualizan a partir de las observaciones que les fueron asignadas y el proceso se repite hasta que la configuración se estabiliza.

    \( \displaystyle \min_{C_1,\ldots,C_K}\sum_{k=1}^{K}\sum_{x_i\in C_k}\lVert x_i-\mu_k\rVert^2 \) el objetivo familiar de k-means: minimizar la distancia cuadrática dentro de cada conglomerado entre cada observación y su centroide

    Incluso quienes nunca han implementado el algoritmo pueden visualizar su lógica. Imaginemos colocar \(K\) alfileres sobre un mapa. Cada observación se envía al alfiler más cercano. Después los alfileres se desplazan hacia los centros de las observaciones que les fueron asignadas y la asignación se repite. Finalmente, los alfileres y las pertenencias dejan de cambiar de manera sustancial.

    Este procedimiento es potente y computacionalmente conveniente, pero su simplicidad impone una estructura geométrica. La lógica de distancia al centroide funciona de manera más natural cuando los conglomerados son compactos y aproximadamente esféricos —o circulares cuando se visualizan en dos dimensiones—.

    Los datos reales no tienen por qué cooperar. Un conglomerado puede ser largo y estrecho, inclinarse diagonalmente en el espacio de características, estar muy concentrado en una dirección y ampliamente disperso en otra. Dos grupos también pueden superponerse. Cuando aparecen estas posibilidades, la distancia a un único centro puede dejar de describir adecuadamente la estructura.

    Hay otra limitación que se vuelve central en el artículo. El k-means ordinario realiza lo que se conoce como una asignación dura. Una observación se coloca en el conglomerado 1, 2 o 3. El algoritmo no dice de forma natural: “hay una probabilidad del 72 % de que esta observación pertenezca al conglomerado 1 y del 28 % de que pertenezca al conglomerado 2”.

    Dos limitaciones que conviene recordar

    La transición de k-means a las mezclas gaussianas está motivada por dos ideas especialmente importantes: la geometría de los conglomerados y la incertidumbre de pertenencia. Las mezclas gaussianas pueden modelar conglomerados con estructura de covarianzas y asignar pertenencias probabilísticas, en lugar de puramente deterministas.

    Esto prepara el giro conceptual central del estudio. En vez de pensar un conglomerado únicamente como una colección de puntos alrededor de un centroide, podemos pensarlo como una distribución de probabilidad.

    · · ·

    06 · Estructura latente La idea central: una población puede ser una mezcla

    Supongamos que observamos la distribución de alguna variable en una población completa. A primera vista vemos un único conjunto de datos. Pero ¿qué ocurre si esa población está compuesta en realidad por varias subpoblaciones generadas por procesos estadísticos distintos?

    Esta es la intuición fundamental detrás de un modelo de mezcla. La distribución de probabilidad global se representa como una combinación ponderada de varias distribuciones componentes.

    \( \displaystyle f(x_i;\Psi)=\sum_{k=1}^{G}\pi_k f_k(x_i;\theta_k) \) modelo de mezcla finita · cada componente tiene sus propios parámetros y contribuye de acuerdo con su peso de mezcla

    Aquí \(G\) es el número de componentes. \(f_k(x_i;\theta_k)\) es la densidad del componente \(k\), determinada por sus propios parámetros \(\theta_k\). La cantidad \(\pi_k\) es el peso de mezcla del componente y satisface \(\pi_k>0\) y \(\sum_{k=1}^{G}\pi_k=1\).

    Los pesos son importantes. Si parece que el 70 % de la población fue generado por un componente y el 30 % por otro, ambas densidades componentes no deberían contribuir por igual a la densidad de la población total. Los pesos de mezcla codifican su prevalencia relativa.

    Pero la característica más profunda del modelo es algo que no observamos directamente: la identidad del componente de cada observación. El conjunto de datos contiene \(x_i\), pero normalmente no contiene una columna adicional proporcionada por la naturaleza que diga: “este punto fue generado por el componente gaussiano 3”.

    La pertenencia al componente es, por tanto, una variable latente. Es una estructura oculta que se infiere a partir de los datos observados.

    Cantidades observadas y latentes

    Las observaciones \(x_1,\ldots,x_n\) son visibles. Las etiquetas de los componentes que las generaron no lo son. Por ello, un modelo de mezcla finita conecta datos observables con pertenencia no observable a grupos, al tiempo que estima los parámetros y el peso relativo de cada componente.

    Por eso el artículo considera los modelos de mezcla como naturalmente conectados con la modelización jerárquica y de variables latentes. Existe un nivel en el que una observación pertenece a algún componente no observado y otro nivel en el que el valor observado se genera según la distribución de probabilidad asociada a ese componente.

    Si las distribuciones componentes son gaussianas, el modelo se convierte en un modelo de mezcla gaussiana, o GMM:

    \( \displaystyle f(x)=\sum_{k=1}^{G}\pi_k\,\mathcal{N}(x\mid\mu_k,\Sigma_k) \) modelo de mezcla gaussiana · cada grupo latente se representa mediante una densidad normal con su propia media y estructura de covarianzas

    En una dimensión, cada componente tiene una media y una varianza. En varias dimensiones, la media se convierte en un vector \(\mu_k\), mientras que la dispersión y la dependencia entre variables se representan mediante la matriz de covarianzas \(\Sigma_k\).

    La matriz de covarianzas es precisamente lo que da a los modelos de mezclas gaussianas su flexibilidad geométrica. Permite que un conglomerado sea estrecho, otro amplio, otro alargado y otro orientado en una dirección diagonal dentro del espacio multivariado.

    El artículo presenta así las mezclas gaussianas como una generalización probabilística de la intuición más rígida, basada en centroides, asociada con k-means. En lugar de preguntar únicamente qué centro está más cerca, el modelo plantea una pregunta más rica: dadas las distribuciones estimadas, ¿qué tan probable es que esta observación provenga de cada componente?

    \( \displaystyle P(Z_i=k\mid x_i)=\frac{\pi_k\,\mathcal{N}(x_i\mid\mu_k,\Sigma_k)}{\sum_{j=1}^{G}\pi_j\,\mathcal{N}(x_i\mid\mu_j,\Sigma_j)} \) probabilidad posterior de que la observación i pertenezca al componente k

    Ahora la discusión anterior sobre Bayes se vuelve visiblemente relevante. El modelo parte de pesos y densidades de los componentes y, condicionado a un punto observado, calcula probabilidades actualizadas de pertenencia a cada componente.

    Una observación cercana al centro de un componente y lejos de todos los demás puede recibir una probabilidad de asignación próxima a uno. Una observación situada en una región de superposición puede recibir una probabilidad sustancial bajo dos o más componentes. Esto es clasificación blanda: la incertidumbre sobre la pertenencia se conserva en lugar de descartarse de inmediato.

    Una mezcla gaussiana no se limita a dividir los datos. Propone una explicación probabilística de cómo varias subpoblaciones ocultas pudieron haber generado la población observada.

    La idea central de modelización del estudio de 2020

    Pero ahora hemos llegado a una aparente circularidad. Para estimar la media, la covarianza y el peso de cada componente, querríamos saber qué observaciones pertenecen a cada componente. Sin embargo, determinar qué observaciones pertenecen a cada componente es precisamente lo que exige conocer esas medias, covarianzas y pesos.

    Resolver ese problema circular es la tarea de uno de los algoritmos más importantes de la estadística con variables latentes: esperanza-maximización.

    07 · Información oculta EM: aprender cuando se desconoce la pertenencia a los grupos

    La dificultad a la que se enfrenta un modelo de mezcla gaussiana puede expresarse ahora con precisión. Observamos los puntos de datos, pero no observamos el componente del que fue generado cada punto. Si esas pertenencias fueran conocidas, estimar los parámetros de cada componente gaussiano sería relativamente sencillo. Pero las propias pertenencias dependen de parámetros que todavía son desconocidos.

    El estudio de Gómez Julián de 2020 aborda este problema mediante el clásico algoritmo de esperanza-maximización, o EM, desarrollado por Dempster, Laird y Rubin. El contexto más amplio es la estimación a partir de datos incompletos: existe información que haría más sencillo el problema de estimación, pero dicha información no se observa directamente.

    En la modelización de mezclas, la pieza faltante es especialmente intuitiva. Imaginemos que cada fila del conjunto de datos lleva secretamente una variable adicional que indica qué componente gaussiano la generó. Si esa variable oculta fuera visible, tendríamos lo que puede concebirse como los datos completos. En realidad, solo se observan las variables medidas.

    La interpretación en términos de datos faltantes

    En un modelo de mezcla gaussiana, el punto de datos se observa, pero su componente generador es latente. EM trata esta información oculta como la parte faltante de un problema estadístico que, de otro modo, sería más conveniente.

    La característica ingeniosa de EM es que no exige que esta información faltante se vuelva de algún modo observable. En su lugar, alterna entre dos cálculos. Cada uno hace posible el otro.

    Paso E: estimar las pertenencias ocultas

    Se comienza con unos valores actuales para los parámetros de los componentes: las medias, las matrices de covarianzas y los pesos de mezcla. Dados esos valores, se calcula qué tan probable es que cada observación pertenezca a cada componente.

    Estas probabilidades suelen denominarse responsabilidades. El componente \(k\) asume responsabilidad por la observación \(i\) en proporción a cuán plausible es esa observación bajo la densidad gaussiana del componente y a cuán prevalente es dicho componente en la mezcla.

    \( \displaystyle \gamma_{ik}=P(Z_i=k\mid x_i,\Psi)=\frac{\pi_k\,\mathcal{N}(x_i\mid\mu_k,\Sigma_k)}{\sum_{j=1}^{G}\pi_j\,\mathcal{N}(x_i\mid\mu_j,\Sigma_j)} \) intuición del paso E · estimar la probabilidad de que cada observación pertenezca a cada componente gaussiano

    Obsérvese lo que ha ocurrido. La afirmación dura y desconocida “la observación \(i\) pertenece al conglomerado \(k\)” ha sido sustituida por un conjunto de probabilidades. Una observación puede estar asociada abrumadoramente con un componente o puede situarse en una región de superposición y repartir su probabilidad entre varios componentes.

    Paso M: actualizar el modelo

    Una vez calculadas esas pertenencias esperadas, el algoritmo da la vuelta al problema. Ahora trata las pertenencias probabilísticas producidas por el paso E como información para reestimar los parámetros.

    Las medias, las matrices de covarianzas y los pesos de mezcla se actualizan de modo que aumente la verosimilitud de los datos observados bajo la mezcla recién estimada.

    Un ciclo de EM

    Paso E: utilizando los parámetros actuales del modelo, estimar las pertenencias ocultas a los componentes.

    Paso M: utilizando esas pertenencias estimadas, reestimar los parámetros del modelo maximizando el criterio de verosimilitud pertinente.

    Después el algoritmo vuelve al paso E. Los nuevos parámetros implican nuevas probabilidades de pertenencia; esas nuevas probabilidades implican nuevas estimaciones de los parámetros; y el proceso continúa iterativamente.

    \( \Psi^{(0)}\rightarrow\text{paso E}\rightarrow\text{paso M}\rightarrow\Psi^{(1)}\rightarrow\text{paso E}\rightarrow\text{paso M}\rightarrow\cdots \) esperanza y maximización se alternan hasta que la solución ajustada se estabiliza

    El proceso se detiene cuando las estimaciones de los parámetros —o, equivalentemente, las mejoras en la verosimilitud— cambian tan poco que se considera que el algoritmo ha alcanzado la convergencia.

    Esto convierte a EM en una respuesta particularmente elegante a la aparente circularidad encontrada al final de la sección anterior. Necesitábamos la pertenencia a los conglomerados para estimar las distribuciones, pero necesitábamos las distribuciones para estimar la pertenencia a los conglomerados. EM resuelve el problema alternando entre ambas tareas condicionales.

    Estime lo que está oculto utilizando el modelo actual; después mejore el modelo utilizando lo que acaba de estimar.

    La lógica iterativa de esperanza-maximización

    Hay una salvedad importante. EM es un algoritmo de optimización, no una garantía mágica de que cualquier punto de partida conduzca a la mejor solución global. Las verosimilitudes de los modelos de mezcla pueden contener múltiples óptimos locales. Por ello, la inicialización y la especificación del modelo pueden importar. Lo que EM garantiza a nivel operativo es un procedimiento iterativo para mejorar la verosimilitud hasta alcanzar una solución estacionaria.

    · · ·

    08 · Geometría estadística Por qué las mezclas gaussianas pueden ver elipses

    El siguiente paso del argumento de Gómez Julián es geométrico. En una dimensión, una distribución gaussiana se describe mediante una media y una varianza. Sin embargo, al pasar a dos o más dimensiones, la varianza ya no es suficiente. También deben representarse las relaciones entre las variables.

    Este es el papel de la matriz de covarianzas, \(\Sigma_k\). Para el componente \(k\), el vector de medias \(\mu_k\) determina su centro, mientras que \(\Sigma_k\) determina cómo se dispersa la masa de probabilidad por el espacio multivariado.

    \( X\mid Z=k\sim\mathcal{N}(\mu_k,\Sigma_k) \) cada componente gaussiano posee su propio centro y su propia geometría de covarianzas

    En dos dimensiones, los contornos de igual densidad gaussiana forman elipses. Esto ofrece una forma intuitiva de leer la covarianza. Una elipse casi circular indica una dispersión similar en distintas direcciones. Una elipse alargada indica una variación mucho mayor en una dirección que en otra. Una elipse inclinada señala covarianza entre las variables.

    Es precisamente aquí donde el agrupamiento mediante mezclas gaussianas se vuelve más flexible que la imagen geométrica elemental proporcionada por k-means. Un centroide solo nos dice dónde está centrado un conglomerado. Una matriz de covarianzas también nos informa de su volumen, forma y orientación.

    Piense geométricamente

    Dos conglomerados pueden tener centros igualmente separados y aun así ser estadísticamente muy distintos. Uno puede ser compacto y casi circular; otro, amplio y fuertemente alargado. Los modelos de mezclas gaussianas pueden representar esta diferencia porque la matriz de covarianzas forma parte del modelo.

    El marco de mclust estudiado en el artículo explota este hecho de forma sistemática. En lugar de ajustar una sola estructura de covarianzas posible, considera una familia de modelos gaussianos obtenidos imponiendo distintas restricciones sobre el volumen, la forma y la orientación de los elipsoides componentes.

    Gómez Julián discute los 14 modelos gaussianos multivariados disponibles en la versión de mclust estudiada en la investigación de 2020. Sus nombres compactos —como EEE, VEV, VVI o EEV— codifican restricciones sobre esas propiedades geométricas.

    Ejemplo Idea geométrica
    EEEVolumen igual, forma igual y orientación igual entre componentes
    VEVVolumen variable, forma igual y orientación variable
    VVIEstructura diagonal de covarianzas con volumen y forma variables
    EEVVolumen y forma iguales, con orientación que puede variar

    Estos códigos no son jerga decorativa de software. Describen hipótesis estadísticas rivales sobre la geometría de los grupos ocultos. ¿Deben todos los conglomerados tener la misma dispersión? ¿Puede uno ser mayor que otro? ¿Deben sus elipses apuntar en la misma dirección? ¿Es suficiente una matriz diagonal de covarianzas o los datos requieren elipsoides rotados?

    Visto así, el agrupamiento basado en modelos hace más que decidir dónde dibujar fronteras. Está comparando descripciones generativas alternativas de los datos.

    En el agrupamiento basado en modelos, la forma de un conglomerado no es un detalle secundario. Forma parte de la hipótesis que se está estimando.

    La covarianza como geometría estadística
    · · ·

    09 · Selección de modelos BIC y el problema de elegir un modelo

    Las mezclas gaussianas crean un nuevo problema precisamente porque son flexibles. Podemos ajustar distintos números de componentes y, para cada número, considerar diferentes estructuras de covarianzas. ¿Qué modelo debe preferirse?

    La verosimilitud maximizada por sí sola no basta. Añadir parámetros suele dar al modelo más libertad para acomodar los datos observados, de modo que el ajuste bruto puede mejorar simplemente porque el modelo se ha vuelto más complicado. Si la complejidad nunca se penaliza, el procedimiento empuja hacia especificaciones cada vez más elaboradas.

    Esto motiva el Criterio de Información Bayesiano (BIC), introducido por Gideon Schwarz y discutido ampliamente en el estudio de 2020. En una notación habitual,

    \( \mathrm{BIC}=-2\log \hat{L}+k\log n \) forma convencional de minimización · el ajuste se equilibra con una penalización que aumenta con la complejidad del modelo

    Aquí \(\hat{L}\) es la verosimilitud maximizada, \(k\) es el número de parámetros estimados y \(n\) es el tamaño de la muestra. El primer término recompensa el ajuste; el segundo penaliza los parámetros adicionales.

    Una convención de signo equivalente suele escribirse de modo que se prefieran valores mayores:

    \( \displaystyle \log \hat{L}-\frac{k}{2}\log n \) forma de maximización de Schwarz · la misma lógica entre ajuste y complejidad, expresada con la orientación opuesta
    Una advertencia práctica sobre los signos

    A veces los lectores encuentran en los manuales “elija el BIC más pequeño” y después ven una salida de mclust donde el modelo preferido tiene el valor BIC más grande. Es una cuestión de convención. El criterio puede escribirse con signos opuestos. Lo importante es usar de manera coherente la convención adoptada por el software o la fuente.

    En mclust, BIC se convierte así en el mecanismo para comparar combinaciones de número de componentes y parametrización de la covarianza. El software puede ajustar un conjunto de modelos candidatos de mezclas gaussianas y compararlos, en vez de obligar al investigador a estipular de antemano una única geometría.

    Conceptualmente, se trata de una competencia entre explicaciones. Un modelo de un componente afirma que una sola población gaussiana es suficiente. Un modelo de dos componentes sostiene que dos subpoblaciones latentes ofrecen una mejor explicación después de tomar en cuenta los parámetros adicionales. Un modelo de cinco componentes formula una afirmación aún más elaborada. BIC pregunta si la ganancia en verosimilitud es suficientemente grande para justificar esa complejidad adicional.

    Qué hace BIC en este artículo

    BIC actúa como puente entre la estimación y la selección de modelos. EM estima los parámetros de una mezcla gaussiana candidata. BIC ayuda a decidir qué estructura candidata —entre distintos números y geometrías de componentes— es comparativamente preferible.

    Esta distinción es esencial. EM no responde por sí solo todas las preguntas de modelización. Dada una estructura de mezcla especificada, proporciona una forma de estimar sus parámetros. La selección de modelos opera en otro nivel: compara estructuras alternativas.

    El resultado es un procedimiento por capas. Primero se definen modelos de probabilidad candidatos. Después se estiman. Luego se comparan. Finalmente, se inspecciona la clasificación resultante y se pregunta si la estructura estadística tiene sentido sustantivo.

    \( \text{modelos candidatos}\rightarrow\text{estimación EM}\rightarrow\text{comparación BIC}\rightarrow\text{estructura de agrupamiento seleccionada} \) flujo de trabajo del agrupamiento basado en modelos desarrollado hacia la sección aplicada del estudio

    Ya estamos listos para el último paso de la investigación de 2020: ver qué produce realmente esta maquinaria en R. Gómez Julián cierra el análisis sustantivo con dos tipos de aplicación. La primera utiliza el conjunto de datos canónico Iris; la segunda pasa a datos sociales y económicos del Banco Mundial, combinando indicadores de gasto en educación, alfabetización, desempleo y pobreza.

    10 · Ejemplos aplicados en R De las flores Iris a los indicadores del Banco Mundial

    Después de más de cien páginas de preparación teórica, el estudio de Gómez Julián de 2020 finalmente pone en marcha la maquinaria estadística. Esta última sección sustantiva es útil precisamente porque la discusión precedente cambia el significado de lo que, de otro modo, parecerían unas pocas líneas de código en R. Llegados a este punto, una llamada a Mclust() ya no es simplemente un comando de software. Invoca mezclas gaussianas finitas, pertenencia latente, estimación por máxima verosimilitud mediante EM, geometrías alternativas de covarianza y comparación de modelos basada en BIC.

    El artículo ofrece dos tipos de ilustración. Primero aparece el conjunto de datos canónico Iris distribuido con R. Después, el análisis pasa a un conjunto de datos construido a partir de indicadores del Banco Mundial, acercando el método a un contexto mucho más próximo a la economía, la ciencia política y la investigación de políticas públicas.

    Cómo leer la salida

    Cuando Mclust() reporta un modelo como VEV, EEE o VVI, está describiendo la estructura de covarianzas seleccionada para los componentes gaussianos. Cuando reporta un número de componentes, está describiendo el número de componentes de mezcla preferido por el procedimiento de selección de modelos entre los candidatos ajustados.

    El ejemplo Iris

    La primera aplicación utiliza las cuatro variables cuantitativas conocidas del conjunto de datos Iris. Gómez Julián ejecuta:

    mod1 <- Mclust(iris[,1:4])
    summary(mod1)
    agrupamiento basado en modelos gaussianos de las cuatro variables medidas de Iris

    La solución reportada es una mezcla gaussiana finita VEV con dos componentes. Las 150 observaciones se dividen en conglomerados de 50 y 100 observaciones, respectivamente. La log-verosimilitud reportada es \(-215.726\), mientras que la salida da un BIC de \(-561.7285\) y un ICL de \(-561.7289\).

    Conjunto de datos Estructura seleccionada Agrupamiento
    IrisVEV · 2 componentes gaussianos50 / 100 observaciones

    Los gráficos que acompañan el ejemplo hacen visibles las dos capas del procedimiento. Un panel compara valores BIC entre modelos candidatos de covarianza y distintos números de componentes. Otro muestra la clasificación resultante a través de pares de variables medidas. Por tanto, el gráfico no se limita a mostrar los conglomerados después del hecho: también ofrece al lector una vista del problema de selección de modelos que los produjo.

    Este ejemplo es deliberadamente sencillo. Su función es mostrar que la discusión teórica sobre densidades de mezcla, EM, estructura de covarianzas y BIC puede condensarse operativamente en un fragmento sorprendentemente corto de código en R.

    · · ·

    Un ejemplo de ciencias sociales con datos del Banco Mundial

    La segunda aplicación está más directamente conectada con las preocupaciones de economistas e investigadores de políticas públicas. Gómez Julián construye un ejemplo con datos del Banco Mundial y cuatro variables correspondientes a 2018:

    Variables utilizadas en la aplicación de 2020

    Gasto público en educación como porcentaje del PIB; desempleo como porcentaje de la fuerza laboral total; incidencia de la pobreza según la línea nacional de pobreza; y la tasa de alfabetización de adultos para personas de 15 años o más.

    El flujo de trabajo en R importa los conjuntos de datos por separado, selecciona las observaciones de 2018, los une por país, elimina las filas en las que la combinación requerida contiene valores faltantes y, finalmente, aplica Mclust() a las variables numéricas resultantes.

    Cuando se consideran conjuntamente los cuatro indicadores, solo quedan 13 observaciones completas en el conjunto de datos utilizado por el código. El modelo reportado es EEE con nueve componentes: conglomerados gaussianos elipsoidales con igual volumen, igual forma e igual orientación.

    \( n=13,\qquad G=9,\qquad \text{modelo}=\mathrm{EEE} \) ejemplo de cuatro variables del Banco Mundial reportado en el estudio

    La salida reporta una log-verosimilitud de \(-77.62892\), 54 grados de libertad, BIC \(-293.7651\) e ICL \(-293.7727\). Los tamaños de los componentes son extremadamente pequeños: los nueve conglomerados contienen, respectivamente, 1, 2, 2, 1, 1, 1, 2, 2 y 1 observaciones.

    Gómez Julián repite después el ejercicio de agrupamiento basado en modelos utilizando combinaciones más pequeñas de variables. Esto resulta particularmente revelador porque el tamaño de muestra disponible cambia de forma marcada según qué indicadores del Banco Mundial deban observarse simultáneamente.

    Variables n Modelo Componentes BIC
    Gasto en educación + alfabetización39XXI1−475.3468
    Gasto en educación + desempleo71VVI2−679.1997
    Gasto en educación + pobreza17EEV5−193.6785

    El contraste es llamativo. Para gasto público en educación y alfabetización adulta, la solución ajustada contiene solo un componente entre 39 observaciones completas. Para gasto en educación y desempleo, el modelo seleccionado es VVI con dos componentes, que contienen 49 y 22 observaciones. Para gasto en educación y pobreza, el resultado es una especificación EEV con cinco componentes, cuyos tamaños son 3, 3, 4, 4 y 3.

    Estos ejemplos muestran algo que puede perderse fácilmente cuando se habla de forma abstracta del “número de conglomerados”. El número de componentes no es una cifra intrínseca unida para siempre a un conjunto de países. Depende de las variables que se modelizan, de las observaciones disponibles, de las estructuras de covarianzas candidatas y del criterio estadístico utilizado para comparar esos modelos.

    Un límite inferencial importante

    La salida reportada en esta sección es análisis de conglomerados. Describe estructura estadística encontrada por los modelos ajustados de mezclas gaussianas. Por sí solo, un ejercicio de este tipo no establece que el gasto en educación cause desempleo, alfabetización o pobreza, ni estima la magnitud de un efecto causal. Esas serían preguntas inferenciales distintas que requerirían otro diseño de investigación.

    Esta distinción es especialmente valiosa para el análisis de políticas públicas. Un conglomerado puede revelar que algunos países ocupan regiones similares de un espacio estadístico multivariado. Eso puede motivar una investigación sustantiva. Pero no explica, por sí mismo, histórica o causalmente por qué esos países ocupan esa región.

    El resultado de cuatro variables merece el mismo cuidado. Nueve componentes a partir de solo trece observaciones completas es exactamente el tipo de salida que debe leerse conjuntamente con el tamaño muestral y la complejidad del modelo, en lugar de reducirse a la frase “nueve tipos de países”. El estudio reporta el ajuste estadístico; la interpretación sustantiva exige regresar del modelo al objeto empírico que se estudia.

    · · ·

    11 · La lección más amplia Lo que realmente enseña el estudio de 2020

    Quizá la característica más importante de la investigación de Gómez Julián sea su negativa a comenzar por el software. El artículo podría haber sido un breve tutorial sobre cómo llamar a Mclust(), inspeccionar BIC y graficar una clasificación. En cambio, construye un largo recorrido conceptual desde la probabilidad y la estimación hasta la salida final del agrupamiento.

    Ese recorrido importa porque sus elementos están genuinamente conectados. El razonamiento bayesiano introduce la probabilidad condicional y la actualización. La teoría de la decisión explica cómo las distribuciones de probabilidad pueden conectarse con estimadores y pérdidas. El aprendizaje no supervisado introduce el problema de descubrir estructura sin etiquetas conocidas. El análisis de conglomerados da a ese problema una forma estadística. Los modelos de mezcla reinterpretan una población aparentemente homogénea como la superposición de subpoblaciones latentes. Las mezclas gaussianas proporcionan a esas subpoblaciones una geometría probabilística flexible. EM estima modelos cuya información de pertenencia está oculta. Y BIC proporciona una forma de comparar especificaciones rivales.

    \( \text{Bayes}\rightarrow\text{estimación}\rightarrow\text{variables latentes}\rightarrow\text{mezclas}\rightarrow\text{EM}\rightarrow\text{BIC}\rightarrow\text{agrupamiento} \) un mapa comprimido del recorrido conceptual reconstruido en el estudio de 2020

    También puede leerse el artículo como un argumento a favor de comprender los métodos estadísticos de manera estructural. Un modelo no es simplemente una ecuación. Incluye supuestos sobre qué es observable, qué es latente, qué familia de probabilidad describe los datos, cómo se estiman los parámetros, qué geometrías se permiten y cómo se comparan especificaciones rivales.

    Los modelos de mezclas gaussianas hacen este punto especialmente visible. La nube observable de datos es solo la superficie. Debajo de ella hay una estructura generativa propuesta: distribuciones componentes, pertenencias latentes, pesos de mezcla, medias y matrices de covarianzas. El analista no observa directamente esta maquinaria. La infiere.

    El conjunto de datos visible es el punto de partida. El modelo estadístico es una hipótesis sobre la estructura oculta capaz de producirlo.

    Una intuición central que recorre el estudio

    Por eso también es tan significativa la diferencia entre clasificación dura y blanda. Decir que un país, una persona o una flor pertenece al “conglomerado 2” suprime información. Una mezcla gaussiana puede, en cambio, conservar el hecho de que una observación se encuentre cerca de la frontera entre varios componentes plausibles. La probabilidad vuelve medible la ambigüedad.

    Del mismo modo, la covarianza transforma el agrupamiento desde la simple idea de distancia a un centro hacia una descripción más rica de la geometría estadística. Los grupos pueden diferir no solo en ubicación, sino también en dispersión, forma y orientación. Y BIC nos recuerda que una mayor flexibilidad tiene un costo: un modelo debe ganarse su complejidad adicional mediante una mejora del ajuste.

    Para economistas, econometristas y politólogos, quizá la lección más transferible sea, por tanto, metodológica. Si una población puede contener regímenes estadísticos cualitativamente distintos, forzar todas las observaciones dentro de una única distribución homogénea puede ocultar estructura. Los modelos de mezcla ofrecen una forma formal de preguntar si el patrón agregado puede ser generado, en cambio, por varios componentes latentes.

    Pero la advertencia inversa es igualmente importante. Descubrir una partición preferida estadísticamente no libera al investigador de la obligación de comprender el fenómeno real. Un componente es un componente de un modelo estadístico. Que corresponda a una clase social significativa, un régimen institucional, una configuración de desarrollo, una población biológica o simplemente a una característica de la muestra disponible debe establecerse mediante conocimiento sustantivo y evidencia adicional.

    En una sola frase

    La investigación de Gómez Julián de 2020 es un recorrido teórico guiado por las ideas necesarias para comprender cómo los modelos gaussianos de mezclas finitas pueden descubrir estructura latente en datos sin etiquetar, cómo EM estima esa estructura y cómo criterios de selección de modelos como BIC ayudan a decidir qué representación probabilística conservar.

    · · ·

    12 · Perspectiva final Estadística antes que software

    Hay una inversión útil en el corazón de este estudio. La computación estadística moderna nos anima a comenzar con una función y descubrir después qué hace. El texto de Gómez Julián de 2020 avanza en la dirección opuesta: primero reconstruye los conceptos matemáticos y estadísticos y después se aproxima a la función.

    Esa elección hace que el artículo sea inusualmente amplio. Probabilidad posterior, estimadores de Bayes, funciones de pérdida, BIC, minería de datos, aprendizaje automático, agrupamiento, estimación de densidades, cuantización vectorial, k-means, EM, distribuciones categórica y de Dirichlet, optimización, parámetros, hiperparámetros y mezclas gaussianas finitas aparecen porque el procedimiento final se encuentra en la intersección de todas esas ideas.

    Para un lector con formación técnica, el valor de este recorrido es que expone la arquitectura oculta bajo un comando familiar de R. Para un lector proveniente de la ciencia política, la economía u otro campo aplicado, ofrece algo igualmente útil: un camino intuitivo hacia un método que, de otro modo, llega envuelto en álgebra matricial y notación probabilística.

    Y la lección práctica es sencilla. Cuando un algoritmo informa que los datos contienen uno, dos o cinco grupos, la pregunta interesante no es simplemente ¿qué devolvió el software? Es: ¿qué modelo estadístico hizo posible esa respuesta, qué supuestos dieron forma a los grupos y qué tipo de afirmación sobre la realidad es realmente capaz de sostener el resultado?

    La buena práctica estadística comienza donde termina la salida automática: en el intento de comprender qué ha medido realmente el modelo.

    Reflexión final sobre el estudio de Gómez Julián de 2020
    José Mauricio Gómez Julián · 2020
    Sobre los estimadores de Bayes, el análisis de conglomerados y las mezclas gaussianas: un análisis teórico general de densityMclust en R y de teoría estadística