
Marxist Philosophy of Science · Estadística matemática
Medidas de Disimilaridad y Estructuras Métricas en el Análisis de Conglomerados
Distancias, correlaciones, pseudométricas y cuasimétricas: fundamentos, ejemplos y criterios de aplicación.
Elegir una medida de disimilaridad determina qué diferencias se consideran relevantes y qué geometría se atribuye a los datos. Esta revisión convierte el cuadro original en una exposición que conecta axiomas, cálculos y decisiones de agrupamiento: desde una distancia euclidiana hasta una comparación direccional, y desde observaciones individuales hasta conjuntos completos.
01 · Qué se compara y qué significa «cerca»
Una clasificación de medidas de disimilaridad comienza por fijar los objetos comparados. Una observación puede representarse por un vector x de características; un conglomerado, por un conjunto de observaciones; una distribución, por una medida de probabilidad; una función, por una trayectoria o perfil. Estos objetos requieren construcciones diferentes. El hecho de que una expresión produzca un número no garantiza que constituya una distancia métrica.
Aquí se escribe 𝒳 para el dominio de objetos, N para el número de observaciones y p para el número de variables. El exponente de Minkowski se denota por q, evitando confundirlo con la dimensión. Se reserva d para distancias cuya estructura se declara; δ, para una disimilaridad más general; y s, para una similitud. En una disimilaridad, un valor menor expresa mayor proximidad; en una similitud suele ocurrir lo contrario.
El espacio muestral Ω es, propiamente, el conjunto de resultados posibles de un experimento aleatorio. El espacio de características 𝒳 contiene las representaciones utilizadas en el análisis. La muestra observada es un subconjunto finito, o una colección indexada, de esas representaciones. Una matriz de datos no identifica automáticamente estas tres nociones.
02 · Métrica, completitud y topología
Una métrica es una función no negativa, finita, que separa puntos, es simétrica y cumple la desigualdad triangular:
La identidad exige las dos implicaciones: un punto tiene distancia cero a sí mismo, y dos puntos con distancia cero son el mismo punto. La desigualdad triangular vale para todos los triples, sin excluir puntos repetidos. No es una generalización del teorema de Pitágoras: este último expresa una igualdad particular de la geometría euclidiana.
La completitud es una propiedad adicional de la pareja (𝒳,d). Una sucesión es de Cauchy cuando sus términos terminan siendo arbitrariamente próximos entre sí:
El espacio es completo si toda sucesión de Cauchy converge a un elemento de 𝒳. Por ejemplo, ℝ con la distancia usual es completo; ℚ con la distancia heredada no lo es, pues sucesiones racionales pueden aproximarse a √2. Un conjunto finito de puntos distintos con una métrica es completo: la menor distancia positiva impide que una sucesión de Cauchy siga saltando entre puntos diferentes. Por eso la completitud no es la principal dificultad al agrupar una muestra finita.
Una métrica genera abiertos mediante bolas. Sin embargo, la topología no determina sus valores: d y 2d generan los mismos abiertos. Tampoco la completitud de una métrica concreta es un invariante topológico: ℝ y (0,1) son homeomorfos, aunque sus métricas euclidianas usuales tienen distinta completitud. Un homeomorfismo conserva estructura topológica; una isometría conserva distancias. Estas son comprobaciones elementales, no supuestos sobre un algoritmo.
03 · Una clasificación por axiomas
| Clase | Simetría | Separación | Triángulo | Ejemplo |
|---|---|---|---|---|
| Métrica | Sí | d(x,y)=0 ⇔ x=y | Sí | Euclidiana; Manhattan |
| Pseudométrica | Sí | Puede fallar | Sí | |x₁−y₁| en ℝ² |
| Cuasimétrica¹ | No exigida | d(x,y)=d(y,x)=0 ⇒ x=y | Sí | max{y−x,0} |
| Semimétrica² | Sí | δ(x,y)=0 ⇔ x=y | No exigido | ‖x−y‖₂² |
| Disimilaridad³ | Según definición | No garantizada | No garantizado | 1−r |
¹ Se adopta la convención de Stojmirović (2005): la separación se exige conjuntamente en las dos direcciones. Otras fuentes reservan «cuasimétrica» para una condición de separación más fuerte. Una métrica es también una cuasimétrica bajo la convención inclusiva: no exigir simetría no significa prohibirla.
² Aquí «semimétrica» designa una función simétrica y no negativa que separa puntos, sin exigir desigualdad triangular. El término tiene usos diferentes. McAuley (1956, p. 315, nota 1) exige simetría y compatibilidad con una topología mediante puntos límite; su definición no debe sustituirse por «distancia asimétrica». Una función que no cumple el triángulo no determina sin más la misma teoría de bolas abiertas que una métrica.
³ Para los ejemplos de agrupamiento se consideran disimilaridades finitas, no negativas y nulas en la diagonal; si además son simétricas, pueden almacenarse como una matriz simétrica. Este conjunto de condiciones no impone por sí solo separación ni triángulo. La tabla describe requisitos, no clases mutuamente excluyentes.
04 · Minkowski, escalas y distancia cuadrática
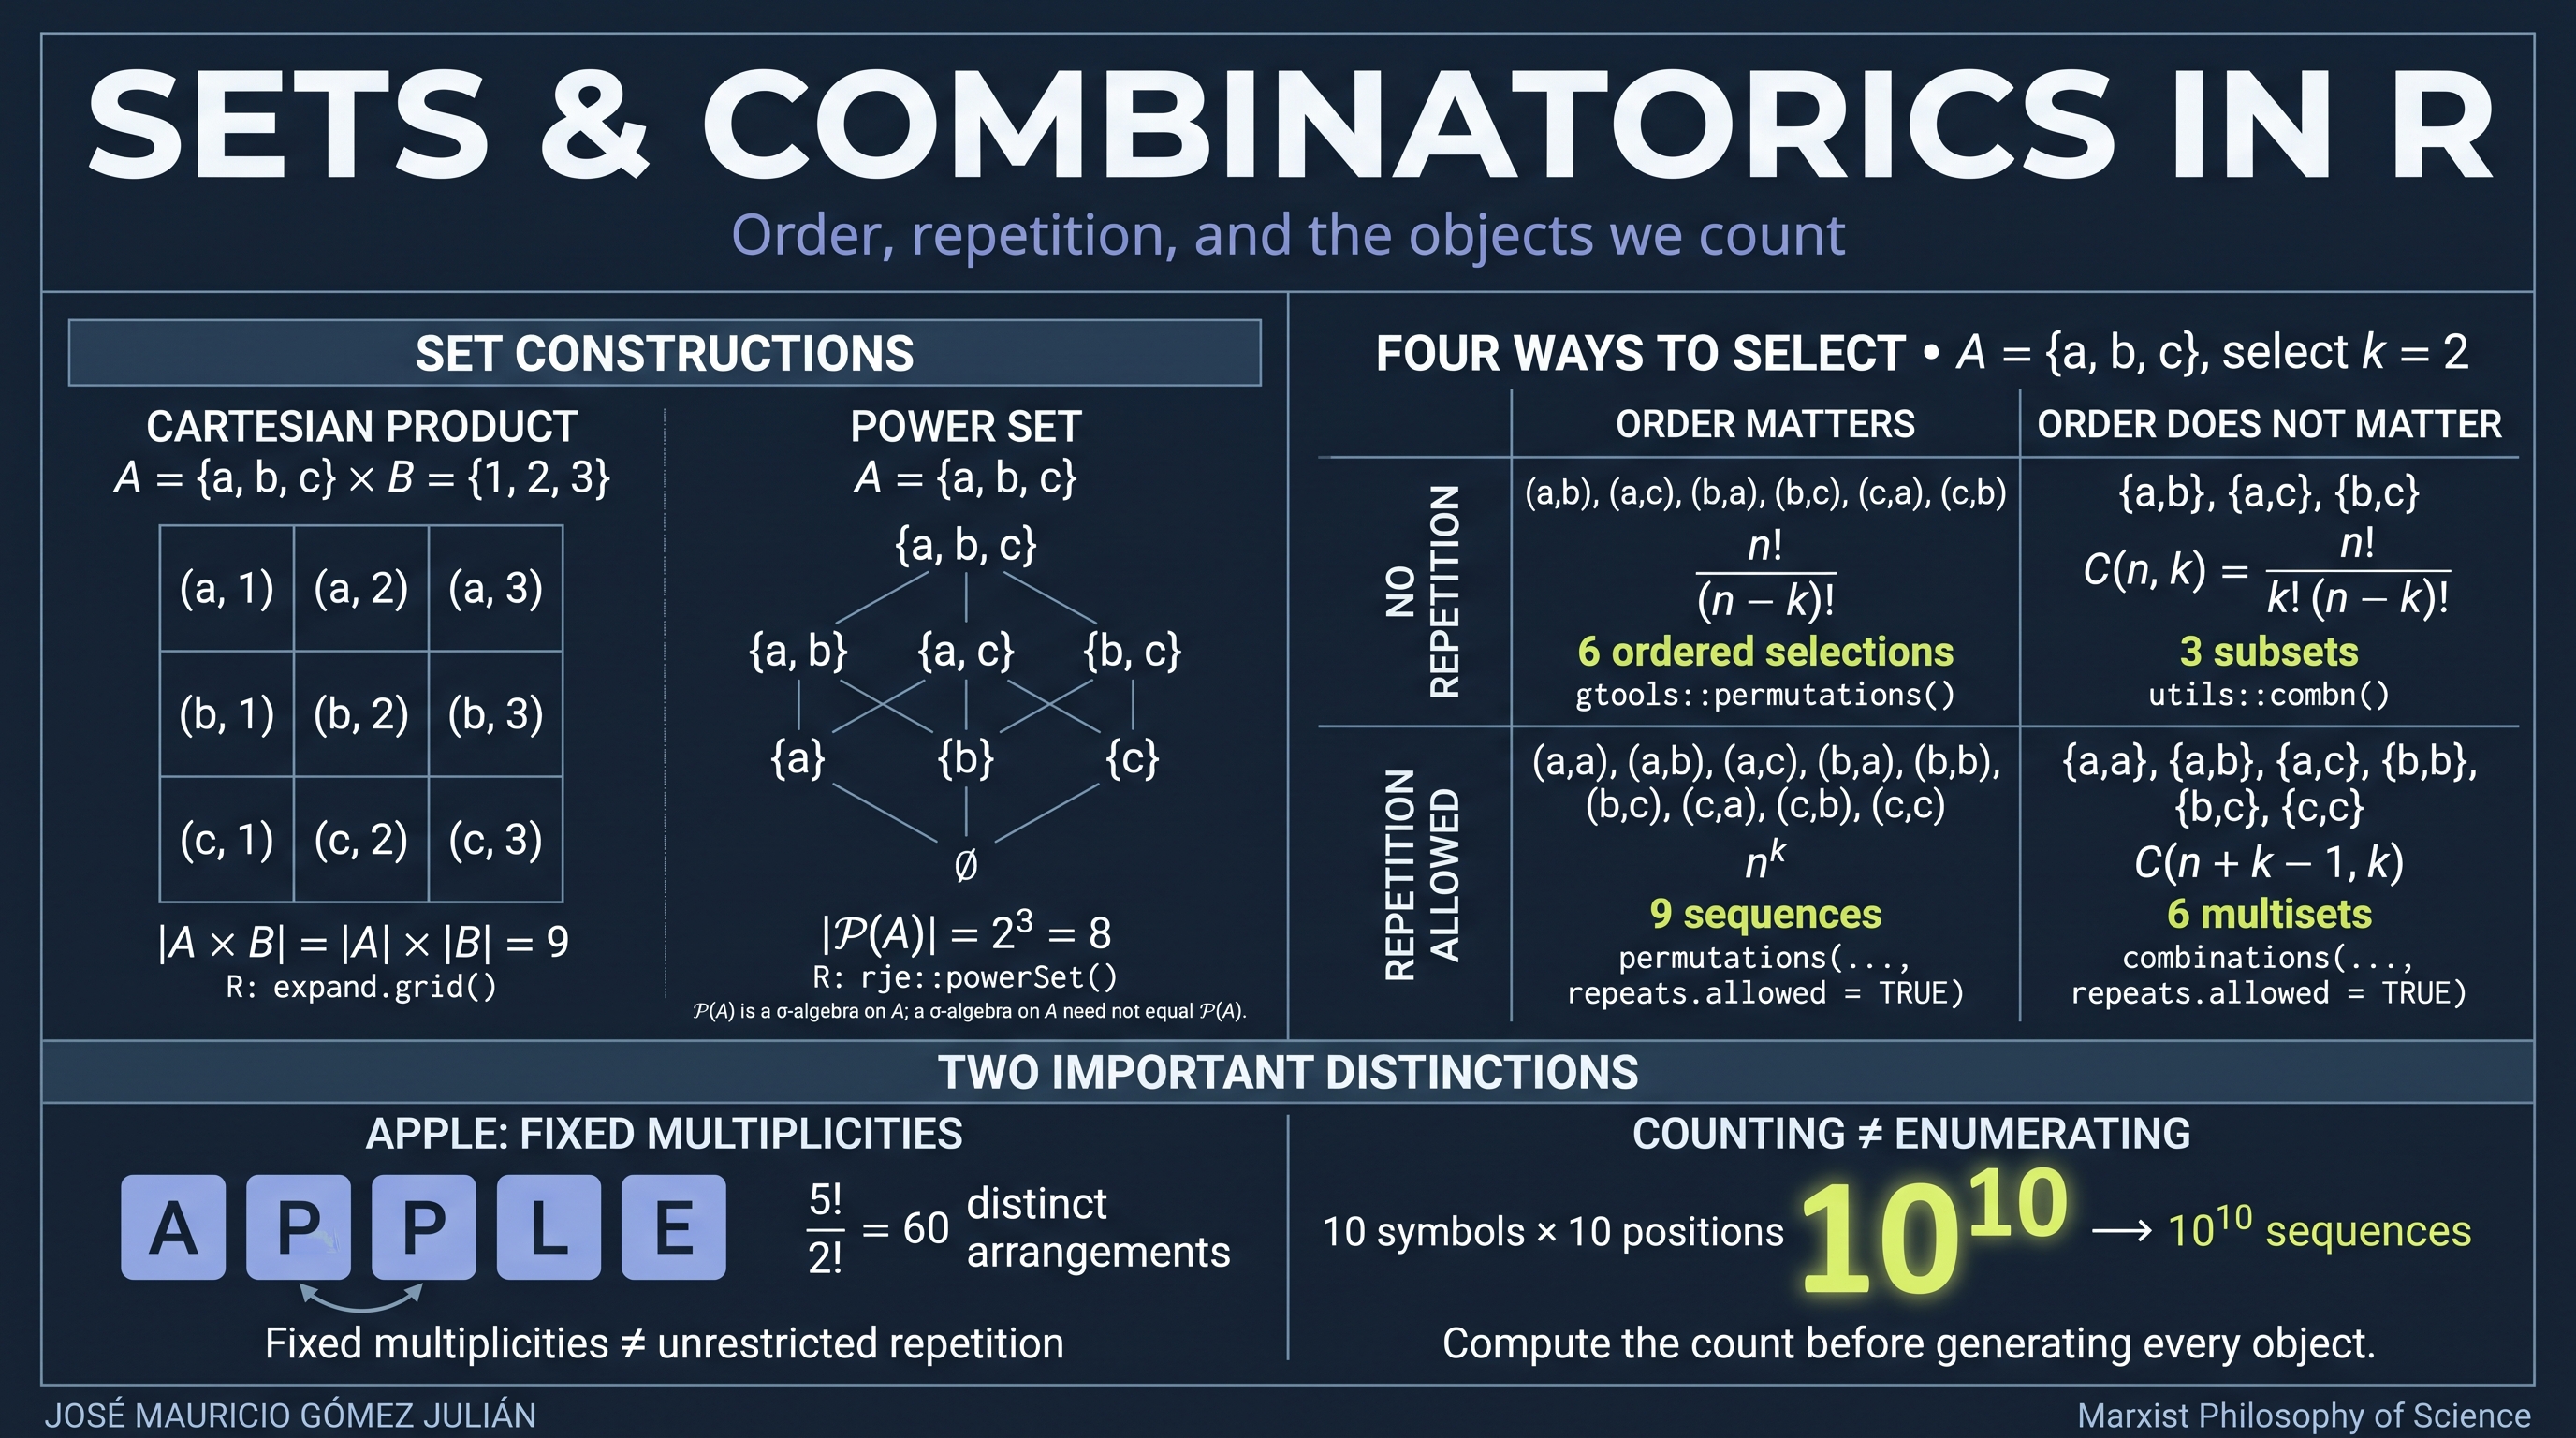
En ℝᵖ, la familia de Minkowski reúne métricas inducidas por normas:
Los casos q=1, q=2 y q→∞ corresponden a Manhattan, euclidiana y máximo. Para q≥1, la desigualdad de Minkowski ‖u+v‖q≤‖u‖q+‖v‖q garantiza el triángulo. Para 0<q<1, la misma expresión con raíz 1/q no es una norma y puede incumplirlo. Esto no debe confundirse con la suma sin esa raíz: ∑|xⱼ−yⱼ|q sí es una métrica en ese intervalo.
Para x=(1,2) e y=(4,6), las diferencias absolutas son 3 y 4: Manhattan da 7; euclidiana, √(9+16)=5; máximo, 4. Las tres respuestas son coherentes con reglas geométricas diferentes.
La expresión δ(x,y)=‖x−y‖₂² es la distancia euclidiana al cuadrado. Es simétrica y separa puntos, pero no es una métrica en general. Con x=0, y=1 y z=2 se obtiene δ(x,z)=4 y δ(x,y)+δ(y,z)=2:
Las unidades importan. Medir una variable en colones y otra en miles de colones cambia el peso relativo de sus diferencias. Estandarizar columnas por desviación estándar es una decisión posible, no una obligación universal; requiere escalas no nulas y una interpretación defendible. Con pesos estrictamente positivos, d(x,y)=√∑wⱼ(xⱼ−yⱼ)² sigue siendo una métrica. Pesos nulos pueden producir una pseudométrica; pesos negativos ya no garantizan una distancia real no negativa.
La implementación de dist() se documenta en R Core Team (s. f.-b); en esa función, el argumento llamado p corresponde al exponente q utilizado en este texto.
05 · Pearson, Spearman y Kendall: de asociación a disimilaridad
Las correlaciones miden asociación, no separación métrica de observaciones originales. Pueden ser negativas y alcanzan 1, no 0, para un perfil no constante comparado consigo mismo. Deben identificarse antes de transformarlas.
Pearson
La fórmula requiere que ambos perfiles tengan variación. Para x=(1,2,3) e y=(2,4,6), r=1 aunque x≠y y la distancia euclidiana sea √14. Así, 1−r ignora diferencias de nivel y escala positiva; esto puede ser deseable para comparar formas, pero no cuando interesa la magnitud absoluta.
Spearman
La primera igualdad es la definición mediante Pearson sobre rangos. La segunda es una simplificación válida sin empates. Con empates se asignan rangos medios y se aplica la primera expresión; las sumas del numerador de Pearson deben ser productos emparejados dentro de una misma sumatoria, no el producto de dos sumas centradas que valdrían cero.
Kendall
Para cada par de elementos i<j, C cuenta concordancias y D discordancias. Tx y Ty cuentan pares empatados únicamente en x o únicamente en y; los empatados en ambos no entran en esos términos. Sin empates, C+D=p(p−1)/2 y τa=(C−D)/(C+D). Un empate no significa que dos jueces otorguen el mismo rango a una misma persona: significa igualdad dentro de al menos una de las ordenaciones para un par de personas.
Retomando los doce candidatos del documento original: X=(1,2,…,12) e Y=(1,2,4,3,6,5,8,7,10,9,12,11). Hay 66 pares, cinco discordantes y 61 concordantes; por tanto τ=56/66≈0.848485. La suma de diferencias de rangos al cuadrado es 10, por lo que ρs=1−60/1716≈0.965035. Son coeficientes diferentes para la misma comparación.
Una transformación no garantiza una métrica
Considérense los perfiles centrados x=(1,−1,0), y=(1,0,−1), z=(0,1,−1). Se calculan r(x,y)=r(y,z)=1/2 y r(x,z)=−1/2. La disimilaridad 1−r produce 1/2, 1/2 y 3/2: incumple el triángulo. La distancia cordal se justifica normalizando:
La igualdad demuestra que dch es euclidiana entre los vectores normalizados. Sobre los perfiles originales es, en general, una pseudométrica: perfiles relacionados por y=a·x+b·1 con a>0 tienen distancia cero. Se convierte en métrica sobre las clases de equivalencia de esos perfiles. Spearman admite la misma construcción después de asignar rangos y normalizarlos. No se debe extender automáticamente esta demostración a cualquier fórmula basada en Kendall.
R Core Team (s. f.-a) documenta la correlación de rangos y el tratamiento de empates; los trabajos de Kendall (1938, 1945) distinguen el coeficiente original y su ajuste. Los cálculos y el contraejemplo anteriores se desarrollan aquí explícitamente.
06 · Pseudométricas: qué información se pierde
Una pseudométrica conserva no negatividad, simetría y triángulo, pero permite distancia cero entre objetos distintos. Si φ:𝒳→𝒴 y d𝒴 es una métrica, entonces dφ(x,y)=d𝒴(φ(x),φ(y)) es una pseudométrica; es métrica si φ es inyectiva. La desigualdad triangular se hereda directamente de 𝒴.
Con π(x₁,x₂)=x₁, los puntos P=(2,3) y Q=(2,5) tienen pseudodistancia cero: la segunda coordenada fue descartada. El ejemplo no contradice la matemática; expresa exactamente la información que la representación ha eliminado.
Se conservan también los ejemplos d(f,g)=|f(t₀)−g(t₀)| para funciones reales sobre un dominio que contiene t₀; d(x,y)=s(x−y) cuando s es una seminorma; y la pseudométrica trivial d≡0. Cada uno explica una forma distinta de indistinguibilidad.
La relación ∼ es de equivalencia: la transitividad se obtiene del triángulo. La distancia entre clases está bien definida, pues cambiar un representante por otro a distancia cero no cambia el resultado. En el cociente 𝒳/∼ se obtiene una métrica. En análisis de datos, esta construcción permite distinguir duplicados de representación de objetos sustantivamente idénticos.
07 · Cuasimétricas y comparaciones direccionales
Una cuasimétrica permite que el coste de pasar de x a y difiera del coste de volver. Bajo la convención aquí adoptada, q(x,x)=0, se cumple el triángulo dirigido y q(x,y)=q(y,x)=0 implica x=y. La no negatividad forma parte de la definición.
Por ejemplo, q(2,5)=3, pero q(5,2)=0. En un sentido se mide el incremento necesario; en el otro, no hay incremento que penalizar. La desigualdad triangular procede de (a+b)₊≤a₊+b₊. El conjugado invierte la dirección, y el máximo de ambos recupera una métrica. Para cualquier cuasimétrica con esa separación conjunta, tanto max{q,q*} como q+q* son métricas.
Las bolas dirigidas dependen de si se usa q(x,y) o q(y,x); las topologías asociadas deben indicar esa elección. Una cuasimétrica puede modelar costes de transformación asimétricos, pero no todo coste asimétrico satisface el triángulo. La métrica discreta, que vale 0 para puntos iguales y 1 para puntos distintos, es simétrica: puede incluirse en la clase amplia de cuasimétricas, pero no ejemplifica asimetría.
08 · Distancias entre conjuntos y criterios de enlace
Sean A y B dos conglomerados finitos no vacíos y d una métrica entre sus observaciones. El enlace simple utiliza el par más próximo; el completo, el más distante; el promedio, todas las parejas. Hausdorff compara la mayor distancia al vecino más próximo en ambas direcciones:
Hausdorff es una métrica sobre los subconjuntos finitos no vacíos de un espacio métrico; se extiende a los compactos no vacíos. Para ver la separación, distancia cero obliga a que cada punto de un conjunto pertenezca al otro; el triángulo se obtiene encadenando aproximaciones a vecinos en el conjunto intermedio.
Los criterios de enlace no son automáticamente métricas sobre conjuntos. El enlace simple puede valer cero para conjuntos diferentes que se intersectan. El completo y el promedio pueden dar D(A,A)>0. La distancia entre centroides puede ser cero para conjuntos diferentes con el mismo centro. Se trata de propiedades distintas de la utilidad de estas reglas para construir una jerarquía.
Ejemplo completo en ℝ: A={0,2}, B={5,9}. Las cuatro distancias cruzadas son 5,9,3,7; los centroides son 1 y 7. Desde A, la mayor distancia al vecino más próximo de B es 5; desde B hacia A es 7. Los resultados son:
| Criterio | Resultado | Cálculo |
|---|---|---|
| Simple | 3 | min{5,9,3,7} |
| Completo | 9 | max{5,9,3,7} |
| Promedio | 6 | (5+9+3+7)/4 |
| Centroides | 6 | |1−7| |
| Hausdorff | 7 | max{5,7} |
| Ward: ΔW | 36 | (2·2/4)·(1−7)² |
Ward elige la fusión que minimiza el incremento de la suma de cuadrados dentro de los grupos. Descomponer las desviaciones respecto al nuevo centro produce:
En el ejemplo, W(A)=2 y W(B)=8; el centro conjunto es 4 y W(A∪B)=46, por lo que ΔW=46−10=36. Este incremento no es la misma cantidad que la distancia entre centroides. En la parametrización euclidiana usual de Ward.D2, la altura corresponde a √(2ΔW), no directamente a ΔW; el ejemplo daría √72≈8.4853.
09 · Elegir una medida y un algoritmo compatibles
| Método | Compatibilidad que debe comprobarse |
|---|---|
| k-means | Minimiza sumas de cuadrados euclidianas respecto a medias. Sustituir sin más la distancia cambia el problema y la actualización óptima del centro. |
| Ward.D2 | Usar distancias euclidianas; hclust las eleva al cuadrado internamente. No proporcionar dist(X)^2 a Ward.D2 para el criterio usual. |
| Enlaces simple, completo y promedio | Admiten disimilaridades simétricas apropiadas; ejecutar el método no demuestra que la entrada sea métrica ni euclidiana. |
| PAM / k-medoids | Los representantes son observaciones. Puede trabajar con disimilaridades sin requerir medias aritméticas; comprobar las condiciones de la implementación. |
| Silueta | Se calcula con las disimilaridades declaradas; su interpretación depende de ellas y de la partición. No certifica los axiomas métricos. |
La euclidianidad es más fuerte que cumplir los axiomas métricos. Para una matriz simétrica finita D, no negativa y con diagonal cero, puede diagnosticarse mediante B=−½JD²J, donde J=I−11ᵀ/N y D² es el cuadrado elemento a elemento. Existe una representación euclidiana exacta si B es semidefinida positiva; autovalores negativos importantes descartan esa representación. Una tolerancia numérica solo atiende redondeo.
Una correlación de Pearson calculada con un conjunto común de coordenadas permite usar la distancia cordal como entrada euclidiana entre perfiles normalizados. Con Ward.D2 se introduce la raíz √[2(1−r)], sin volver a elevarla al cuadrado previamente. La operación conserva la geometría normalizada, no las magnitudes originales.
Para variables categóricas o mixtas, debe elegirse una construcción que respete su escala. Codificar categorías nominales como 1,2,3 e introducirlas en una distancia euclidiana impone un orden y separaciones que pueden carecer de sentido. Pueden considerarse Hamming, Jaccard o Gower según el dominio, declarando tratamientos de ausencias, ponderación y valores faltantes. Estas extensiones no eliminan la necesidad de verificar los axiomas de la variante concreta.
El criterio de mínima variación procede de Ward (1963); la distinción entre implementaciones se desarrolla en Murtagh y Legendre (2014) y en R Core Team (s. f.-c).
10 · Un experimento reproducible con seis observaciones
Se utiliza un conjunto ilustrativo diseñado para poder reconstruir todos los cálculos; no representa una muestra empírica de una población. Ambas variables se tratan como coordenadas comparables y no se estandarizan en este ejemplo:
| ID | x₁ | x₂ |
|---|---|---|
| A | 0 | 0 |
| B | 1 | 0.2 |
| C | 0.3 | 2.4 |
| D | 3.5 | 3.1 |
| E | 5.2 | 1.3 |
| F | 5.9 | 4 |
| ID | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| A | 0.0000 | 1.0198 | 2.4187 | 4.6755 | 5.3600 | 7.1281 |
| B | 1.0198 | 0.0000 | 2.3087 | 3.8288 | 4.3417 | 6.2008 |
| C | 2.4187 | 2.3087 | 0.0000 | 3.2757 | 5.0220 | 5.8241 |
| D | 4.6755 | 3.8288 | 3.2757 | 0.0000 | 2.4759 | 2.5632 |
| E | 5.3600 | 4.3417 | 5.0220 | 2.4759 | 0.0000 | 2.7893 |
| F | 7.1281 | 6.2008 | 5.8241 | 2.5632 | 2.7893 | 0.0000 |
La primera fusión euclidiana une A y B a √1.04≈1.019804. La altura final del enlace simple depende de un puente entre grupos; la del completo depende del par más alejado. Al cambiar a Manhattan se modifican las contribuciones por coordenada. Ward calcula una secuencia basada en incrementos de dispersión. Que una partición a cierto número de grupos coincida entre dos métodos no significa que toda la jerarquía o sus alturas sean iguales.
| Fusión | Euc. completo | Euc. simple | Man. completo | Ward.D2 |
|---|---|---|---|---|
| 1 | 1.019804 | 1.019804 | 1.200000 | 1.019804 |
| 2 | 2.418677 | 2.308679 | 2.900000 | 2.475884 |
| 3 | 2.475884 | 2.475884 | 3.300000 | 2.665833 |
| 4 | 2.789265 | 2.563201 | 3.500000 | 2.742870 |
| 5 | 7.128113 | 3.275668 | 9.900000 | 8.377151 |
A tres grupos, la euclidiana con enlace completo produce {A,B,C}, {D,E}, {F}; Manhattan con enlace completo produce {A,B,C}, {D,F}, {E}. El resto del procedimiento es el mismo: cambia la medida y cambia una decisión de fusión. Las etiquetas numéricas de grupo son arbitrarias.
11 · Funciones, variedades y tensores: distinciones necesarias
La palabra «métrica» aparece en contextos relacionados pero distintos. La distancia de Minkowski sobre vectores es una métrica inducida por una norma. En espacios de funciones, para 1≤q<∞ se define:
Sobre funciones consideradas punto a punto, dos funciones que difieren únicamente en un conjunto de medida cero pueden tener distancia cero. Los espacios Lᵠ se construyen identificando funciones iguales casi en todas partes; sobre esas clases la expresión es una norma. Los espacios Lᵠ son completos para q≥1, pero su definición requiere especificar la medida y el dominio de integración.
Una variedad suave de dimensión n es localmente semejante a un abierto de ℝⁿ mediante cartas compatibles. El espacio tangente TₐM en un punto a no requiere que la variedad sea compacta. Un tensor métrico riemanniano asigna, de manera suave, un producto interno positivo definido a cada espacio tangente:
La simetría corresponde a intercambiar vectores tangentes, no a intercambiar puntos de la variedad. La no degeneración significa que gₐ(u,v)=0 para todo v obliga a u=0; en coordenadas equivale a una matriz de componentes invertible. La positividad definida es una exigencia adicional. En una variedad riemanniana conexa, integrar √g(γ̇,γ̇) a lo largo de curvas y tomar el ínfimo define la distancia intrínseca entre puntos.
Una métrica pseudoriemanniana admite firma indefinida. Por ejemplo, g(v,v)=−v₀²+v₁²+⋯+vₙ² puede ser positiva, negativa o cero con v≠0. Esa forma no proporciona automáticamente una disimilaridad no negativa apta para los algoritmos anteriores. La geometría del espacio-tiempo de Minkowski debe distinguirse de la familia de normas de Minkowski.
Por último, orden tensorial y dimensión son conceptos diferentes: un tensor de orden dos puede tener una matriz de componentes n×n. Su carácter tensorial exige una ley de transformación. Para un tensor covariante de orden dos:
En coordenadas euclidianas cartesianas, g̃ₐᵦ=δₐᵦ, y se obtiene el caso particular gᵢⱼ=∑ₐ(∂ξᵃ/∂xⁱ)(∂ξᵃ/∂xʲ). Una matriz de datos puede representar distintos objetos matemáticos; su disposición rectangular no basta para identificarla con un tensor métrico. Estas distinciones preservan la conexión con la geometría sin atribuir a cualquier agrupamiento una estructura diferencial que aún no se ha construido.
Las definiciones algebraicas de métrica no degenerada y de firma pueden contrastarse en SageMath Developers (s. f.). La separación entre estas estructuras y los criterios de agrupamiento es parte del argumento de esta revisión.
12 · Código R y verificaciones
El siguiente programa utiliza únicamente paquetes incluidos con R. No descarga datos ni instala dependencias. Rechaza entradas no finitas para mantener un dominio común; produce resultados tabulares, diagnósticos y un PDF con los cuatro dendrogramas. La función audit_distance verifica todos los triples de la muestra y señala que su coste es cúbico.
Mostrar el programa R completo
# Medidas de disimilaridad: ejemplos verificables con R base.
# Ejecutar: Rscript disimilaridad_ejemplos_reproducibles.R [directorio_salida]
# Las columnas son coordenadas comparables; no se estandarizan en este ejemplo.
args <- commandArgs(trailingOnly = TRUE)
out_dir <- if (length(args)) args[1L] else "disimilaridad_resultados"
dir.create(out_dir, recursive = TRUE, showWarnings = FALSE)
audit_distance <- function(D, tol = 1e-10) {
# Revisión exhaustiva de la matriz finita: tiempo O(N^3).
D <- as.matrix(D)
if (!is.numeric(D) || nrow(D) != ncol(D) || nrow(D) < 1L ||
any(!is.finite(D)) || length(tol) != 1L || !is.finite(tol) || tol <= 0) {
stop("Se requiere una matriz numerica cuadrada finita y tol > 0.")
}
n <- nrow(D)
eps <- tol * max(1, abs(D))
diagonal_zero <- max(abs(diag(D))) <= eps
nonnegative <- min(D) >= -eps
symmetric <- max(abs(D - t(D))) <= eps
separated <- if (n == 1L) TRUE else all(D[row(D) != col(D)] > eps)
max_violation <- -Inf
for (k in seq_len(n)) {
max_violation <- max(max_violation, D - outer(D[, k], D[k, ], "+"))
}
triangle <- max_violation <= eps
euclidean <- NA
min_eigenvalue <- NA_real_
if (nonnegative && diagonal_zero && symmetric) {
J <- diag(n) - matrix(1 / n, n, n)
B <- -0.5 * J %*% (D^2) %*% J
eigenvalues <- eigen((B + t(B)) / 2, symmetric = TRUE,
only.values = TRUE)$values
min_eigenvalue <- min(eigenvalues)
euclidean <- min_eigenvalue >= -tol * max(1, abs(eigenvalues))
}
c(diagonal_zero = diagonal_zero, nonnegative = nonnegative,
symmetric = symmetric, separated = separated, triangle = triangle,
metric = diagonal_zero && nonnegative && symmetric && separated && triangle,
max_triangle_violation = max(0, max_violation),
euclidean = euclidean, min_gram_eigenvalue = min_eigenvalue)
}
X <- rbind(A = c(0, 0), B = c(1, 0.2), C = c(0.3, 2.4),
D = c(3.5, 3.1), E = c(5.2, 1.3), F = c(5.9, 4.0))
colnames(X) <- c("x1", "x2")
stopifnot(all(is.finite(X)))
D_e <- as.matrix(dist(X, method = "euclidean"))
D_m <- as.matrix(dist(X, method = "manhattan"))
D_i <- as.matrix(dist(X, method = "maximum"))
stopifnot(isTRUE(all.equal(dist(X, method = "minkowski", p = 2),
dist(X), check.attributes = FALSE)))
write.csv(X, file.path(out_dir, "observaciones.csv"))
write.csv(D_e, file.path(out_dir, "distancias_euclidianas.csv"))
# Contraejemplo 1: elevar al cuadrado puede romper el triangulo.
D_line <- as.matrix(dist(matrix(0:2, ncol = 1)))
check_squared <- audit_distance(D_line^2)
stopifnot(check_squared["triangle"] == 0,
abs(check_squared["max_triangle_violation"] - 2) < 1e-10)
# Contraejemplo 2: 1-r puede romper el triangulo.
profiles <- rbind(x = c(1, -1, 0), y = c(1, 0, -1), z = c(0, 1, -1))
stopifnot(all(apply(profiles, 1, sd) > 0))
R <- cor(t(profiles), use = "all.obs", method = "pearson")
D_corr <- 1 - R
D_chord <- sqrt(pmax(2 * D_corr, 0))
dimnames(D_chord) <- dimnames(R)
U <- profiles - rowMeans(profiles)
U <- U / sqrt(rowSums(U^2))
stopifnot(isTRUE(all.equal(unname(D_chord), unname(as.matrix(dist(U))),
tolerance = 1e-10)))
stopifnot(audit_distance(D_corr)["triangle"] == 0,
audit_distance(D_chord)["metric"] == 1)
# Mismo perfil normalizado: objetos originales distintos, distancia cero.
x <- c(1, 2, 3)
y <- c(2, 4, 6)
stopifnot(abs(cor(x, y) - 1) < 1e-12,
abs(sqrt(sum((x - y)^2)) - sqrt(14)) < 1e-12)
# Pseudometrica y cuasimetrica: se mantienen ambas direcciones.
P <- rbind(P = c(2, 3), Q = c(2, 5), S = c(4, 1))
D_projection <- abs(outer(P[, 1], P[, 1], "-"))
v <- c(2, 5, 8)
Q <- outer(v, v, function(a, b) pmax(b - a, 0))
Q_s <- pmax(Q, t(Q))
stopifnot(audit_distance(D_projection)["separated"] == 0,
Q[1, 2] == 3, Q[2, 1] == 0,
audit_distance(Q)["triangle"] == 1,
audit_distance(Q_s)["metric"] == 1)
# Doce candidatos: cinco inversiones adyacentes, sin empates.
rank_x <- 1:12
rank_y <- c(1, 2, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11)
pairs <- combn(12L, 2L)
signs <- apply(pairs, 2, function(ij) {
sign((rank_x[ij[1]] - rank_x[ij[2]]) *
(rank_y[ij[1]] - rank_y[ij[2]]))
})
concordant <- sum(signs > 0)
discordant <- sum(signs < 0)
rho_s <- cor(rank_x, rank_y, method = "spearman")
tau <- cor(rank_x, rank_y, method = "kendall")
stopifnot(concordant == 61, discordant == 5,
abs(tau - 56 / 66) < 1e-12,
abs(rho_s - (1 - 60 / 1716)) < 1e-12)
# Con empates, Spearman es Pearson sobre rangos medios.
tie_x <- c(1, 1, 3, 4)
tie_y <- c(2, 3, 3, 5)
stopifnot(isTRUE(all.equal(cor(tie_x, tie_y, method = "spearman"),
cor(rank(tie_x), rank(tie_y)))))
# Conglomerados A={0,2}, B={5,9}: comparaciones en una dimension.
cluster_A <- c(0, 2)
cluster_B <- c(5, 9)
cross <- abs(outer(cluster_A, cluster_B, "-"))
hausdorff <- max(apply(cross, 1, min), apply(cross, 2, min))
delta_W <- length(cluster_A) * length(cluster_B) /
(length(cluster_A) + length(cluster_B)) *
(mean(cluster_A) - mean(cluster_B))^2
cluster_results <- c(single = min(cross), complete = max(cross),
average = mean(cross), centroid = abs(mean(cluster_A) -
mean(cluster_B)), Hausdorff = hausdorff, Ward_deltaW = delta_W)
stopifnot(isTRUE(all.equal(unname(cluster_results), c(3, 9, 6, 6, 7, 36))))
fits <- list(
euclidean_complete = hclust(as.dist(D_e), method = "complete"),
euclidean_single = hclust(as.dist(D_e), method = "single"),
manhattan_complete = hclust(as.dist(D_m), method = "complete"),
euclidean_wardD2 = hclust(as.dist(D_e), method = "ward.D2")
)
# Comprueba cada altura de Ward.D2 mediante el incremento real de W.
hc <- fits$euclidean_wardD2
groups <- vector("list", nrow(hc$merge))
ward_check <- numeric(nrow(hc$merge))
for (i in seq_len(nrow(hc$merge))) {
get_group <- function(j) if (j < 0) -j else groups[[j]]
a <- get_group(hc$merge[i, 1])
b <- get_group(hc$merge[i, 2])
delta <- length(a) * length(b) / (length(a) + length(b)) *
sum((colMeans(X[a, , drop = FALSE]) - colMeans(X[b, , drop = FALSE]))^2)
ward_check[i] <- sqrt(2 * delta)
groups[[i]] <- c(a, b)
}
stopifnot(isTRUE(all.equal(hc$height, ward_check, tolerance = 1e-10)))
diagnostics <- rbind(
euclidean = audit_distance(D_e), manhattan = audit_distance(D_m),
maximum = audit_distance(D_i), squared_line = check_squared,
one_minus_r = audit_distance(D_corr), chordal = audit_distance(D_chord),
projection = audit_distance(D_projection), directed = audit_distance(Q),
symmetrized = audit_distance(Q_s)
)
write.csv(diagnostics, file.path(out_dir, "diagnosticos.csv"))
write.csv(as.data.frame(cluster_results), file.path(out_dir, "criterios_conglomerados.csv"))
write.csv(data.frame(concordant, discordant, rho_s, tau),
file.path(out_dir, "rangos.csv"), row.names = FALSE)
heights <- do.call(cbind, lapply(fits, function(h) h$height))
colnames(heights) <- names(fits)
write.csv(heights, file.path(out_dir, "alturas.csv"), row.names = FALSE)
partitions <- do.call(cbind, lapply(fits, cutree, k = 3))
write.csv(partitions, file.path(out_dir, "particiones_k3.csv"))
for (name in names(fits)) {
h <- fits[[name]]
write.csv(data.frame(left = h$merge[, 1], right = h$merge[, 2], height = h$height),
file.path(out_dir, paste0("fusiones_", name, ".csv")), row.names = FALSE)
}
pdf(file.path(out_dir, "dendrogramas.pdf"), width = 9, height = 7,
bg = "#fffdf7", family = "serif", useDingbats = FALSE)
par(mfrow = c(2, 2), mar = c(3, 4, 3, 1), col = "#2c2418",
col.axis = "#2c2418", col.lab = "#2c2418", col.main = "#8b4513")
titles <- c("Euclidiana / completo", "Euclidiana / simple",
"Manhattan / completo", "Euclidiana / Ward.D2")
for (i in seq_along(fits)) {
plot(fits[[i]], main = titles[i], sub = "", xlab = "", ylab = "Altura", hang = -1)
}
invisible(dev.off())
capture.output(sessionInfo(), file = file.path(out_dir, "sessionInfo.txt"))
print(round(diagnostics, 8))
print(cluster_results)
print(data.frame(concordant, discordant, rho_s, tau))
print(round(heights, 8))
print(partitions)
cat("Verificaciones completadas. Resultados en:", normalizePath(out_dir), "\n")
13 · Referencias y alcance de la revisión
Las demostraciones breves, los contraejemplos y el conjunto A–F son desarrollos didácticos de esta revisión. Las referencias fundamentan las convenciones y permiten comprobar las implementaciones; no se presentan los ejemplos sintéticos como resultados de esos autores.
Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1–2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239–251. https://doi.org/10.1093/biomet/33.3.239
McAuley, L. F. (1956). A relation between perfect separability, completeness, and normality in semi-metric spaces. Pacific Journal of Mathematics, 6(2), 315–326. https://doi.org/10.2140/pjm.1956.6.315
Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31, 274–295. https://doi.org/10.1007/s00357-014-9161-z
R Core Team. (s. f.-a). Correlation, variance and covariance (matrices) [R stats documentación]. Recuperado el 11 de noviembre de 2026, de https://stat.ethz.ch/R-manual/R-devel/library/stats/html/cor.html
R Core Team. (s. f.-b). Distance matrix computation [R stats documentación]. Recuperado el 11 de noviembre de 2026, de https://stat.ethz.ch/R-manual/R-devel/library/stats/html/dist.html
R Core Team. (s. f.-c). Hierarchical clustering [R stats documentación]. Recuperado el 11 de noviembre de 2026, de https://stat.ethz.ch/R-manual/R-devel/library/stats/html/hclust.html
SageMath Developers. (s. f.). Pseudo-Riemannian metrics and degenerate metrics [SageMath manual de referencia]. Recuperado el 11 de noviembre de 2026, de https://doc.sagemath.org/html/en/reference/manifolds/sage/manifolds/differentiable/metric.html
Stojmirović, A. (2005). Quasi-metrics, similarities and searches: Aspects of geometry of protein datasets [Tesis doctoral, Victoria University of Wellington]. arXiv (depósito de 2008). https://arxiv.org/abs/0810.5407
Ward, J. H., Jr. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845