Espartaco

“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”

Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290

28,796 views since December 2020

28,796 visitas desde diciembre de 2020

EnglishEspañol

Categoría: GitHub

  • Extracción de Señales del Ruido: Cómo SignalY Aborda Tres Problemas Complejos en Datos de Panel

    Extracción de Señales del Ruido: Cómo SignalY Aborda Tres Problemas Complejos en Datos de Panel

    Puedes también encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Econometría · Extracción de señales · Series temporales multivariadas

    Del ruido a la estructura: cómo SignalY busca la señal oculta en datos complejos

    Un paquete de R que reúne selección bayesiana de variables, descubrimiento de factores, wavelets, descomposición empírica, filtrado bayesiano y pruebas de persistencia en un mismo flujo para paneles y series temporales multivariadas.

    Desarrollado por José Mauricio Gómez Julián · Licencia MIT · GitHub

    Imaginemos una matriz con cincuenta columnas y apenas unos cientos de observaciones. Cada columna representa un indicador macroeconómico, financiero o político. Sabemos que, en alguna parte de esa matriz, existe una señal que merece nuestra atención. El problema es que también hay ruido, redundancia, tendencias comunes y variables que parecen importantes únicamente porque se mueven junto con otras.

    Entonces aparecen tres preguntas distintas, pero estrechamente conectadas: ¿qué variables importan realmente?, ¿qué estructura latente existe detrás de ellas? y ¿qué tan persistentes son las señales que terminamos extrayendo?

    Normalmente responderlas obliga a saltar entre varios paquetes: uno para selección de variables, otro para PCA, otro para filtros, otro para pruebas de raíz unitaria y otro para visualizar resultados.

    SignalY nace precisamente para reducir esa fragmentación. Su idea no es inventar de nuevo cada uno de esos métodos, sino organizarlos dentro de un marco coherente donde las diferentes etapas del análisis puedan comunicarse entre sí.

    La idea en una frase

    SignalY intenta convertir una tarea fragmentada — seleccionar, descomponer y caracterizar una señal— en un único flujo reproducible de análisis estadístico.

    Tres preguntas, tres pilares

    Selección: ¿cuáles de todas las variables disponibles contienen información estructural y cuáles pueden considerarse principalmente ruido?

    Descomposición: una vez identificada o construida la señal, ¿qué parte corresponde a tendencia, ciclos de distintas frecuencias y fluctuaciones residuales?

    Persistencia: ¿los componentes extraídos son estacionarios, poseen raíz unitaria o se encuentran en una zona fronteriza cercana a la no estacionariedad?

    Primer pilar: ¿qué variables importan?

    En un problema de alta dimensión podemos tener decenas de predictores, aunque sólo unos pocos contengan la señal que realmente interesa. Una regresión convencional puede intentar asignar un coeficiente a todos, pero con muestras moderadas eso abre rápidamente la puerta al sobreajuste.

    SignalY aborda el problema mediante regresión bayesiana dispersa con prior Horseshoe.

    La intuición detrás de la Horseshoe

    La prior Horseshoe pertenece a la familia de priors global-local shrinkage. Su objetivo es ejercer mucha presión sobre los coeficientes pequeños —probablemente asociados a ruido— y, simultáneamente, permitir que las señales fuertes escapen de esa contracción.

    Podemos representar la idea esquemáticamente como:

    $$ \beta_j \sim \mathcal{N} \left( 0, \tau^2 \lambda_j^2 \right) $$

    donde $\tau$ controla la contracción global y $\lambda_j$ permite una adaptación local para cada coeficiente.

    Si la evidencia a favor de una variable es débil, la fuerza global puede empujar su coeficiente hacia cero. Si existe una señal suficientemente fuerte, su parámetro local puede permitir que sobreviva.

    La intuición

    En lugar de preguntar “¿incluyo o elimino esta variable?” antes de estimar, la Horseshoe plantea algo más gradual: ¿cuánto debe contraerse cada coeficiente dada la información disponible?

    Una posterior no selecciona variables por sí sola

    Ajustar una prior de contracción es apenas la primera parte del problema. Todavía necesitamos convertir las distribuciones posteriores en alguna regla práctica para determinar qué variables conservar.

    SignalY incluye cuatro estrategias distintas.

    Projection predictive selection

    Proyecta la distribución posterior del modelo completo sobre modelos más pequeños y busca el subconjunto mínimo cuyo desempeño predictivo permanezca suficientemente próximo al modelo de referencia.

    Intervalos creíbles

    Conserva variables cuyos intervalos posteriores no incluyen cero. Es una estrategia sencilla de interpretar, aunque puede resultar conservadora cuando la dimensión es alta.

    Selección por contracción

    Utiliza la intensidad de shrinkage —representada mediante cantidades como $\kappa$— para detectar qué variables consiguieron escapar sustancialmente de la contracción.

    Selección por magnitud

    Aplica un filtro basado directamente en el tamaño del efecto, útil como cribado inicial o como complemento a las decisiones bayesianas.

    La ventaja de ofrecer las cuatro dentro del mismo sistema es que el investigador puede comprobar hasta qué punto una selección depende de una única definición de “variable importante”.

    Otra pregunta: quizá las cincuenta variables sean la manifestación de tres factores

    No todo problema de alta dimensión exige seleccionar columnas individualmente. A veces muchas variables son expresiones diferentes de unos pocos procesos latentes.

    SignalY incorpora dos estrategias para explorar esta posibilidad.

    PCA + block bootstrap

    La componente principal resume variación común, mientras que el bootstrap por bloques intenta respetar la dependencia temporal al construir medidas de incertidumbre.

    Dynamic Factor Model

    Utiliza criterios de información de Bai y Ng para determinar el número de factores estáticos y posteriormente modela su evolución mediante un VAR.

    Topología informacional

    El módulo de PCA incorpora además análisis basados en entropía para caracterizar el contenido informativo de los componentes extraídos.

    La diferencia es importante. PCA ayuda a encontrar direcciones de máxima variación común. Un modelo factorial dinámico intenta además describir cómo evolucionan temporalmente esos factores.

    Segundo pilar: una serie no es una sola cosa

    Después de seleccionar variables o construir una señal compuesta aparece una nueva pregunta: ¿qué estructura interna tiene esa serie?

    Una observación temporal puede mezclar tendencia secular, oscilaciones de mediano plazo, ciclos rápidos y ruido. SignalY ofrece tres maneras metodológicamente diferentes de intentar separarlos.

    Wavelets: mirar el tiempo y la escala simultáneamente

    Una transformada de Fourier representa una señal mediante ondas sinusoidales que se extienden indefinidamente. Eso es extremadamente útil para identificar frecuencias, pero sacrifica localización temporal: sabemos qué frecuencia existe, pero no necesariamente cuándo aparece.

    Las wavelets utilizan oscilaciones localizadas. SignalY implementa la Maximal Overlap Discrete Wavelet Transform (MODWT) con wavelets de Daubechies.

    La descomposición produce componentes de detalle:

    $$ D_1,\;D_2,\;D_3,\;\ldots,\;D_J $$

    y una aproximación suave:

    $$ S_J. $$

    Los primeros niveles recogen variaciones relativamente rápidas; al avanzar hacia escalas mayores aparecen oscilaciones progresivamente más lentas. El componente suave representa la estructura de baja frecuencia.

    Una ventaja de MODWT es que no realiza downsampling: cada escala conserva la longitud temporal de la serie original.

    SignalY calcula además una descomposición de la varianza por escala. Esto permite preguntar si la dinámica de una serie está dominada por fluctuaciones rápidas, ciclos intermedios o movimiento de largo plazo.

    EMD: dejar que la propia serie decida cómo descomponerse

    La Empirical Mode Decomposition adopta una filosofía casi opuesta. En lugar de imponer una familia matemática de funciones base, construye los componentes directamente a partir de la geometría local de los datos.

    El algoritmo identifica máximos y mínimos locales, construye envolventes y aplica sucesivamente un procedimiento de sifting para extraer Intrinsic Mode Functions o IMFs.

    De forma esquemática:

    $$ x(t) = \sum_{k=1}^{K} \mathrm{IMF}_k(t) + r(t) $$

    donde $r(t)$ es el residuo o tendencia restante.

    Esto vuelve a EMD especialmente interesante cuando la serie es no estacionaria, no lineal o posee frecuencias que cambian con el tiempo.

    La flexibilidad tiene un costo. EMD puede ser sensible a efectos de borde y al llamado mode mixing, por lo que los componentes extraídos no deberían interpretarse mecánicamente.

    HP-GC: un Hodrick-Prescott donde $\lambda$ deja de ser una elección arbitraria

    El filtro Hodrick-Prescott tradicional es familiar para muchos macroeconomistas. También lo es una de sus críticas más recurrentes: el usuario tiene que escoger un parámetro de suavizado $\lambda$.

    La regla $\lambda=1600$ para datos trimestrales es famosa, pero sigue siendo una regla fijada externamente.

    SignalY incorpora el enfoque de componentes no observados de Grant y Chan, estimado mediante MCMC.

    La señal puede conceptualizarse como:

    $$ y_t = \tau_t + c_t + \varepsilon_t $$

    donde $\tau_t$ representa la tendencia y $c_t$ el ciclo. La tendencia se regula mediante sus segundas diferencias, mientras que el ciclo se modela como un proceso AR(2).

    La diferencia decisiva es que $\lambda$ se estima a partir de los datos mediante MCMC en lugar de fijarse manualmente.

    El resultado incluye distribuciones posteriores para tendencia, ciclo y residuo, de modo que la descomposición incorpora también incertidumbre.

    Tres filtros, una misma serie: ¿por qué no escoger simplemente el mejor?

    SignalY incluye filter_all(), que aplica wavelets, EMD y HP-GC a la misma serie y devuelve los resultados en un formato comparable.

    Esto es más que una comodidad de programación.

    La idea metodológica

    Si un componente aparece bajo varias descomposiciones con supuestos diferentes, tenemos más razones para considerarlo una propiedad robusta de la señal. Si aparece únicamente bajo un filtro, puede ser una característica dependiente del método.

    Wavelets parten de una base predeterminada. EMD deja que la descomposición sea guiada por los propios datos. HP-GC utiliza un modelo probabilístico de componentes no observados. No responden exactamente la misma pregunta y por eso compararlos puede resultar más informativo que declarar a uno universalmente superior.

    Tercer pilar: ¿la señal vuelve a su centro o se aleja indefinidamente?

    Extraer una tendencia o un ciclo no termina el análisis. Para modelar correctamente un componente necesitamos conocer su régimen de persistencia.

    Un proceso estacionario y un random walk pueden parecer similares en una muestra corta y, sin embargo, tienen propiedades estadísticas muy diferentes.

    Por eso SignalY ejecuta una batería de cuatro pruebas de raíz unitaria.

    Prueba Hipótesis nula Qué aporta
    ADF Existe raíz unitaria Es la prueba clásica de Dickey-Fuller aumentada y depende de la especificación de rezagos.
    Phillips-Perron Existe raíz unitaria Introduce una corrección no paramétrica frente a correlación serial y heterocedasticidad.
    KPSS La serie es estacionaria Invierte la hipótesis nula, lo que la hace especialmente útil como contraste de las pruebas anteriores.
    ERS Existe raíz unitaria La prueba Elliott-Rothenberg-Stock busca mayor potencia en alternativas cercanas a la unidad.

    Por qué cuatro pruebas pueden ser mejores que una

    El problema es que ninguna prueba individual es definitiva. ADF y Phillips-Perron pueden tener poca potencia cuando el proceso se encuentra muy cerca de una raíz unitaria.

    KPSS parte, en cambio, de la hipótesis nula opuesta. Esa asimetría permite utilizar los resultados conjuntamente.

    SignalY resume la evidencia con una lógica del tipo:

    Estacionaria

    ADF, PP o ERS ofrecen evidencia contra la raíz unitaria y KPSS no rechaza estacionariedad.

    Raíz unitaria

    Las pruebas con raíz unitaria como nula no logran rechazarla y KPSS sí rechaza la hipótesis de estacionariedad.

    Zona fronteriza

    Los resultados son mixtos o inconsistentes entre pruebas, sugiriendo un proceso potencialmente cercano a la unidad.

    Transparencia

    La clasificación automática no oculta las pruebas originales: estadísticas y valores p permanecen disponibles para inspección.

    El punto de unión: signal_analysis()

    Todos estos módulos pueden utilizarse de manera independiente, pero el diseño de SignalY cobra sentido cuando se encadenan.

    La función signal_analysis() funciona como orquestador:

    result <- signal_analysis(
      data = data,
      y_formula = Y ~ X1 + X2 + X3,
      methods = c(
        "wavelet",
        "emd",
        "pca",
        "dfm",
        "unitroot"
      ),
      verbose = TRUE
    )

    Una llamada puede combinar:

    • selección o reducción de columnas;
    • descubrimiento de factores;
    • descomposición temporal;
    • análisis de persistencia;
    • resúmenes y visualizaciones dentro de una estructura común.

    Los objetos resultantes incluyen métodos como print(), summary() y plot(), y las visualizaciones pueden mostrar perfiles de coeficientes, cargas de PCA, factores dinámicos y componentes de los filtros.

    ¿Cómo sabemos que los procedimientos recuperan lo que deberían?

    La documentación incluye experimentos sobre datos sintéticos con estructura verdadera conocida. Esto es importante: si sabemos de antemano qué variables, factores o ciclos generaron los datos, podemos medir qué tan bien los recupera cada método.

    Tarea sintética Método Resultado documentado
    Recuperar 3 factores latentes PCA / DFM Correlación $$r>0.95$$ y recuperación exacta del número de factores.
    Seleccionar 5 variables entre 50 Horseshoe $F1>0.85$ y precisión superior a $0.90$.
    Recuperar una tendencia logarítmica EMD Correlación $r>0.95$ con la tendencia verdadera.
    Extraer un ciclo multiescala Wavelet $D_3+D_4$ Correlación $r>0.70$ con el ciclo verdadero.
    Tendencia estocástica + ciclo AR(2) HP-GC bayesiano Tendencia $r>0.90$; ciclo $r>0.50$.
    Clasificación de estacionariedad Batería de raíz unitaria 4 de 4 casos sintéticos clasificados correctamente.
    Cómo interpretar estos números

    Son pruebas de recuperación sobre simulaciones. Demuestran que, bajo los escenarios sintéticos evaluados, los métodos pueden recuperar estructuras conocidas. No implican que la misma precisión esté garantizada en cualquier conjunto de datos del mundo real.

    ¿Quién puede sacar provecho de SignalY?

    Economistas

    Para paneles y sistemas multivariados donde interesa separar predictores relevantes, factores comunes, ciclos y tendencias antes de especificar modelos posteriores.

    Investigación cuantitativa

    Para finanzas, macroeconomía o economía política cuando existen conjuntos de predictores amplios y la selección ad hoc resulta difícil de justificar.

    Ciencia de datos

    Para señales no estacionarias, no lineales o multiescala donde se necesita algo más que una rutina puramente descriptiva de procesamiento digital.

    Un flujo mínimo

    La instalación y una primera ejecución pueden ser muy compactas:

    # Instalar desde GitHub
    remotes::install_github("IsadoreNabi/SignalY")
    
    library(SignalY)
    
    # Preparar un data frame
    data <- data.frame(
      Y = as.vector(Y),
      X
    )
    
    # Flujo mínimo
    result <- signal_analysis(
      data = data,
      y_formula = "Y",
      methods = c(
        "pca",
        "wavelet",
        "unitroot"
      )
    )
    
    plot(result)

    SignalY está distribuido bajo licencia MIT y está diseñado para trabajar con estructuras de datos habituales de R.

    La cuestión metodológica de fondo

    Ninguno de los elementos centrales de SignalY existe exclusivamente dentro del paquete. La Horseshoe tiene una literatura propia. PCA y los modelos factoriales dinámicos poseen décadas de desarrollo. MODWT, EMD, el filtro HP y las pruebas de raíz unitaria son herramientas establecidas.

    La propuesta está en cómo se conectan.

    Podemos comenzar con cincuenta variables, utilizar shrinkage para identificar aquellas que contienen mayor señal, descubrir después factores latentes comunes, descomponer la serie resultante en escalas temporales y, finalmente, preguntarnos si cada componente es estacionario o persistente.

    También podemos someter la misma serie a wavelets, EMD y HP-GC y observar qué estructuras aparecen bajo los tres enfoques.

    O podemos obtener factores dinámicos y estudiar después el régimen de persistencia de cada uno antes de utilizarlos en una etapa econométrica posterior.

    Ésa es la idea central de SignalY: la extracción de señal no debería entenderse como una colección de procedimientos aislados. Seleccionar variables cambia qué señal vemos; descomponerla cambia qué escalas estudiamos; y determinar su persistencia cambia qué modelos pueden ser apropiados después. El valor del paquete está en convertir esas decisiones sucesivas en un flujo coherente, comparable y reproducible.

    SignalY es desarrollado por José Mauricio Gómez Julián y se distribuye bajo licencia MIT. El código fuente, la documentación y la wiki están disponibles en GitHub.

  • EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Inferencia causal · Series temporales · Validación predictiva

    Una relación estadística no basta: cómo EconCausal intenta comprobar si sobrevivirá al futuro

    Un paquete de R que integra modelos de corrección de errores, regresión no lineal, series temporales estructurales bayesianas, errores autorregresivos y validación temporal dentro de un protocolo reproducible para evaluar relaciones causales en series temporales.

    EconCausal · R · Econometría aplicada · GitHub

    Encontramos una relación en nuestros datos. Es estadísticamente significativa. Los coeficientes parecen razonables. Tal vez incluso encaje perfectamente con la teoría. Pero todavía queda una pregunta incómoda: ¿seguirá apareciendo dentro de seis meses, cuando el modelo tenga que enfrentarse a datos que aún no existen?

    Esta pregunta es especialmente importante en economía. Las relaciones temporales que parecen sólidas dentro de una muestra pueden desaparecer cuando cambia el régimen macroeconómico, cuando llega una crisis o, sencillamente, cuando el modelo deja de describir el pasado y tiene que predecir el futuro.

    EconCausal fue construido alrededor de ese problema. Su objetivo no es ofrecer un nuevo botón que convierta correlaciones en causalidad, sino imponer un procedimiento más exigente: preanalizar los datos, estimar la relación desde varios marcos metodológicos y obligarla a sobrevivir a pruebas temporales antes de aceptarla.

    La idea en una frase

    EconCausal funciona como una especie de línea de control de calidad para afirmaciones causales en series temporales: una relación candidata debe superar una secuencia explícita de pruebas antes de recibir luz verde.

    El problema: correlación hoy no significa estabilidad mañana

    Una regresión convencional puede indicarnos que dos variables se mueven juntas. Pero una covariación estadística no nos dice automáticamente por qué ocurre, en qué dirección opera la relación ni si seguirá apareciendo cuando cambien las condiciones económicas.

    En series temporales existe además una dificultad adicional: las observaciones no son intercambiables. El año 2020 viene después de 2019. El trimestre siguiente depende, en mayor o menor medida, de la historia anterior. Ignorar esta estructura puede generar resultados que parecen mucho más robustos de lo que realmente son.

    EconCausal aborda el problema combinando tres marcos metodológicos distintos. Ninguno de ellos pretende monopolizar el significado de causalidad; la idea es obtener perspectivas complementarias sobre una misma relación.

    ECM-MARS

    Combina corrección de errores y cointegración con Multivariate Adaptive Regression Splines para capturar ajustes no lineales entre equilibrio de largo plazo y dinámica de corto plazo.

    BSTS

    Descompone la serie en componentes estructurales dentro de un marco bayesiano y permite construir distribuciones contrafactuales y pronósticos con incertidumbre explícita.

    BGLM-AR(1)

    Ajusta un modelo lineal generalizado bayesiano mientras representa explícitamente la dependencia temporal de los errores mediante una estructura autorregresiva de primer orden.

    Primera vía: ECM-MARS y la diferencia entre corto y largo plazo

    Muchas variables económicas pueden alejarse entre sí durante períodos relativamente cortos y, sin embargo, mantener una relación de equilibrio a largo plazo.

    Ésta es precisamente la intuición detrás de un Modelo de Corrección de Errores o ECM. Si dos variables están cointegradas, sus movimientos de corto plazo pueden desviarse, pero existe alguna fuerza de ajuste que impide que esa divergencia crezca indefinidamente.

    En su forma conceptual más sencilla, podemos imaginar:

    $$ \Delta Y_t = \alpha + \lambda \left( Y_{t-1} – \beta X_{t-1} \right) + \gamma \Delta X_t + \varepsilon_t $$

    El término entre paréntesis representa el desequilibrio acumulado respecto de la relación de largo plazo. El parámetro $\lambda$ refleja la velocidad con la que el sistema responde a ese desequilibrio.

    El problema es que la respuesta real puede no ser lineal. Una economía podría tolerar pequeñas desviaciones durante bastante tiempo y reaccionar bruscamente cuando se cruza cierto umbral.

    Ahí aparece MARS —Multivariate Adaptive Regression Splines—. En lugar de obligar al ajuste a seguir una única pendiente lineal, MARS puede encontrar automáticamente regiones y umbrales donde la dinámica cambia.

    Intuición

    ECM aporta la arquitectura económica del equilibrio de largo plazo y la corrección de corto plazo; MARS permite que el mecanismo de ajuste sea flexible y potencialmente no lineal.

    Antes de estimar, hay que demostrar que el problema está bien planteado

    EconCausal no lanza automáticamente un ECM sobre cualquier par de series. Antes, el protocolo comprueba las condiciones que justifican un análisis de cointegración.

    Comprueba si las variables son integradas de orden uno, $I(1)$, condición previa para el análisis de cointegración utilizado por este procedimiento.

    Ejecuta las pruebas de cointegración de Engle-Granger y Johansen.

    Aplica una regla de tipo either: si cualquiera de las dos pruebas proporciona evidencia suficiente de cointegración, el análisis puede continuar.

    Controla correlación serial y heterocedasticidad mediante errores estándar consistentes HAC.

    Ajusta el ECM utilizando MARS como motor de regresión.

    Somete posteriormente la relación a validación temporal mediante ventanas de origen móvil.

    La utilización conjunta de Engle-Granger y Johansen es deliberada. Engle-Granger es relativamente directo, mientras que Johansen puede manejar estructuras de cointegración más ricas en contextos multivariados. El protocolo prefiere utilizar ambas perspectivas en lugar de hacer depender todo el análisis de una sola prueba.

    Segunda vía: BSTS y el contrafactual

    La segunda familia metodológica cambia la pregunta. En lugar de concentrarse primero en cointegración y corrección de errores, un modelo de Bayesian Structural Time Series representa la serie como un sistema de componentes estructurales.

    Conceptualmente, podemos pensar en una descomposición como:

    $$ Y_t = \mu_t + \tau_t + \mathbf{x}_t^{\top}\boldsymbol{\beta} + \varepsilon_t $$

    donde $\mu_t$ puede representar el nivel o tendencia, $\tau_t$ algún componente temporal adicional y $\mathbf{x}_t^{\top}\boldsymbol{\beta}$ el efecto de variables predictoras.

    Esta representación resulta especialmente útil para inferencia causal cuando queremos formular una pregunta contrafactual: ¿qué habría ocurrido con la variable analizada si una intervención o cambio determinado no hubiese sucedido?

    EconCausal incorpora además priors spike-and-slab, que realizan selección probabilística de variables. En lugar de incluir automáticamente todos los predictores o eliminarlos mediante procedimientos stepwise, el modelo estima qué variables tienen mayor probabilidad de pertenecer a la estructura predictiva.

    Al ser bayesiano, el resultado no es solamente una predicción puntual. Se obtiene una distribución posterior, lo que permite expresar explícitamente la incertidumbre asociada al contrafactual.

    Tercera vía: BGLM-AR(1) y el problema de los errores que recuerdan el pasado

    Uno de los errores más comunes en econometría aplicada consiste en estimar una regresión como si los residuos de un período no tuviesen ninguna relación con los del período anterior.

    En muchos procesos económicos esto es poco plausible.

    EconCausal incorpora por ello un Bayesian Generalized Linear Model con errores AR(1). Una representación básica de la estructura residual es:

    $$ \varepsilon_t = \rho\varepsilon_{t-1} + \eta_t, \qquad |\rho|<1 $$

    Si $\rho$ es distinto de cero, parte del error actual está relacionado con el error del período anterior.

    Ignorar esa dependencia puede generar intervalos excesivamente estrechos y una falsa sensación de precisión. Modelarla explícitamente permite que la incertidumbre estadística refleje mejor la estructura temporal de los datos.

    La estimación se realiza mediante Hamiltonian Monte Carlo a través de Stan, con priors débilmente informativas calibradas para variables estandarizadas.

    La regla que hace distinto al protocolo: no basta con mejorar una sola métrica

    Uno de los elementos centrales de EconCausal es su criterio dual de evaluación.

    Una relación candidata no se considera respaldada simplemente porque obtenga mejores predicciones puntuales, ni porque mejore la distribución predictiva. Debe mejorar simultáneamente ambas dimensiones.

    1. Densidad predictiva — ELPD

    Se evalúa la calidad de la distribución predictiva mediante Expected Log Predictive Density, utilizando PSIS-LOO cuando corresponde.

    2. Precisión puntual — RMSE

    También debe mejorar la precisión de los pronósticos puntuales, evaluada mediante Root Mean Squared Error.

    Esto importa porque ambos criterios responden preguntas distintas. Un modelo podría reducir el RMSE y, al mismo tiempo, producir una distribución de incertidumbre peor calibrada. Otro podría representar muy bien la incertidumbre, pero producir predicciones centrales peores.

    EconCausal exige superar ambos filtros.

    La prueba decisiva: dejar que el futuro haga de árbitro

    El rasgo más característico del protocolo aparece en la validación. Una relación temporal no se considera estable porque haya funcionado en una única partición de entrenamiento y prueba.

    El paquete utiliza validación Leave-Future-Out con ventanas y horizontes configurables.

    La lógica es:

    $$ \underbrace{ y_1,\ldots,y_t }_{\text{entrenamiento}} \quad\longrightarrow\quad \underbrace{ y_{t+1},\ldots,y_{t+h} }_{\text{futuro}} $$

    Después el punto de corte avanza y el proceso se repite:

    Se entrena utilizando únicamente información disponible hasta cierto momento.

    Se pronostican observaciones estrictamente posteriores.

    Se calcula el desempeño predictivo.

    La frontera temporal avanza.

    El procedimiento se repite en múltiples ventanas.

    El resultado incluye una medida de soporte temporal: la proporción de ventanas en las que la relación continúa satisfaciendo los criterios establecidos.

    Por qué esto importa

    Una relación que funciona magníficamente en una única ventana puede ser casualidad. Una relación que reaparece sistemáticamente cuando el modelo debe predecir distintos segmentos futuros ofrece una evidencia mucho más difícil de atribuir a una partición afortunada de la muestra.

    Menos libertad invisible para el investigador

    Buena parte del análisis aplicado contiene decisiones que el lector nunca llega a observar: qué transformación se probó primero, qué ventana se descartó, qué modelo alternativo se abandonó, qué umbral se modificó después de mirar los resultados.

    Este problema suele describirse como researcher degrees of freedom.

    EconCausal intenta reducirlos mediante un protocolo explícito: prepruebas, reglas de aceptación, umbrales y procedimientos de validación están integrados dentro del mismo flujo reproducible.

    Esto no elimina el juicio científico. Pero vuelve más visible qué reglas condujeron desde los datos hasta la conclusión.

    ¿Dónde está la novedad?

    No en inventar desde cero Engle-Granger, Johansen, MARS, BSTS, modelos AR(1), Stan, PSIS-LOO o validación temporal.

    Todas estas herramientas tienen antecedentes bien establecidos.

    Según una evaluación de novedad incluida en la documentación del paquete, la contribución reside en la combinación de esos componentes dentro de un protocolo end-to-end concreto, con prepruebas, reglas duales de decisión, umbrales de soporte y validación temporal.

    Esa distinción es importante: la afirmación metodológica no es “hemos inventado nuevas matemáticas”, sino “hemos convertido varias técnicas existentes en un procedimiento único, explícito y auditable”.

    ¿Quién podría utilizar EconCausal?

    Aunque el paquete fue desarrollado inicialmente para investigación económica, el problema que intenta resolver es mucho más general: relaciones direccionales entre variables observadas a lo largo del tiempo.

    Macroeconomía

    Para estudiar relaciones entre producción, precios, salarios, inversión, crédito, empleo u otras variables con dinámica temporal.

    Política pública

    Para evaluar si una relación asociada a una intervención permanece estable bajo distintos contextos económicos.

    Finanzas

    Para diferenciar una asociación histórica aparente de una relación que mantiene capacidad predictiva fuera de muestra.

    También puede servir como herramienta pedagógica para estudiantes de econometría e inferencia causal, precisamente porque obliga a recorrer etapas que en un análisis manual resultan fáciles de omitir.

    Instalación

    El paquete puede instalarse directamente desde GitHub:

    # Instalar desde GitHub
    remotes::install_github("IsadoreNabi/EconCausal")
    
    # En Windows, si falla la construcción de las viñetas:
    remotes::install_github(
      "IsadoreNabi/EconCausal",
      build_vignettes = FALSE
    )

    EconCausal utiliza una infraestructura bayesiana moderna, incluyendo cmdstanr para muestreo HMC, loo para cálculos PSIS-LOO y bsts para los componentes de series temporales estructurales.

    Lo que EconCausal no puede hacer por vos

    Un protocolo riguroso no convierte datos pobres en datos excelentes.

    Si la muestra es demasiado pequeña, las variables contienen errores de medición importantes o existen rupturas estructurales tan fuertes que destruyen la relación estudiada, ningún paquete estadístico puede eliminar mágicamente esas limitaciones.

    Tampoco sustituye el conocimiento del dominio.

    Que una relación sea estable, direccional y predictivamente robusta es una evidencia importante, pero una interpretación causal todavía necesita un mecanismo teórico, una consideración seria de variables confusoras y una evaluación de los supuestos identificadores.

    Límite fundamental

    EconCausal intenta disciplinar la inferencia estadística. No puede decidir por sí solo qué mecanismo causal existe en el mundo real.

    La cuestión de fondo

    En análisis temporal es relativamente fácil encontrar relaciones que describen bien el pasado. Lo difícil es encontrar relaciones que permanezcan cuando llega información nueva.

    EconCausal desplaza por ello parte del énfasis metodológico desde “¿obtuvimos significancia?” hacia una pregunta más dura: “¿esta relación sigue funcionando cuando le pedimos que sobreviva fuera de la muestra donde la descubrimos?”

    Esa diferencia puede parecer pequeña, pero cambia la filosofía del análisis. La significancia estadística deja de ser la meta final y se convierte apenas en una pieza dentro de una cadena de validación mucho más amplia.

    La contribución de EconCausal está en el protocolo. ECM-MARS, BSTS, modelos bayesianos con errores AR(1), HMC, PSIS-LOO, RMSE y validación Leave-Future-Out ya pertenecen al repertorio de la econometría moderna. Lo distintivo es obligarlos a trabajar juntos bajo reglas explícitas y reproducibles, de modo que una relación no sea aceptada porque se vea convincente en una muestra, sino porque resista una batería organizada de pruebas y mantenga apoyo cuando se enfrenta al futuro.

    EconCausal está disponible en GitHub. Las metodologías subyacentes se apoyan, entre otros trabajos, en Engle & Granger (1987), Johansen (1991), Friedman (1991), Scott & Varian (2014), Vehtari et al. (2017) y Hyndman & Athanasopoulos (2021).

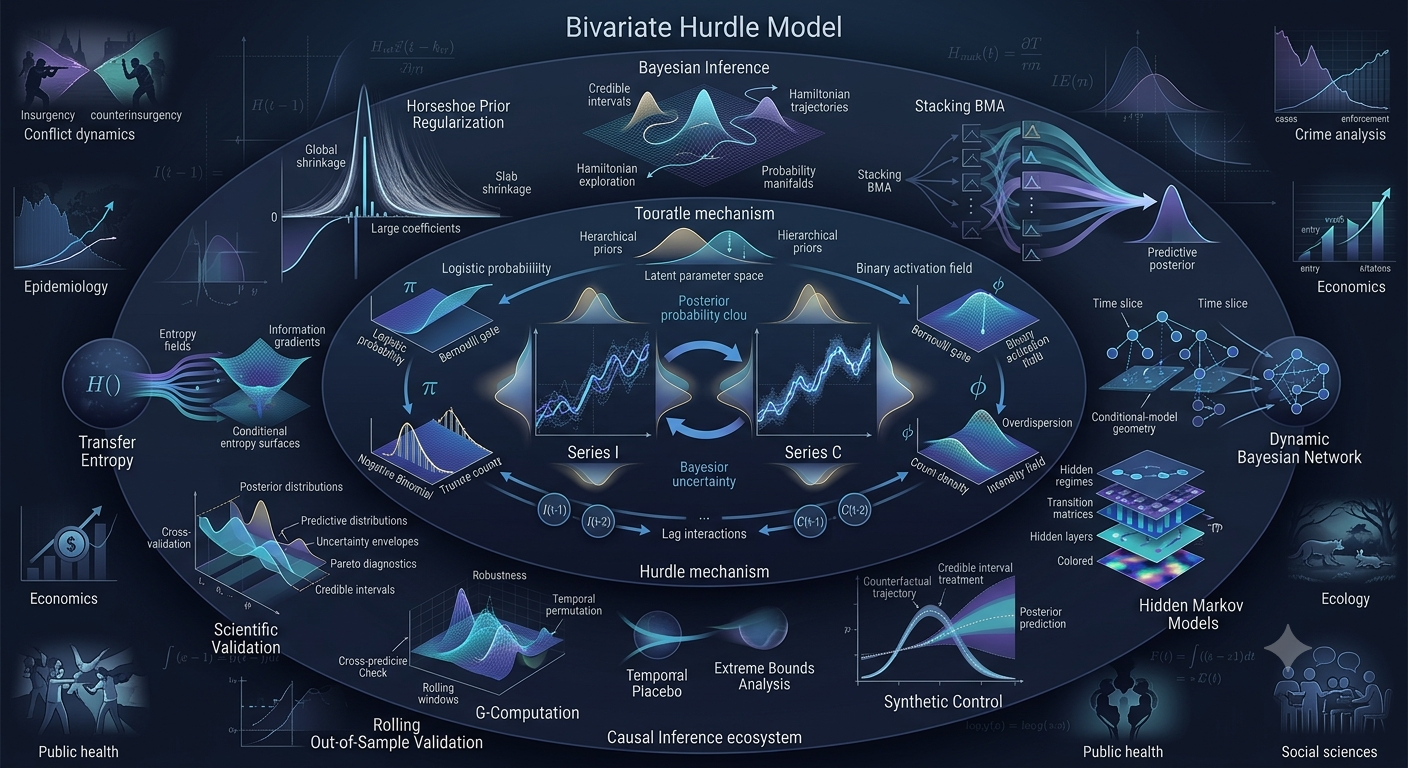
  • bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

    bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

    También puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Estadística bayesiana · Series temporales · Inferencia causal

    Cuando dos series tienen demasiados ceros: una introducción a bivarhr

    Un paquete de R que combina modelos hurdle bivariados, regularización horseshoe, comparación predictiva y múltiples estrategias de inferencia causal para uno de esos problemas que parecen sencillos hasta que uno intenta analizarlos de verdad.

    Por José Mauricio Gómez Julián · CRAN · GitHub

    Imaginemos que queremos estudiar dos procesos que evolucionan juntos en el tiempo. Podrían ser ataques insurgentes y operaciones contrainsurgentes, casos de una enfermedad y muertes asociadas, protestas y respuestas del gobierno, entradas y salidas de empresas o cualquier otro par de fenómenos registrados como conteos.

    Hasta aquí nada parece especialmente extraño. Tenemos series temporales, tenemos conteos y tenemos una considerable caja de herramientas estadística. El problema comienza cuando los datos se parecen más al mundo real que a los ejemplos de un manual.

    Puede ocurrir que durante la mayor parte del tiempo no suceda absolutamente nada: cero ataques, cero protestas, cero extinciones, cero nuevos casos. Después, cuando finalmente ocurre algo, el número observado puede variar enormemente. A eso se suma otra dificultad: las dos series pueden influenciarse predictivamente entre sí con rezagos, mientras docenas de variables adicionales compiten por entrar en el modelo.

    bivarhr fue diseñado precisamente para trabajar en ese cruce de problemas.

    La idea en una frase

    En lugar de tratar por separado el exceso de ceros, la dinámica entre ambas series, la selección de variables, la incertidumbre sobre el modelo y la evidencia causal, bivarhr intenta integrarlos dentro de un único flujo de análisis reproducible.

    Primero: ¿por qué tantos ceros son un problema?

    Un modelo de Poisson convencional presupone una estructura relativamente simple para los conteos. La distribución binomial negativa permite mayor dispersión y suele funcionar mejor cuando la variabilidad excede lo que admitiría un Poisson.

    Pero ninguna de esas decisiones resuelve automáticamente un conjunto de datos en el que, por ejemplo, el 60 %, 70 % u 80 % de las observaciones son exactamente cero.

    Un modelo hurdle aborda el problema dividiéndolo conceptualmente en dos mecanismos.

    1. Primero pregunta si el proceso logra cruzar el “obstáculo”: ¿ocurrió algo o el resultado fue cero?
    2. Solamente después, condicionando a que ocurrió algo, pregunta: ¿cuánto ocurrió?

    La primera parte puede modelarse mediante una distribución Bernoulli con enlace logit. La segunda, en bivarhr, mediante una binomial negativa truncada en cero.

    Formalmente, para una de las series \(I\) en el instante \(t\):

    \[ P(Y_{I,t}=0)=1-\pi_{I,t} \]

    mientras que, para un conteo positivo,

    \[ P(Y_{I,t}=y\mid y>0) = \pi_{I,t} \frac{ f_{\mathrm{NB}}(y\mid\mu_{I,t},\phi_I) }{ 1-f_{\mathrm{NB}}(0\mid\mu_{I,t},\phi_I) } \]

    Aquí, \(\pi_{I,t}\) representa la probabilidad de observar un valor distinto de cero, \(\mu_{I,t}\) controla el conteo esperado una vez superado el hurdle y \(\phi_I\) gobierna la dispersión.

    Esta separación es importante. El proceso que determina si sucede algo no tiene por qué ser el mismo que determina la intensidad de lo que sucede.

    ¿Y qué aporta que el modelo sea bivariado?

    Supongamos que llamamos \(I\) y \(C\) a nuestras dos series. Analizarlas por separado perdería precisamente una de las preguntas más interesantes: ¿contiene el pasado de una información útil para predecir el futuro de la otra?

    bivarhr permite introducir valores rezagados de \(C\) en la ecuación correspondiente a \(I\), valores rezagados de \(I\) en la de \(C\), ambas cosas simultáneamente o ninguna.

    Especificación C → I I → C Lectura
    A Sí No C contiene información predictiva rezagada sobre I
    B No Sí I contiene información predictiva rezagada sobre C
    C Sí Sí Dinámica predictiva bidireccional
    D No No Sin efectos cruzados rezagados

    Esta comparación permite estudiar causalidad en el sentido de Granger: si conocer el pasado de una variable mejora sistemáticamente la predicción de otra una vez considerada la información pertinente.

    Una distinción importante

    La causalidad de Granger es una afirmación sobre precedencia e información predictiva. No equivale, por sí sola, a demostrar una relación causal estructural. Precisamente por eso bivarhr no termina el análisis en los rezagos cruzados: incorpora otras herramientas que permiten contrastar la misma hipótesis desde ángulos diferentes.

    Muchos predictores, pocos datos: el papel del horseshoe

    Imaginemos ahora que, además de ambas series, disponemos de indicadores económicos, variables institucionales, condiciones climáticas, tendencias, cambios de régimen y distintas transformaciones de cada una.

    El número de parámetros puede crecer rápidamente. Con una muestra relativamente pequeña, un modelo suficientemente flexible puede terminar aprendiendo ruido.

    Para enfrentarse a este problema, bivarhr utiliza la prior horseshoe regularizada.

    La intuición es sencilla aunque su formulación matemática sea más rica: los coeficientes que no encuentran suficiente respaldo en los datos son fuertemente contraídos hacia cero, mientras que las señales verdaderamente importantes pueden escapar de esa contracción.

    El mecanismo combina un parámetro global de contracción, \(\tau\), que controla el nivel general de esparsidad, con parámetros locales \(\lambda_j\), capaces de adaptarse a cada coeficiente. La versión regularizada empleada por el paquete sigue el enfoque de Piironen y Vehtari y limita además comportamientos excesivamente extremos de los coeficientes.

    En términos prácticos, esto significa que el investigador no necesita convertir la selección manual de variables en una sucesión interminable de decisiones ad hoc.

    El problema que viene después: ¿qué modelo elegimos?

    Incluso después de definir la estructura general, queda una decisión incómoda. ¿Cuántos rezagos deberíamos utilizar? ¿Uno? ¿Dos? ¿Tres? ¿Qué grado de regularización es apropiado?

    La respuesta habitual consiste en escoger el modelo que obtiene el mejor valor de algún criterio y descartar los demás.

    bivarhr sigue otra filosofía. Combina modelos mediante predictive stacking, asignándoles pesos según su capacidad predictiva.

    \[ p_{\mathrm{stack}}(y_t) = \sum_{m=1}^{M} w_m\, p(y_t\mid y_{1:t-1},\mathcal{M}_m) \]

    Los pesos se estiman buscando maximizar la densidad logarítmica predictiva esperada —ELPD—, evaluada mediante PSIS-LOO. En términos menos técnicos: los modelos que predicen mejor reciben más influencia y los que predicen peor reciben menos.

    El resultado evita hacer depender toda la inferencia de una única decisión sobre el número exacto de rezagos o sobre un solo conjunto de hiperparámetros.

    De la predicción a la causalidad: buscar evidencia convergente

    Probablemente éste sea el aspecto más ambicioso del paquete. bivarhr no propone que un único procedimiento estadístico resuelva automáticamente el problema de la causalidad. En su lugar, proporciona varias herramientas complementarias.

    Entropía de transferencia

    Pregunta cuánto reduce el pasado de una serie nuestra incertidumbre acerca de la otra, más allá de la información contenida en su propio pasado. A diferencia del Granger lineal tradicional, procede desde la teoría de la información.

    Redes Bayesianas Dinámicas

    Buscan aprender relaciones dirigidas entre variables situadas en distintos momentos, permitiendo distinguir conexiones directas de estructuras mediadas por otras variables.

    Modelos Ocultos de Markov

    Permiten investigar si ambas series parecen estar gobernadas por estados latentes, como períodos de calma, transición o escalada que no fueron etiquetados previamente.

    VARX

    Aporta una comprobación desde la tradición clásica de series temporales, incluyendo diagnósticos de estabilidad, autocorrelación, normalidad y efectos ARCH.

    Análisis de sensibilidad

    Siguiendo a Cinelli y Hazlett, cuantifica cuán potente tendría que ser un confusor no observado para explicar un efecto estimado.

    Control sintético

    Mediante series temporales estructurales bayesianas puede construir un escenario contrafactual y comparar lo observado con lo que habría ocurrido en ausencia de una intervención.

    Ninguno de estos métodos convierte mágicamente una asociación en causalidad. Su utilidad reside en otra cosa: permiten preguntar si una conclusión sobrevive cuando el mismo problema se examina mediante representaciones y supuestos diferentes.

    Un resultado no vale mucho si desaparece al tocar el modelo

    Una parte importante de bivarhr está dedicada no a producir resultados nuevos, sino a intentar destruir los resultados que ya obtuvimos.

    Ésa es una virtud.

    Placebos temporales

    Si se altera aleatoriamente el orden temporal de los datos y el modelo continúa funcionando igual de bien, existe un problema: quizá no estaba aprendiendo realmente la dinámica temporal.

    Evaluación fuera de muestra

    El paquete permite ajustar modelos en fracciones sucesivas de la muestra y evaluar sus pronósticos sobre las observaciones restantes. En lugar de preguntar solamente qué tan bien describe el modelo los datos conocidos, preguntamos qué tan bien funciona cuando tiene que enfrentarse a datos que no utilizó para estimarse.

    Análisis de límites extremos

    También puede reestimarse el modelo bajo distintas combinaciones de controles. Si un resultado fundamental cambia de signo o desaparece cada vez que modificamos ligeramente la especificación, tenemos razones para desconfiar de su robustez.

    G-computation

    Finalmente, la simulación posterior permite construir cantidades contrafactuales del tipo: ¿cómo cambiaría \(I\) si elimináramos determinados rezagos cruzados o variables de transición? Así es posible expresar los resultados en términos de efectos promedio del tratamiento bajo la especificación causal adoptada.

    ¿En qué campos puede resultar útil?

    El paquete nació alrededor de un problema estadístico, no de una disciplina particular. Por eso su campo potencial de aplicación es amplio.

    Campo Ejemplos de pares de procesos
    Salud pública Casos y mortalidad; hospitalizaciones y reingresos; vacunación y brotes.
    Criminología Delitos y respuestas policiales; incautaciones y sobredosis.
    Economía Entradas y salidas de empresas; patentes y citas; determinados conteos asociados a flujos comerciales.
    Ecología Depredadores y presas; aparición y desaparición de especies; colonización y extinción local.
    Ciencia política Protestas y respuestas gubernamentales; iniciativas legislativas y vetos.
    Entornos digitales Publicaciones de desinformación y actividad posterior de verificación.

    ¿Qué ocurre bajo el capó?

    Aunque el objetivo del paquete es ofrecer un flujo integrado, la infraestructura estadística es plenamente bayesiana allí donde se ajusta el modelo hurdle principal.

    Componente Implementación
    Muestreo Stan NUTS mediante cmdstanr
    Regularización Horseshoe regularizado
    Evaluación predictiva PSIS-LOO y ELPD
    Combinación de modelos Pesos de predictive stacking
    Convergencia \(\hat{R}\), ESS y divergencias
    Diagnóstico LOO Valores de Pareto \(k\)

    El código Stan tampoco constituye una caja negra: puede inspeccionarse mediante get_hurdle_model(), mientras que las cantidades generadas permiten obtener log-verosimilitudes por observación, predicciones posteriores y valores ajustados.

    Empezar a utilizar bivarhr

    El paquete puede instalarse desde GitHub, mientras que también dispone de distribución a través de CRAN.

    # Instalación desde GitHub
    devtools::install_github("isadorenabi/bivarhr")
    
    # Instalar cmdstanr
    install.packages(
      "cmdstanr",
      repos = c(
        "https://stan-dev.r-universe.dev",
        getOption("repos")
      )
    )
    
    cmdstanr::install_cmdstan()
    
    # Paquetes opcionales para el conjunto completo
    # de herramientas causales
    install.packages(c(
      "RTransferEntropy",
      "bnlearn",
      "sensemakr",
      "CausalImpact",
      "vars",
      "openxlsx"
    ))

    Un ajuste mínimo con dos rezagos y efectos cruzados en ambas direcciones puede escribirse de forma compacta:

    fit <- fit_one(
      DT,
      k = 2,
      spec = "C",
      iter_warmup = 500,
      iter_sampling = 500,
      chains = 2
    )
    
    print(fit$fit$summary())

    Si queremos comparar múltiples órdenes de rezago y configuraciones de la prior horseshoe, podemos construir una cuadrícula y dejar que el procedimiento de selección y stacking evalúe el conjunto:

    hs_grid <- expand.grid(
      hs_tau0 = c(0.1, 0.5, 1.0),
      hs_slab_scale = c(1, 5),
      hs_slab_df = 4
    )
    
    bma_results <- select_by_bma(
      DT = DT,
      spec = "C",
      k_grid = 0:3,
      hs_grid = hs_grid,
      iter_warmup = 1000,
      iter_sampling = 1200,
      chains = 4,
      use_parallel = TRUE
    )
    
    print(bma_results$table)

    El punto más interesante no es un modelo: es el flujo de trabajo

    Es fácil describir bivarhr enumerando sus piezas: binomial negativa hurdle, horseshoe, Stan, PSIS-LOO, stacking, entropía de transferencia, redes bayesianas, modelos de Markov, VARX y análisis contrafactual.

    Pero hacer solamente esa lista oculta lo más interesante del proyecto.

    Prácticamente ninguno de esos métodos existe únicamente dentro de bivarhr. Lo particular es su intento de reunirlos alrededor de una secuencia coherente de preguntas.

    ¿Los ceros forman parte central del proceso? Entonces hay que modelarlos explícitamente. ¿Las dos variables evolucionan conjuntamente? Entonces no conviene estimarlas como mundos separados. ¿Hay demasiados predictores? Regularicemos. ¿No sabemos qué especificación elegir? Incorporémoslo a la incertidumbre predictiva. ¿Queremos hablar de causalidad? No dependamos de una única evidencia. ¿Encontramos un efecto? Intentemos romperlo con placebos, cambios de especificación y evaluación fuera de muestra.

    Ésa es, en última instancia, la apuesta de bivarhr: que la solidez de una investigación aplicada no depende únicamente de utilizar una técnica estadística sofisticada, sino de construir un camino reproducible desde los datos hasta la conclusión y someter cada tramo de ese camino a comprobaciones independientes.

    bivarhr es software de código abierto distribuido bajo licencia MIT. Disponible en CRAN y GitHub. Autor: José Mauricio Gómez Julián · ORCID.

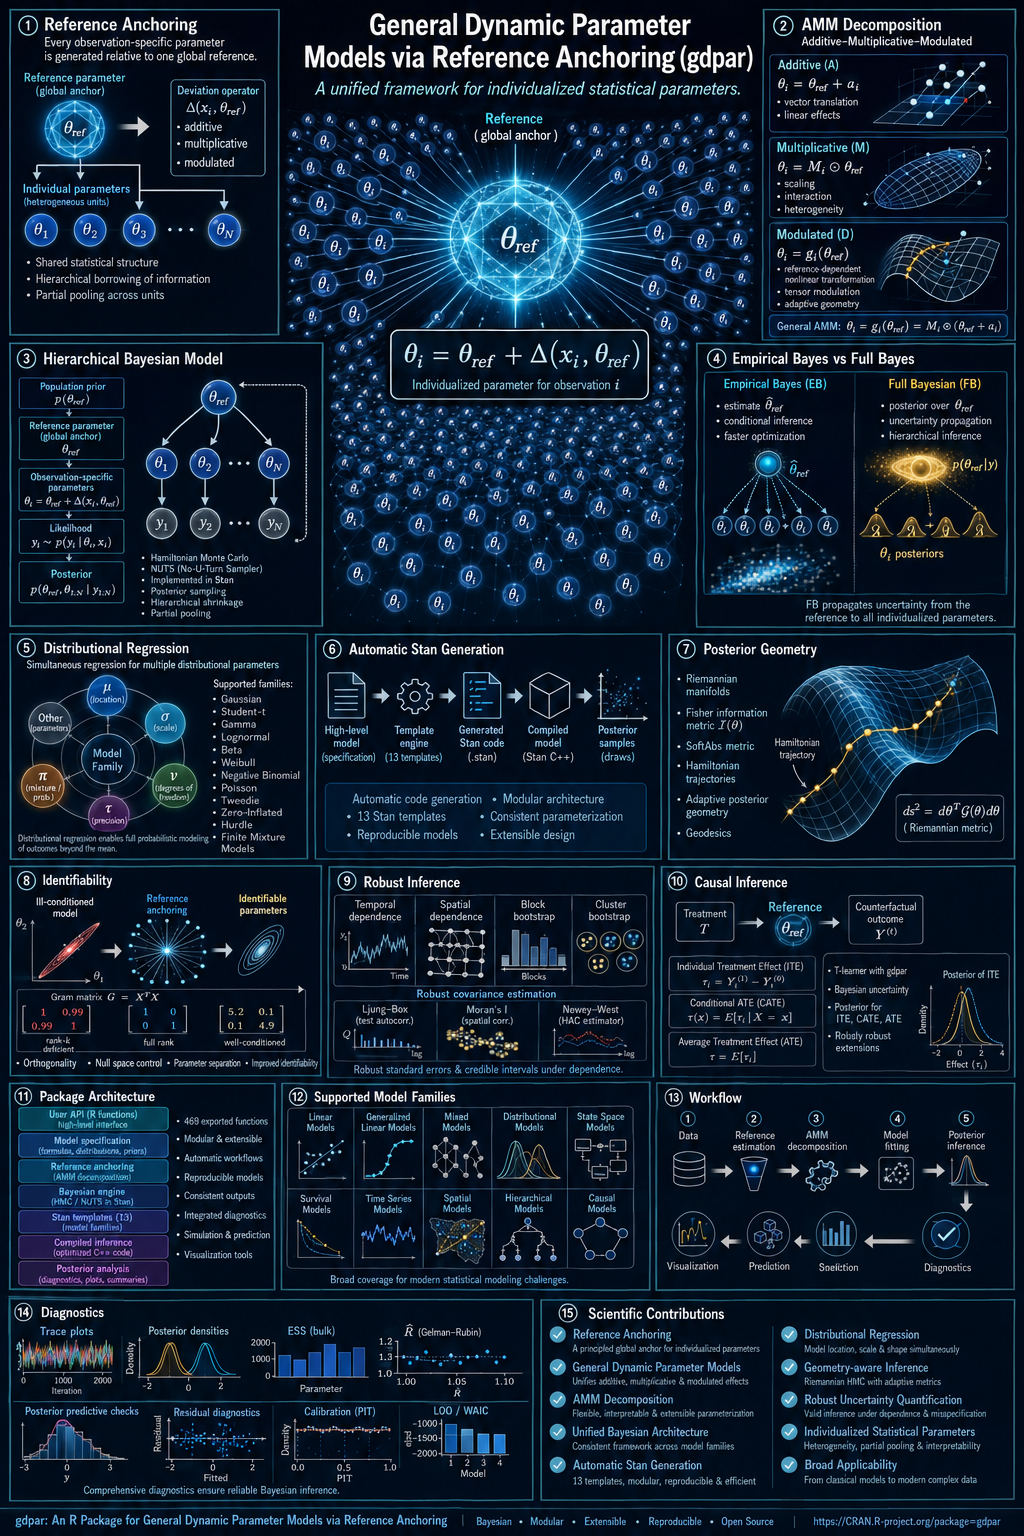
  • Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Pueden encontrar esta librería y su documentación en CRAN y descargargla directamente desde R y RStudio.

    Además, también les recomendamos echarle un ojo al mapa mental resumen al final de este artículo para entender mejor la relación entre las funciones del paquete.

    Reseña de biblioteca de R

    Conoce gdpar

    Modelos de Parámetros Dinámicos Generales mediante Anclaje de Referencia

    En el cálculo fugaz de una decisión de dos segundos —adelantar un automóvil en una carretera estrecha— el cerebro humano realiza un notable truco estadístico. No construye desde cero un modelo del conductor que se aproxima. En su lugar, recupera una referencia de base: el conductor promedio, que representa tiempos de reacción típicos y un nivel modal de agresividad. En una fracción de segundo, interpreta las señales específicas del conductor real —velocidad relativa, tipo de vehículo, micromovimientos— y estima en qué medida este conductor específico se desvía de la referencia. La decisión de adelantar surge de esa síntesis.

    Esta receta cognitiva —referencia poblacional + desviación individual— constituye el fundamento filosófico del paquete de R gdpar (General Dynamic Parameter models via Reference Anchoring) de José Mauricio Gómez Julián. El paquete toma esta intuición, la formaliza como una descomposición estadística rigurosa, demuestra las condiciones bajo las cuales es matemáticamente identificable, proporciona un motor bayesiano basado en Stan para estimarla y añade capas de inferencia causal, muestreo adaptativo a la geometría e inferencia robusta frente a la dependencia.

    ❦

    La anatomía de la desviación

    Cada capa de gdpar constituye una elaboración de una única y elegante ecuación. Para cada observación $i$ con covariables $x_i$:

    $$ \theta_i \;=\; \theta_{\text{ref}} \;+\; \Delta(x_i,\; \theta_{\text{ref}}) $$

    Se lee así: el parámetro del individuo $i$ es igual a una referencia poblacional, más una desviación que es, a su vez, función de las covariables del individuo y de la propia referencia.

    Es en esa última cláusula donde la arquitectura se aparta de la estadística clásica. La desviación $\Delta$ no depende únicamente de quién sos (tus covariables $x_i$); depende de cuál es la referencia. Si trasladás el modelo a una nueva población, la función de desviación se comporta de manera diferente porque $\theta_{\text{ref}}$ es uno de sus argumentos. Esta dependencia estructural es la característica definitoria del «anclaje de referencia». Distingue a gdpar de los modelos de efectos aleatorios o de coeficientes variables, en los cuales la desviación está estructuralmente separada de la referencia.

    Entonces, ¿qué forma tiene $\Delta$? El paquete distingue una forma funcional específica denominada descomposición Aditiva–Multiplicativa–Modulada (AMM):

    $$ \Delta(x,\theta_{\text{ref}}) \;=\; \underbrace{a(x)}_{\text{aditiva}} \;+\; \underbrace{b(x)\odot\theta_{\text{ref}}}_{\text{multiplicativa}} \;+\; \underbrace{W(\theta_{\text{ref}})\,x}_{\text{modulada}} $$

    Tres mecanismos, claramente separados e interpretables de forma independiente:

    • $a(x)$ — Un desplazamiento puramente aditivo. Puede pensarse como un efecto fijo tradicional determinado por covariables.
    • $b(x)\odot\theta_{\text{ref}}$ — Un escalamiento de la referencia dependiente de las covariables (mediante el producto de Hadamard o producto elemento a elemento). Aquí es donde «la desviación depende de la referencia» entra de manera multiplicativa.
    • $W(\theta_{\text{ref}})\,x$ — Las covariables se combinan mediante una matriz $W$ que, a su vez, está ajustada por la referencia. Este es el canal explícito y estructuralmente dependiente de la referencia.

    Los modelos estándar aparecen como casos particulares. Si se establece $\Delta \equiv 0$, se obtiene una regresión de efectos fijos. Si se establece $W \equiv 0$, se obtiene un modelo jerárquico con interacción multiplicativa. Si se establece $b \equiv 0$, se obtiene un modelo de coeficientes variables. La AMM es la familia natural mínima que contiene los tres casos y eleva la referencia al papel de argumento activo de la desviación.

    ❦

    Los tres motores de estimación

    gdpar define tres motores complementarios para estimar $\Delta$. De manera crucial, solo uno es ejecutable en la versión actual: una decisión deliberada de plantear un alcance matemático que excede la superficie ejecutable y de declararlo con transparencia.

    Ruta Motor Representación Estado
    Ruta 1 Bayesiano jerárquico (Stan) AMM paramétrica ✅ Operativa
    Ruta 2 Coeficientes variables (splines) $\beta(z)$ suave 🚧 Conceptual
    Ruta 3 Hiperrred / Red neuronal La red genera $\theta_i$ 🚧 Conceptual

    Las rutas 2 y 3 están documentadas con calidad de referencia —la Wiki desarrolla la teoría asintótica completa (tasas de contracción, Bernstein–von Mises)—, pero si se invocan terminan con gdpar_unsupported_feature_error. La Ruta 1 asigna distribuciones a priori a cada componente ($\theta_{\text{ref}}, a, b, W$) y muestrea la distribución posterior conjunta mediante HMC, produciendo de forma nativa incertidumbre basada en la posterior completa.

    Historia de dos posteriores: EB frente a FB

    Dentro de la Ruta 1, gdpar ofrece dos regímenes inferenciales. Bayes completo (FB), mediante gdpar(), muestrea la posterior conjunta y se mantiene como la opción más fiel a la analogía cognitiva. Bayes empírico (EB), mediante gdpar_eb(), estima los hiperparámetros maximizando una verosimilitud marginal mediante una aproximación de Laplace y, posteriormente, muestrea los parámetros restantes de manera condicional.

    El comparador EB frente a FB

    En lugar de imponer una elección, gdpar los trata como rutas paralelas. Incluye un comparador específico, gdpar_compare_eb_fb(), que cuantifica el grado de concordancia en $\theta_{\text{ref}}$ y en el vector de parámetros reducido $\xi$. La Wiki desarrolla la teoría con profundidad de primer nivel: las posteriores de nivel inferior de EB y FB coinciden asintóticamente (Teorema 7A), mientras que los intervalos EB presentan una cobertura insuficiente de orden $O(n^{-1})$ (Proposición 7B). Si alguna vez te has preguntado si EB es «suficientemente bueno» para tus datos, gdpar permite responderlo empíricamente.

    Regresión distribucional: cada parámetro es una ranura

    gdpar no está restringido a modelar la media. Una distribución de probabilidad posee múltiples parámetros —localización, escala, forma, índice de cola, probabilidad de inflación de ceros— y cada uno de ellos puede tener su propia descomposición AMM. El paquete los indexa mediante $k = 1, \dots, K$:

    $$ \theta_i^{(k)} = \theta_{\text{ref}}^{(k)} + \Delta^{(k)}(x_i, \theta_{\text{ref}}^{(k)}), \qquad k = 1, \dots, K $$

    El repertorio incorporado abarca las familias gaussiana, Poisson, binomial negativa, Bernoulli, Beta, Gamma, Student-$t$, Tweedie, ZIP, ZINB y hurdle. Los modelos inflados en cero y hurdle reciben un tratamiento especialmente elegante: tanto la probabilidad de inflación de ceros $\pi_i$ como el parámetro de conteo $\theta_i$ quedan anclados a sus respectivas referencias, conformando un diseño de desviación dual.

    ❦

    El puente causal

    Dado que la forma AMM produce parámetros individuales, los efectos individuales del tratamiento surgen de manera natural. gdpar_causal_bridge() implementa un T-learner: ajusta el modelo anclado por separado bajo tratamiento y control y, posteriormente, obtiene el efecto promedio condicional del tratamiento (CATE) en $x_i$ como la diferencia entre las predicciones individuales ancladas:

    $$ \widehat{\tau}(x_i) = \widehat{\mu}_1(x_i) – \widehat{\mu}_0(x_i) $$

    Una segunda capa, gdpar_compare_meta_learners(), compara el learner basado en AMM con meta-learners externos mediante adaptadores conectables: grf::causal_forest del lado de R y CausalForestDML de EconML del lado de Python (mediante reticulate). Las afirmaciones causales del marco se someten a comparación empírica; no se dan simplemente por sentadas.

    Mecánica y engranajes

    Varias decisiones de ingeniería elevan a gdpar de ejercicio teórico a entorno computacional serio:

    • Generador de código Stan: Compone programas a partir de piezas canónicas —bloques AMM para $p=1$ y $p \geq 1$, bloques marginales/condicionales EB y bloques distribucionales-$K$— seleccionadas según la configuración resuelta $(K, p, \text{family}, W, \text{parametrization}, \text{group})$. La base de $W$ admite B-splines con evaluación Cox–de Boor del lado de Stan, garantizando diferenciabilidad dentro de HMC.
    • Verificación previa de identificabilidad: Antes de cualquier muestreo, gdpar_check_identifiability() ejecuta una comprobación de la matriz de Gram (Proposición 1C), una comprobación por coordenada entre componentes (C4-bis) para $p > 1$ y una comprobación anti-aliasing por grupo (C7). Si tu diseño no es identificable, lo sabrás antes de que el muestreador consuma tiempo de CPU, acompañado de un gdpar_identifiability_error estructurado que identifica las direcciones dependientes.
    • Reparametrización guiada por los datos: Trata la parametrización de $b(x) \odot \theta_{\text{ref}}$ como una decisión previa al ajuste. Un breve piloto calcula una razón de información y deriva el problema hacia CP, NCP o —la solución de gdpar dirigida a la causa raíz— una reparametrización lineal que muestrea directamente el producto $\theta_{\text{ref}} \cdot b$, evitando por completo los embudos bilineales.

    Herramientas avanzadas de activación opcional

    Dos capacidades avanzadas están desactivadas por defecto y documentadas con el mismo nivel de detalle que la ruta principal.

    1. Muestreo adaptativo a la geometría

    Las posteriores AMM jerárquicas pueden presentar geometrías particularmente hostiles —embudos, cuasi-determinismo, colas pesadas—. El motor geométrico, de activación opcional, asciende por una jerarquía de métricas riemannianas: Euclidiana → Fisher/SoftAbs → subriemanniana → relativista/Finsler. Un orquestador certificador diagnostica la patología, selecciona una métrica, ajusta el integrador y emite un certificado. Si se certifica que el muestreo completo es inviable, un mecanismo alternativo de Laplace proporciona una posterior plug-in con un ELPD comparable al de mgcv-REML o INLA-Laplace.

    2. Inferencia robusta frente a la dependencia

    gdpar no modela la dependencia temporal o espacial dentro de su estructura puntual; en su lugar, hace que la inferencia sea robusta frente a la dependencia (un enfoque de independencia de trabajo + varianza sándwich, en el espíritu de Liang & Zeger, 1986). Se obtienen diagnósticos (Durbin–Watson, Ljung–Box, $I$ de Moran) y errores estándar robustos mediante bootstrap por bloques: bloques móviles o circulares en el tiempo (con longitud automática de bloque flat-top de Politis–White) y bloques espaciales en mosaico con origen aleatorizado. Las estimaciones puntuales permanecen intactas; únicamente la incertidumbre se vuelve más honesta.

    ⚠️ Limitaciones declaradas con transparencia

    La Wiki es admirablemente explícita respecto del alcance. Solo la Ruta 1 es ejecutable en la versión 0.1.0. La dependencia no se modela: únicamente se hace robusta la inferencia frente a ella. El alcance matemático del paquete excede su superficie ejecutable por diseño. Conviene leer cuidadosamente las notas de «Estado de implementación» antes de depender de una determinada funcionalidad.

    ❦

    En resumen

    gdpar toma una de las ideas más naturales de la predicción humana —predecir a un individuo como una desviación respecto de una referencia poblacional, donde la propia desviación depende de esa referencia— y la transforma en un marco de regresión bayesiana plenamente especificado, con comprobación de identificabilidad y respaldado por Stan. Es teóricamente riguroso, computacionalmente serio y excepcionalmente transparente respecto de lo que hace y de lo que todavía no hace. Si tu trabajo involucra heterogeneidad individual, regresión distribucional o estimación de efectos causales con incertidumbre fundamentada, gdpar merece una mirada detenida.

  • ESPACIOS BITOPOLÓGICOS: ESCUCHAR LA DIRECCIÓN DEL TIEMPO CUANDO IMPORTA

    ESPACIOS BITOPOLÓGICOS: ESCUCHAR LA DIRECCIÓN DEL TIEMPO CUANDO IMPORTA

    Espacios bitopológicos: escuchar la dirección del tiempo cuando importa

    Espacios bitopológicos: escuchar la dirección del tiempo cuando importa

    Cómo dos topologías —construidas a partir de los mismos datos— pueden percibir la diferencia entre pasado y futuro

    La mayoría de las herramientas que utilizamos para analizar secuencias de datos —promedios, correlaciones, análisis espectrales— tratan el tiempo como una etiqueta que podría transcurrir en cualquiera de las dos direcciones sin alterar la respuesta. Invertí el orden de tus datos y muchos métodos estándar te darán exactamente los mismos resultados. Pero en el mundo real, la dirección del tiempo importa profundamente. Las economías se expanden lentamente y colapsan de forma repentina. Los latidos del corazón aumentan suavemente y descienden con brusquedad. Un método ciego a la dirección es un método ciego a una de las características más fundamentales de cómo cambian los sistemas.

    Un artículo reciente del investigador independiente José Mauricio Gómez Julián introduce una construcción que aborda esta limitación. Partiendo de un método conocido de la teoría de grafos y extendiéndolo a grafos dirigidos, el artículo produce un par de topologías —marcos matemáticos para comprender la estructura y la conectividad— cuya divergencia constituye una huella topológica de la irreversibilidad temporal. Aplicado a tres décadas de datos económicos estadounidenses, el método recupera una imagen que es a la vez matemáticamente precisa y económicamente interpretable. Veamos las ideas principales.


    Ver y ser visto

    El punto de partida es una idea de hermosa simplicidad introducida por Lucas Lacasa y sus colaboradores en 2008. Imaginá representar una serie temporal —por ejemplo, 129 tasas trimestrales consecutivas de crecimiento del PIB de EE. UU.— como puntos sobre una línea temporal. Ahora conectá dos puntos mediante una línea si pueden «verse» entre sí: el segmento recto que los une pasa por encima de todos los puntos intermedios, como si estuvieras situado en uno de ellos y alumbraras con una linterna hacia el otro sin que hubiera obstáculos en el camino.

    El resultado es un grafo de visibilidad: una red cuyos nodos son puntos temporales y cuyas aristas codifican una relación geométrica. Los grafos de visibilidad se han utilizado para clasificar sistemas caóticos, detectar anomalías en los latidos cardíacos y distinguir entre distintos tipos de regímenes económicos. Traducen la forma de una serie temporal en la estructura de un grafo, abriendo la puerta al vasto conjunto de herramientas de la ciencia de redes.

    Pero los grafos de visibilidad estándar son no dirigidos: una arista entre dos puntos no registra cuál ocurrió primero. Si orientás cada arista desde el punto temporal anterior hacia el posterior, obtenés un grafo de visibilidad dirigido: un grafo dirigido acíclico en el que las flechas siempre apuntan hacia adelante en el tiempo. Esta orientación conserva información sobre la asimetría temporal que el grafo no dirigido descarta por completo.

    De las redes a la estructura

    Aquí es donde comienza la contribución del artículo.

    En 2018, Huda Nada y sus colaboradores introdujeron un procedimiento para transformar cualquier grafo no dirigido en un espacio topológico. Para quienes no estén familiarizados con el término, una topología es un marco matemático que define qué significa que grupos de puntos sean «abiertos», que conjuntos estén «conectados» y que los espacios posean «estructura». Opera en un nivel más abstracto que las distancias o las coordenadas: captura el patrón mediante el cual los conjuntos se superponen y se separan.

    La construcción de Nada funciona de la siguiente manera. Para cada vértice del grafo, se calcula su vecindad cerrada: el propio vértice más todos sus vecinos inmediatos. Se toma esta familia de vecindades y se genera una topología cerrándola bajo dos operaciones: intersecciones finitas (combinar vecindades mediante su superposición) y uniones arbitrarias (combinar vecindades reuniéndolas). El resultado es una topología sobre el conjunto de vértices, y sus invariantes —componentes conexas, propiedades de separación, número de componentes— capturan características estructurales del grafo.

    Este procedimiento es universal: funciona para cualquier familia de subconjuntos de cualquier conjunto. El contenido matemático reside en identificar cuál es la familia adecuada que debe utilizarse.

    La observación fundamental de Gómez Julián es que, para un grafo dirigido, no se obtiene una única familia de vecindades, sino dos. Para cada vértice:

    La vecindad cerrada hacia adelante incluye el propio vértice y todos los vértices hacia los que este apunta: los puntos temporales posteriores que puede ver. La vecindad cerrada hacia atrás incluye el propio vértice y todos los vértices que apuntan hacia él: los puntos temporales anteriores desde los cuales es visible.

    Aplicá el procedimiento de Nada a las vecindades hacia adelante y obtenés una topología τ+. Aplicalo a las vecindades hacia atrás y obtenés una topología τ−. La terna resultante (V, τ+, τ−) es lo que los matemáticos denominan un espacio bitopológico: un conjunto equipado simultáneamente con dos topologías, concepto introducido por John Kelly en 1963.

    La extensión es, en un sentido matemático preciso, trivial: a los axiomas de la topología no les importa de dónde provenga la familia generadora. Pero reconocer que esta extensión trivial es precisamente lo que debe hacerse, y demostrar que la estructura bitopológica resultante captura algo real acerca de la asimetría temporal, constituye la idea central del artículo.

    Cuando dos topologías discrepan

    Si el proceso que genera tus datos es simétrico —con la misma probabilidad de subir que de bajar y a la misma velocidad—, entonces las vecindades hacia adelante y hacia atrás son estadísticamente intercambiables. Las dos topologías τ+ y τ− tienen el mismo aspecto, y la estructura bitopológica no añade nada respecto de la construcción no dirigida.

    Pero si el proceso es asimétrico, las dos topologías divergen. Consideremos la asimetría prototípica de los sistemas económicos y físicos: una expansión gradual seguida de una contracción repentina. La visibilidad hacia adelante a través de un ascenso gradual conecta muchos puntos: cada punto puede ver muy lejos hacia adelante gracias a la suave pendiente. La visibilidad hacia atrás a través de una caída abrupta conecta pocos: el pronunciado descenso bloquea la línea de visión. La topología hacia adelante termina estando más conectada —con menos componentes separadas— que la topología hacia atrás.

    Esta divergencia es la huella topológica de la irreversibilidad temporal. El artículo define tres medidas cuantitativas de ella:

    La dirección de la asimetría Δ = C− − C+, donde C+ y C− son los números de componentes conexas de las topologías hacia adelante y hacia atrás. Un Δ positivo significa que la topología hacia adelante está más conectada. El índice de irreversibilidad por número de componentes IC, que normaliza la diferencia para que se sitúe entre 0 y 1. Y el índice de irreversibilidad por tamaño de la base IB, que mide la diferencia análoga entre los tamaños de las bases generadoras.

    Se trata de números puros: sin calibración, sin parámetros libres y sin datos de entrenamiento. Emergen de la propia estructura de los datos y de la construcción.

    Si invertís la dirección del tiempo en tus datos y las topologías cambian, entonces algo en el proceso que generó esos datos es irreversible; y la distancia entre las dos topologías mide exactamente cuánto.

    Pelando la cebolla: tres capas de estructura

    Una de las contribuciones más esclarecedoras del artículo es la identificación de tres capas anidadas de estructura topológica sobre una misma serie temporal, cada una de las cuales revela información distinta.

    Capa 1 — La topología de Alexandrov (alcanzabilidad). Para un grafo dirigido acíclico, la topología más básica considera «abierto» cualquier conjunto cerrado bajo alcanzabilidad hacia adelante: si un nodo pertenece al conjunto, todos sus descendientes también pertenecen a él. Esta topología tiene exactamente una componente conexa para cualquier grafo débilmente conexo, porque cada nodo puede alcanzar a todo nodo posterior mediante algún camino dirigido. En este nivel, el sistema es globalmente indescomponible. Nos dice lo que ya sabemos: la economía es un único proceso conectado en el que cada trimestre influye sobre todos los trimestres posteriores mediante cadenas de causalidad.

    Capa 2 — La topología de Nada no dirigida (fragmentación local). Cuando aplicás la construcción de Nada a la versión no dirigida del grafo de visibilidad, la topología se fragmenta drásticamente. El cierre por intersecciones de las vecindades revela grupos de puntos temporales que comparten similitud estructural local —grupos de observaciones vinculados mediante vecindades de visibilidad superpuestas— y que van más allá de la mera alcanzabilidad. Esta capa descubre una estructura genuina que la topología de alcanzabilidad oculta por completo.

    Capa 3 — La capa bitopológica (asimetría temporal). Cuando dividís la construcción en una parte hacia adelante y otra hacia atrás, emerge una distinción adicional. Las topologías hacia adelante y hacia atrás poseen diferentes números de componentes, y esa diferencia es invisible tanto para la construcción no dirigida como para la construcción de Alexandrov. Solo existe en la brecha entre las dos topologías dirigidas.

    Cada capa está contenida en la siguiente: la topología de Alexandrov es una subtopología de la topología de Nada —un teorema demostrado en el artículo—, que a su vez subyace a la estructura bitopológica. Pero cada capa más gruesa oculta información que la capa más fina revela.

    Cómo se ve la economía estadounidense a través de una lente topológica

    El artículo aplica el procedimiento completo a la tasa trimestral de crecimiento del PIB real de EE. UU. desde el T1 de 1992 hasta el T1 de 2024: 129 observaciones que abarcan el colapso de las puntocom, la Crisis Financiera Global y el impacto de la COVID-19. Se utilizan dos construcciones de grafos: el Grafo de Visibilidad Horizontal (HVG) y el Grafo de Visibilidad Natural (NVG), ambos en sus formas dirigidas.

    El principal resultado es que Δ = +4 en ambas construcciones. La topología hacia adelante posee 4 componentes conexas menos que la topología hacia atrás, independientemente de qué variante del grafo de visibilidad se utilice. Este valor positivo es coherente con la bien documentada asimetría del ciclo económico estadounidense durante este período: las expansiones son graduales y sostenidas (1992–2000, 2001–2007, 2009–2020), mientras que las contracciones son bruscas y de corta duración (2001, 2008–2009, 2020). La visibilidad hacia adelante a través de una expansión gradual permanece despejada; la visibilidad hacia atrás a través de una contracción abrupta es fragmentaria.

    Lo que hace especialmente convincente este resultado es su invariancia. El HVG y el NVG producen grafos muy diferentes —248 frente a 406 aristas, distintos tamaños de base y distintos números absolutos de componentes— y, sin embargo, coinciden tanto en el signo como en la magnitud de Δ. La señal parece robusta: una característica de los datos subyacentes, no un artefacto de la forma elegida para construir el grafo.

    Otro detalle digno de atención: el índice de irreversibilidad por tamaño de la base IB es exactamente cero en ambas construcciones. Las topologías hacia adelante y hacia atrás son generadas por bases de igual tamaño (250 y 250 para el HVG; 239 y 239 para el NVG). La asimetría reside por completo en la estructura de esos elementos de la base y en la forma en que se distribuyen sus intersecciones, no en cuántos elementos existen. Las dos topologías están construidas con el mismo número de bloques fundamentales, pero esos bloques encajan de manera diferente dependiendo de si se observa hacia adelante o hacia atrás en el tiempo.

    Un único impacto

    Quizá el resultado empírico más llamativo sea lo que la topología nos dice acerca del impacto de la COVID-19.

    El segundo trimestre de 2020 registró la contracción más pronunciada del PIB de EE. UU. de toda la serie: una tasa anualizada de aproximadamente −31 %. El tercer trimestre registró el rebote más pronunciado: aproximadamente +33 %. Son las dos observaciones más extremas de toda la serie de 129 trimestres, opuestas tanto en signo como en interpretación económica.

    Un análisis ingenuo las separaría naturalmente: una es el peor colapso y la otra, la mejor recuperación. Se encuentran en extremos opuestos del espectro de valores.

    Pero la topología de Nada las clasifica juntas. Tanto bajo las topologías no dirigidas como bajo las dirigidas, y tanto con el HVG como con el NVG, estas dos observaciones pertenecen a la misma componente conexa.

    ¿Por qué? Porque la topología no es una medida de proximidad. No agrupa los puntos según lo cercanos que sean sus valores. Los agrupa según la estructura de sus vecindades de visibilidad: qué otros puntos pueden ver y cómo se intersectan esos patrones de visibilidad. A pesar de poseer valores extremos y opuestos, ambos trimestres comparten vecindades que se superponen sustancialmente. El cierre por intersecciones, que impulsa la construcción de Nada, los sitúa en el mismo grupo.

    Esto coincide con la interpretación que la mayoría de los economistas da al acontecimiento: la contracción y el rebote son dos fases de un único impacto exógeno, impulsadas por la misma causa subyacente —la pandemia y la respuesta de política económica ante ella—. La topología recupera esta interpretación únicamente a partir de la geometría de los datos, sin incorporar a priori ningún supuesto económico.

    Lo que la topología no afirma: no dice que los dos trimestres sean «similares» en valor —son las dos observaciones más distantes de toda la serie—. Afirma que están estructuralmente vinculados: ningún conjunto abierto topológico los separa. La construcción responde a la combinatoria de la visibilidad, no a la métrica de la distancia.

    Certificando la construcción

    El artículo se toma en serio la fiabilidad en tres niveles.

    Demostraciones verificadas por máquina. El teorema central y otros resultados fundamentales relacionados han sido formalizados en Lean 4, un asistente de demostración, utilizando la biblioteca matemática Mathlib. Una computadora ha verificado que las demostraciones son lógicamente correctas, sin lagunas ni supuestos ocultos. La formalización está archivada junto con el artículo como parte de un paquete de reproducibilidad en Zenodo.

    Algoritmos de tiempo polinómico. Cada paso de la construcción posee un algoritmo explícito con cotas de complejidad demostradas. Las componentes conexas de cada topología pueden calcularse en tiempo polinómico sin enumerar la topología completa, que puede alcanzar un tamaño exponencial. El truco fundamental consiste en trabajar mediante un sustituto combinatorio de la topología denominado preorden de especialización, utilizando operaciones sobre conjuntos de bits que resultan altamente eficientes en la práctica.

    Incertidumbre honesta. Un procedimiento de decisión trivaluado para la conexidad por pares devuelve «conectados por pares», «desconectados por pares» o «indeterminado»; esta última respuesta aparece cuando el cálculo agota su presupuesto de recursos. En lugar de adivinar, el algoritmo informa honestamente que no ha terminado el trabajo. Esto constituye tanto un compromiso metodológico como técnico: una afirmación topológica solo se considera establecida cuando el cálculo ha completado el trabajo necesario para establecerla.

    Sin parámetros libres. La construcción no posee parámetros de ajuste. Los invariantes topológicos —número de componentes, tamaños de las bases e índices de irreversibilidad— quedan determinados por completo por los datos y las definiciones. No hay nada que calibrar ni nada que sobreajustar.

    Una nueva lente

    El artículo no propone sustituir los métodos existentes de análisis de series temporales. La correlación, el análisis espectral, los modelos de cambio de régimen y las muchas otras herramientas de la econometría y la estadística capturan información que la topología no puede ver: amplitud, frecuencia y forma distribucional. El artículo es explícito respecto de esta complementariedad.

    Lo que ofrece la construcción topológica es una nueva lente: una que responde a la estructura relacional de una serie temporal en lugar de a su estructura métrica. No pregunta «¿qué tan grande es este cambio?», sino «¿con qué conecta este cambio?, ¿de qué se desconecta?, ¿y cambia la respuesta dependiendo de la dirección temporal desde la cual lo observamos?».

    En sistemas en los que la asimetría temporal constituye una característica definitoria —ciclos económicos, dinámica climática, señales fisiológicas, secuencias causales de acontecimientos—, esta lente puede revelar estructuras que las herramientas tradicionales, por su propia construcción, son incapaces de ver.

    La aplicación al PIB de EE. UU. es una prueba de concepto. La construcción es general: se aplica a cualquier serie temporal que pueda transformarse en un grafo de visibilidad dirigido, es decir, a cualquier serie temporal. Determinar si los invariantes que produce constituyen características útiles para la clasificación, la predicción o la interpretación en contextos más amplios es una cuestión empírica que el artículo abre, pero no resuelve.

    Lo que sí establece es lo siguiente: existe una construcción que toma una serie temporal, produce dos topologías a partir de ella y cuantifica la brecha entre ambas como una medida de irreversibilidad temporal. La construcción es matemáticamente sólida, está verificada mecánicamente, es tratable algorítmicamente, carece de parámetros libres y —cuando se aplica a la economía estadounidense a lo largo de tres décadas turbulentas— produce resultados que tienen sentido económico.

    Esa es una base sobre la que vale la pena seguir construyendo.

    “Bitopological Spaces from Directed Graphs: Extending the Nada Construction to Capture Temporal Irreversibility”, de José Mauricio Gómez Julián, está disponible en Zenodo (v1.0.2, abril de 2026). El compendio completo de investigación —formalización en Lean 4, paquete de R, conjunto de datos empíricos y cuaderno de reproducibilidad— está archivado junto con el artículo.

  • ALGUNAS REFLEXIONES SOBRE LOS PRECIOS DE PRODUCCIÓN DE MARX

    ALGUNAS REFLEXIONES SOBRE LOS PRECIOS DE PRODUCCIÓN DE MARX

    ¿Se equivocó Marx sobre los precios de producción? — Una investigación de 260 páginas dice que no

    Economía Política • Econometría • Marx

    ¿Se equivocó Marx sobre los precios de producción?
    Una investigación de 260 páginas dice que no.

    Cómo un investigador dedicó años a demostrar que la crítica más célebre a la economía de Marx descansa sobre un error que Marx nunca cometió.

    Basado en: Gómez Julián (2026), “Algunas Reflexiones sobre los Precios de Producción de Marx” — Introducción, Conclusiones y el Capítulo Formal-Empírico · DOI 10.5281/zenodo.21842103

    ¿Un defecto fatal, o una lectura fatalmente equivocada?

    Durante más de un siglo, un único argumento matemático se ha esgrimido como la prueba definitiva de que la economía de Karl Marx no funciona. Dice así: Marx sostuvo que el valor de las mercancías está determinado por el trabajo que las produce, y que los precios de mercado terminan gravitando hacia “precios de producción” — versiones modificadas de esos valores-trabajo, ajustadas según cuán intensiva en capital sea cada industria. Pero al intentar verificarlo con un sistema de ecuaciones simultáneas, las cuentas no cierran. La suma de los valores no iguala a la suma de los precios. La teoría, dicen los críticos desde comienzos del siglo XX, contiene un error algebraico fatal.

    Este trabajo — 260 páginas que recorren filosofía, historia, sociología y estadística — sostiene que el error nunca fue de Marx. Fue el error de quienes revisaron sus cuentas con un método que Marx jamás empleó.

    ◊

    La fotografía contra la película

    Imagine que quiere entender un río. Puede tomarle una fotografía — capturar un instante congelado — o puede filmarlo como una película, viendo cómo el agua fluye en el tiempo. Durante más de cien años, los economistas que criticaron a Marx le tomaron una fotografía a su teoría y después se quejaron de que no se pareciera a una película.

    El problema específico es éste. Marx describió un proceso de dos pasos: primero se forma una tasa general de ganancia en toda la economía; después, el precio de cada industria se desvía de su valor-trabajo puro según cuánto capital inmovilice respecto del promedio. La crítica estándar — originada con Ladislaus von Bortkiewicz en 1907 y repetida desde entonces — toma todas las identidades contables de Marx y las resuelve simultáneamente, como si los precios de los insumos y los precios de los productos se determinaran en el mismo instante. Bajo ese marco, las tres igualdades agregadas de Marx no pueden sostenerse todas a la vez.

    La “inconsistencia” que se le atribuye a Marx desde hace más de un siglo es la inconsistencia del marco simultaneista-dualista que se le impuso, y se disuelve en cuanto se restituye el tiempo. — Gómez Julián, resumiendo la tesis central

    Pero aquí está la trampa: resolver todo simultáneamente equivale a suponer que la economía es una fotografía — que no hay tiempo. Y todo el marco de Marx está construido sobre la premisa contraria: que la economía es un proceso, una secuencia que se despliega en la cual los precios que salen de un período se convierten en los precios de los insumos que entran al siguiente. En cuanto se restituye esa dimensión temporal, la “inconsistencia” desaparece. Las tres igualdades se sostienen simultáneamente — no porque Marx fuera secretamente consistente por algún milagro, sino porque la contradicción era un artefacto del marco que se le impuso, no de su propia lógica.

    El trabajo llama a ese enfoque simultaneista “marxismo walrasiano” — una frase que capta la ironía: los economistas importaron la lógica del equilibrio general de Léon Walras y la usaron para leer a Marx, y después culparon a Marx cuando el resultado no funcionó.

    En lenguaje llano

    A Marx se lo acusó durante más de un siglo de haberse equivocado en una cuenta aritmética. Lo que en realidad pasó es que alguien rehizo esa cuenta bajo un supuesto que Marx nunca hizo — que los precios de lo que se compra para producir y los precios de lo que sale de la producción son los mismos precios, fijados en el mismo momento. Si se supone eso, las cuentas de Marx no cierran. Pero ese supuesto equivale a decir que la economía no ocurre en el tiempo.

    ◊

    ¿Pero la película fue real?

    Señalar que la lógica de Marx funciona cuando se la lee correctamente es necesario pero no suficiente. La escuela “temporalista” viene sosteniendo este argumento desde hace casi cincuenta años. Pero el autor advirtió un vacío crítico: nadie en esa escuela había tomado nunca datos del mundo real para estimar efectivamente los tres tipos de precios que describe Marx — valores-trabajo directos, precios de producción y precios de mercado — y luego contrastar si los precios de mercado realmente gravitan hacia los precios de producción como predice la teoría.

    Esto importa porque, como lo plantea el trabajo, dejar la lectura correcta de Marx “en el terreno de la argumentación conceptual mientras la lectura incorrecta ocupa ella sola el terreno de la medición” es una vulnerabilidad estratégica. Si no se puede mostrar que los precios reales se comportan como la teoría dice que deberían, la teoría sigue siendo un argumento filosófico, por más internamente consistente que sea.

    Pero antes de presentar ningún número, el trabajo dedica un espacio considerable a establecer que el proceso que Marx describió ocurrió efectivamente en la historia. Esto no es un apéndice; es una parte fundacional del argumento.

    Antes del capitalismo

    En las sociedades precapitalistas, el intercambio estaba regulado por el tiempo de trabajo — no porque alguien impusiera una teoría, sino porque las condiciones materiales lo hacían así. El trueque predominaba, la inflación no existía, y los precios solo podían reflejar los costos de producción dada la tecnología disponible. La evidencia de la antropología (los estudios de Malinowski sobre las islas Trobriand), la sociología (Mauss sobre el don), la historia de la contabilidad (el análisis de Kula sobre los registros de las haciendas feudales) e incluso la paleogenómica convergen: los objetos se valoraban en proporción al trabajo que incorporaban.

    La transición

    La disolución de las relaciones feudales, la monetización del intercambio y la destrucción de los marcos normativos preindustriales crearon las condiciones para que el capital se moviera libremente entre industrias. El trabajo de Thompson sobre la “economía moral” documenta cómo la nueva ideología de libre mercado tuvo que imponerse violentamente, destruyendo protecciones consuetudinarias y creando una relación de explotación sin precedentes.

    El capitalismo establecido

    Una vez destruidas las barreras a la movilidad del capital, el capital fluýo del comercio hacia la industria persiguiendo mayores ganancias, y la competencia generalizada forzó una redistribución de la plusvalía total entre sectores. La crisis de 1873 — que destruyó casi la mitad de los altos hornos en los principales países productores de hierro — se presenta como evidencia concreta del mecanismo: las empresas cuyos costos todavía se basaban en métodos más antiguos e individualmente más intensivos en trabajo quebraron al no poder competir con los precios de producción que dictaba la tecnología moderna.

    En lenguaje llano

    Los precios de producción no aparecieron el día en que alguien escribió una ecuación. Aparecieron el día en que el capital pudo moverse libremente de una industria a otra persiguiendo la mayor ganancia — lo cual no ocurrió hasta que se destruyeron las barreras legales, morales y políticas. Antes de eso, las cosas se intercambiaban aproximadamente según el trabajo que costaban, y hay evidencia más que suficiente — etnográfica, contable, arqueológica y genética — para mostrarlo.

    ◊

    ¿Qué es exactamente un precio de producción?

    Aquí el trabajo entra en su territorio más original desde el punto de vista técnico. El autor separa cuidadosamente dos cosas que no deben confundirse:

    Qué es un precio de producción (el explanandum): es el valor esperado, sobre la distribución de las perturbaciones económicas, del promedio temporal de largo plazo de los precios de mercado. En lenguaje llano: es el centro de gravedad alrededor del cual giran los precios de mercado reales. No el precio al que llegan y en el que se quedan (eso sería el equilibrio), sino el promedio alrededor del cual nunca dejan de oscilar.

    Concepto clave

    El precio de producción no es un equilibrio eterno y atémporal (el error del enfoque simultaneista y de la economía walrasiana, que toma la ley como tal para el todo y elimina el tiempo) ni tampoco un caos de precios sin ley (el error del empirismo, que se queda en el nivel de los precios individuales y pierde la ley). Es la ley de la totalidad realizándose a través de la contingencia de las partes.

    Cómo funciona cada paso del proceso (el explanans): una regla que determina el precio de mercado de este año a partir del precio de mercado del año anterior y del precio de producción latente del año anterior, y de nada más. Esto se modela como un proceso de Ornstein-Uhlenbeck jerárquico — una cascada de tres niveles en la que el precio de producción es él mismo un estado latente con su propia dinámica que gravita hacia el valor, y los precios de mercado gravitan hacia ese estado latente y no hacia un índice fijo y ruidoso.

    La incertidumbre está incorporada explícitamente al modelo: incertidumbre en la tasa media de ganancia, incertidumbre en el capital adelantado, incertidumbre en la desagregación de las cuentas nacionales en 37 sectores (tratada mediante imputación múltiple con 25 imputaciones combinadas por la regla de Rubin), e incertidumbre paramétrica estimada mediante métodos bayesianos de Monte Carlo por cadenas de Márkov.

    Un punto crucial: ninguna magnitud se obtiene resolviendo un sistema simultáneo. El valor se construye empírica y directamente como $V = c + v + p$ (costo más plusvalía), y el precio de producción como $\Phi = c + K \cdot G’$ (costo más capital por la tasa general de ganancia). No hay inversa de Leontief ni álgebra simultaneista en ningún punto de la construcción.

    En lenguaje llano

    Piense en un precio de producción como el “centro gravitacional” de un objeto que gira. El objeto (un precio de mercado) nunca deja de moverse — se tambalea, oscila, deriva — pero con el tiempo su posición promedio es atraída hacia ese centro. La matemática describe tanto qué es ese centro como cómo ocurre cada tambaleo, y lo hace dando cuenta honestamente de toda la incertidumbre de la medición.

    Las ecuaciones que lo definen: de la (9) a la (11)

    Aquí la metáfora se vuelve matemática. El trabajo escribe la definición de un precio de producción en tres pasos sucesivos — cada uno explicitando un supuesto que el anterior dejaba implícito — numerados (9), (10) y (11) en el texto original. Ninguna de las tres genera por sí sola una trayectoria; juntas definen el explanandum — qué es el objeto — que la cascada de más abajo después genera.

    Ecuación 9 — Qué es un precio de producción
    $$ \lim_{t\to\infty} E\!\left[\varphi^i_t\right] \;=\; k^i_t + K^i_t\, E\!\left[G'(t,X)\right] \;=\; \Phi^i_t $$

    Aquí $\varphi^i_t$ es el precio de mercado de la mercancía del sector $i$ en el horizonte temporal $t$, $k^i_t$ es su precio de costo (capital constante consumido más capital variable), $K^i_t$ es el capital total adelantado, y $G'(t,X)$ es la tasa general de ganancia — ella misma un proceso estocástico indexado por una perturbación $X$ que agrupa el éxodo de capitales entre ramas y la innovación tecnológica.

    En palabras: un precio de producción es el límite de largo plazo del promedio del precio de mercado. No el precio mismo en ningún instante — eso sigue oscilando para siempre — sino el punto en el que se asienta su promedio temporal a medida que el horizonte se estira. Nótese el objeto del lado derecho, $k + K \cdot E[G’]$: es la misma identidad contable presentada antes (precio de costo más la tasa media de ganancia aplicada al capital adelantado), solo que ahora la tasa de ganancia se escribe como una esperanza, porque fluctúa.

    Ecuación 10 — Explicitando el promedio
    $$ \Phi^i_t = \lim_{t\to\infty} E\!\left[\varphi^i_t\right] = \int_{-\infty}^{\infty} \!\left(\lim_{t\to\infty} \varphi^i_t(x)\right) f_X(x)\, dx \;=\; k^i_t + K^i_t \int_{-\infty}^{\infty} G'(t,x)\, f_X(x)\, dx $$

    $f_X$ es la densidad de probabilidad de $X$. La ecuación dice que la esperanza es un promedio sobre cada estado posible $x$ de la turbulencia del sistema, ponderado por cuán probable sea ese estado.

    La ecuación (10) se gana su lugar al legitimar un movimiento sutil: intercambiar el orden del límite y la esperanza. Eso parece inocuo, pero esconde una pregunta real — ¿converge siquiera el precio de mercado $\varphi^i_t$ a algo cuando $t \to \infty$? La respuesta del trabajo es que no: un sistema capitalista no se asienta en un punto fijo, se asienta en un ciclo límite — una oscilación perpetua. Entonces la convergencia que el argumento necesita no es la del precio instantáneo, sino la de su promedio temporal acumulado. Ese promedio sí converge, para casi todo estado del mundo, precisamente porque el sistema es ergódico — la fracción de tiempo que el ciclo pasa en cada región de su órbita se estabiliza. Esto es el teorema ergódico de Birkhoff haciendo, en lenguaje matemático, exactamente lo que Marx dice en lenguaje económico: el precio de producción no es el valor al que el precio de mercado llega y en el que se queda, es el promedio alrededor del cual nunca deja de oscilar. La oscilación no es un obstáculo para el promedio — es su condición de existencia.

    Por qué importa el orden de las operaciones

    El trabajo invoca el teorema de convergencia dominada de Lebesgue para justificar el intercambio de “límite del promedio” por “promedio del límite”. Esto exige acotar los precios de mercado con alguna envolvente integrable — económicamente, que ningún precio pueda crecer sin límite, cosa que garantizan los techos tecnológicos y la presión competitiva — y, de manera crucial, no exige que la convergencia sea uniforme entre sectores. La convergencia uniforme significaría que la competencia iguala las ganancias de manera instantánea e idéntica en todas partes, sin lugar para que un shock golpee más fuerte a una industria que a otra. La teoría de Marx dice lo contrario, y la matemática está construida para permitirlo.

    Ecuación 11 — Cuando el capital también es incierto
    $$ \Phi^i_t = \lim_{t\to\infty} E\!\left[\varphi^i_t\right] = \int_{-\infty}^{\infty}\!\!\int_{-\infty}^{\infty} \left[k^i_t + K^i_t(y)\, G'(t,x)\right] f_{X\mid Y}(x\mid y)\, f_Y(y)\; dx\, dy $$

    La ecuación (10) todavía trataba el capital adelantado $K^i_t$ como algo conocido con exactitud. La ecuación (11) abandona esa simplificación: $Y$ es una segunda variable aleatoria que porta el error de estimación de $K$, con densidad $f_Y$, y $f_{X \mid Y}$ permite que la perturbación de la tasa de ganancia dependa de qué realización de ese error ocurrió. El objeto es el mismo doble promedio — solo que ahora la incertidumbre se propaga desde dos fuentes en lugar de una.

    Esta última ecuación no es un adorno matemático; es la razón por la cual la sección empírica dedica tanto esfuerzo a la imputación múltiple. Las cuentas nacionales no le entregan a nadie una medición limpia del capital adelantado por sector — hay que reconstruirlo a partir de datos incompletos, y esa reconstrucción carga su propio error. La ecuación (11) es la licencia para tratar ese error como una variable aleatoria que se promedia, y no como una molestia que se ignora. La incertidumbre se propaga de manera externa — mediante un generador fuera del propio modelo estadístico — en lugar de estimarse como un parámetro interno del modelo dinámico: estimar el error de $K$ adentro del modelo lo confundiría con el propio término de ruido de medición del modelo, abriendo una cresta de no identificación entre dos magnitudes que el dato por sí solo no puede distinguir. Mantenida afuera, primero se generan veinticinco reconstrucciones completas del dato, cada una respetando las identidades agregadas marxianas a precisión de máquina, se ajusta el modelo dinámico sobre cada una, y los veinticinco ajustes se combinan por la regla de Rubin. Eso es el promedio externo de la ecuación (11), calculado sorteando literalmente de la distribución de $Y$ en lugar de suponerla resuelta.

    El motor: una cascada de Ornstein–Uhlenbeck de tres niveles

    Las ecuaciones (9)–(11) definen el objetivo; no generan por sí solas un camino hacia él. El explanans — el mecanismo que efectivamente produce una trayectoria año a año consistente con ese objetivo — es un proceso de Ornstein-Uhlenbeck jerárquico de hasta tres niveles anidados, ajustado como un único programa de Stan (el mismo programa maneja uno, dos o tres niveles, lo cual garantiza que agregar niveles nunca pueda romper en silencio los casos más simples anidados adentro). Todas las series entran estandarizadas; el tiempo se discretiza año a año con el esquema de Euler–Maruyama.

    Nivel 1 — El precio de mercado
    $$ dev_{t,s} = \varphi_{t-1,s} – \Phi_{t-1,s} $$
    $$ \kappa^m_{t,s} = \kappa_{\mathrm{cap}} \cdot \mathrm{invlogit}\!\left(\kappa_s + \beta_1\, z^{TMG}_t\right) $$
    $$ \Delta\varphi_{t,s} = \kappa^m_{t,s}\!\left(-\,dev_{t,s}\right) \;+\; a_{3,s}\, dev_{t,s}^{\,3} \;+\; \gamma\, COM^{std}_{t,s} \;+\; \varepsilon_{t,s} $$

    Los subíndices $s$ (sector) y $t$ (año) corren en todo momento. $dev$ es la brecha del año anterior entre el precio de mercado y el precio de producción latente. $\kappa^m$ es la velocidad de reversión del sector, pasada por un enlace logit que la acota dentro de $(0,\, \kappa_{\mathrm{cap}})$ y permite que la tasa general de ganancia ($z^{TMG}$) la module sin jamás empujar al sistema fuera de la región estable de la discretización. $\varepsilon$ es una innovación de cola pesada (Student-t) con volatilidad estocástica, de modo que la volatilidad puede agruparse en el tiempo sin desestabilizar la media.

    Léase la línea del Nivel 1 como un resorte. El término $-\kappa \cdot dev$ es la fuerza restauradora: tira del precio de mercado de vuelta hacia el precio de producción con una fuerza proporcional a cuánto se ha desviado. El término cúbico $a_{3,s} \cdot dev^3$, con $a_{3,s}$ restringido a ser negativo por construcción — no estimado, impuesto — hace que esa fuerza restauradora crezca más que proporcionalmente cuando la desviación es grande: cuanto más se aleja el mercado, con más fuerza se lo trae de vuelta. Este es un supuesto de estabilidad declarado, no un hallazgo: garantiza que el modelo nunca pueda generar un régimen explosivo, al costo real de que si tal régimen existiera en algún sector de la economía real, esta especificación en particular no podría detectarlo.

    Niveles 2–3 — Donde el propio centro latente revierte
    $$ \mu_{s,t} = m_{0,s} + m_1\, G’_t + m_v\, V_{s,t} $$

    El precio de producción $\Phi$ no se trata como un índice fijo y observado; es él mismo un estado latente que revierte — más lentamente, con su propia velocidad sectorial $\kappa_p$ — hacia esta media $\mu$. $m_1$ es el canal que pasa por la tasa general de ganancia; $m_v$ es el coeficiente que mide cuán fuertemente el precio de producción rastrea al valor construido directamente $V_{s,t} = k + p$ (Nivel 3, y la razón por la cual la cascada llega hasta tres niveles en lugar de detenerse en dos).

    Éste es el puente de vuelta hacia las ecuaciones abstractas de más arriba, término a término. $\mu_{s,t}$ es el sustituto estimable del lado derecho de (9): $m_{0,s} + m_1 G’_t$ cumple el papel de $k + K \cdot E[G’]$, y $m_v V_{s,t}$ es la forma funcional específica elegida para el canal de anclaje al valor que la definición abstracta deja deliberadamente abierto (el trabajo se cuida de decir que la competencia capitalista como función de la estructura de valor está declarada al nivel de las ecuaciones 9–11, no derivada; darle la forma concreta $m_v V$ es una decisión de modelado tomada al nivel de la cascada, defendida por su desempeño en la validación y no deducida de la definición). Y la esperanza de $G’$ de la ecuación (9) tiene su contraparte operativa en la tasa de ganancia promediada sobre las veinticinco imputaciones múltiples — el mecanismo que habilita la ecuación (11).

    El coeficiente $m_v$ carga un peso teórico real: es el sustituto empírico de la afirmación del capítulo IX según la cual los precios de producción gravitan alrededor de los valores. Se le asigna una a priori neutral, $m_v \sim \mathcal{N}(0,\, 0.5)$ — centrada en cero, simétrica, que asigna igual plausibilidad a $m_v > 0$ y a $m_v < 0$ antes de ver ningún dato. Eso importa por la misma razón por la que importa una moneda justa en un experimento de tirar una moneda: si el dato no llevara ninguna señal, el posterior se quedaría donde lo puso la a priori, pegado a cero. No lo hace. Se ubica en $m_v \approx 1.0136$ con $P(m_v > 0) = 1$ — evidencia de que fueron los datos, y no la a priori, los que lo llevaron hasta ahí. El anclaje al valor se encuentra, no se impone en el diseño.

    En lenguaje llano

    La cascada son tres resortes apilados uno sobre otro. El precio de mercado está atado por un resorte al precio de producción latente, no observado. El precio de producción está atado por su propio resorte, más lento, a un blanco móvil que combina la tasa general de ganancia con el valor-trabajo medido directamente. Tire de cualquiera de los resortes y suéltelo: no salta a un punto fijo, se asienta en el tipo de oscilación perpetua y decreciente que las ecuaciones (9)–(11) describen como un promedio. Los resortes se estiman con sesenta y un años de datos reales de Estados Unidos, no se suponen; el coeficiente que ata los precios de producción a los valores, en particular, podía haber salido negativo o cero — el modelo le dio toda la oportunidad de hacerlo — y no salió.

    Qué dicen los números

    El núcleo empírico del trabajo es un panel de 37 ramas productivas de la economía de Estados Unidos a lo largo de 61 años, de 1960 a 2020. La hipótesis contrastada encierra tres relaciones distintas, y el trabajo es meticuloso en no conflarlas. Cada una se enuncia, se contrasta y se reporta por separado.

    Precio de mercado ↔ precio de producción: el eslabón más firme

    Esta es la relación con el respaldo estadístico más sólido, confirmada mediante seis líneas de evidencia independientes:

    Hallazgo central

    La gravitación existe, y es lenta. La velocidad mediana entre sectores es $\kappa_m = 0.0770$, equivalente a una vida media de aproximadamente 9 años. Los precios de mercado tardan cerca de una década en recorrer la mitad del camino de vuelta hacia su centro de precios de producción. Esto es consistente con la caracterización que hace Marx de la gravitación como una regulación tendencial y mediada, no un ajuste instantáneo.

    La cifra es notablemente estable bajo pruebas de estrés:

    • Quitar del panel cinco de los seis bloques productivos apenas mueve la estimación — se desplaza en la tercera cifra decimal. El sexto, que reúne 18 de los 37 sectores, sí produce un desplazamiento (de 9 años a 6 años), y el trabajo lo descompone: cerca de la mitad de la aceleración es el efecto genérico de achicar el panel a la mitad — arrancar 18 sectores al azar ya da 0.0929 — y no el bloque en sí.
    • Destruir el ancla de valor de tres maneras distintas — incluyendo permutar la plusvalía entre esferas — mueve la velocidad en la tercera cifra decimal. Esto es significativo: significa que la conclusión sobre la gravitación de mercado hacia producción no depende del vínculo menos robusto entre producción y valor.
    • El desvío de mercado tiene su propia firma dinámica. Comparado contra un paseo aleatorio igualado en varianza, tres de seis estadísticos separan limpiamente (la convergencia por sumas ponderadas alcanza una tolerancia de 0.01 mientras el nulo nunca alcanza una tolerancia diez veces más laxa; la laminaridad del análisis de recurrencia la triplica y la entropía de recurrencia la duplica). Los que no separan son el determinismo del análisis de recurrencia y los dos invariantes deterministas del caos — el exponente de Lyapunov y la dimensión de correlación — que el trabajo nunca pretendió encontrar.
    • La estimación es invariante ante decisiones metodológicas secundarias. Barrer el regularizador de latencia sobre tres valores produce vidas medias de 9 años en los tres brazos (velocidades de 0.0774, 0.0770, 0.0772).
    • El sesgo conocido de la desagregación empuja en contra del resultado. Partir una cifra nacional entre 37 ramas está subdeterminado y sesga las estimaciones de velocidad hacia abajo — lo que significa que la vida media verdadera probablemente sea de 7–8 años en lugar de 9. Un sesgo que juega en contra de la propia conclusión es uno con el que se puede convivir, porque el resultado se sostiene a pesar de él, no gracias a él.

    Precio de producción ↔ valor: la pata más débil

    Esta es la parte más débil del argumento empírico, y el trabajo lo declara con total transparencia. El problema no es un defecto del instrumento sino una propiedad del objeto:

    Transparencia metodológica

    El coeficiente de acoplamiento estimado dentro del modelo dinámico es $m_v = 1.0136$ con un intervalo creíble al 95% de $[1.0096,\; 1.0176]$ — pero el mismo procedimiento devuelve 1.0365 cuando la plusvalía se permuta entre esferas, preservando todos los agregados anuales. ¿Por qué? Porque el precio de producción y el valor comparten el precio de costo, que explica el 66.1% de la varianza del primero y el 72.0% de la del segundo, y su correlación en niveles es 0.9987. El coeficiente se ubicaría cerca de uno incluso si la ley del valor no rigiera en absoluto. Por eso el trabajo lo reporta como un control de consistencia, no como evidencia.

    El respaldo real de esta relación viene de contrastes transversales, no del acoplamiento dinámico. Cuando se remueven las tendencias temporales comunes y el análisis se hace dentro de año, la pendiente del recargo sobre la plusvalía propia es 0.675 con el dato verdadero contra 0.090 bajo permutación, con intervalos que ni siquiera se acercan a solaparse. El ordenamiento sectorial de la cuña entre $\Phi$ y $V$ tiene una correlación de rangos interanual de 0.986 y un valor a sesenta años de 0.558 — estructura muy persistente, no ruido.

    Un hallazgo colateral que vale la pena señalar: el coeficiente de variación de las tasas de ganancia sectoriales es 0.669 — lo que significa que las tasas de ganancia entre industrias muestran una dispersión considerable y persistente. Lejos de contradecir la teoría, esta dispersión es la condición de existencia del mecanismo: si las tasas de ganancia ya estuvieran igualadas, no habría diferencial que impulsara la migración de capitales, y la gravitación no tendría sobre qué operar. Marx postula la igualación como una tendencia, no como un hecho consumado.

    Precio de mercado ↔ valor: sostenida en su forma, ajustada en su existencia

    La modificación estructural entre sectores existe y es no lineal (el escalón de no linealidad se sostiene con holgura a 6.8 desvíos nulos). Pero el escalón de existencia queda ajustado: el 44% de su ganancia se obtiene por igual con características sectoriales desemparejadas de sus esferas, y la brecha contra el máximo nulo es del orden de un error estándar apareado. Los coeficientes sobreviven a una corrección deliberadamente severa por dependencia serial (triplicando el error).

    El instrumento detrás de esa cifra: una escalera anidada en gdpar

    Ese contraste es una pequeña escalera de modelos de regresión distribucional anidados, ajustada con gdpar (Gómez Julián, 2026b), el paquete de R del propio autor para regresión de parámetros distribucionales generalizados, publicado en CRAN el 15 de julio de 2026. La escalera sube desde un modelo desnudo — “el cociente mercado-valor no tiene ninguna corrección específica por sector” — pasando por un modelo en el que la composición orgánica, la participación salarial y el tamaño del sector desplazan ese cociente linealmente, hasta un modelo en el que la corrección es un spline flexible en lugar de una recta. Importan dos ganancias, medidas en unidades de densidad predictiva: agregar la corrección lineal compra 207.3 unidades; dejarla curvarse compra otras 215.1. Ambas se sometieron a un control diseñado para ser difícil de aprobar — barajar qué sector recibe las características de cuál, 99 veces, reajustando cada vez, con los nudos del spline fijos en cada barajado para que la comparación no pueda ganarse solo con una mejor base. La ganancia de curvatura supera su nulo con holgura (6.8 desvíos estándar nulos; el mejor de los 99 barajados llega apenas a 114.8 contra 215.1 observadas). La ganancia de existencia se reporta honestamente como más delgada: los sectores barajados igual compran cerca del 44% de la ganancia real con solo tener alguna característica que ajustar — tres covariables más un intercepto le dan al modelo margen para acomodarse al ruido aunque no se le esté diciendo nada cierto — de modo que el margen genuino sobre el nulo queda en alrededor de un error estándar apareado (23.2, contra una brecha de unas 24 unidades). Ambas cifras se reportan juntas, precisamente para que la grande no se lea sola.

    Una especificación complementaria, estimada en el mismo ajuste de gdpar, hace la misma pregunta sobre la dispersión en lugar de la ubicación: no dónde está centrado el cociente mercado-valor, sino cuán apretado se agrupa. Los sectores más grandes y los de mayor composición de capital muestran sistemáticamente menos dispersión relativa — elasticidades de $-0.226$ y $-0.104$ — consistente con que la igualación opera con más eficacia donde el capital está más concentrado. Ambos efectos superan un “factor de ruptura” (el múltiplo del error estándar en el que el intervalo al 95% recién tocaría el cero) de más de seis y cuatro respectivamente, por encima del techo de 2.94 alcanzado en cualquier otro coeficiente de ubicación de este trabajo, y el hallazgo se reproduce bajo una familia de verosimilitud completamente distinta (una gamma sobre el cociente de precios) con una diferencia de apenas 5.2%.

    ◊

    Tres fracasos que confirman la teoría

    Uno de los rasgos intelectualmente más llamativos de este trabajo es cómo maneja resultados que, a primera vista, se ven mal para su tesis. Hay tres, y el trabajo los reporta todos sin suavizarlos — y después muestra deductivamente por qué cada uno era esperable si la teoría es correcta.

    Resultado negativo núm. 1

    El modelo no predice fuera de muestra mejor que un paseo aleatorio. Pero esto estaba deductivamente implicado por la forma lenta de la tesis. A un horizonte mucho más corto que la vida media, un proceso de reversión a la media es, en primer orden, un paseo aleatorio. Si algo tarda una década en recorrer la mitad del camino de vuelta, mirar un solo año no alcanza para verlo regresar.

    Resultado negativo núm. 2

    El término de valor es predictivamente indistinguible. Esto también se sigue del acoplamiento lento entre precios de producción y valores: con vidas medias del orden de décadas y solo 61 años de datos, las pruebas univariadas de raíz unitaria están estructuralmente subpotenciadas.

    Resultado negativo núm. 3

    Ninguna prueba univariada separa la cuña verdadera de sus placebos permutados. Pero esto se predijo antes de medir, por la propia persistencia del ordenamiento sectorial (correlación de rangos interanual de 0.986). Una serie de tiempo muy persistente es difícil de distinguir de su versión permutada usando pruebas diseñadas para memoria más corta.

    Encontrar estas firmas es corroboración de la forma lenta de la tesis, y no encontrarlas habría sido el verdadero problema. — Gómez Julián, sobre los resultados negativos

    Vale la pena destacar la postura del trabajo al respecto: “Lejos de refutar la tesis, los tres están deductivamente implicados por su forma lenta”. Un único mecanismo (la gravitación lenta) explica tanto la tesis sustantiva como todos los resultados aparentemente negativos, y además sobrevive en el posterior validado. “Que una única causa explique la tesis y todos los resultados aparentemente negativos, y que además sobreviva en el registro validado, es lo contrario de una petición de principio: es una narrativa unificada, falsable y validada internamente”.

    ◊

    El temporalismo no es una preferencia — es una condición de medición

    Quizá el resultado más trascendente de todo el trabajo no es un número sino un enunciado sobre qué puede y qué no puede medirse. Se refiere al “modulador” — el componente del argumento de Marx en el cual la tasa general de ganancia entra dentro de la modificación estructural de cada esfera, es decir, en el cual el desvío de cada esfera no es independiente de la referencia sino engendrado por ella.

    El argumento de identificabilidad

    Cuando el modelo se corrió con una tasa general de ganancia única y fija para los 61 años (como exigiría un enfoque simultaneista), el posterior exhibió una cresta plana: dos bases funcionales completamente distintas (un polinomio de grado dos y una base de splines) produjeron la misma patología hasta la tercera cifra decimal, con un tamaño de muestra efectivo de apenas seis sorteos. El diagnóstico empeoraba con más muestreo (el R-sombrero subía de 1.33 a 1.73). Esta es la firma inconfundible de una dirección en el espacio de parámetros a lo largo de la cual la verosimilitud no cambia.

    La causa es teórica, no computacional. Con una referencia única, el modulador solo puede identificarse evaluado en ese punto — un número, no una función sobre el espacio de referencias. No se pueden estimar tres coeficientes de un polinomio con un solo dato.

    Cuando se dejó que la referencia variara año a año (61 tasas generales de ganancia distintas), el modelo convergió en cuestión de minutos, con una gran mejora tanto en tiempo como en tamaño de muestra efectivo, y cero divergencias.

    Con nombre propio, no improvisado: los teoremas 1A y 1E

    Este diagnóstico no es una lectura ad hoc de un muestreador que se porta mal. gdpar (Gómez Julián, 2026b) — el mismo paquete detrás de la escalera anidada de más arriba — incluye un resultado formal de identificabilidad para exactamente esta situación. Su Teorema 1A establece que, con una referencia única y fija, un modulador distribucional se identifica solo en ese punto: como un número, no como una función sobre el espacio de referencias posibles. El Teorema 1E es la contraparte positiva: dejar que la referencia varíe restituye la identificabilidad del modulador como función. Ajustar un polinomio de grado dos (tres coeficientes) o una base de splines de cinco nudos (cinco coeficientes) contra una única referencia inmóvil pide más de lo que un solo dato en esa dimensión puede sostener — que es exactamente el aspecto que tiene una cresta plana de verosimilitud desde el lado del muestreador.

    Las cifras exactas detrás de la mejora: una referencia fija con un polinomio de grado dos da un R-sombrero de 1.7333, un tamaño de muestra efectivo de 6, y 8 transiciones divergentes en 39 minutos; una base de splines de un nudo reproduce la misma patología — R-sombrero 1.7335, tamaño de muestra efectivo 6, 14 divergencias, 5.6 horas. Dejar que la referencia varíe año a año (61 valores anuales distintos de la tasa general de ganancia), centrando el componente aditivo y subiendo el parámetro de adaptación del muestreador a 0.99, da un R-sombrero de 1.0035, un tamaño de muestra efectivo de 1332, y cero transiciones divergentes — en 2.9 minutos. Esa es la mejora de factor 115 en tiempo y factor 222 en tamaño de muestra efectivo mencionada arriba, y es un teorema, no un truco de ajuste: ninguna cantidad de muestreo adicional cierra esa brecha bajo una referencia fija, porque el objeto que se pide — el modulador como función — sencillamente no está ahí para encontrarlo.

    La consecuencia se enuncia con precisión: con una única tasa general de ganancia fija obtenida al resolver el sistema simultáneamente, la afirmación del capítulo IX del tomo III de El Capital es inverificable por construcción. No es que los datos sean insuficientes — el objeto no está identificado, y ninguna cantidad de datos lo identificaría. El argumento no establece que el simultaneismo sea falso como descripción del capitalismo (eso lo establecen la historiografía y la sociología); establece que un procedimiento simultaneista no puede, ni siquiera en principio, constatar empíricamente la parte específica del argumento de Marx que este trabajo estima.

    En lenguaje llano

    Marx dice: primero se forma una tasa general de ganancia, y después cada industria se desvía de ella según cuán intensiva en capital sea. Para comprobar si ese desvío depende de la tasa general, hay que ver qué le pasa al desvío cuando la tasa general cambia. Si se calcula una sola tasa general para los sesenta y un años, la tasa general nunca cambia, y no hay nada que observar. Eso es exactamente lo que pasa: el modelo con una tasa fija no converge — no por limitaciones computacionales, sino porque se le está pidiendo medir una relación con una sola observación de una de las dos variables. Calculando una tasa por año — que es lo que la lectura temporal de Marx sostiene que hay que hacer — el mismo modelo converge en tres minutos.

    ◊

    Qué es esto, y qué no es

    El trabajo es cuidadoso, casi minucioso, respecto de los límites de lo que afirma. Esta sección importa porque un lector que venga del lado “pro-Marx” o “anti-Marx” podría sentir la tentación de sobre-leer los resultados. El autor no se lo permite.

    Lo que la evidencia autoriza a afirmar: en Estados Unidos entre 1960 y 2020, los precios de mercado gravitan hacia los precios de producción con una vida media de orden decenal y sectorialmente heterogénea, y esa velocidad sobrevive a tres agresiones independientes (quitar cinco de los seis bloques productivos, destruir el ancla de valor, variar decisiones metodológicas secundarias). Este es un hecho medido, calibrado y falsable.

    Lo que la evidencia no autoriza a afirmar:

    • No se afirma superioridad predictiva (el modelo no mejora el pronóstico fuera de muestra sobre un paseo aleatorio, cosa que era esperable).
    • No se afirma que las pruebas univariadas de raíz unitaria confirmen la gravitación (están estructuralmente subpotenciadas a esta escala temporal).
    • No se afirma unicidad ni novedad categórica. El aporte es la integración explícita y la canonización de una cascada de gravitación lenta con anclaje de valor, medida sobre datos reales, con la incertidumbre propagada, validada, y sometida a un diagnóstico cuyos resultados desfavorables se reportan junto con los favorables.
    • No se afirma que esto demuestre estadísticamente la ley del valor, “y no por prudencia retórica sino porque sería falso: una serie de precios puede mostrar que una magnitud se comporta como la ley predice, y no puede explicar por qué esa magnitud existe ni si la categoría con que la nombramos es la correcta”.

    Ese último punto es el compromiso epistemológico más profundo del trabajo. Las preguntas sobre si “valor” es la categoría correcta para lo que los precios en última instancia miden no las responde ninguna serie de precios, por larga que sea. Las responden la historia, la sociología y la filosofía — y la respuesta firme es la que se obtiene cuando las cuatro disciplinas (esas tres más la estadística) apuntan en la misma dirección. La convergencia de las cuatro dimensiones es el argumento, no ninguna de sus patas por separado.

    El trabajo también aborda la homología que unifica sus dos mitades aparentemente dispares — el primer capítulo historiográfico-filosófico y el segundo capítulo econométrico. La relación entre necesidad y contingencia que gobierna la transición del feudalismo al capitalismo (donde el mismo shock demográfico produjo resultados opuestos en distintas regiones de Europa) es estructuralmente idéntica a la relación entre los precios de producción y los precios de mercado. Una ley determina el centro; las circunstancias determinan cada resultado particular. Ningún hecho niega al otro, porque describen niveles distintos de la misma realidad.

    ◊

    Lo que todo esto suma

    Esta es la versión más simple de lo que establece este trabajo de 260 páginas:

    A Marx se lo reprochó durante un siglo por haber hecho mal una cuenta aritmética. Lo que pasó es que se rehizo esa cuenta bajo un supuesto que Marx nunca hizo: que los precios de las cosas que se compran para producir y los precios de las cosas que salen de la producción son los mismos precios, fijados en el mismo momento. Si se supone eso, las cuentas de Marx efectivamente no cierran. Pero ese supuesto equivale a decir que la economía no ocurre en el tiempo. En cuanto se acepta que lo que sale de la fábrica este año es lo que entra a la fábrica el año que viene, las cuentas cierran sin que nadie tenga que arreglar nada. — Gómez Julián, resumen para el lector

    Pero reconocer el error conceptual fue solo la primera mitad. Lo que faltaba — y lo que este trabajo aporta — es hacer esas cuentas con datos reales en lugar de con ejemplos numéricos ficticios, que es lo que la escuela que tenía la lectura conceptual correcta nunca había hecho.

    Los resultados empíricos muestran que los precios de la economía estadounidense a lo largo de seis décadas sí se comportan como predice la teoría: gravitan, lentamente, hacia precios de producción calculados con la teoría de Marx y ninguna otra. Este hallazgo sobrevivió a todos los ataques que el autor pudo idear — quitar sectores productivos, destruir el ancla de valor, permutar plusvalías, variar decisiones metodológicas, y correr diagnósticos cuyos resultados desfavorables se reportan en su totalidad junto con los favorables.

    La parte del argumento que vincula los precios de producción con los valores-trabajo también está respaldada por evidencia real, aunque con menos firmeza, y el trabajo dice exactamente dónde están los puntos débiles y por qué son propiedades del objeto, no defectos del instrumento.

    Y el trabajo no pretende haber demostrado la ley del valor con una serie de números, porque “preguntas de ese tipo no se contestan con números: se contestan con historia, con sociología y con filosofía, y la respuesta firme es la que se obtiene cuando las cuatro cosas (las tres anteriores, junto con la estadística) apuntan al mismo lugar”.

    Esa convergencia no vuelve eterno al resultado — mejor evidencia puede revertirlo mañana. Pero por ahora lo convierte en “nuestra mejor aproximación posible a la verdad”.

    — — —

    “En la ciencia como en la vida, superar la adversidad es lo que nos hace verdaderamente fuertes”.

    Esta entrada resume la introducción, las conclusiones y el capítulo formal-empírico (§2.4) de Gómez Julián, J. M. (2026). Algunas Reflexiones sobre los Precios de Producción de Marx: Historicidad de la Ley del Valor, Fundamento Dialéctico-Materialista y Formalización Dinámica Bajo Incertidumbre. Zenodo. https://doi.org/10.5281/zenodo.21842103. El trabajo completo abarca aproximadamente 260 páginas en dos capítulos que recorren filosofía, historiografía, formalización matemática y econometría empírica. Las ecuaciones (9)–(11) y la especificación del modelo citadas aquí reproducen la notación de ese capítulo; gdpar se cita por separado como Gómez Julián (2026b).

    Escrito para el curioso. Es una invitación a leer.

  • MUESTREO SISTEMÁTICO

    MUESTREO SISTEMÁTICO

    ISADORE NABI

    Historia y Definición Conceptual (Ochoa, 2015):

    El muestreo sistemático era muy popular en el pasado, antes de que la aparición de los ordenadores hiciese trivial un problema que siempre había dado muchos quebraderos de cabeza a los investigadores: elegir individuos de forma aleatoria dentro de una muestra. En la medida en que los ordenadores nos han facilitado la tarea de generar números aleatorios, este problema ha desaparecido.

    También se sigue utilizando para seleccionar individuos a lo largo del tiempo. Por ejemplo, para estudiar la satisfacción de un servicio, podemos elegir sistemáticamente encuestar a 1 de cada n clientes que nos visitan. En estas circunstancias, en las que puede existir diferente varianza entre individuos en diferentes periodos de tiempo, el muestreo sistemático puede ser incluso más preciso que el muestreo aleatorio puro.

    Es una técnica dentro de la categoría de muestreos probabilísticos – y que por lo tanto requiere tener un control preciso del marco muestral de individuos seleccionables junto con la probabilidad de que sean seleccionados – consistente en escoger un individuo inicial de forma aleatoria entre la población y, a continuación, seleccionar para la muestra a cada enésimo individuo disponible en el marco muestral.

    El muestreo sistemático es un proceso muy simple y que sólo requiere la elección de un individuo al azar. El resto del proceso es trivial y rápido. Los resultados que obtenemos son representativos de la población, de forma similar al muestreo aleatorio simple, siempre y cuando no haya algún factor intrínseco en la forma en que los individuos están listados que haga que se reproduzcan ciertas características poblacionales cada cierto número de individuos. Este suceso es realmente poco frecuente.

    Pasos (QuestionPro, 2022) y (QuestionPro, 2022):

    1. Es necesario desarrollar una audiencia estructural (muestra) definida para que el investigador comience a trabajar en el aspecto del muestreo.
    2. El investigador a cargo debe determinar el tamaño de la muestra ideal, es decir, cuántas personas de la población completa se van a elegir.
    3. La clave para obtener resultados precisos razonables y prácticos es tener una audiencia grande. Por ejemplo, si una ONG busca formar un muestreo sistemático de 500 voluntarios de una población de 5000, puede seleccionar a cada décima persona de la población (esto es básicamente de lo que se trata el muestreo sistemático).
    4. Una vez que se decida el número de tamaño de la muestra, se debe asignar un número a cada miembro de la muestra.
    5. Decide cuál será el intervalo de esta muestra. Este es básicamente la distancia estándar entre los elementos. Específicamente, el intervalo de muestreo (i) se calcula dividiendo el número de elementos en el marco de muestreo (N) por el tamaño de la muestra específica (n). El ejemplo mencionado anteriormente sugiere que el intervalo de muestra debe ser 10, que es el resultado de la división de 5000 (N= tamaño de la población) y 500 (N = tamaño de la muestra) (i) = N/n = 5000/500 = 10. El investigador debe seleccionar miembros que cumplan con este criterio. En este caso sería una persona de cada 10.
    6. Se debe elegir un número de manera aleatoria como miembro inicial (r) de la muestra, y este intervalo se agregará al número aleatorio para seguir agregando miembros tal que r, r+i, r+2i, r+3i, … (hasta agotar el marco de muestreo) serán elementos de la muestra.

    Ventajas (QuestionPro, 2022):

    1. Es extremadamente simple y conveniente para los investigadores crear, conducir y analizar las muestras.
    2. Como no es necesario enumerar a cada miembro de la muestra, el muestreo sistemático es mejor para representar a una población de manera más rápida y sencilla.
    3. Las muestras creadas se basan en la selección de miembros libre de favoritismos.
    4. En los otros métodos de muestreo hay posibilidades de que los conglomerados creados sean altamente sesgados, y esto comúnmente no sucede en el muestreo sistemático, ya que los miembros se encuentran a una distancia fija el uno del otro.
    5. El factor de riesgo involucrado en este método de muestreo es extremadamente mínimo.
    6. En caso de que haya diversos miembros de una población, el muestreo sistemático puede ser beneficioso debido a la distribución uniforme de los miembros que son seleccionados para formar una muestra.

    Referencias

    Ochoa, C. (5 de Mayo de 2015). Muestreo probabilístico: muestreo sistemático. Obtenido de netquest: https://www.netquest.com/blog/es/blog/es/muestreo-sistematico

    QuestionPro. (21 de Agosto de 2022). ¿Cómo realizar un muestreo sistemático? Obtenido de Investigación de Mercado: https://www.questionpro.com/blog/es/como-realizar-un-muestreo-sistematico/

    QuestionPro. (21 de Agosto de 2022). Muestreo sistemático: fácil, sencillo y económico. Obtenido de Encuestas: https://www.questionpro.com/blog/es/muestreo-sistematico/