Espartaco

“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”

Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290

27,992 views since December 2020

27,992 visitas desde diciembre de 2020

EnglishEspañol

Autor: José M. Gómez

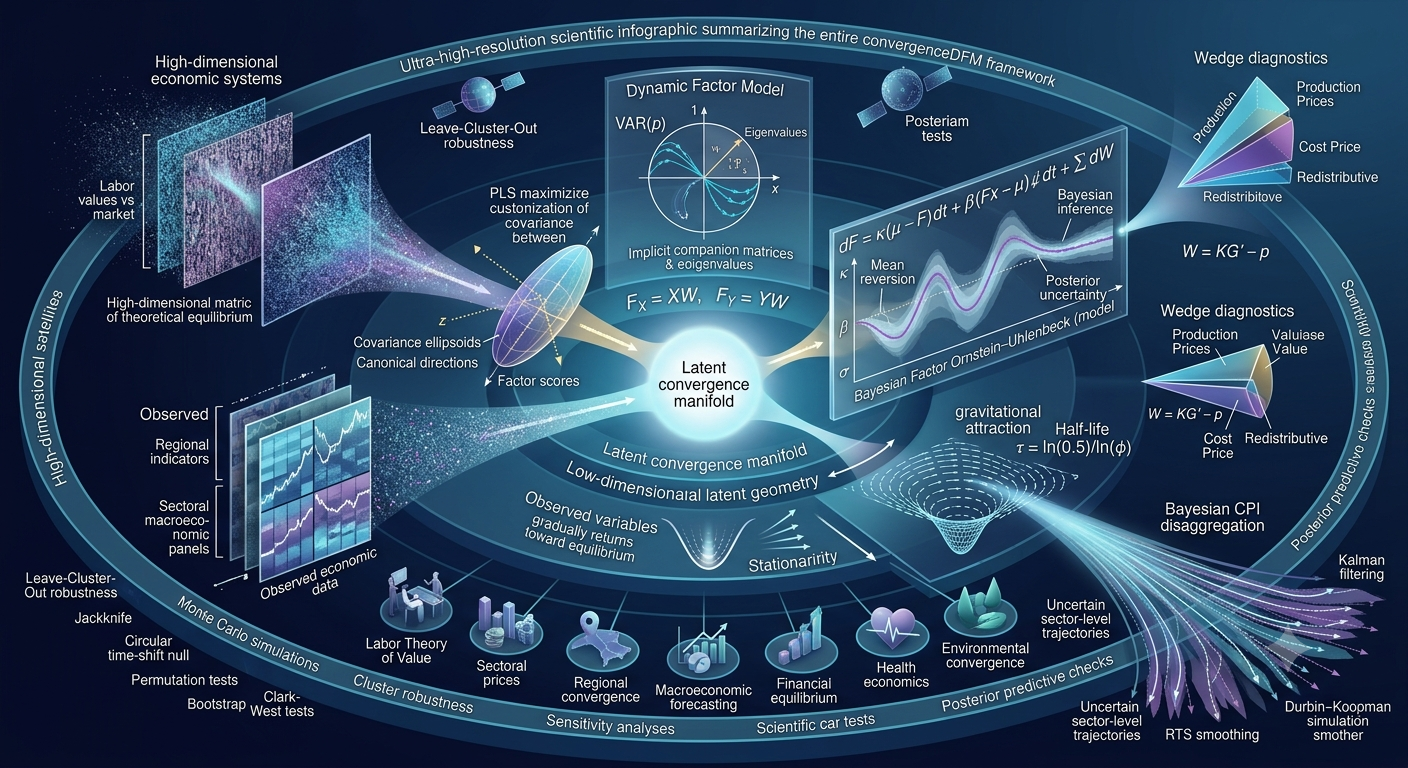
  • EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    EconCausal: Un Paquete de R Que Toma En Serio la Inferencia Causal en Series Temporales.

    Puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Inferencia causal · Series temporales · Validación predictiva

    Una relación estadística no basta: cómo EconCausal intenta comprobar si sobrevivirá al futuro

    Un paquete de R que integra modelos de corrección de errores, regresión no lineal, series temporales estructurales bayesianas, errores autorregresivos y validación temporal dentro de un protocolo reproducible para evaluar relaciones causales en series temporales.

    EconCausal · R · Econometría aplicada · GitHub

    Encontramos una relación en nuestros datos. Es estadísticamente significativa. Los coeficientes parecen razonables. Tal vez incluso encaje perfectamente con la teoría. Pero todavía queda una pregunta incómoda: ¿seguirá apareciendo dentro de seis meses, cuando el modelo tenga que enfrentarse a datos que aún no existen?

    Esta pregunta es especialmente importante en economía. Las relaciones temporales que parecen sólidas dentro de una muestra pueden desaparecer cuando cambia el régimen macroeconómico, cuando llega una crisis o, sencillamente, cuando el modelo deja de describir el pasado y tiene que predecir el futuro.

    EconCausal fue construido alrededor de ese problema. Su objetivo no es ofrecer un nuevo botón que convierta correlaciones en causalidad, sino imponer un procedimiento más exigente: preanalizar los datos, estimar la relación desde varios marcos metodológicos y obligarla a sobrevivir a pruebas temporales antes de aceptarla.

    La idea en una frase

    EconCausal funciona como una especie de línea de control de calidad para afirmaciones causales en series temporales: una relación candidata debe superar una secuencia explícita de pruebas antes de recibir luz verde.

    El problema: correlación hoy no significa estabilidad mañana

    Una regresión convencional puede indicarnos que dos variables se mueven juntas. Pero una covariación estadística no nos dice automáticamente por qué ocurre, en qué dirección opera la relación ni si seguirá apareciendo cuando cambien las condiciones económicas.

    En series temporales existe además una dificultad adicional: las observaciones no son intercambiables. El año 2020 viene después de 2019. El trimestre siguiente depende, en mayor o menor medida, de la historia anterior. Ignorar esta estructura puede generar resultados que parecen mucho más robustos de lo que realmente son.

    EconCausal aborda el problema combinando tres marcos metodológicos distintos. Ninguno de ellos pretende monopolizar el significado de causalidad; la idea es obtener perspectivas complementarias sobre una misma relación.

    ECM-MARS

    Combina corrección de errores y cointegración con Multivariate Adaptive Regression Splines para capturar ajustes no lineales entre equilibrio de largo plazo y dinámica de corto plazo.

    BSTS

    Descompone la serie en componentes estructurales dentro de un marco bayesiano y permite construir distribuciones contrafactuales y pronósticos con incertidumbre explícita.

    BGLM-AR(1)

    Ajusta un modelo lineal generalizado bayesiano mientras representa explícitamente la dependencia temporal de los errores mediante una estructura autorregresiva de primer orden.

    Primera vía: ECM-MARS y la diferencia entre corto y largo plazo

    Muchas variables económicas pueden alejarse entre sí durante períodos relativamente cortos y, sin embargo, mantener una relación de equilibrio a largo plazo.

    Ésta es precisamente la intuición detrás de un Modelo de Corrección de Errores o ECM. Si dos variables están cointegradas, sus movimientos de corto plazo pueden desviarse, pero existe alguna fuerza de ajuste que impide que esa divergencia crezca indefinidamente.

    En su forma conceptual más sencilla, podemos imaginar:

    $$ \Delta Y_t = \alpha + \lambda \left( Y_{t-1} – \beta X_{t-1} \right) + \gamma \Delta X_t + \varepsilon_t $$

    El término entre paréntesis representa el desequilibrio acumulado respecto de la relación de largo plazo. El parámetro $\lambda$ refleja la velocidad con la que el sistema responde a ese desequilibrio.

    El problema es que la respuesta real puede no ser lineal. Una economía podría tolerar pequeñas desviaciones durante bastante tiempo y reaccionar bruscamente cuando se cruza cierto umbral.

    Ahí aparece MARS —Multivariate Adaptive Regression Splines—. En lugar de obligar al ajuste a seguir una única pendiente lineal, MARS puede encontrar automáticamente regiones y umbrales donde la dinámica cambia.

    Intuición

    ECM aporta la arquitectura económica del equilibrio de largo plazo y la corrección de corto plazo; MARS permite que el mecanismo de ajuste sea flexible y potencialmente no lineal.

    Antes de estimar, hay que demostrar que el problema está bien planteado

    EconCausal no lanza automáticamente un ECM sobre cualquier par de series. Antes, el protocolo comprueba las condiciones que justifican un análisis de cointegración.

    Comprueba si las variables son integradas de orden uno, $I(1)$, condición previa para el análisis de cointegración utilizado por este procedimiento.

    Ejecuta las pruebas de cointegración de Engle-Granger y Johansen.

    Aplica una regla de tipo either: si cualquiera de las dos pruebas proporciona evidencia suficiente de cointegración, el análisis puede continuar.

    Controla correlación serial y heterocedasticidad mediante errores estándar consistentes HAC.

    Ajusta el ECM utilizando MARS como motor de regresión.

    Somete posteriormente la relación a validación temporal mediante ventanas de origen móvil.

    La utilización conjunta de Engle-Granger y Johansen es deliberada. Engle-Granger es relativamente directo, mientras que Johansen puede manejar estructuras de cointegración más ricas en contextos multivariados. El protocolo prefiere utilizar ambas perspectivas en lugar de hacer depender todo el análisis de una sola prueba.

    Segunda vía: BSTS y el contrafactual

    La segunda familia metodológica cambia la pregunta. En lugar de concentrarse primero en cointegración y corrección de errores, un modelo de Bayesian Structural Time Series representa la serie como un sistema de componentes estructurales.

    Conceptualmente, podemos pensar en una descomposición como:

    $$ Y_t = \mu_t + \tau_t + \mathbf{x}_t^{\top}\boldsymbol{\beta} + \varepsilon_t $$

    donde $\mu_t$ puede representar el nivel o tendencia, $\tau_t$ algún componente temporal adicional y $\mathbf{x}_t^{\top}\boldsymbol{\beta}$ el efecto de variables predictoras.

    Esta representación resulta especialmente útil para inferencia causal cuando queremos formular una pregunta contrafactual: ¿qué habría ocurrido con la variable analizada si una intervención o cambio determinado no hubiese sucedido?

    EconCausal incorpora además priors spike-and-slab, que realizan selección probabilística de variables. En lugar de incluir automáticamente todos los predictores o eliminarlos mediante procedimientos stepwise, el modelo estima qué variables tienen mayor probabilidad de pertenecer a la estructura predictiva.

    Al ser bayesiano, el resultado no es solamente una predicción puntual. Se obtiene una distribución posterior, lo que permite expresar explícitamente la incertidumbre asociada al contrafactual.

    Tercera vía: BGLM-AR(1) y el problema de los errores que recuerdan el pasado

    Uno de los errores más comunes en econometría aplicada consiste en estimar una regresión como si los residuos de un período no tuviesen ninguna relación con los del período anterior.

    En muchos procesos económicos esto es poco plausible.

    EconCausal incorpora por ello un Bayesian Generalized Linear Model con errores AR(1). Una representación básica de la estructura residual es:

    $$ \varepsilon_t = \rho\varepsilon_{t-1} + \eta_t, \qquad |\rho|<1 $$

    Si $\rho$ es distinto de cero, parte del error actual está relacionado con el error del período anterior.

    Ignorar esa dependencia puede generar intervalos excesivamente estrechos y una falsa sensación de precisión. Modelarla explícitamente permite que la incertidumbre estadística refleje mejor la estructura temporal de los datos.

    La estimación se realiza mediante Hamiltonian Monte Carlo a través de Stan, con priors débilmente informativas calibradas para variables estandarizadas.

    La regla que hace distinto al protocolo: no basta con mejorar una sola métrica

    Uno de los elementos centrales de EconCausal es su criterio dual de evaluación.

    Una relación candidata no se considera respaldada simplemente porque obtenga mejores predicciones puntuales, ni porque mejore la distribución predictiva. Debe mejorar simultáneamente ambas dimensiones.

    1. Densidad predictiva — ELPD

    Se evalúa la calidad de la distribución predictiva mediante Expected Log Predictive Density, utilizando PSIS-LOO cuando corresponde.

    2. Precisión puntual — RMSE

    También debe mejorar la precisión de los pronósticos puntuales, evaluada mediante Root Mean Squared Error.

    Esto importa porque ambos criterios responden preguntas distintas. Un modelo podría reducir el RMSE y, al mismo tiempo, producir una distribución de incertidumbre peor calibrada. Otro podría representar muy bien la incertidumbre, pero producir predicciones centrales peores.

    EconCausal exige superar ambos filtros.

    La prueba decisiva: dejar que el futuro haga de árbitro

    El rasgo más característico del protocolo aparece en la validación. Una relación temporal no se considera estable porque haya funcionado en una única partición de entrenamiento y prueba.

    El paquete utiliza validación Leave-Future-Out con ventanas y horizontes configurables.

    La lógica es:

    $$ \underbrace{ y_1,\ldots,y_t }_{\text{entrenamiento}} \quad\longrightarrow\quad \underbrace{ y_{t+1},\ldots,y_{t+h} }_{\text{futuro}} $$

    Después el punto de corte avanza y el proceso se repite:

    Se entrena utilizando únicamente información disponible hasta cierto momento.

    Se pronostican observaciones estrictamente posteriores.

    Se calcula el desempeño predictivo.

    La frontera temporal avanza.

    El procedimiento se repite en múltiples ventanas.

    El resultado incluye una medida de soporte temporal: la proporción de ventanas en las que la relación continúa satisfaciendo los criterios establecidos.

    Por qué esto importa

    Una relación que funciona magníficamente en una única ventana puede ser casualidad. Una relación que reaparece sistemáticamente cuando el modelo debe predecir distintos segmentos futuros ofrece una evidencia mucho más difícil de atribuir a una partición afortunada de la muestra.

    Menos libertad invisible para el investigador

    Buena parte del análisis aplicado contiene decisiones que el lector nunca llega a observar: qué transformación se probó primero, qué ventana se descartó, qué modelo alternativo se abandonó, qué umbral se modificó después de mirar los resultados.

    Este problema suele describirse como researcher degrees of freedom.

    EconCausal intenta reducirlos mediante un protocolo explícito: prepruebas, reglas de aceptación, umbrales y procedimientos de validación están integrados dentro del mismo flujo reproducible.

    Esto no elimina el juicio científico. Pero vuelve más visible qué reglas condujeron desde los datos hasta la conclusión.

    ¿Dónde está la novedad?

    No en inventar desde cero Engle-Granger, Johansen, MARS, BSTS, modelos AR(1), Stan, PSIS-LOO o validación temporal.

    Todas estas herramientas tienen antecedentes bien establecidos.

    Según una evaluación de novedad incluida en la documentación del paquete, la contribución reside en la combinación de esos componentes dentro de un protocolo end-to-end concreto, con prepruebas, reglas duales de decisión, umbrales de soporte y validación temporal.

    Esa distinción es importante: la afirmación metodológica no es “hemos inventado nuevas matemáticas”, sino “hemos convertido varias técnicas existentes en un procedimiento único, explícito y auditable”.

    ¿Quién podría utilizar EconCausal?

    Aunque el paquete fue desarrollado inicialmente para investigación económica, el problema que intenta resolver es mucho más general: relaciones direccionales entre variables observadas a lo largo del tiempo.

    Macroeconomía

    Para estudiar relaciones entre producción, precios, salarios, inversión, crédito, empleo u otras variables con dinámica temporal.

    Política pública

    Para evaluar si una relación asociada a una intervención permanece estable bajo distintos contextos económicos.

    Finanzas

    Para diferenciar una asociación histórica aparente de una relación que mantiene capacidad predictiva fuera de muestra.

    También puede servir como herramienta pedagógica para estudiantes de econometría e inferencia causal, precisamente porque obliga a recorrer etapas que en un análisis manual resultan fáciles de omitir.

    Instalación

    El paquete puede instalarse directamente desde GitHub:

    # Instalar desde GitHub
    remotes::install_github("IsadoreNabi/EconCausal")
    
    # En Windows, si falla la construcción de las viñetas:
    remotes::install_github(
      "IsadoreNabi/EconCausal",
      build_vignettes = FALSE
    )

    EconCausal utiliza una infraestructura bayesiana moderna, incluyendo cmdstanr para muestreo HMC, loo para cálculos PSIS-LOO y bsts para los componentes de series temporales estructurales.

    Lo que EconCausal no puede hacer por vos

    Un protocolo riguroso no convierte datos pobres en datos excelentes.

    Si la muestra es demasiado pequeña, las variables contienen errores de medición importantes o existen rupturas estructurales tan fuertes que destruyen la relación estudiada, ningún paquete estadístico puede eliminar mágicamente esas limitaciones.

    Tampoco sustituye el conocimiento del dominio.

    Que una relación sea estable, direccional y predictivamente robusta es una evidencia importante, pero una interpretación causal todavía necesita un mecanismo teórico, una consideración seria de variables confusoras y una evaluación de los supuestos identificadores.

    Límite fundamental

    EconCausal intenta disciplinar la inferencia estadística. No puede decidir por sí solo qué mecanismo causal existe en el mundo real.

    La cuestión de fondo

    En análisis temporal es relativamente fácil encontrar relaciones que describen bien el pasado. Lo difícil es encontrar relaciones que permanezcan cuando llega información nueva.

    EconCausal desplaza por ello parte del énfasis metodológico desde “¿obtuvimos significancia?” hacia una pregunta más dura: “¿esta relación sigue funcionando cuando le pedimos que sobreviva fuera de la muestra donde la descubrimos?”

    Esa diferencia puede parecer pequeña, pero cambia la filosofía del análisis. La significancia estadística deja de ser la meta final y se convierte apenas en una pieza dentro de una cadena de validación mucho más amplia.

    La contribución de EconCausal está en el protocolo. ECM-MARS, BSTS, modelos bayesianos con errores AR(1), HMC, PSIS-LOO, RMSE y validación Leave-Future-Out ya pertenecen al repertorio de la econometría moderna. Lo distintivo es obligarlos a trabajar juntos bajo reglas explícitas y reproducibles, de modo que una relación no sea aceptada porque se vea convincente en una muestra, sino porque resista una batería organizada de pruebas y mantenga apoyo cuando se enfrenta al futuro.

    EconCausal está disponible en GitHub. Las metodologías subyacentes se apoyan, entre otros trabajos, en Engle & Granger (1987), Johansen (1991), Friedman (1991), Scott & Varian (2014), Vehtari et al. (2017) y Hyndman & Athanasopoulos (2021).
  • bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

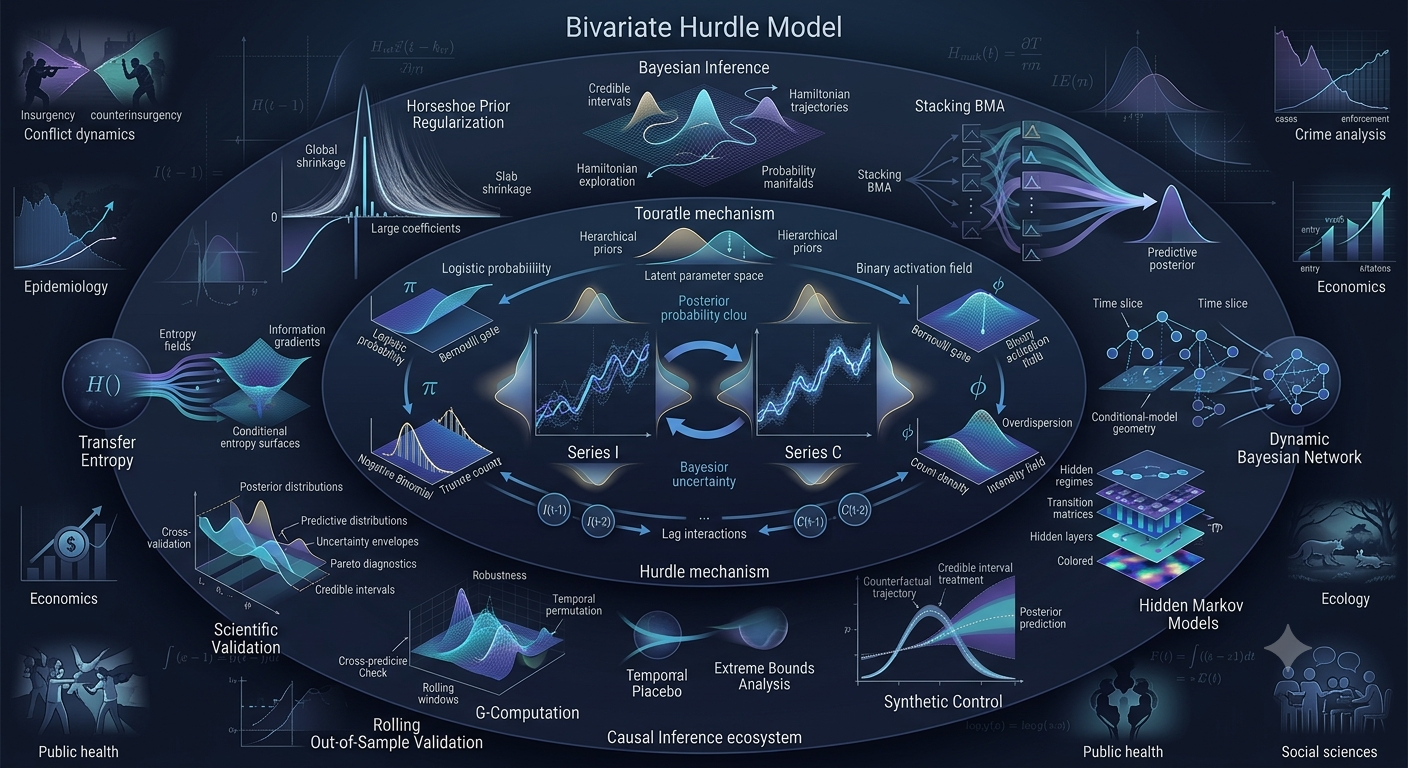
    bivarhr: Cuando Dos Series de Conteo Necesitan Comunicarse: Un Marco Bayesiano Para Modelos de Umbral Bivariados

    También puedes encontrar esta librería en CRAN y descargarla directamente desde R y RStudio.

    Estadística bayesiana · Series temporales · Inferencia causal

    Cuando dos series tienen demasiados ceros: una introducción a bivarhr

    Un paquete de R que combina modelos hurdle bivariados, regularización horseshoe, comparación predictiva y múltiples estrategias de inferencia causal para uno de esos problemas que parecen sencillos hasta que uno intenta analizarlos de verdad.

    Por José Mauricio Gómez Julián · CRAN · GitHub

    Imaginemos que queremos estudiar dos procesos que evolucionan juntos en el tiempo. Podrían ser ataques insurgentes y operaciones contrainsurgentes, casos de una enfermedad y muertes asociadas, protestas y respuestas del gobierno, entradas y salidas de empresas o cualquier otro par de fenómenos registrados como conteos.

    Hasta aquí nada parece especialmente extraño. Tenemos series temporales, tenemos conteos y tenemos una considerable caja de herramientas estadística. El problema comienza cuando los datos se parecen más al mundo real que a los ejemplos de un manual.

    Puede ocurrir que durante la mayor parte del tiempo no suceda absolutamente nada: cero ataques, cero protestas, cero extinciones, cero nuevos casos. Después, cuando finalmente ocurre algo, el número observado puede variar enormemente. A eso se suma otra dificultad: las dos series pueden influenciarse predictivamente entre sí con rezagos, mientras docenas de variables adicionales compiten por entrar en el modelo.

    bivarhr fue diseñado precisamente para trabajar en ese cruce de problemas.

    La idea en una frase

    En lugar de tratar por separado el exceso de ceros, la dinámica entre ambas series, la selección de variables, la incertidumbre sobre el modelo y la evidencia causal, bivarhr intenta integrarlos dentro de un único flujo de análisis reproducible.

    Primero: ¿por qué tantos ceros son un problema?

    Un modelo de Poisson convencional presupone una estructura relativamente simple para los conteos. La distribución binomial negativa permite mayor dispersión y suele funcionar mejor cuando la variabilidad excede lo que admitiría un Poisson.

    Pero ninguna de esas decisiones resuelve automáticamente un conjunto de datos en el que, por ejemplo, el 60 %, 70 % u 80 % de las observaciones son exactamente cero.

    Un modelo hurdle aborda el problema dividiéndolo conceptualmente en dos mecanismos.

    1. Primero pregunta si el proceso logra cruzar el “obstáculo”: ¿ocurrió algo o el resultado fue cero?
    2. Solamente después, condicionando a que ocurrió algo, pregunta: ¿cuánto ocurrió?

    La primera parte puede modelarse mediante una distribución Bernoulli con enlace logit. La segunda, en bivarhr, mediante una binomial negativa truncada en cero.

    Formalmente, para una de las series \(I\) en el instante \(t\):

    \[ P(Y_{I,t}=0)=1-\pi_{I,t} \]

    mientras que, para un conteo positivo,

    \[ P(Y_{I,t}=y\mid y>0) = \pi_{I,t} \frac{ f_{\mathrm{NB}}(y\mid\mu_{I,t},\phi_I) }{ 1-f_{\mathrm{NB}}(0\mid\mu_{I,t},\phi_I) } \]

    Aquí, \(\pi_{I,t}\) representa la probabilidad de observar un valor distinto de cero, \(\mu_{I,t}\) controla el conteo esperado una vez superado el hurdle y \(\phi_I\) gobierna la dispersión.

    Esta separación es importante. El proceso que determina si sucede algo no tiene por qué ser el mismo que determina la intensidad de lo que sucede.

    ¿Y qué aporta que el modelo sea bivariado?

    Supongamos que llamamos \(I\) y \(C\) a nuestras dos series. Analizarlas por separado perdería precisamente una de las preguntas más interesantes: ¿contiene el pasado de una información útil para predecir el futuro de la otra?

    bivarhr permite introducir valores rezagados de \(C\) en la ecuación correspondiente a \(I\), valores rezagados de \(I\) en la de \(C\), ambas cosas simultáneamente o ninguna.

    Especificación C → I I → C Lectura
    A Sí No C contiene información predictiva rezagada sobre I
    B No Sí I contiene información predictiva rezagada sobre C
    C Sí Sí Dinámica predictiva bidireccional
    D No No Sin efectos cruzados rezagados

    Esta comparación permite estudiar causalidad en el sentido de Granger: si conocer el pasado de una variable mejora sistemáticamente la predicción de otra una vez considerada la información pertinente.

    Una distinción importante

    La causalidad de Granger es una afirmación sobre precedencia e información predictiva. No equivale, por sí sola, a demostrar una relación causal estructural. Precisamente por eso bivarhr no termina el análisis en los rezagos cruzados: incorpora otras herramientas que permiten contrastar la misma hipótesis desde ángulos diferentes.

    Muchos predictores, pocos datos: el papel del horseshoe

    Imaginemos ahora que, además de ambas series, disponemos de indicadores económicos, variables institucionales, condiciones climáticas, tendencias, cambios de régimen y distintas transformaciones de cada una.

    El número de parámetros puede crecer rápidamente. Con una muestra relativamente pequeña, un modelo suficientemente flexible puede terminar aprendiendo ruido.

    Para enfrentarse a este problema, bivarhr utiliza la prior horseshoe regularizada.

    La intuición es sencilla aunque su formulación matemática sea más rica: los coeficientes que no encuentran suficiente respaldo en los datos son fuertemente contraídos hacia cero, mientras que las señales verdaderamente importantes pueden escapar de esa contracción.

    El mecanismo combina un parámetro global de contracción, \(\tau\), que controla el nivel general de esparsidad, con parámetros locales \(\lambda_j\), capaces de adaptarse a cada coeficiente. La versión regularizada empleada por el paquete sigue el enfoque de Piironen y Vehtari y limita además comportamientos excesivamente extremos de los coeficientes.

    En términos prácticos, esto significa que el investigador no necesita convertir la selección manual de variables en una sucesión interminable de decisiones ad hoc.

    El problema que viene después: ¿qué modelo elegimos?

    Incluso después de definir la estructura general, queda una decisión incómoda. ¿Cuántos rezagos deberíamos utilizar? ¿Uno? ¿Dos? ¿Tres? ¿Qué grado de regularización es apropiado?

    La respuesta habitual consiste en escoger el modelo que obtiene el mejor valor de algún criterio y descartar los demás.

    bivarhr sigue otra filosofía. Combina modelos mediante predictive stacking, asignándoles pesos según su capacidad predictiva.

    \[ p_{\mathrm{stack}}(y_t) = \sum_{m=1}^{M} w_m\, p(y_t\mid y_{1:t-1},\mathcal{M}_m) \]

    Los pesos se estiman buscando maximizar la densidad logarítmica predictiva esperada —ELPD—, evaluada mediante PSIS-LOO. En términos menos técnicos: los modelos que predicen mejor reciben más influencia y los que predicen peor reciben menos.

    El resultado evita hacer depender toda la inferencia de una única decisión sobre el número exacto de rezagos o sobre un solo conjunto de hiperparámetros.

    De la predicción a la causalidad: buscar evidencia convergente

    Probablemente éste sea el aspecto más ambicioso del paquete. bivarhr no propone que un único procedimiento estadístico resuelva automáticamente el problema de la causalidad. En su lugar, proporciona varias herramientas complementarias.

    Entropía de transferencia

    Pregunta cuánto reduce el pasado de una serie nuestra incertidumbre acerca de la otra, más allá de la información contenida en su propio pasado. A diferencia del Granger lineal tradicional, procede desde la teoría de la información.

    Redes Bayesianas Dinámicas

    Buscan aprender relaciones dirigidas entre variables situadas en distintos momentos, permitiendo distinguir conexiones directas de estructuras mediadas por otras variables.

    Modelos Ocultos de Markov

    Permiten investigar si ambas series parecen estar gobernadas por estados latentes, como períodos de calma, transición o escalada que no fueron etiquetados previamente.

    VARX

    Aporta una comprobación desde la tradición clásica de series temporales, incluyendo diagnósticos de estabilidad, autocorrelación, normalidad y efectos ARCH.

    Análisis de sensibilidad

    Siguiendo a Cinelli y Hazlett, cuantifica cuán potente tendría que ser un confusor no observado para explicar un efecto estimado.

    Control sintético

    Mediante series temporales estructurales bayesianas puede construir un escenario contrafactual y comparar lo observado con lo que habría ocurrido en ausencia de una intervención.

    Ninguno de estos métodos convierte mágicamente una asociación en causalidad. Su utilidad reside en otra cosa: permiten preguntar si una conclusión sobrevive cuando el mismo problema se examina mediante representaciones y supuestos diferentes.

    Un resultado no vale mucho si desaparece al tocar el modelo

    Una parte importante de bivarhr está dedicada no a producir resultados nuevos, sino a intentar destruir los resultados que ya obtuvimos.

    Ésa es una virtud.

    Placebos temporales

    Si se altera aleatoriamente el orden temporal de los datos y el modelo continúa funcionando igual de bien, existe un problema: quizá no estaba aprendiendo realmente la dinámica temporal.

    Evaluación fuera de muestra

    El paquete permite ajustar modelos en fracciones sucesivas de la muestra y evaluar sus pronósticos sobre las observaciones restantes. En lugar de preguntar solamente qué tan bien describe el modelo los datos conocidos, preguntamos qué tan bien funciona cuando tiene que enfrentarse a datos que no utilizó para estimarse.

    Análisis de límites extremos

    También puede reestimarse el modelo bajo distintas combinaciones de controles. Si un resultado fundamental cambia de signo o desaparece cada vez que modificamos ligeramente la especificación, tenemos razones para desconfiar de su robustez.

    G-computation

    Finalmente, la simulación posterior permite construir cantidades contrafactuales del tipo: ¿cómo cambiaría \(I\) si elimináramos determinados rezagos cruzados o variables de transición? Así es posible expresar los resultados en términos de efectos promedio del tratamiento bajo la especificación causal adoptada.

    ¿En qué campos puede resultar útil?

    El paquete nació alrededor de un problema estadístico, no de una disciplina particular. Por eso su campo potencial de aplicación es amplio.

    Campo Ejemplos de pares de procesos
    Salud pública Casos y mortalidad; hospitalizaciones y reingresos; vacunación y brotes.
    Criminología Delitos y respuestas policiales; incautaciones y sobredosis.
    Economía Entradas y salidas de empresas; patentes y citas; determinados conteos asociados a flujos comerciales.
    Ecología Depredadores y presas; aparición y desaparición de especies; colonización y extinción local.
    Ciencia política Protestas y respuestas gubernamentales; iniciativas legislativas y vetos.
    Entornos digitales Publicaciones de desinformación y actividad posterior de verificación.

    ¿Qué ocurre bajo el capó?

    Aunque el objetivo del paquete es ofrecer un flujo integrado, la infraestructura estadística es plenamente bayesiana allí donde se ajusta el modelo hurdle principal.

    Componente Implementación
    Muestreo Stan NUTS mediante cmdstanr
    Regularización Horseshoe regularizado
    Evaluación predictiva PSIS-LOO y ELPD
    Combinación de modelos Pesos de predictive stacking
    Convergencia \(\hat{R}\), ESS y divergencias
    Diagnóstico LOO Valores de Pareto \(k\)

    El código Stan tampoco constituye una caja negra: puede inspeccionarse mediante get_hurdle_model(), mientras que las cantidades generadas permiten obtener log-verosimilitudes por observación, predicciones posteriores y valores ajustados.

    Empezar a utilizar bivarhr

    El paquete puede instalarse desde GitHub, mientras que también dispone de distribución a través de CRAN.

    # Instalación desde GitHub
    devtools::install_github("isadorenabi/bivarhr")
    
    # Instalar cmdstanr
    install.packages(
      "cmdstanr",
      repos = c(
        "https://stan-dev.r-universe.dev",
        getOption("repos")
      )
    )
    
    cmdstanr::install_cmdstan()
    
    # Paquetes opcionales para el conjunto completo
    # de herramientas causales
    install.packages(c(
      "RTransferEntropy",
      "bnlearn",
      "sensemakr",
      "CausalImpact",
      "vars",
      "openxlsx"
    ))

    Un ajuste mínimo con dos rezagos y efectos cruzados en ambas direcciones puede escribirse de forma compacta:

    fit <- fit_one(
      DT,
      k = 2,
      spec = "C",
      iter_warmup = 500,
      iter_sampling = 500,
      chains = 2
    )
    
    print(fit$fit$summary())

    Si queremos comparar múltiples órdenes de rezago y configuraciones de la prior horseshoe, podemos construir una cuadrícula y dejar que el procedimiento de selección y stacking evalúe el conjunto:

    hs_grid <- expand.grid(
      hs_tau0 = c(0.1, 0.5, 1.0),
      hs_slab_scale = c(1, 5),
      hs_slab_df = 4
    )
    
    bma_results <- select_by_bma(
      DT = DT,
      spec = "C",
      k_grid = 0:3,
      hs_grid = hs_grid,
      iter_warmup = 1000,
      iter_sampling = 1200,
      chains = 4,
      use_parallel = TRUE
    )
    
    print(bma_results$table)

    El punto más interesante no es un modelo: es el flujo de trabajo

    Es fácil describir bivarhr enumerando sus piezas: binomial negativa hurdle, horseshoe, Stan, PSIS-LOO, stacking, entropía de transferencia, redes bayesianas, modelos de Markov, VARX y análisis contrafactual.

    Pero hacer solamente esa lista oculta lo más interesante del proyecto.

    Prácticamente ninguno de esos métodos existe únicamente dentro de bivarhr. Lo particular es su intento de reunirlos alrededor de una secuencia coherente de preguntas.

    ¿Los ceros forman parte central del proceso? Entonces hay que modelarlos explícitamente. ¿Las dos variables evolucionan conjuntamente? Entonces no conviene estimarlas como mundos separados. ¿Hay demasiados predictores? Regularicemos. ¿No sabemos qué especificación elegir? Incorporémoslo a la incertidumbre predictiva. ¿Queremos hablar de causalidad? No dependamos de una única evidencia. ¿Encontramos un efecto? Intentemos romperlo con placebos, cambios de especificación y evaluación fuera de muestra.

    Ésa es, en última instancia, la apuesta de bivarhr: que la solidez de una investigación aplicada no depende únicamente de utilizar una técnica estadística sofisticada, sino de construir un camino reproducible desde los datos hasta la conclusión y someter cada tramo de ese camino a comprobaciones independientes.

    bivarhr es software de código abierto distribuido bajo licencia MIT. Disponible en CRAN y GitHub. Autor: José Mauricio Gómez Julián · ORCID.

  • Economía Política y Teoría de las Probabilidades: Smith, Marx y la Ley de los Grandes Números

    Economía Política y Teoría de las Probabilidades: Smith, Marx y la Ley de los Grandes Números

    El Cuaderno de Economía Política
    Explorando la economía más allá de los manuales

    ¿Todos los trabajadores son explotados por igual?
    Un supuesto marxiano puesto a prueba con teoría de probabilidades

    Cómo sesenta años de datos sectoriales de Estados Unidos y versiones no clásicas de la Ley de los Grandes Números permiten examinar un supuesto fundamental detrás de la tasa media de ganancia marxiana

    ~ 9 min de lectura

    Detrás de los análisis marxistas de la tasa media de ganancia existe un supuesto importante siempre que no se modelan explícitamente las diferencias en el grado de explotación del trabajo entre los distintos sectores productivos: las tasas sectoriales de plusvalía pueden tratarse como magnitudes que tienden hacia la uniformidad. Adam Smith proporcionó el argumento económico original para esta tendencia y, dentro de la economía política marxista, el postulado adquirió una importancia central. Pero ¿puede defenderse esa tendencia cuando los sectores reales no son independientes ni estadísticamente idénticos? Un artículo publicado en 2022 por José Mauricio Gómez Julián en Ciencia Económica aborda el problema simultáneamente desde tres direcciones: la teoría de probabilidades, los mecanismos concretos del mercado de trabajo estudiados por Smith y Marx, y evidencia estadística de Estados Unidos correspondiente al período 1960–2020.

    El problema, en lenguaje sencillo

    En la teoría marxista, la plusvalía es el valor producido por el trabajo más allá del valor representado por la fuerza de trabajo. Para llevar este concepto al terreno empírico, el artículo utiliza una aproximación basada en la contabilidad nacional moderna: el excedente bruto de operación representa el tiempo de trabajo excedente y las remuneraciones de los trabajadores representan el tiempo de trabajo necesario. El cociente entre ambos proporciona la tasa sectorial empleada en el análisis estadístico.

    La cuestión importa porque la tendencia hacia la uniformidad de las tasas sectoriales de plusvalía forma parte de la base sobre la cual se construyen la tasa media de ganancia y, consiguientemente, los precios de producción marxianos. Pero aquí existe un matiz fundamental. El artículo no presenta los precios de producción como precios de equilibrio preexistentes alrededor de los cuales los precios de mercado simplemente oscilan. Siguiendo a Carchedi y de Haan, adopta una interpretación dinámica: los precios de mercado existen primero y la competencia capitalista —incluidas la competencia tecnológica y la movilidad de los capitales— los presiona hacia un promedio sistémico. Los precios de producción existen precisamente a través de este proceso de convergencia, y no como un centro fijo establecido de antemano.

    La pregunta empírica, por tanto, no consiste en determinar si todas las industrias poseen exactamente la misma tasa de explotación en cada instante. Lo que se somete a examen es una tendencia hacia la uniformidad asintótica: cuando el análisis se aproxima a un período suficientemente largo y/o a un conjunto suficientemente grande de sectores relevantes, ¿se comportan las tasas sectoriales de una manera compatible con la convergencia hacia un valor esperado global?

    Por qué importa la perspectiva asintótica

    El artículo conecta esta pregunta con la teoría del conocimiento de Marx. Su argumento es que el método marxiano no puede reducirse a aceptar pasivamente hechos empíricos aislados. Mediante una apropiación materialista de la dialéctica hegeliana, el análisis privilegia la totalidad: el fenómeno debe comprenderse a través de sus relaciones, de su desarrollo y del sistema más amplio del que forma parte. En el artículo, la expresión régimen asintótico condensa estadísticamente esta idea: un horizonte temporal suficientemente largo, un número suficientemente grande de unidades o ambas cosas.

    Esto importa porque un sector observado aisladamente puede diferir sustancialmente de otro. La uniformidad, si existe, no tiene por qué aparecer como igualdad punto por punto. Puede ser una propiedad que sólo se vuelve visible cuando el sistema se considera a una escala suficientemente grande.

    Entra en escena la Ley de los Grandes Números

    El marco matemático es la Ley de los Grandes Números (LGN). En términos generales, las leyes de los grandes números describen las condiciones bajo las cuales los promedios se estabilizan alrededor de un valor esperado conforme aumenta la cantidad de información. La versión fuerte se refiere a la convergencia casi segura; la versión débil, a la convergencia en probabilidad.

    La dificultad aparece inmediatamente. Las formulaciones clásicas suelen descansar en supuestos fuertes, entre ellos la independencia y la identidad de distribución. Estas condiciones no son realistas para los sectores de una economía capitalista. Las industrias interactúan mediante cadenas productivas, competencia, salarios, tecnología, demanda y movimientos de capital; además, sus estructuras productivas son diferentes. Los propios resultados estadísticos del artículo confirman que las variables sectoriales ni son idénticamente distribuidas ni son, en términos generales, linealmente independientes.

    Esto no vuelve irrelevante a la LGN. Por el contrario, la parte teórica del estudio pregunta si versiones más generales de la ley pueden acomodar la estructura del problema económico. La respuesta es afirmativa, pero condicionada: distintos resultados matemáticos flexibilizan diferentes componentes de los supuestos clásicos y no todos lo hacen de la misma manera.

    Lo que realmente establece la literatura matemática

    • Li, Rao y Wang (1995): estudian una ley fuerte para sumas ponderadas de variables aleatorias independientes con índices multidimensionales, sujeta a condiciones estructurales y de momentos específicas.
    • Adler y Rosalsky (1987): establecen un resultado de ley fuerte para sumas ponderadas normalizadas de variables aleatorias independientes e idénticamente distribuidas.
    • Chen y Sung (2016): generalizan resultados relativos a sumas ponderadas bajo condiciones de dominación estocástica y ponderación, flexibilizando restricciones relevantes sobre la estructura distributiva.
    • Sung (2011): es especialmente importante para la aplicación económica porque proporciona condiciones suficientes bajo las cuales las variables pueden ser dependientes, sujetas a requisitos sobre sus momentos y otras condiciones técnicas.
    • Andrews (1988) y Davidson (2021): proporcionan resultados relativos a leyes débiles y un marco más amplio para procesos débilmente dependientes, incluidas estructuras de tipo mixingala relevantes para la econometría.
    «La lógica del planteamiento de Smith relativo a la ley de tendencia hacia la UTP es consistente con la lógica detrás de determinadas variedades de la LGN». Gómez Julián, 2022

    La palabra determinadas es esencial. El artículo no sostiene que la simple invocación de una LGN no clásica demuestre automáticamente la proposición marxiana. La consistencia formal depende de que se satisfagan las condiciones del teorema particular que se esté utilizando. En algunos casos pueden ser necesarias transformaciones del conjunto de datos: por ejemplo, agrupar o desagregar sectores, organizar observaciones en estructuras como triangular arrays, o estimar períodos faltantes cuando corresponda. Que dichos requisitos puedan satisfacerse efectivamente depende del conjunto de datos concreto.

    ¿Qué cuenta como sector productivo?

    Antes de realizar el análisis estadístico, el artículo afronta un problema de clasificación específicamente marxiano: no toda actividad que aparece en las cuentas nacionales debe incorporarse necesariamente al cálculo de la tasa media de ganancia. Los sectores pertinentes son aquellos considerados productivos en relación con el circuito del capital y con la producción de plusvalía.

    La distinción es particularmente importante en el sector servicios. A partir de la literatura sobre trabajo productivo e improductivo, el estudio distingue entre actividades que producen directamente plusvalía, actividades que facilitan su producción en otros lugares y actividades situadas fuera del circuito del capital relevante para el análisis. Después de armonizar las clasificaciones sectoriales a lo largo del período histórico y aplicar esos criterios teóricos, el análisis empírico trabaja con 36 sectores productivos.

    Lo que muestran los datos de Estados Unidos

    El componente empírico utiliza datos de la Oficina de Análisis Económico de Estados Unidos (Bureau of Economic Analysis, BEA) correspondientes al período 1960–2020. Las tasas sectoriales de plusvalía se construyen a partir del excedente bruto de operación y las remuneraciones de los trabajadores, y posteriormente se analizan sus distribuciones de probabilidad, las correlaciones de Pearson entre pares de sectores y las diferencias entre los parámetros de localización sectoriales y sus equivalentes globales.

    Principales resultados empíricos

    • Los sectores no están idénticamente distribuidos: de los 36 sectores, 16 se ajustan mejor a una distribución uniforme, 13 a Cauchy, 3 a logística, 2 a lognormal y 2 a Weibull. Ninguno presenta a la distribución normal como su mejor ajuste.
    • Los sectores no son, en términos generales, linealmente independientes: se calculan 630 correlaciones de Pearson por pares. Su media es aproximadamente 0,081 y su mediana aproximadamente 0,140.
    • La dependencia por pares de magnitud apreciable no es excepcional: 256 de las 630 correlaciones —aproximadamente el 40,63 %— son iguales o superiores a 0,30. El artículo concluye por ello que los sectores no pueden tratarse, en términos generales, como linealmente independientes.
    • La mayoría de las medidas resumen de las diferencias se aproximan a cero: respecto de la media global, la suma de las diferencias sectoriales es aproximadamente 3,38 × 10⁻¹⁴ y su media aproximadamente 9,38 × 10⁻¹⁶. Respecto de la mediana global, los valores correspondientes también son pequeños.
    • Existe una excepción importante: la mediana de las diferencias calculadas con respecto a la media global no se encuentra próxima a cero. Por ello, el artículo habla de una tendencia general hacia la nulificación recíproca, y no de una cancelación perfecta en todos los estadísticos.
    • Las diferencias presentan formas distributivas distintas: las calculadas respecto de la media global se ajustan mejor a una distribución de Cauchy, con la logística como segunda opción; las calculadas respecto de la mediana global se ajustan mejor a una uniforme, con la normal como segunda opción.

    Este patrón es importante precisamente porque los datos empíricos no reproducen los supuestos de la LGN clásica. Los sectores continúan siendo heterogéneos e interdependientes. Sin embargo, el comportamiento descriptivo de sus desviaciones proporciona, según la interpretación del autor, evidencia favorable a una tendencia hacia la nulificación recíproca cuando el sistema se considera como una totalidad.

    Por qué se dejaron de lado las pruebas convencionales de significancia

    El artículo considera inicialmente pruebas para evaluar las diferencias entre medias o medianas sectoriales y sus equivalentes globales, entre ellas procedimientos t de Student y de Wilcoxon, acompañados de bootstrapping. Finalmente sostiene que las pruebas inferenciales disponibles no son adecuadas para extraer conclusiones válidas a partir de esta estructura particular de datos.

    El problema no se reduce a la ausencia de normalidad. Dependiendo del procedimiento, resultan relevantes supuestos acerca de la forma de las distribuciones, la independencia lineal, el emparejamiento de las observaciones y la igualdad de tamaños muestrales. Las variables económicas son interdependientes por su propia naturaleza y el bootstrapping no elimina toda la dificultad: aunque el remuestreo puede romper la relación entre los grupos inmediatamente comparados, no elimina la dependencia existente entre los componentes sectoriales que conforman el grupo global.

    Existe además un matiz especialmente importante: las pruebas descartadas sí indicaron diferencias estadísticamente significativas. Aun así, el artículo se niega a tratar esos resultados como evidencia inferencial válida porque no se satisfacen adecuadamente las condiciones necesarias. En consecuencia, sustituye esa vía inferencial por un análisis descriptivo —o, como el propio artículo sugiere, quizá más precisamente semidescriptivo— basado en el comportamiento y en las distribuciones de probabilidad de las diferencias.

    Smith, Marx y el mecanismo económico

    El argumento probabilístico constituye sólo una dimensión de la investigación. Una segunda dimensión vuelve a la explicación de Adam Smith sobre el ajuste del mercado de trabajo. Smith sostiene que las ventajas y desventajas totales de los diferentes empleos existentes en una misma localidad deben ser iguales o tender constantemente hacia la igualdad; de lo contrario, los movimientos de trabajadores y capitales tenderían a erosionar las condiciones excepcionalmente favorables o desfavorables.

    El artículo organiza la discusión de Smith alrededor de siete factores que influyen sobre las remuneraciones: la sencillez o dificultad del trabajo; si este resulta agradable o desagradable; el peligro y sus efectos sobre la salud; la regularidad o temporalidad del empleo; el grado de confianza depositado en el trabajador; la probabilidad de éxito profesional; y consideraciones subjetivas como la pasión por una profesión, la búsqueda de reputación, la confianza en las propias capacidades y la confianza en la propia suerte.

    Estos factores son importantes precisamente porque no implican sectores aislados. Al contrario: las tasas sectoriales pueden relacionarse directamente mediante la interdependencia orgánica de la producción capitalista e indirectamente mediante fuerzas comunes que afectan salarios y condiciones laborales. En este sentido, el mecanismo económico descrito por Smith y Marx resulta más naturalmente compatible con marcos probabilísticos generalizados que admiten dependencia que con un modelo clásico que exige independencia recíproca.

    • • •

    Entonces, ¿qué establece realmente el artículo?

    La conclusión es favorable al supuesto de uniformidad, pero está cuidadosamente delimitada. En el plano teórico, la lógica de la tendencia smithiana hacia la uniformidad de las tasas sectoriales de plusvalía es consistente con determinadas versiones fuertes y débiles de la Ley de los Grandes Números que permiten variables correlacionadas y/o no exigen identidad distributiva. Esta consistencia formal está condicionada a que puedan satisfacerse los requisitos concretos de los resultados matemáticos pertinentes.

    En el plano empírico, los datos estadounidenses muestran precisamente la heterogeneidad y la interdependencia que impiden formular un argumento simplista basado en la LGN clásica. Al mismo tiempo, el análisis descriptivo de las desviaciones sectoriales produce resultados que apuntan en una dirección favorable a la proposición de Smith y Marx sobre la tendencia hacia la uniformidad de las tasas sectoriales de plusvalía.

    No se trata, por tanto, de una demostración de que toda economía capitalista, en cualquier período histórico, deba presentar una tasa uniforme de plusvalía. Tampoco se afirma que todos los sectores posean la misma tasa en cada instante. La conclusión, más acotada y defendible, es que el supuesto utilizado en los análisis marxistas de largo plazo sobre la tasa media de ganancia posee una formulación probabilística plausible y encuentra evidencia empírica a su favor en el caso estadounidense estudiado.

    La distinción es importante. La contribución del artículo no consiste en eliminar la diversidad sectorial, sino en preguntar si la diversidad existente en el nivel de las partes puede coexistir con una regularidad asintótica en el nivel de la totalidad. Su respuesta es cautelosamente afirmativa, y es precisamente la combinación de heterogeneidad, interdependencia y regularidad sistémica lo que vuelve al problema interesante tanto desde las matemáticas como desde la economía política.

    Artículo original: Gómez Julián, J. M. (2022). «Sobre la validez del supuesto de uniformidad en las tasas de plusvalía sectorial desde la teoría de las probabilidades». Ciencia Económica, Año 11, No. 17, Universidad Nacional Autónoma de México, Facultad de Economía. DOI: 10.22201/fe.24484962e.2022.11.17.2. Acceso abierto bajo licencia CC BY-NC-ND 4.0.
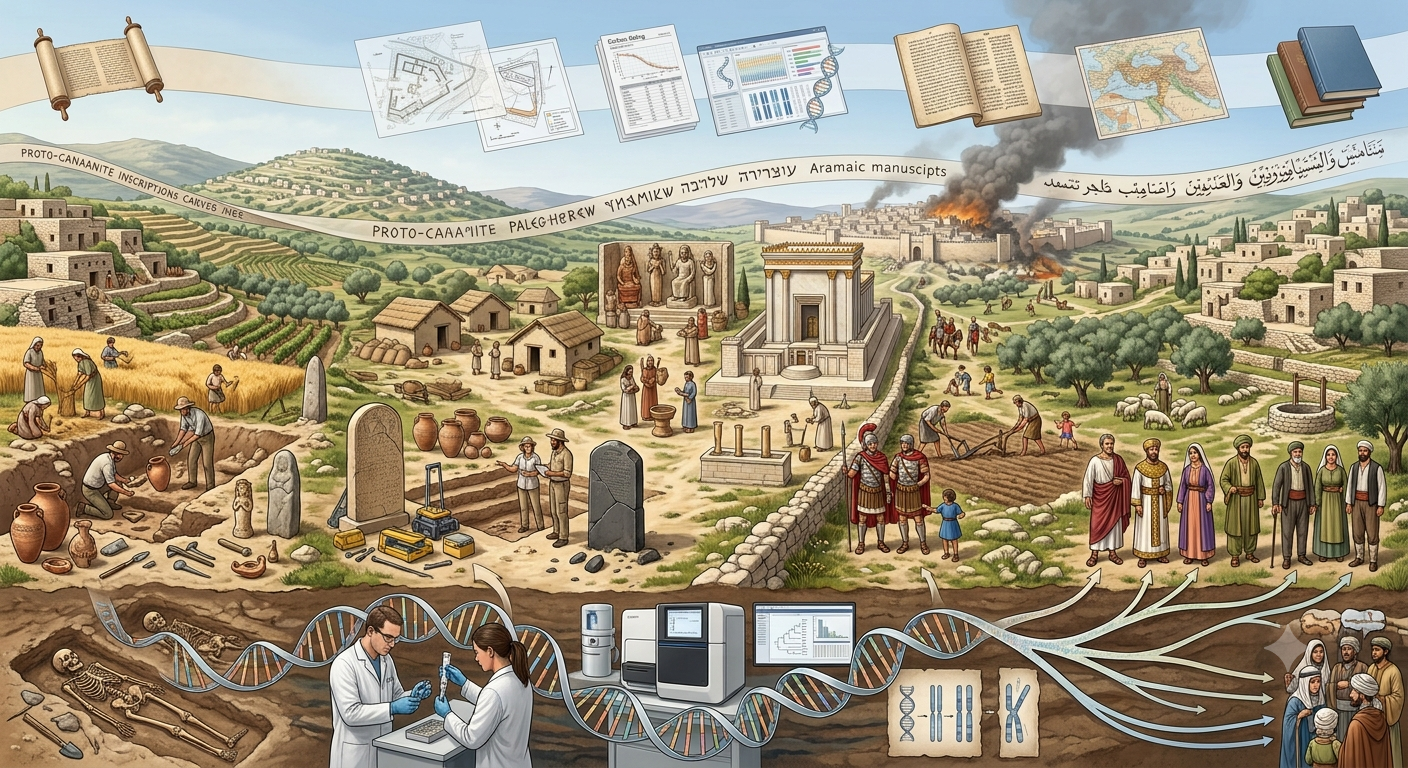
  • Descubriendo La Verdad: Genética, Arqueología y la Descendencia Palestina de Los Antiguos Judíos

    Descubriendo La Verdad: Genética, Arqueología y la Descendencia Palestina de Los Antiguos Judíos

    Los antiguos judeanos de Judea como ancestros directos de los palestinos contemporáneos

    Arqueología, paleogenómica, historiografía, epigrafía y lingüística contra la narrativa del exilio y el «retorno»: una síntesis de la monografía de José Mauricio Gómez Julián.
    La monografía parte de una pregunta histórica con consecuencias políticas directas: ¿quiénes son, estrictamente hablando, los descendientes de los antiguos judeanos de Judea?

    Su tesis es que la convergencia de la arqueología crítica del Levante meridional, la historiografía, la epigrafía, la paleogenómica y genética de poblaciones y la lingüística histórica apunta a que los palestinos contemporáneos constituyen los herederos demográficos más directos de las antiguas poblaciones de la región, incluidos los judeanos del Reino de Judá. Frente a ello, las poblaciones judías modernas presentan historias demográficas heterogéneas, con proporciones variables de ascendencia levantina y aportes adquiridos mediante migraciones, conversiones y mezcla con poblaciones europeas, africanas y asiáticas.

    El argumento no depende de una sola disciplina. Su núcleo consiste precisamente en la corroboración cruzada de líneas de evidencia independientes: el origen cananeo de los primeros israelitas, la inexistencia de una expulsión romana general de Palestina, la continuidad arqueológica durante las transiciones bizantina e islámica, los datos genómicos y la continuidad lingüística y toponímica.
    Una cautela metodológica central: la monografía distingue expresamente entre consensos robustos, conclusiones bien fundamentadas y cuestiones todavía abiertas. No sostiene que cada detalle posea el mismo grado de certeza. En particular, todavía no se ha publicado en una revista revisada por pares el genoma de un individuo identificable inequívocamente como «judeano» del Reino de Judá. Por ello, la conexión específica con los judeanos se infiere mediante la convergencia entre continuidad arqueológica e histórica y la comparación genética con poblaciones levantinas antiguas, no mediante una comparación directa entre un «genoma judeano» y palestinos modernos.

    De la Biblia como relato fundacional a la historia crítica

    La investigación comienza por el problema metodológico de utilizar la Biblia como si fuera una crónica histórica. Revisa la revolución historiográfica asociada con Thomas L. Thompson, Niels Peter Lemche, Philip R. Davies y Keith W. Whitelam, la llamada «escuela minimalista», y la confronta con las objeciones maximalistas y con posiciones intermedias como las de William G. Dever y Lester Grabbe.

    El punto fundamental no consiste en afirmar que todo contenido bíblico carezca de historicidad. La monografía subraya precisamente que las posiciones extremas han dado paso a un terreno intermedio: existe material históricamente aprovechable, especialmente desde el primer milenio a. C., pero los relatos patriarcales, el Éxodo, la conquista militar de Canaán y la monarquía unificada en la escala descrita por el texto bíblico no cuentan con el respaldo arqueológico que la historiografía tradicional les atribuía.

    Mario Liverani proporciona una de las claves interpretativas del trabajo mediante su distinción entre «historia normal» e «historia inventada»: las antiguas entidades políticas de Israel y Judá deben reconstruirse mediante arqueología, epigrafía, crítica textual y fuentes comparativas, mientras que las grandes narrativas fundacionales deben analizarse también como construcciones político-teológicas desarrolladas por la comunidad postexílica.

    Los primeros israelitas surgieron de Canaán

    Uno de los pilares más robustos del argumento es el origen autóctono cananeo de los primeros israelitas. Alrededor de 1200 a. C. surgieron aproximadamente 250 pequeñas aldeas sin murallas en las tierras altas centrales. Su cerámica muestra continuidad con las tradiciones del Bronce Tardío, no aparecen estratos generalizados de destrucción atribuibles a una conquista exterior y la organización de los asentamientos es compatible con poblaciones locales en proceso de sedentarización.

    Israel Finkelstein y William G. Dever, pese a sus profundas diferencias historiográficas y cronológicas, convergen en este punto: las poblaciones que posteriormente serían identificadas como israelitas surgieron principalmente desde el interior de la sociedad cananea, no como una población extranjera que conquistó Canaán desde fuera.

    La epigrafía: Merneptah y Tel Dan

    La monografía incorpora una línea de evidencia que el HTML anterior prácticamente omitía: la epigrafía. La estela de Merneptah, hacia 1208 a. C., contiene la primera referencia extrabíblica conocida a «Israel» y lo identifica mediante un determinativo egipcio correspondiente a un pueblo o grupo socioétnico, no a un Estado territorial.

    La estela de Tel Dan, del siglo IX a. C., contiene la secuencia generalmente interpretada como «Casa de David». La lectura fue discutida por algunos minimalistas, pero es aceptada por la mayoría de los especialistas. Para la monografía, estas inscripciones introducen una distinción decisiva: la crítica al relato bíblico no requiere negar la existencia histórica de Israel o de una dinastía davídica. Lo que la evidencia extrabíblica no confirma es el Éxodo, la conquista de Canaán ni un imperio salomónico de las dimensiones descritas en la Biblia.

    Del politeísmo cananeo al monoteísmo yahvista

    Otro componente sustancial del paper es la evolución religiosa de Israel. A partir de Mark S. Smith, William G. Dever, Othmar Keel, Christoph Uehlinger y Thomas Römer, la monografía presenta el monoteísmo yahvista no como el punto inicial de la historia israelita, sino como el resultado de un proceso histórico prolongado.

    La evidencia textual, arqueológica y epigráfica muestra la coexistencia de Yahweh, El, Baal y Asherah en distintos momentos de la religión israelita. Las inscripciones de Kuntillet Ajrud y Khirbet el-Qom, junto con figurillas judeanas, altares, piedras cultuales y otros materiales, documentan prácticas religiosas incompatibles con la imagen retrospectiva de un Israel primordialmente monoteísta.

    El proceso habría avanzado desde el politeísmo y la monolatría hacia un monoteísmo más exclusivo, acelerado por la crisis del exilio babilónico y consolidado durante el período persa. La posible influencia del zoroastrismo sobre elementos posteriores del judaísmo —dualismo, escatología, angelología— es tratada expresamente como un debate abierto, no como una conclusión establecida.

    El caso filisteo

    La monografía también utiliza a los filisteos como ejemplo de la capacidad histórica del sustrato levantino para absorber poblaciones migrantes. El ADN antiguo de Ascalón muestra un componente relacionado con el sur de Europa durante el Hierro I temprano que deja de ser detectable aproximadamente dos siglos más tarde, coincidiendo con una creciente integración cultural en el entorno cananeo.

    De ahí no se concluye que los palestinos sean simplemente «descendientes de los filisteos». El argumento es más amplio: los palestinos contemporáneos representan una síntesis histórica de las sucesivas poblaciones del Levante meridional —cananeos, israelitas, judeanos, samaritanos, filisteos, fenicios y otros grupos— sobre un sustrato local caracterizado por una fuerte continuidad demográfica.

    Asirios, babilonios y la diferencia entre deportar una élite y vaciar un territorio

    La monografía insiste en distinguir las deportaciones históricamente documentadas de la idea de un vaciamiento demográfico total. Tras la conquista asiria del Reino de Israel, una parte de la población fue deportada, otra huyó hacia Judá y una cantidad considerable permaneció en el territorio. La deportación imperial afectaba de manera desproporcionada a élites políticas, administrativas y especializadas; no equivalía automáticamente a eliminar a toda la población campesina.

    El mismo principio se aplica a la conquista babilónica. Jerusalén sufrió una destrucción profunda y hubo deportaciones reales, pero otras zonas —particularmente Benjamín— muestran continuidad rural. Por ello, el llamado «exilio babilónico» se interpreta como una ruptura política, institucional y cultural de enorme importancia, pero no como la desaparición física de la población de Judá.

    Durante el período persa se consolidó progresivamente el judaísmo como sistema religioso diferenciado. Esa transformación proporciona el contexto histórico en el que la monografía sitúa la redacción y reorganización de una parte fundamental de la tradición bíblica.

    De Ioudaios a «judío»: conversiones asmoneas y transformación de la identidad

    La expansión asmonea de los siglos II y I a. C. constituye otro punto de inflexión. Juan Hircano I impuso la circuncisión y la observancia de la ley judía a los idumeos; Aristóbulo I hizo lo propio con poblaciones itureas. La propia dinastía herodiana procedía de aquella población idumea incorporada al judaísmo.

    Siguiendo a Shaye J. D. Cohen, la monografía subraya la transformación semántica de Ioudaios: de una designación primordialmente etnogeográfica —«judeano», habitante de Judea— pasó a adquirir un sentido también religioso y cultural. Desde entonces, era posible convertirse en judío sin haber nacido judeano. Esta transformación constituye una precondición conceptual para comprender la posterior expansión de la diáspora.

    El mito de una expulsión romana total

    Las guerras contra Roma fueron devastadoras. La destrucción del Segundo Templo en 70 d. C. y, especialmente, la rebelión de Bar Kojba de 132–135 d. C. provocaron enormes pérdidas humanas y materiales en Judea. La monografía no minimiza esa destrucción.

    Lo que rechaza es una afirmación distinta: que Roma deportara en masa a la población judía de toda Palestina y vaciara la tierra. Adriano prohibió el acceso judío a Aelia Capitolina —Jerusalén—, pero no existe evidencia de una política romana de deportación total de Palestina. La continuidad de asentamientos en diversas regiones y el desplazamiento del centro de la vida judía hacia Galilea contradicen ese escenario.

    En Galilea surgieron centros rabínicos como Usha, Séforis y Tiberíades; allí se compiló la Mishná hacia el año 200 y posteriormente el Talmud de Jerusalén. La destrucción romana fue, por tanto, enormemente importante en el plano institucional y regional, pero no produjo la desaparición física de la población judía de la tierra.

    • Consenso historiográfico: la inexistencia de una expulsión romana masiva de todos los judíos de Palestina no es una tesis exclusiva de Shlomo Sand. Historiadores como Israel Bartal y Anita Shapira reconocen que la idea de un exilio colectivo impuesto por Roma pertenece mucho más a la cultura popular que a la historiografía especializada.
    • Matiz necesario: aceptar que no hubo una expulsión general no implica negar las muertes, esclavizaciones, desplazamientos locales y destrucciones producidas por las guerras romanas.
    • Diáspora: la existencia de importantes comunidades judías fuera de Palestina es anterior a las guerras romanas y debe explicarse mediante una combinación de migraciones, crecimiento demográfico y conversiones, no mediante un único episodio de expulsión.

    De la permanencia a la conversión: continuidad de la población palestina

    Este es uno de los eslabones centrales de la monografía. Si la población rural no fue expulsada de manera general, la pregunta pasa a ser qué ocurrió con ella. La respuesta propuesta es una transformación religiosa progresiva sobre una base demográfica ampliamente continua.

    Durante los siglos IV al VII, una parte creciente de la población de Palestina se cristianizó bajo dominio bizantino. Después de la conquista árabe de 634–638, la islamización tampoco ocurrió de manera inmediata. Los modelos demográficos y la evidencia arqueológica examinados en el paper sitúan el proceso a lo largo de varios siglos, hasta la época medieval tardía.

    Gideon Avni encuentra una notable continuidad de los patrones de asentamiento y de la cultura material durante la transición bizantino-islámica. Richard Bulliet y otros investigadores muestran asimismo que la conversión al islam siguió una trayectoria gradual. El resultado es fundamental para el argumento: cambió la religión de la población mucho más rápidamente que su composición biológica.

    La continuidad judía tampoco desapareció

    La monografía enfatiza que la presencia judía en Palestina nunca se extinguió por completo. Comunidades judías sobrevivieron durante la Antigüedad tardía, la Edad Media y el período otomano; los llamados Musta’arabim, judíos autóctonos arabizados, compartían lengua y numerosas prácticas cotidianas con sus vecinos musulmanes y cristianos.

    Este hecho no contradice la tesis de continuidad palestina. Al contrario, para el paper demuestra que permanecer en el territorio no exigía conservar una religión determinada: distintas ramas de una población históricamente relacionada podían permanecer como judías, convertirse al cristianismo o posteriormente al islam.

    Ben-Gurión, Ben-Zvi, Borochov y Belkind

    La monografía concede especial importancia a que varios dirigentes del sionismo temprano sostuvieron, antes de la consolidación del conflicto nacional, que los fellahin palestinos descendían en buena medida de poblaciones judías y cananeas antiguas que permanecieron en la tierra y cambiaron posteriormente de religión.

    David Ben-Gurión y Yitzhak Ben-Zvi defendieron esta continuidad en trabajos de 1918; Ber Borochov había formulado una tesis similar en 1905, Israel Belkind rechazó en 1928 la idea de que los judíos hubieran dejado de habitar el país tras Roma, y Ben-Zvi volvió sobre la ascendencia local de los fellahin en 1929. El paper argumenta que esta interpretación perdió centralidad posteriormente a medida que cambiaron las necesidades políticas del movimiento sionista.

    La paleogenómica: continuidad, mezcla y los límites de lo que el ADN puede demostrar

    La paleogenómica proporciona la dimensión cuantitativa del argumento, pero la monografía advierte expresamente contra utilizar categorías estadísticas como si fueran poblaciones históricas perfectamente delimitadas.

    El estudio de Agranat-Tamir y colaboradores analizó decenas de genomas del Levante de las edades del Bronce y del Hierro. Pese a la diversidad cultural y política regional, esos individuos muestran una base genética relacionada y permiten establecer una referencia para estudiar la continuidad con las poblaciones actuales.

    • Palestinos contemporáneos: los modelos examinados en la monografía sitúan aproximadamente entre 81 % y 87 % de su ascendencia en poblaciones levantinas de la Edad del Bronce, complementada por componentes posteriores, entre ellos aportes africanos y europeos.
    • Judíos asquenazíes: distintos estudios de genoma completo encuentran una población claramente mezclada. Carmi et al. la modelan aproximadamente como 50 % de origen medio-oriental y 50 % europeo, mientras otros análisis producen intervalos diferentes según el método empleado. Una parte importante del componente europeo procede del sur de Europa.
    • Cuello de botella asquenazí: la población moderna deriva de un severo cuello de botella estimado en aproximadamente 350 individuos hace unos 600–800 años.
    • Erfurt: el ADN de 33 judíos asquenazíes medievales del siglo XIV revela una heterogeneidad genética mayor que la actual, posteriormente reducida mediante deriva genética y endogamia.
    • Cromosoma Y: alrededor del 70 % de los cromosomas Y judíos y el 82 % de los palestinos musulmanes analizados por Nebel et al. pertenecían al mismo acervo cromosómico general, dominado por linajes J1 y J2, mostrando un profundo sustrato patrilineal levantino compartido.
    • Judíos mizrajíes: constituyen un matiz decisivo. La monografía señala proporciones de ascendencia levantina del orden del 80–90 % en diferentes poblaciones mizrajíes, comparables a las palestinas.
    Lo que los datos permiten afirmar con mayor precisión: los palestinos contemporáneos muestran, a escala de genoma completo, una proximidad muy elevada con las antiguas poblaciones levantinas y una continuidad superior a la observada en los asquenazíes, cuya historia incluye una considerable mezcla europea. Pero esto no significa que los judíos modernos carezcan de ascendencia levantina. La monografía rechaza explícitamente esa conclusión simétrica.

    Tampoco existe todavía un conjunto publicado de genomas inequívocamente identificados como judeanos del Reino de Judá. Los datos preliminares de Kiriath-Jearim mencionados en el trabajo apuntan hacia continuidad con perfiles cananeos, pero su publicación formal se encuentra pendiente. Además, herramientas como qpAdm pierden capacidad para discriminar entre fuentes históricas estrechamente relacionadas, y los componentes de programas como ADMIXTURE son construcciones estadísticas, no pueblos históricos literalmente preservados en el ADN.

    La hipótesis jázara

    La monografía distingue también entre la existencia histórica de conversiones al judaísmo entre la élite jázara —que no se discute en términos generales— y la afirmación mucho más fuerte de que los jázaros constituyeran el origen principal de los asquenazíes. Los análisis genómicos modernos no encuentran la contribución caucásica o centroasiática masiva que esa hipótesis requeriría. Por ello, el paper considera refutada la hipótesis jázara como explicación principal del origen asquenazí.

    La genética no puede fundamentar derechos territoriales; pero sí puede someter a prueba afirmaciones genealógicas cuando esas afirmaciones se utilizan como argumentos políticos.

    Lengua: cananeo → hebreo → arameo → árabe

    El argumento lingüístico complementa la evidencia genética. El hebreo pertenece al conjunto de lenguas cananeas. Con la expansión de los grandes imperios mesopotámicos, el arameo se convirtió progresivamente en lengua franca y desplazó al hebreo en numerosos usos cotidianos, sin que ello implicara un reemplazo de la población.

    Después de la conquista islámica ocurrió un proceso estructuralmente semejante. El árabe sustituyó al griego en la administración bajo los omeyas y fue reemplazando paulatinamente al arameo entre la población local. La transición lingüística se prolongó durante siglos.

    Por ello, la trayectoria cananeo → hebreo → arameo → árabe no representa para la monografía una sucesión de cuatro pueblos que se reemplazaron mutuamente, sino en gran medida una sucesión de lenguas habladas sobre una base poblacional históricamente continua.

    Toponimia y etnografía: la memoria conservada en el paisaje

    Los nombres de lugares refuerzan esa interpretación. Beit Lahm (Belén), Beisan (Beth-shean), Bir as-Saba (Be’er Sheva), ‘Anata (Anathoth), Seilun (Shiloh) y numerosos topónimos más muestran la conservación y transformación fonética de nombres antiguos dentro del árabe palestino.

    La investigación recupera también los trabajos etnográficos de Tawfiq Canaan y Hilma Granqvist. Canaan documentó prácticas campesinas palestinas con posibles antecedentes preislámicos y precristianos, entre ellas el término ard ba’liyyeh para las tierras dependientes de la lluvia, que preserva lingüísticamente el nombre de Baal, la antigua divinidad cananea asociada a las tormentas.

    El hebreo moderno

    El paper contrapone esta continuidad orgánica con la recuperación moderna del hebreo. Siguiendo especialmente a Ghil’ad Zuckermann, caracteriza al hebreo israelí como una lengua revitalizada en los siglos XIX y XX sobre bases semíticas antiguas pero con una influencia estructural significativa de lenguas europeas —especialmente el yidis— habladas por numerosos revitalizadores.

    La monografía reconoce que existen formulaciones más radicales, como la de Paul Wexler, que no representan el consenso lingüístico. Su argumento no depende de ellas: basta con distinguir entre una lengua revitalizada conscientemente y una cadena dialectal que evolucionó históricamente en el mismo territorio.

    La diáspora judía como mosaico histórico

    Si Roma no expulsó en bloque a la población de Palestina, queda por explicar la enorme diáspora judía ya existente en la Antigüedad. La respuesta de la monografía no es monocausal. La diáspora se formó mediante migraciones, conversiones voluntarias, conversiones forzadas y absorción matrimonial de poblaciones locales, con pesos relativos diferentes según el lugar y la época.

    Las conversiones asmoneas demuestran tempranamente que la pertenencia judía podía adquirirse. Durante el mundo grecorromano existieron prosélitos y «temerosos de Dios», aunque la magnitud exacta del proselitismo activo es objeto de debate entre especialistas como Louis Feldman y Martin Goodman.

    La extraordinaria expansión demográfica del judaísmo antiguo —desde una población comparativamente reducida tras la conquista babilónica hasta varios millones de personas durante el período romano— constituye para el paper una fuerte evidencia de que la conversión desempeñó un papel sustancial que el crecimiento natural por sí solo difícilmente puede explicar.

    La monografía examina después casos muy distintos: el reino himyarita de Arabia meridional, las discutidas tradiciones sobre conversiones bereberes, Beta Israel en Etiopía, Bene Israel y Cochin en India, los judíos de Kaifeng en China y las comunidades sefardíes y asquenazíes de Europa. El resultado no es una única genealogía, sino un mosaico de comunidades con historias biológicas y culturales diferentes vinculadas por el judaísmo.

    Dos simplificaciones que el propio paper rechaza:

    1. No es sostenible que todos los judíos modernos desciendan biológicamente de manera lineal y homogénea de los antiguos israelitas.

    2. Tampoco es sostenible afirmar que los judíos modernos no poseen ninguna conexión genética con el antiguo Levante.

    La evidencia muestra, precisamente, una historia de continuidad levantina combinada con grados muy diferentes de mezcla según cada comunidad.

    Las implicaciones historiográficas y políticas

    La monografía no presenta sus conclusiones demográficas como políticamente neutrales. Su punto de partida teórico es explícitamente gramsciano: las narrativas históricas pueden convertirse en mecanismos de hegemonía cuando pasan a funcionar como «sentido común» legitimador de relaciones políticas presentes.

    Desde esta perspectiva, el relato de un pueblo étnicamente continuo expulsado por Roma y «retornado» dos milenios más tarde cumple, según el paper, una función política específica: transforma una colonización moderna en la restauración de una soberanía ancestral. La investigación contrapone ese relato a la historia documentada del sionismo europeo, la Declaración Balfour de 1917, el Mandato británico, la inmigración organizada, la partición de 1947, la Nakba de 1948 y el posterior patrocinio estadounidense de Israel.

    El paper sitúa así al Estado de Israel dentro de la historia moderna del colonialismo de asentamiento y de los intereses geopolíticos occidentales en Oriente Medio, y sostiene que la narrativa bíblico-genealógica opera como uno de sus dispositivos de legitimación cultural.

    Esta interpretación no se presenta como una crítica al judaísmo ni a los judíos como población. La monografía dedica una sección específica a voces judías e israelíes críticas del sionismo —entre ellas Tony Judt, Judith Butler, Norman Finkelstein y los llamados «nuevos historiadores» israelíes— precisamente para distinguir entre judaísmo, identidad judía, historiografía y proyecto político sionista.

    Lo que la monografía considera establecido —y lo que no

    • Consenso robusto: los primeros israelitas surgieron principalmente del sustrato cananeo local, no mediante una conquista exterior de Canaán como la descrita en Josué.
    • Consenso robusto: Roma no llevó a cabo una deportación masiva de toda la población judía de Palestina tras las guerras de los siglos I y II.
    • Consenso robusto según la síntesis del paper: una parte predominante de la población palestina desciende de poblaciones antiguas del Levante que permanecieron en la región y atravesaron sucesivas transformaciones religiosas y lingüísticas.
    • Conclusión bien fundamentada, con matices: las comunidades judías de la diáspora se formaron mediante combinaciones diferentes de ascendencia levantina, migración, conversión y mezcla con poblaciones locales.
    • Conclusión bien fundamentada: la secuencia lingüística cananeo–hebreo–arameo–árabe es compatible con cambios de lengua sin sustitución demográfica general.
    • Conclusión bien fundamentada: judíos y palestinos comparten un profundo sustrato genético levantino; las diferencias actuales reflejan historias posteriores divergentes de permanencia, migración, endogamia, mezcla y deriva genética.
    • Debates abiertos y límites: no existe todavía ADN publicado inequívocamente atribuible a individuos judeanos del Reino de Judá; la magnitud relativa del proselitismo antiguo continúa discutida; las proporciones genéticas dependen de modelos estadísticos y poblaciones de referencia; y algunas cuestiones religiosas e historiográficas, como el alcance de influencias zoroastrianas, permanecen abiertas.

    Conclusión: continuidad bajo la transformación

    La tesis final de la monografía no consiste en imaginar una población palestina biológicamente «pura» ni inmutable. Es prácticamente lo contrario: la continuidad histórica puede coexistir con migraciones, mezclas, cambios religiosos, transformaciones culturales y sustituciones lingüísticas profundas.

    La población del Levante meridional absorbió durante milenios a cananeos, israelitas, judeanos, samaritanos, filisteos y otros grupos. Las conquistas asiria, babilónica, persa, helenística, romana, bizantina y árabe transformaron profundamente las instituciones, religiones y lenguas de la región sin producir, en la mayoría de esos episodios, una sustitución completa de su población.

    Dentro de ese proceso histórico, el paper sostiene que los palestinos contemporáneos representan la principal continuidad demográfica de las poblaciones antiguas que permanecieron en el territorio, incluidos los antiguos judeanos, mientras las poblaciones judías modernas presentan trayectorias heterogéneas: algunas —particularmente las mizrajíes— conservan niveles muy elevados de ascendencia levantina; otras —como los asquenazíes— combinan una ascendencia levantina sustancial con una contribución europea igualmente sustancial.

    Por ello, el estudio rechaza simultáneamente dos extremos: tanto la ficción de una continuidad biológica homogénea y exclusiva entre todos los judíos modernos y los antiguos habitantes de Judea como la afirmación inversa de que los judíos modernos carezcan de raíces levantinas.

    Finalmente, la monografía insiste en una frontera normativa fundamental: la genética no concede derechos territoriales y la proximidad genética no determina quién merece ciudadanía, dignidad, autodeterminación o derechos políticos. Su relevancia aparece cuando una determinada genealogía histórica es utilizada como justificación política. En ese caso, sostiene el autor, las ciencias históricas, arqueológicas, lingüísticas y genómicas tienen legitimidad para someter esa genealogía a examen.

    De este modo, arqueología, historiografía, epigrafía, genética y lingüística convergen en la tesis que organiza toda la investigación: la historia de Palestina es mucho más una historia de continuidad humana bajo transformaciones sucesivas que una historia de expulsión total seguida, dos mil años después, por el retorno de la misma población.

  • La Inflación No Siempre Es Un Fenómeno Monetario ni se manifiesta en todas partes.

    La Inflación No Siempre Es Un Fenómeno Monetario ni se manifiesta en todas partes.

    Más allá de la curva de Phillips — Inflación, cambio tecnológico y plusvalía
    Economía política Oct.–nov. 2025 · 10 min de lectura

    Más allá de la curva de Phillips

    Un estudio con datos estadounidenses de 1968 a 2021 no encuentra una relación inversa significativa de largo plazo entre inflación y desempleo y plantea, desde una perspectiva marxista, que la inflación funciona como un mecanismo de ajuste del salario real mediante el cual los beneficios del cambio tecnológico pueden transformarse en plusvalía relativa.

    La curva de Phillips ocupa desde hace décadas un lugar central en la macroeconomía convencional: la idea de que inflación y desempleo mantienen una relación inversa que condiciona las opciones de política económica. Este estudio somete esa relación a contraste empírico y plantea una explicación alternativa de la inflación desde la economía política marxista.

    Utilizando datos de Estados Unidos para el período 1968–2021, la investigación no encuentra una relación estadísticamente significativa de largo plazo entre inflación y desempleo. En cambio, identifica relaciones relevantes entre los indicadores de cambio tecnológico —aproximados mediante el gasto en investigación y desarrollo (I+D)—, los precios, los salarios reales y la tasa de plusvalía.

    La hipótesis central es que la inflación no debe entenderse únicamente como un desequilibrio entre oferta y demanda ni como un fenómeno puramente monetario. Desde el marco desarrollado en el artículo, funciona también como un mecanismo de ajuste salarial dentro del proceso de acumulación capitalista.

    Qué está realmente en juego con la curva de Phillips

    El artículo reconstruye el desarrollo intelectual de la curva de Phillips: el trabajo de William Phillips de 1958 sobre desempleo y variación de los salarios nominales, y la posterior adaptación de Samuelson y Solow al vínculo entre desempleo e inflación. Esa reconstrucción histórica describe cómo se formuló y consolidó la teoría; no equivale, por sí misma, a conceder que exista una relación económica universal y estable entre ambas variables.

    La pregunta empírica es precisamente si esa relación inversa puede sostenerse frente a los datos. Para Estados Unidos en el período analizado, la respuesta obtenida es negativa: cuando se examinan las relaciones de largo plazo y se introducen controles, no aparece una asociación inversa estadísticamente significativa capaz de sostener el trade-off convencional.

    El alcance exacto de esta conclusión El estudio no necesita afirmar que una sola muestra histórica haya demostrado por sí misma la inexistencia universal de toda posible curva de Phillips. Lo que demuestra es que la relación no aparece de manera significativa en los datos estadounidenses analizados. La investigación funciona así como una primera pieza de un programa empírico más amplio: si se quiere evaluar la pretensión general de existencia de la curva, el análisis debe replicarse en otros períodos, países, estructuras económicas y especificaciones. Esta investigación coloca la primera piedra; el edificio completo exige más evidencia.

    Una estrategia empírica más amplia que una simple correlación

    El estudio combina análisis descriptivo, inferencia bayesiana, herramientas de series temporales y un modelo bayesiano de la tasa de plusvalía. Las distintas técnicas no cumplen la misma función: cada una permite examinar una parte diferente de la estructura propuesta.

    Correlaciones bayesianas

    Se estiman correlaciones ordinarias y parciales de Pearson y Kendall entre indicadores de cambio tecnológico, inflación y desempleo. Las correlaciones parciales permiten controlar variables como el PIB nominal, el PIB real y los salarios reales. La evidencia se evalúa mediante factores bayesianos, utilizando BF > 3 como criterio de evidencia sustancial a favor de una correlación.

    Los resultados no pueden reducirse a la frase “más I+D siempre implica más inflación”. Las correlaciones ordinarias varían según la fuente de I+D y el indicador de precios: aparecen relaciones tanto positivas como negativas. Sin embargo, al introducir controles emergen relaciones positivas particularmente importantes entre el gasto en I+D federal y capitalista y el índice de precios al consumidor.

    También resulta central el papel de los salarios reales: al controlar su efecto, varias correlaciones negativas entre las fuentes de cambio tecnológico y la inflación total dejan de ser estadísticamente significativas. Esto es coherente con la hipótesis de que el salario real ocupa una posición mediadora en el mecanismo estudiado.

    Causalidad de Granger

    Las pruebas de Granger del artículo no se utilizan para afirmar que “el desempleo no causa la inflación”. Su objeto son las relaciones temporales entre los indicadores de cambio tecnológico y los indicadores de precios, empleando uno, dos y tres rezagos.

    Con un rezago se encuentran relaciones estadísticamente significativas entre todos los tipos de indicadores de cambio tecnológico y todos los tipos de indicadores de precios. Además, el promedio de los valores-p es menor cuando los indicadores tecnológicos actúan como variables explicativas que cuando lo hacen los precios. Con dos rezagos, los indicadores de precios explican la I+D capitalista; con tres, vuelve a predominar el cambio tecnológico como determinante temporal de los precios.

    El resultado, por tanto, es más complejo que una causalidad mecánica en un único sentido: existen interacciones y retroalimentaciones, aunque el patrón temporal proporciona evidencia importante a favor del papel del cambio tecnológico.

    Modelos de corrección de errores

    Tras las comprobaciones correspondientes de las propiedades de las series, los modelos de corrección de errores encuentran que el gasto federal en I+D determina estadísticamente la inflación subyacente, el IPC y el IPP; que el gasto capitalista en I+D determina el IPC y el IPP; y que la I+D de otras fuentes determina igualmente diversos indicadores de precios.

    En la dirección contraria, la inflación subyacente aparece como el canal mediante el cual los precios pueden determinar los indicadores de cambio tecnológico. De nuevo, el resultado describe una estructura dinámica con retroalimentaciones, no una flecha causal simplista.

    · · ·

    Los salarios también cuentan una historia

    El trabajo examina directamente la dinámica de salarios y precios. Las series no poseen la misma estructura probabilística: el crecimiento de los salarios nominales se ajusta a una distribución Gamma, el crecimiento de la inflación total a una distribución Cauchy y el de la inflación subyacente a una distribución logística.

    Esa diferencia importa. Comparar directamente parámetros de distribuciones tan distintas puede inducir a conclusiones incorrectas. Por ello, el artículo utiliza análisis de tendencia-ciclo mediante ondículas de Daubechies, que permiten comparar la dinámica temporal sin imponer una estructura distributiva común.

    Las tendencias obtenidas muestran que los indicadores de precios se encuentran sistemáticamente por encima de los salarios nominales y reales en las comparaciones realizadas. Esto conecta la dinámica inflacionaria con la evolución del poder adquisitivo y prepara el terreno para el mecanismo marxista que constituye el núcleo teórico del artículo.

    El mecanismo marxista: de la innovación al ajuste del salario real

    Cuando un capitalista introduce una innovación tecnológica que eleva la productividad, puede producir mercancías en mejores condiciones que sus competidores y obtener temporalmente una plusvalía extraordinaria: una ventaja derivada de encontrarse por delante de las condiciones productivas medias.

    Pero esa ventaja no puede durar indefinidamente. La competencia impulsa la difusión de la tecnología. Los demás capitalistas adoptan las nuevas técnicas para no quedar rezagados y, a medida que la innovación se generaliza, desaparece la ventaja extraordinaria del pionero.

    Aquí entra el elemento central de la hipótesis. Frente a los aumentos de productividad, la inflación puede operar como mecanismo de ajuste del salario real: los precios aumentan sin que los salarios nominales tengan que reducirse directamente y, si estos no crecen en la misma proporción, disminuye el poder adquisitivo de los trabajadores.

    De esta manera, los beneficios del cambio tecnológico pueden continuar repercutiendo positivamente en la tasa de plusvalía incluso después de que la innovación se haya difundido. El mecanismo no consiste simplemente en que “la inflación absorba una diferencia de costos”. Su elemento distributivo decisivo es la reducción relativa del salario real frente al aumento de productividad.

    Innovación tecnológica
    I+D federal y privada
    →
    Plusvalía extraordinaria
    ventaja temporal
    →
    Difusión tecnológica
    competencia capitalista
    →
    Presión sobre la
    tasa de ganancia
    →
    Inflación
    ajuste del salario real
    →
    Menor poder adquisitivo
    del trabajo
    →
    Plusvalía relativa
    para la clase capitalista
    →
    Acumulación y
    desigualdad
    Fig. 1 — Versión divulgativa del mecanismo desarrollado en el Diagrama 1 del artículo.

    La prueba que conecta tecnología, precios y plusvalía

    Una de las piezas empíricas más importantes del estudio es un modelo lineal generalizado bayesiano objetivo. La variable dependiente es el logaritmo natural de la tasa de plusvalía bruta; como variables explicativas se utilizan el logaritmo del gasto global en I+D y el logaritmo del índice de precios al consumidor.

    49–61 % intervalo de varianza de la tasa de plusvalía bruta explicada por I+D global e IPC
    0,709 mediana del coeficiente del gasto global en I+D
    0,195 mediana del coeficiente del IPC

    El modelo alcanza un R² de 0,55. Al estar formulado en logaritmos, los coeficientes pueden interpretarse como elasticidades. Además, presenta buenos indicadores de validación cruzada y factores de inflación de la varianza de 1,17 para ambas variables explicativas.

    Este resultado es especialmente importante porque enlaza empíricamente tres componentes que la interpretación teórica presenta como relacionados: cambio tecnológico, inflación y tasa de plusvalía. No se trata solo de observar que tecnología y precios se mueven conjuntamente; ambos contienen información sustancial para explicar la variación de la plusvalía bruta.

    · · ·

    Qué sostiene realmente el artículo sobre la inflación

    La interpretación marxista propuesta considera la inflación como parte de la lucha distributiva entre capital y trabajo. Cuando el incremento de los precios reduce los salarios reales, los aumentos de productividad pueden beneficiar principalmente al capital mediante un aumento de la tasa de plusvalía.

    Desde esta perspectiva, la inflación desempeña una función sistémica: contribuye a transformar los efectos temporales de la plusvalía extraordinaria en plusvalía relativa para el conjunto de la clase capitalista, preservando los beneficios de la innovación incluso después de que las nuevas tecnologías se hayan generalizado.

    La inflación aparece así no como un mero accidente monetario, sino como un mecanismo vinculado a la acumulación capitalista, al ajuste de los salarios reales y a la distribución del ingreso entre capital y trabajo.

    Esto tampoco implica negar que las variables monetarias puedan desempeñar un papel. La tesis más precisa es que reducir la inflación a un fenómeno puramente monetario resulta insuficiente para explicar las relaciones empíricas y distributivas estudiadas.

    Lo que el artículo no pretende haber terminado

    El trabajo delimita expresamente sus propias fronteras. La investigación utiliza únicamente datos de Estados Unidos y cubre el período 1968–2021. Por ello, sus resultados no deben presentarse como si una sola investigación hubiese agotado la demostración histórica de la inexistencia de la curva de Phillips en toda economía, época o contexto.

    Pero esta limitación no neutraliza el hallazgo. Si una relación presentada durante décadas como pieza fundamental de la teoría macroeconómica no aparece en una serie estadounidense extensa y bajo una estrategia estadística amplia, existe una razón sustantiva para cuestionar su generalidad y seguir sometiéndola a prueba.

    La primera pieza del rompecabezas La conclusión adecuada no es “la curva queda universalmente refutada con una sola muestra”, pero tampoco “quizá la curva siga siendo válida y este resultado sea una anomalía”. El estudio aporta una primera pieza empírica dentro de un problema más grande. Para completar el rompecabezas hace falta repetir este tipo de investigación en más países, períodos históricos y estructuras económicas. Cada nueva replicación permitirá evaluar hasta dónde puede sostenerse —o desmontarse— la pretensión general de una relación inversa entre inflación y desempleo.

    Las limitaciones importan, pero también indican por dónde continuar

    El gasto en I+D como proporción del PIB es una aproximación al cambio tecnológico, no una medición exhaustiva. No captura plenamente los spillovers tecnológicos, las transferencias internacionales de tecnología, las innovaciones organizacionales, el aprendizaje por la práctica, las mejoras incrementales no formalizadas ni toda la adopción creativa de tecnologías ya existentes.

    Al mismo tiempo, el artículo defiende su utilización porque ofrece series largas, comparables y metodológicamente estandarizadas y porque existe una relación bien documentada entre I+D y medidas posteriores de productividad. Precisamente porque omite formas reales de cambio tecnológico, el indicador puede interpretarse como una cota inferior conservadora del cambio tecnológico total.

    El propio estudio señala además que las relaciones encontradas son complejas y pueden estar afectadas por variables no incorporadas al análisis. También reconoce que, aunque el núcleo teórico queda delineado y sometido a verificación econométrica, todavía debe conectarse con otros componentes de la teoría marxista, como los ciclos económicos y la tendencia decreciente de la tasa media de ganancia.

    ¿Y qué implica todo esto para la política económica?

    Aquí conviene no atribuirle al artículo conclusiones que todavía no desarrolla. El trabajo no presenta una teoría acabada de política monetaria ni concluye, por ejemplo, que una determinada decisión sobre tasas de interés sea simplemente “tratar el síntoma y no la enfermedad”.

    En cambio, señala explícitamente esas preguntas como una línea de trabajo pendiente: deben desarrollarse las implicaciones tanto para la organización sindical de los trabajadores como para los hacedores de política económica, y debe examinarse la relación de la teoría propuesta con las políticas monetarias contemporáneas, particularmente los regímenes de metas de inflación.

    La consecuencia inmediata del artículo es, por tanto, anterior a cualquier receta: si la inflación posee una dimensión estructural ligada al cambio tecnológico, los salarios reales, la plusvalía y la distribución del ingreso, entonces una teoría que pretenda explicarla exclusivamente mediante variables monetarias deja fuera una parte esencial del fenómeno.

    · · ·

    Más allá de la curva

    La contribución del estudio puede condensarse en tres resultados: no encuentra una relación estadísticamente significativa de largo plazo entre inflación y desempleo para Estados Unidos durante el período estudiado; encuentra evidencia de relaciones relevantes entre cambio tecnológico e inflación; y obtiene resultados consistentes con la hipótesis de que la inflación reduce los salarios reales y permite que las ganancias de productividad repercutan en la tasa de plusvalía.

    La importancia del argumento no reside simplemente en sustituir una correlación por otra. El cambio de perspectiva es más profundo: pasa de tratar la inflación como un problema aislado de precios a situarla dentro de la reproducción y acumulación del capital y de la disputa por la distribución del valor producido.

    En ese marco, la pregunta deja de ser únicamente por qué suben los precios. También pasa a ser: ¿qué ocurre con los beneficios de las mejoras tecnológicas cuando se generalizan? ¿Cómo se distribuyen esos incrementos de productividad entre capital y trabajo? ¿Qué función desempeña la variación del salario real en ese proceso?

    Son esas relaciones —y no una simple sustitución mecánica entre inflación y desempleo— las que el artículo propone situar en el centro del análisis.

  • VENTAJA ABSOLUTA VS. VENTAJA COMPARATIVA: UNA COMPARACIÓN MULTIDIMENSIONAL

    VENTAJA ABSOLUTA VS. VENTAJA COMPARATIVA: UNA COMPARACIÓN MULTIDIMENSIONAL

    Teoría del comercio · Econometría · Política económica

    ¿Y si David Ricardo estaba equivocado?
    Un nuevo desafío econométrico a la ventaja comparativa

    Basado en: Gómez Julián, J. M. (2025). “Teorías del comercio internacional versus resultados de los tratados comerciales.” Revista Cubana de Economía Internacional, 12(1), 36–57. Leer el artículo original

    La mayoría de las personas que han llevado un curso introductorio de economía se han encontrado con una idea engañosamente sencilla: los países deberían especializarse en aquello que hacen relativamente mejor, incluso si otro país es mejor produciendo todo. Esta es la doctrina de la ventaja comparativa, atribuida en gran medida al trabajo de David Ricardo de comienzos del siglo XIX sobre el comercio entre Inglaterra y Portugal. Se ha convertido en una de las justificaciones más citadas del libre comercio y de la arquitectura de los tratados comerciales modernos.

    Un artículo de 2025 de Juan Manuel Gómez Julián, publicado en la Revista Cubana de Economía Internacional, plantea una pregunta provocadora: ¿los datos reales de los tratados comerciales respaldan la ventaja comparativa, o apuntan de nuevo hacia la idea más antigua y sencilla de la ventaja absoluta? Su respuesta, alcanzada mediante una combinación de análisis histórico, razonamiento matemático y modelización econométrica moderna, probablemente incomode buena parte del pensamiento convencional sobre política comercial.

    Las dos ideas en competencia, explicadas en lenguaje sencillo

    Antes de entrar en la contribución del artículo, conviene dejar absolutamente claro qué está en juego. Imaginemos dos países:

    • País A puede producir tanto trigo como acero de manera más eficiente —más rápido, más barato y utilizando menos recursos— que el País B.
    • País B es menos eficiente en la producción de ambos bienes.

    La ventaja absoluta (Adam Smith, 1776) sostiene: el País A es sencillamente mejor en ambos bienes. El País B no tiene ninguna razón evidente para competir directamente con él, y el comercio entre ambos estará condicionado por la magnitud de la diferencia en sus capacidades productivas.

    La ventaja comparativa (David Ricardo, 1817) responde: un momento; aunque el País A sea mejor en ambos bienes, es proporcionalmente mejor produciendo acero que trigo. El País B, aunque sea peor en todo, es relativamente menos malo produciendo trigo. Por tanto, si el País A se concentra en el acero y el País B en el trigo, y ambos comercian, los dos terminan beneficiándose. La superioridad absoluta no importa; lo que importa es la proporción entre las eficiencias dentro de cada país.

    La idea es elegante. Pero también es, como sostiene Gómez Julián, sorprendentemente frágil cuando se contrasta con datos del mundo real.

    Lo que realmente hace el artículo

    Gómez Julián aborda la cuestión desde tres ángulos complementarios, lo que proporciona al artículo una amplitud metodológica poco habitual.

    1. Generalización matemática

    En primer lugar, examina hasta qué punto cada teoría se sostiene cuando se la lleva matemáticamente más lejos; es decir, cuando se pregunta si su lógica continúa siendo válida bajo supuestos más generales y realistas que los modelos de manual originales de dos países y dos bienes. Según encuentra, la ventaja comparativa depende de un conjunto estrecho de supuestos —tecnologías idénticas en determinados aspectos, costos constantes, ausencia de costos de transporte y pleno empleo— que tienden a desmoronarse cuando el modelo se vuelve más realista. La ventaja absoluta, por el contrario, mantiene su coherencia bajo una gama más amplia de condiciones.

    2. Contexto histórico

    En segundo lugar, el artículo reconstruye la historia intelectual del problema. Ricardo desarrolló la ventaja comparativa en un mundo en el que la naturaleza de la producción era fundamentalmente distinta de la actual economía globalizada e intensiva en tecnología. El autor sostiene que la teoría fue producto de su época: útil como experimento mental, pero no como guía fiable para la política comercial moderna, especialmente cuando la brecha tecnológica entre los socios comerciales es muy amplia.

    3. Evidencia econométrica

    Es aquí donde el artículo realiza su contribución más distintiva. Gómez Julián utiliza dos familias de modelos estadísticos para comprobar cuál de las dos teorías explica mejor los resultados reales de los tratados comerciales:

    • Modelos de Equilibrio General Computable (EGC) — modelos de simulación a gran escala que intentan representar la economía completa, sector por sector, y posteriormente simulan qué ocurre cuando un tratado comercial modifica aranceles, cuotas o condiciones de acceso a los mercados. Son ampliamente utilizados por instituciones como el Banco Mundial y la OMC.
    • Modelos Lineales Generalizados (GLM) bayesianos objetivos — un enfoque estadístico moderno que emplea inferencia bayesiana —actualizando las creencias mediante los datos— con un mínimo de supuestos subjetivos (priores “objetivos”). Esto permite que los datos hablen con mayor libertad, sin imponer fuertes ideas preconcebidas acerca de cuál “debería” ser la respuesta.

    Los resultados combinados apuntan en la misma dirección: los resultados comerciales entre países con asimetrías tecnológicas significativas son explicados mejor por la ventaja absoluta que por la ventaja comparativa.

    ¿Qué significa esto en la práctica?

    Las implicaciones prácticas son importantes y van a contracorriente de las recomendaciones dominantes en materia de política comercial durante las últimas décadas.

    Si la ventaja comparativa es el enfoque correcto, entonces el libre comercio entre cualesquiera dos países —ricos o pobres, tecnológicamente avanzados o no— resulta mutuamente beneficioso casi por definición. La recomendación de política económica es sencilla: liberalizar, firmar acuerdos y reducir barreras.

    Pero si la ventaja absoluta constituye un modelo mejor, entonces la estructura del acuerdo importa enormemente. Un tratado comercial entre un país altamente industrializado y otro predominantemente agrícola no es intrínsecamente beneficioso para ambas partes. Puede encerrar al país menos desarrollado en exportaciones de bajo valor agregado mientras inunda sus mercados con bienes manufacturados que desplazan a la industria local. Las asimetrías tecnológicas y salariales entre los firmantes pasan entonces a ocupar un lugar central, en lugar de constituir una consideración secundaria.

    En otras palabras, los resultados de Gómez Julián sugieren que los tratados comerciales deberían diseñarse prestando una atención deliberada a los desequilibrios de poder y a las capacidades productivas de las partes involucradas, en lugar de firmarse simplemente bajo el supuesto de que todo comercio es necesariamente beneficioso.

    Por qué esto importa más allá de la economía

    Si sos politólogo, analista de políticas públicas o simplemente alguien que sigue la geopolítica, este debate está lejos de ser meramente académico. Los tratados comerciales se encuentran entre los instrumentos más importantes de la política exterior y de la estrategia económica interna. Moldean la política industrial, los mercados laborales, los patrones migratorios e incluso las alianzas geopolíticas.

    La cuestión de si un tratado comercial es “justo” o “beneficioso” depende de la teoría económica utilizada para evaluarlo. Si la teoría dominante es incorrecta —o, como mínimo, incompleta—, décadas de recomendaciones en materia de política comercial podrían haber subestimado sistemáticamente los riesgos de la liberalización entre socios desiguales.

    Esto no significa que el proteccionismo sea la respuesta. Pero sí significa que los términos de la relación importan. Un tratado comercial que tome en consideración las brechas tecnológicas, incluya disposiciones para la transferencia de tecnología e incorpore mecanismos de ajuste es un instrumento muy distinto de uno que simplemente elimine los aranceles entre economías desiguales y dé el asunto por terminado.

    Referencia: Gómez Julián, J. M. (2025). Teorías del comercio internacional versus resultados de los tratados comerciales: ¿ventaja absoluta o comparativa? Revista Cubana de Economía Internacional, 12(1), 36–57. https://revistas.uh.cu/rcei/article/view/11142

  • James Mill: Un Padre Olvidado de la Economía Política

    James Mill: Un Padre Olvidado de la Economía Política

    La influencia de James Mill en la ciencia económica moderna
    Historia del pensamiento económico

    La influencia de James Mill

    Aportaciones de James Mill a la ciencia económica moderna

    Basado en el artículo de José Mauricio Gómez Julián · Leer el artículo original

    El artículo parte de una tesis precisa: la literatura sobre Historia del Pensamiento Económico ha prestado poca atención a la importancia de James Mill para la ciencia económica moderna. Gómez Julián sostiene que Mill fue el primer economista en plantear que toda oferta crea su propia demanda, uno de los mejores exponentes de su época de la Teoría Cuantitativa del Dinero, un autor en cuya obra pueden encontrarse gérmenes de la Política Monetaria Moderna, y un pionero en cuestiones como el trabajo productivo e improductivo y la acumulación de capital. El objetivo declarado del artículo es demostrar cuán fundamental fue James Mill para la Economía Política moderna.

    Alcance del artículo

    El resumen del texto atribuye expresamente a Mill la primera definición clara de las nociones de Trabajo Productivo y Trabajo Improductivo. En el desarrollo del artículo, la exposición se concentra especialmente en la Ley de Say, la teoría monetaria, el consumo productivo e improductivo, el capital, la población, las clases sociales y las influencias intelectuales de Mill.

    I. El plagio menos conocido de los economistas clásicos

    Gómez Julián abre el desarrollo calificando como «el plagio menos conocido» de la época de los economistas clásicos la atribución a Jean-Baptiste Say de la formulación de la llamada Ley de Say, conocida popularmente por la afirmación de que «toda oferta crea su propia demanda».

    La reconstrucción histórica del artículo comienza con William Spence, autor de Britain Independent of Commerce —presentado en el texto como Bretaña no Depende del Comercio—, obra publicada en 1807. El artículo añade que la idea había sido desarrollada anteriormente por William Cobbett en su Political Register, bajo el título «Abajo el Comercio». A raíz de la obra de Spence, James Mill publicó Commerce Defended en 1808.

    En esa obra, Mill sostuvo que el producto anual de un país se emplea en realizar compras y, al ser ese mismo producto el que se ofrece a la venta, una parte del producto compra a la otra. De ahí deriva la idea de que el producto anual crea un mercado para sí mismo. Mill también aclara que puede existir exceso de una mercancía particular, pero no de las mercancías en general: un exceso sectorial implica que otras mercancías se han producido en proporción insuficiente y que los medios de producción deben redistribuirse hasta restablecer el equilibrio.

    «Por grande que sea el producto anual, siempre crea un mercado para sí mismo». James Mill, Commerce Defended (1808), citado en el artículo

    El artículo continúa con Elements of Political Economy (1821). Allí Mill plantea que la proporción en que las mercancías se intercambian depende, en primera instancia, de la relación entre oferta y demanda. Sin embargo, sostiene que su valor relativo depende en última instancia del costo de producción: los cambios de oferta o demanda pueden apartar temporalmente los valores de ese punto, mientras que la competencia, cuando no se encuentra obstruida, tiende a devolverlos a él.

    II. Teoría monetaria y Teoría Cuantitativa del Dinero

    En materia monetaria, el artículo retoma una observación de Marx: James Mill trató de exponer la teoría del dinero de Ricardo a partir de la circulación metálica simple, sin recurrir a las complicaciones internacionales con las que, según la formulación del propio artículo, Ricardo intentaba disimular la inconsistencia de su concepción y sin entrar en polémica con las funciones del Banco Central. Gómez Julián recuerda además que Ricardo cuestionó en más de una ocasión dichas funciones.

    Gómez Julián presenta a Mill como uno de los mejores exponentes de su tiempo de la Teoría Cuantitativa del Dinero. Según la exposición del artículo, Mill intenta demostrar de manera relativamente sólida que la cantidad de dinero circulante determina la suma total de los precios de las mercancías de una economía y determina igualmente el valor o precio del dinero.

    «Es la cantidad total de dinero de un país la que determina qué porción de éste se intercambia por una determinada cantidad de mercancías». James Mill, Elements of Political Economy (1821), traducción del pasaje citado

    Mill explica después dos circunstancias bajo las cuales el Gobierno crea dinero: 1) cuando desea dejarlo fluir libremente por los canales de circulación y 2) cuando desea controlar discrecionalmente la cantidad que circula. En el primer caso, el Gobierno deja abierta al público la Casa de la Moneda para convertir lingotes en moneda, de modo que las personas acuñan sus lingotes cuando su forma monetaria resulta más valiosa.

    Es precisamente aquí donde Gómez Julián identifica gérmenes de la Política Monetaria Moderna en James Mill, en contraste con predecesores como Ricardo, que cuestionaban la intervención monetaria del Gobierno. El artículo añade que, para Mill, el valor del dinero depende de su cantidad: aumenta con su escasez y, a través del mecanismo que el propio texto vincula con la «necesidad metafísica» atribuida a la posterior Ley de Say, el mercado de dinero tiende nuevamente al equilibrio.

    Mill también plantea que, si el Gobierno desea una cantidad de dinero circulante menor que la que existiría sin intervención, debe elevar el valor del metal contenido en la moneda; si desea una cantidad mayor, debe reducirlo. Gómez Julián presenta este mecanismo como otro germen de la Política Monetaria Moderna.

    III. Comercio, ventajas comparativas y competitividad cambiaria

    En el terreno del comercio internacional, el artículo sostiene que James Mill concebía la relación entre las naciones del mismo modo que la relación entre comerciantes: comprar en el mercado más barato y vender en el más caro. Gómez Julián contrapone explícitamente esta formulación a lo que denomina la «ilusión Ricardiana de las Ventajas Comparativas», que señala como muy difundida en aquella época.

    El texto añade que Mill fue uno de los primeros economistas en plantear el uso del valor de la moneda para ganar o perder competitividad en el mercado mundial; es decir, identifica en su obra una formulación temprana de la competitividad mediante los tipos de cambio.

    IV. Consumo, egoísmo y organización de la Economía Política

    Gómez Julián señala que en el pensamiento de Mill pueden encontrarse nociones originales de consumo productivo y consumo improductivo, retomadas posteriormente por Marx en su sistema teórico. Al comentar la exposición de Mill sobre estas nociones, Marx destacó su «habitual agudeza cínica y claridad».

    El artículo concede también una mención especial a los principios del egoísmo ligados a la propiedad privada y a la producción. Según Gómez Julián, estas cuestiones aparecen en Mill con mayor claridad y profundidad que en La teoría de los sentimientos morales de Adam Smith. El propio artículo resume esta concepción mediante una frase de Marx:

    «El límite de su necesidad constituye el límite de su producción». Karl Marx, citado por Gómez Julián

    La claridad de Mill se reflejaría igualmente en la organización de su obra magna, dividida en cuatro grandes partes:

    1. Producción
    2. Distribución
    3. Intercambio
    4. Consumo

    Gómez Julián destaca la profundidad, sencillez y concreción con las que Mill aborda esta estructura. El artículo no afirma que este esquema se convirtiera posteriormente en la plantilla general de los manuales de economía; esa extrapolación queda, por tanto, fuera de esta versión.

    El texto cita asimismo a Marx a propósito de las teorías monetarias de John Stuart Mill. Con la intención de poner de relieve la capacidad teórica de James Mill, Marx señala que el hijo mantenía una «lógica ecléctica» que le permitía abrazar las posiciones de su padre y, al mismo tiempo, las contrarias.

    V. Clases sociales, capital y población

    La cuestión de las clases sociales tampoco pasa inadvertida en el artículo. Aunque Gómez Julián caracteriza a James Mill como un «apologeta burgués por excelencia» de su época, destaca la claridad con que éste se refiere a la gran masa del pueblo como la clase que sólo puede ofrecer, a cambio de sus medios de subsistencia, un trabajo corriente.

    El artículo atribuye además a Mill una temprana comprensión de la distinción entre el medio de circulación como capital y el medio de circulación como simple medio de intercambio. Para ilustrarlo, reproduce un pasaje de Elements of Political Economy en el que Mill rechaza como circular la afirmación de que el valor de las mercancías dependa del capital, puesto que el capital mismo está compuesto por mercancías. Gómez Julián resume la interpretación marxiana indicando que el medio de circulación empleado con fines productivos constituye capital.

    Sobre población, Mill sostiene que existe una determinada densidad conveniente tanto para la interacción social como para la combinación de fuerzas que aumenta el producto del trabajo. A partir de ello, Gómez Julián afirma que Mill tenía claro que las necesidades del capital determinan esencialmente la densidad poblacional, en contraste con los conocidos planteamientos de Malthus.

    «Existe una cierta densidad de población conveniente […] para aquella combinación de fuerzas mediante la cual aumenta el producto del trabajo». James Mill, Elements of Political Economy (1821), traducción abreviada

    VI. Acumulación de capital e influencia intelectual

    Gómez Julián sostiene que James Mill fue, junto con S. Bailey, uno de los primeros economistas en discutir a fondo la cuestión de la Acumulación de Capital: en particular, la extensión de los efectos del capital industrial respecto de su acumulación cuando permanece constante la magnitud del capital total desembolsado.

    El artículo señala también el error cometido tanto por Mill como por Bailey al presentar como magnitud fija la parte del capital invertida en fuerza de trabajo —el capital variable—, separándola de la masa de ganancia obtenida por el capitalista.

    Finalmente, el texto recurre a John Maynard Keynes, quien explica que la denominación «economistas clásicos», inventada por Marx, se refería a Ricardo, James Mill y sus predecesores, es decir, a los fundadores de la teoría que culminó con Ricardo. Gómez Julián utiliza este pasaje para presentar a Mill como uno de los fundadores de la Economía Política.

    Aportaciones indirectas

    El artículo concluye señalando otras aportaciones de carácter indirecto: la formación intelectual de John Stuart Mill y el papel de James Mill como uno de los principales mentores de David Ricardo en Economía Política. En una nota final, añade que Mill fue el principal motivador para que Ricardo escribiera su obra magna y observa el parecido entre el título de la obra de Ricardo y el de una obra de James Mill publicada varios años antes.

    · · ·

    La tesis del artículo

    La conclusión que se desprende del conjunto de la exposición coincide con el objetivo anunciado desde el resumen: mostrar que James Mill desempeñó un papel fundamental en la formación de la ciencia económica moderna. El argumento se apoya en sus aportaciones a la relación entre oferta y demanda, la teoría del valor y los costos de producción, la Teoría Cuantitativa del Dinero, los antecedentes de la política monetaria, el comercio y los tipos de cambio, el consumo, el egoísmo y la propiedad privada, las clases sociales, la distinción entre dinero y capital, la población, la acumulación de capital y su influencia directa sobre John Stuart Mill y David Ricardo.

    Bibliografía citada en el artículo

    • Keynes, J. (2003). Teoría General de la Ocupación, el Interés y el Dinero. Fondo de Cultura Económica, México D. F.
    • Marx, K. (1844). Comments on James Mill, Éléments D’économie Politique.
    • Marx, K. (1989). Contribución a la Crítica de la Economía Política. Editorial Progreso, Moscú.
    • Marx, K. (2010). El Capital. Fondo de Cultura Económica, México D. F.
    • Mill, J. (1808). Commerce Defended.
    • Mill, J. (1821). Elements of Political Economy.
    • Mill, J. (1825). Colony.
    • Sraffa, P. (1795). The Works and Correspondence of David Ricardo, Vol. 10, Biographical Miscellany.
    • Winch, D. (1966). Selected Economic Writings.

    — Fin —

  • ¿Cómo Hacer Política Económica Ante un Superávit o Déficit de Capital Fijo Sin Papel Moneda?

    ¿Cómo Hacer Política Económica Ante un Superávit o Déficit de Capital Fijo Sin Papel Moneda?

    ¿Cómo realizar política económica ante superávit o déficit de capital fijo sin recurrir al papel moneda?
    Un blog para el economista curioso — y para todos los demás
    La cuestión del capital
    Economía política marxista Política económica 8 min de lectura

    ¿Cómo realizar política económica ante superávit o déficit de capital fijo sin recurrir al papel moneda?

    A partir de un problema expuesto de manera embrionaria por Marx en el tomo II de El capital, este artículo examina cómo una sociedad poscapitalista podría afrontar los superávits y déficits de capital fijo sin recurrir al papel moneda ni, en general, a la política monetaria.

    MG
    José Mauricio Gómez Julián
    Contribuciones a la Economía • Enero de 2016 • ISSN 1696-8360

    En las economías contemporáneas resulta difícil concebir una política económica destinada a manejar el superávit o el déficit de una mercancía sin recurrir, de una u otra forma, a la política monetaria. El artículo parte de esa constatación y centra el problema en una variable particularmente importante: el capital fijo. Su objetivo es demostrar que, en una sociedad poscapitalista, sería posible controlar los superávits y déficits de capital fijo sin recurrir al papel moneda ni a las variables asociadas a éste.

    Introducción: el problema y sus alcances

    El análisis constituye un desarrollo teórico complementario de un problema planteado por Marx en el tomo II de El capital. El artículo utiliza el mismo ejemplo teórico de Marx, aunque advierte que el fenómeno puede originarse por diversas causas que quedan fuera de su delimitación. Asimismo, el desequilibrio no tiene por qué producirse exclusivamente entre grandes sectores de la economía: puede presentarse tanto a nivel intersectorial como a nivel intrasectorial.

    En una sociedad capitalista, las consecuencias de estos desajustes no son esencialmente distintas de las que provoca el superávit —sobreproducción— o el déficit —escasez— de cualquier otra mercancía. El comercio exterior puede ofrecer una salida de corto plazo. Ante un superávit, puede permitir transformar en medios de consumo una parte de la mercancía del Sector I que ha quedado estancada bajo forma dineraria; ante un déficit, puede contribuir a dar salida al remanente de mercancías relacionado con la amortización del capital fijo. Pero esa solución no elimina la contradicción: simplemente la desplaza a una esfera más extensa, ampliando su campo de acción y potencialmente la magnitud de sus consecuencias.

    El problema central no es simplemente cuánto capital fijo existe, sino cómo mantener su proporcionalidad respecto del capital circulante cuando la reposición física del primero varía de un año a otro.

    Los dos escenarios teóricos

    El razonamiento se desarrolla a partir de la relación entre dos sectores: el sector productor de medios de producción y el sector productor de medios de consumo. La cuestión decisiva es cómo cambia la relación entre la parte fija y la parte circulante del capital constante cuando varía la proporción de capital fijo que debe ser repuesta físicamente.

    1

    Primer escenario

    Si aumenta la parte de la producción de medios de producción destinada a reponer el capital fijo del sector productor de medios de consumo, mientras permanece constante la producción global destinada a abastecerlo de capital constante, el aumento de la amortización modifica la proporción entre la reposición del capital fijo y los elementos circulantes necesarios. Una parte mayor del capital fijo restaurado bajo forma dineraria fluye hacia el sector productor de medios de producción para recuperar su forma natural, de modo que circula más dinero con función unilateral de medio de compra, al tiempo que cambia la masa de mercancías intercambiada entre ambos sectores.

    Resultado → SUPERÁVIT EN LA PRODUCCIÓN DE CAPITAL FIJO
    2

    Segundo escenario

    Si disminuye la proporción del capital fijo del sector productor de medios de consumo que debe reproducirse en especie —es decir, reemplazarse físicamente de una vez—, aumenta correspondientemente la parte que sólo debe reponerse en dinero mediante el fondo de reserva. La masa de elementos circulantes del capital constante reproducidos por el sector de medios de producción permanece sin variación, mientras disminuye la producción del capital fijo sujeto a reposición.

    Resultado → DÉFICIT EN LA PRODUCCIÓN DE CAPITAL FIJO

    La propuesta de política económica

    El artículo da entonces el paso decisivo. Una vez suprimido el modo de producción capitalista —y, con él, el papel moneda en los términos del planteamiento desarrollado—, el problema de la proporcionalidad entre capital fijo y capital circulante se reduce fundamentalmente a que la magnitud del capital fijo que se agota y debe reponerse físicamente puede variar de un año a otro. Esas variaciones pueden compensarse sucesivamente, mientras que, ceteris paribus, la parte restante del capital constante necesaria para la producción anual de artículos de consumo —materias primas, auxiliares e intermedias— no tiene por qué disminuir.

    La respuesta propuesta por el artículo es una continua sobreproducción relativa: producir una cierta cantidad de capital fijo por encima de la necesidad inmediata y mantener existencias de materias primas, materias auxiliares y materias intermedias superiores a las necesidades anuales.

    Esos valores de uso excedentarios no serían mercancías producidas sin salida, sino un fondo de reserva. Su función sería proporcionar al proceso productivo la parte del capital constante que resulte necesaria en cada momento: capital fijo cuando exista déficit de su parte fija, o elementos circulantes cuando el desajuste exija reforzar esa parte. La finalidad es impedir que las variaciones de la reposición del capital fijo reduzcan o perturben la reproducción del sistema.

    De esta manera, la propuesta no consiste en eliminar las variaciones materiales que originan los desajustes, sino en disponer conscientemente de reservas capaces de compensarlas. La fluctuación interanual de la reposición física del capital fijo permanece; lo que cambia es el mecanismo social mediante el cual se responde a ella.

    Por qué la misma política no funcionaría bajo el capitalismo

    El artículo subraya que una política semejante tendría un significado completamente diferente dentro de una sociedad capitalista. Allí constituiría un elemento de anarquía porque la planificación no pertenece a la esencia del sistema. Además, la sobreproducción capitalista no es «relativa» en el sentido específico utilizado por la propuesta: genera crisis comerciales. Tampoco adopta la forma de una sobreproducción continua y conscientemente mantenida como reserva, sino que las crisis comerciales presentan un carácter cíclico.

    La diferencia fundamental reside, por tanto, en la organización del proceso productivo. En el planteamiento poscapitalista del artículo, el excedente se produce deliberadamente como reserva de valores de uso para garantizar la reproducción; dentro del capitalismo, la sobreproducción aparece en un sistema cuya dinámica no está regida por esa planificación consciente y desemboca en crisis comerciales.

    • • •

    Breve apreciación final

    El artículo termina desplazando la atención desde el problema técnico hacia la historia de la teoría marxista. Gómez Julián señala que el Diccionario de Economía Política de Borísov, Zhamin y Makárova —que toma como una síntesis de la teoría económica soviética de su época— no desarrolla ni siquiera menciona este problema en sus entradas dedicadas al «Capital Fijo», la «Reproducción Simple» o la «Reproducción Ampliada».

    La omisión resulta especialmente significativa para el autor porque Marx había dejado planteado el problema, aunque sólo de manera embrionaria, en las páginas 414–417 del tomo II de El capital. Gómez Julián considera que la cuestión posee una importancia vital tanto para la teoría marxista como para la construcción de una sociedad comunista o de cualquier otra sociedad poscapitalista.

    A partir de ello formula una crítica deliberadamente severa contra el marxismo soviético: interpreta la ausencia de este desarrollo como una muestra de que numerosos fundamentos de la teoría no fueron comprendidos adecuadamente ni en el plano teórico ni en el práctico, y vincula polémicamente esa valoración con el desenlace histórico simbolizado por el 9 de noviembre de 1989.

    La tesis del artículo, en síntesis

    El argumento puede condensarse así: las variaciones de un año a otro en la parte del capital fijo que debe reponerse físicamente generan desajustes entre capital fijo y capital circulante. Bajo el capitalismo, estos desequilibrios se manifiestan dentro de una estructura mercantil y monetaria y pueden desembocar en sobreproducción, escasez y crisis. En una sociedad poscapitalista, en cambio, el artículo propone prescindir del papel moneda para afrontar este problema mediante una continua sobreproducción relativa de capital fijo y de elementos circulantes, cuyos excedentes serían acumulados como fondos de reserva y utilizados según las necesidades materiales de la reproducción.

    Esta entrada presenta en lenguaje divulgativo el argumento desarrollado por José Mauricio Gómez Julián. El fenómeno analizado puede producirse por causas diversas —que el artículo no estudia por razones de delimitación— y puede aparecer tanto a nivel intersectorial como intrasectorial. Para consultar el desarrollo original y su vínculo directo con Marx, véase: Gómez Julián, J. M. (2016), “¿Cómo realizar política económica ante superávit o déficit de capital fijo sin recurrir al papel moneda?”, Contribuciones a la Economía.
    Artículo original Gómez Julián, José Mauricio. “¿Cómo realizar política económica ante superávit o déficit de capital fijo sin recurrir al papel moneda?” Contribuciones a la Economía, enero de 2016, ISSN 1696-8360.
    Texto completo: https://dialnet.unirioja.es/servlet/articulo?codigo=9041512

    Referencias principales del artículo: Karl Marx, El Capital, Fondo de Cultura Económica, 2010; Borísov, Zhamin y Makárova, Diccionario de Economía Política, 1965.

    La cuestión del capital — Economía política explicada desde sus problemas teóricos fundamentales.

  • Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Modelos de Parámetros Dinámicos Generales Mediante Anclaje de Referencia

    Pueden encontrar esta librería y su documentación en CRAN y descargargla directamente desde R y RStudio.

    Además, también les recomendamos echarle un ojo al mapa mental resumen al final de este artículo para entender mejor la relación entre las funciones del paquete.

    Reseña de biblioteca de R

    Conoce gdpar

    Modelos de Parámetros Dinámicos Generales mediante Anclaje de Referencia

    En el cálculo fugaz de una decisión de dos segundos —adelantar un automóvil en una carretera estrecha— el cerebro humano realiza un notable truco estadístico. No construye desde cero un modelo del conductor que se aproxima. En su lugar, recupera una referencia de base: el conductor promedio, que representa tiempos de reacción típicos y un nivel modal de agresividad. En una fracción de segundo, interpreta las señales específicas del conductor real —velocidad relativa, tipo de vehículo, micromovimientos— y estima en qué medida este conductor específico se desvía de la referencia. La decisión de adelantar surge de esa síntesis.

    Esta receta cognitiva —referencia poblacional + desviación individual— constituye el fundamento filosófico del paquete de R gdpar (General Dynamic Parameter models via Reference Anchoring) de José Mauricio Gómez Julián. El paquete toma esta intuición, la formaliza como una descomposición estadística rigurosa, demuestra las condiciones bajo las cuales es matemáticamente identificable, proporciona un motor bayesiano basado en Stan para estimarla y añade capas de inferencia causal, muestreo adaptativo a la geometría e inferencia robusta frente a la dependencia.

    ❦

    La anatomía de la desviación

    Cada capa de gdpar constituye una elaboración de una única y elegante ecuación. Para cada observación $i$ con covariables $x_i$:

    $$ \theta_i \;=\; \theta_{\text{ref}} \;+\; \Delta(x_i,\; \theta_{\text{ref}}) $$

    Se lee así: el parámetro del individuo $i$ es igual a una referencia poblacional, más una desviación que es, a su vez, función de las covariables del individuo y de la propia referencia.

    Es en esa última cláusula donde la arquitectura se aparta de la estadística clásica. La desviación $\Delta$ no depende únicamente de quién sos (tus covariables $x_i$); depende de cuál es la referencia. Si trasladás el modelo a una nueva población, la función de desviación se comporta de manera diferente porque $\theta_{\text{ref}}$ es uno de sus argumentos. Esta dependencia estructural es la característica definitoria del «anclaje de referencia». Distingue a gdpar de los modelos de efectos aleatorios o de coeficientes variables, en los cuales la desviación está estructuralmente separada de la referencia.

    Entonces, ¿qué forma tiene $\Delta$? El paquete distingue una forma funcional específica denominada descomposición Aditiva–Multiplicativa–Modulada (AMM):

    $$ \Delta(x,\theta_{\text{ref}}) \;=\; \underbrace{a(x)}_{\text{aditiva}} \;+\; \underbrace{b(x)\odot\theta_{\text{ref}}}_{\text{multiplicativa}} \;+\; \underbrace{W(\theta_{\text{ref}})\,x}_{\text{modulada}} $$

    Tres mecanismos, claramente separados e interpretables de forma independiente:

    • $a(x)$ — Un desplazamiento puramente aditivo. Puede pensarse como un efecto fijo tradicional determinado por covariables.
    • $b(x)\odot\theta_{\text{ref}}$ — Un escalamiento de la referencia dependiente de las covariables (mediante el producto de Hadamard o producto elemento a elemento). Aquí es donde «la desviación depende de la referencia» entra de manera multiplicativa.
    • $W(\theta_{\text{ref}})\,x$ — Las covariables se combinan mediante una matriz $W$ que, a su vez, está ajustada por la referencia. Este es el canal explícito y estructuralmente dependiente de la referencia.

    Los modelos estándar aparecen como casos particulares. Si se establece $\Delta \equiv 0$, se obtiene una regresión de efectos fijos. Si se establece $W \equiv 0$, se obtiene un modelo jerárquico con interacción multiplicativa. Si se establece $b \equiv 0$, se obtiene un modelo de coeficientes variables. La AMM es la familia natural mínima que contiene los tres casos y eleva la referencia al papel de argumento activo de la desviación.

    ❦

    Los tres motores de estimación

    gdpar define tres motores complementarios para estimar $\Delta$. De manera crucial, solo uno es ejecutable en la versión actual: una decisión deliberada de plantear un alcance matemático que excede la superficie ejecutable y de declararlo con transparencia.

    Ruta Motor Representación Estado
    Ruta 1 Bayesiano jerárquico (Stan) AMM paramétrica ✅ Operativa
    Ruta 2 Coeficientes variables (splines) $\beta(z)$ suave 🚧 Conceptual
    Ruta 3 Hiperrred / Red neuronal La red genera $\theta_i$ 🚧 Conceptual

    Las rutas 2 y 3 están documentadas con calidad de referencia —la Wiki desarrolla la teoría asintótica completa (tasas de contracción, Bernstein–von Mises)—, pero si se invocan terminan con gdpar_unsupported_feature_error. La Ruta 1 asigna distribuciones a priori a cada componente ($\theta_{\text{ref}}, a, b, W$) y muestrea la distribución posterior conjunta mediante HMC, produciendo de forma nativa incertidumbre basada en la posterior completa.

    Historia de dos posteriores: EB frente a FB

    Dentro de la Ruta 1, gdpar ofrece dos regímenes inferenciales. Bayes completo (FB), mediante gdpar(), muestrea la posterior conjunta y se mantiene como la opción más fiel a la analogía cognitiva. Bayes empírico (EB), mediante gdpar_eb(), estima los hiperparámetros maximizando una verosimilitud marginal mediante una aproximación de Laplace y, posteriormente, muestrea los parámetros restantes de manera condicional.

    El comparador EB frente a FB

    En lugar de imponer una elección, gdpar los trata como rutas paralelas. Incluye un comparador específico, gdpar_compare_eb_fb(), que cuantifica el grado de concordancia en $\theta_{\text{ref}}$ y en el vector de parámetros reducido $\xi$. La Wiki desarrolla la teoría con profundidad de primer nivel: las posteriores de nivel inferior de EB y FB coinciden asintóticamente (Teorema 7A), mientras que los intervalos EB presentan una cobertura insuficiente de orden $O(n^{-1})$ (Proposición 7B). Si alguna vez te has preguntado si EB es «suficientemente bueno» para tus datos, gdpar permite responderlo empíricamente.

    Regresión distribucional: cada parámetro es una ranura

    gdpar no está restringido a modelar la media. Una distribución de probabilidad posee múltiples parámetros —localización, escala, forma, índice de cola, probabilidad de inflación de ceros— y cada uno de ellos puede tener su propia descomposición AMM. El paquete los indexa mediante $k = 1, \dots, K$:

    $$ \theta_i^{(k)} = \theta_{\text{ref}}^{(k)} + \Delta^{(k)}(x_i, \theta_{\text{ref}}^{(k)}), \qquad k = 1, \dots, K $$

    El repertorio incorporado abarca las familias gaussiana, Poisson, binomial negativa, Bernoulli, Beta, Gamma, Student-$t$, Tweedie, ZIP, ZINB y hurdle. Los modelos inflados en cero y hurdle reciben un tratamiento especialmente elegante: tanto la probabilidad de inflación de ceros $\pi_i$ como el parámetro de conteo $\theta_i$ quedan anclados a sus respectivas referencias, conformando un diseño de desviación dual.

    ❦

    El puente causal

    Dado que la forma AMM produce parámetros individuales, los efectos individuales del tratamiento surgen de manera natural. gdpar_causal_bridge() implementa un T-learner: ajusta el modelo anclado por separado bajo tratamiento y control y, posteriormente, obtiene el efecto promedio condicional del tratamiento (CATE) en $x_i$ como la diferencia entre las predicciones individuales ancladas:

    $$ \widehat{\tau}(x_i) = \widehat{\mu}_1(x_i) – \widehat{\mu}_0(x_i) $$

    Una segunda capa, gdpar_compare_meta_learners(), compara el learner basado en AMM con meta-learners externos mediante adaptadores conectables: grf::causal_forest del lado de R y CausalForestDML de EconML del lado de Python (mediante reticulate). Las afirmaciones causales del marco se someten a comparación empírica; no se dan simplemente por sentadas.

    Mecánica y engranajes

    Varias decisiones de ingeniería elevan a gdpar de ejercicio teórico a entorno computacional serio:

    • Generador de código Stan: Compone programas a partir de piezas canónicas —bloques AMM para $p=1$ y $p \geq 1$, bloques marginales/condicionales EB y bloques distribucionales-$K$— seleccionadas según la configuración resuelta $(K, p, \text{family}, W, \text{parametrization}, \text{group})$. La base de $W$ admite B-splines con evaluación Cox–de Boor del lado de Stan, garantizando diferenciabilidad dentro de HMC.
    • Verificación previa de identificabilidad: Antes de cualquier muestreo, gdpar_check_identifiability() ejecuta una comprobación de la matriz de Gram (Proposición 1C), una comprobación por coordenada entre componentes (C4-bis) para $p > 1$ y una comprobación anti-aliasing por grupo (C7). Si tu diseño no es identificable, lo sabrás antes de que el muestreador consuma tiempo de CPU, acompañado de un gdpar_identifiability_error estructurado que identifica las direcciones dependientes.
    • Reparametrización guiada por los datos: Trata la parametrización de $b(x) \odot \theta_{\text{ref}}$ como una decisión previa al ajuste. Un breve piloto calcula una razón de información y deriva el problema hacia CP, NCP o —la solución de gdpar dirigida a la causa raíz— una reparametrización lineal que muestrea directamente el producto $\theta_{\text{ref}} \cdot b$, evitando por completo los embudos bilineales.

    Herramientas avanzadas de activación opcional

    Dos capacidades avanzadas están desactivadas por defecto y documentadas con el mismo nivel de detalle que la ruta principal.

    1. Muestreo adaptativo a la geometría

    Las posteriores AMM jerárquicas pueden presentar geometrías particularmente hostiles —embudos, cuasi-determinismo, colas pesadas—. El motor geométrico, de activación opcional, asciende por una jerarquía de métricas riemannianas: Euclidiana → Fisher/SoftAbs → subriemanniana → relativista/Finsler. Un orquestador certificador diagnostica la patología, selecciona una métrica, ajusta el integrador y emite un certificado. Si se certifica que el muestreo completo es inviable, un mecanismo alternativo de Laplace proporciona una posterior plug-in con un ELPD comparable al de mgcv-REML o INLA-Laplace.

    2. Inferencia robusta frente a la dependencia

    gdpar no modela la dependencia temporal o espacial dentro de su estructura puntual; en su lugar, hace que la inferencia sea robusta frente a la dependencia (un enfoque de independencia de trabajo + varianza sándwich, en el espíritu de Liang & Zeger, 1986). Se obtienen diagnósticos (Durbin–Watson, Ljung–Box, $I$ de Moran) y errores estándar robustos mediante bootstrap por bloques: bloques móviles o circulares en el tiempo (con longitud automática de bloque flat-top de Politis–White) y bloques espaciales en mosaico con origen aleatorizado. Las estimaciones puntuales permanecen intactas; únicamente la incertidumbre se vuelve más honesta.

    ⚠️ Limitaciones declaradas con transparencia

    La Wiki es admirablemente explícita respecto del alcance. Solo la Ruta 1 es ejecutable en la versión 0.1.0. La dependencia no se modela: únicamente se hace robusta la inferencia frente a ella. El alcance matemático del paquete excede su superficie ejecutable por diseño. Conviene leer cuidadosamente las notas de «Estado de implementación» antes de depender de una determinada funcionalidad.

    ❦

    En resumen

    gdpar toma una de las ideas más naturales de la predicción humana —predecir a un individuo como una desviación respecto de una referencia poblacional, donde la propia desviación depende de esa referencia— y la transforma en un marco de regresión bayesiana plenamente especificado, con comprobación de identificabilidad y respaldado por Stan. Es teóricamente riguroso, computacionalmente serio y excepcionalmente transparente respecto de lo que hace y de lo que todavía no hace. Si tu trabajo involucra heterogeneidad individual, regresión distribucional o estimación de efectos causales con incertidumbre fundamentada, gdpar merece una mirada detenida.