“Is that to say we are against Free Trade? No, we are for Free Trade, because by Free Trade all economical laws, with their most astounding contradictions, will act upon a larger scale, upon the territory of the whole earth; and because from the uniting of all these contradictions in a single group, where they will stand face to face, will result the struggle which will itself eventuate in the emancipation of the proletariat.”
Karl Heinrich Marx · Marx-Engels Collected Works, Vol. VI, p. 290
Bayes, T. (23 de Diciembre de 1763). An Essay towards solving a Problem in the Doctrine of Chances. Philosophical Transactions of the Royal Society of London, 370-418.
Bernoulli, J. (2006). The Art of Conjecturing (Together to a Friend on Sets in Court Tennis). Maryland: John Hopkins University Press.
DeGroot, M., & Schervish, M. (2012). Probability and Statistics. Boston: Pearson Education.
Dussel, E. (1991). 2. El método dialéctico de lo abstracto a lo concreto (20, 41-33, 14; 21,3-31,38) :(Cuaderno M. desde la página 14 del manuscrito, terminado a mediados deseptiembre de 1857). En E. Dussel, La producción teórica de Marx: un comentario a los grundrisse (págs. 48-63). México D.F.: Siglo XXI Editores. Obtenido de http://biblioteca.clacso.edu.ar/clacso/otros/20120424094653/3cap2.pdf
Efron, B. (1978). Controversies in the Foundations of Statistics. The American Mathematical Monthly, 231-246.
Fröhlich, N. (2012). Labour values, prices of production and the missing equalisation tendency of profit rates: evidence from the German economy. Cambridge Journal of Economics, 37(5), 1107-1126.
Frolov, I. T. (1984). Diccionario de filosofía. (O. Razinkov, Trad.) Moscú: Editorial Progreso. Obtenido de http://filosofia.org/
Maibaum, G. (1988). Teoría de Probabilidades y Estadística Matemática. (M. Á. Pérez, Trad.) La Habana, Cuba: Editorial Pueblo y Educación.
Marx, K. (1894). Capital. A Critique of Political Economy (Vol. III). New York: International Publishers.
Marx, K. (1989). Contribución a la Crítica de la Economía Política. Moscú: Editorial Progreso.
Marx, K. (2007). Elementos Fundamentales para la Crítica de la Economía Política (Grundrisse) 1857-1858 (Vol. I). (J. Aricó, M. Murmis, P. Scaron, Edits., & P. Scaron, Trad.) México, D.F.: Siglo XXI Editores.
Marx, K. (2010). El Capital (Vol. I). México, D.F.: Fondo de Cultura Económica.
Marx, K., & Engels, F. (1987). Karl Marx and Friedrich Engels Collected Works (Vol. XLII). Moscú: Progress Publishers.
Mittelhammer, R. (2013). Mathematical Statistics for Economics and Business (Segunda ed.). New York: Springer.
Perezgonzalez, J. (3 de Marzo de 2015). Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing. (L. Roberts, Ed.) Frontiers in Psychology, 6(223), 1-11. doi:10.3389/fpsyg.2015.00223
Poisson, S.-D. (2013). Researches into the Probabilities of Judgments in Criminal and Civil Cases. (O. Sheynin, Ed.) Berlin: arXiv. Obtenido de https://arxiv.org/abs/1902.02782
Fórmula general para permutar un conjunto repitiendo sus elementosEjemplo de permutaciones con repetición para el caso de un conjunto de cuatro elementos
CÓDIGO EN R
library(gtools)
permutations(10, 10, conjunto, set = FALSE)
IV. COMBINACIONES SIN REPETICIÓN
Fórmula general para calcular combinaciones sin repetición
Desde Pierre-Simon Laplace en 1840 con su célebre “Ensayo Filosófico Sobre Probabilidades”, los filósofos y científicos se han interesado por dicotomía, sugerida por la observación de los hechos de la realidad, entre la incertidumbre y el determinismo. Henri Poincaré en 1908 coge el testigo de Laplace, comenzando así el esfuerzo consciente por unificarlas filosóficamente y dando así nacimiento a la Teoría del Caos, para que luego Edward Lorenz en 1963 diera a luz los Sistemas Complejos en su investigación titulada “Deterministic Nonperiodic Flow” y finalmente fue Benoit Mandelbrot en 1982 quien revolucionó la Geometría con el planteamiento de las superficies fractales en su obra “La Geometría Fractal de la Naturaleza”. Así como para los sistemas complejos ha sido de vital importancia ir comprendiendo unificadamente el caos y el determinismo, también fue para los sistemas filosóficos (particularmente la Antigua Grecia y del Idealismo Clásico Alemán) alcanzar precisión en las definiciones de las categorías esencia, forma, contenido, apariencia y fenómeno. Estas categorías filosóficas fueron trabajadas por los filósofos soviéticos en su búsqueda por comprender de manera holista la realidad, siendo plasmadas en el célebre “Diccionario Filosófico” publicado en 1971. La presente investigación plantea que la forma óptima de instrumentalizar esa visión filosófica es nutriéndola de los hallazgos realizados en el campo de la Teoría del Caos y también que la forma óptima de depurar teóricamente lo relacionado a los sistemas complejos es mediante su análisis a la luz de la Lógica Dialéctica-Materialista.
Palabras Clave: Materialismo Dialéctico, Sistemas Complejos, Fractales, Teoría del Caos, Escuela de Filosofía Soviética.
REREFENCIAS
Aravindh, M., Venkatesan, A., & Lakshmanan, M. (2018). Strange nonchaotic attractors for computation. Physical Review E, 97(5), 1-10. doi:https://doi.org/10.1103/PhysRevE.97.052212
Barnet, W., & Chen, P. (1988). Deterministic Chaos and Fractal Atrractors as Tools for NonParametric Dynamical Econometric Inference: With An Application to the Divisa Monetary Aggregates. Computational Mathematics and Modeling, 275-296. Obtenido de http://www.maths.usyd.edu.au/u/gottwald/preprints/testforchaos_MPI.pdf
Elert, G. (11 de Agosto de 2020). Flow Regimes – The Physics Hypertextbook. Recuperado el 11 de Agosto de 2020, de https://physics.info/turbulence/
Gottwald, G., & Melbourne, I. (2016). The 0-1 Test for Chaos: A review. En U. Parlitz, E. G. Lega, R. Barrio, P. Cincotta, C. Giordano, C. Skokos, . . . J. Laskar, & C. G. Sokos (Ed.), Chaos Detection and Predictability (págs. 221-248). Berlin: Springer.
Halperin, B. (2019). Theory of dynamic critical phenomena. Physics Today, 72(2), 42-43. doi:10.1063/PT.3.4137
Jaynes, E. (2003). Probability Theory. The Logic of Science. Cambridge University Press: New York.
Kessler, D., & Greenkorn, R. (1999). Momentum, Heat, and Mass Transfer Fundamentals. New York: Marcel Denker, Inc.
Kilifarska, N., Bakmutov, V., & Melnyk, G. (2020). The Hidden Link Between Earth’s Magnetic Field and Climate. Leiden: Elsevier.
Landau, L. (1994). Física Teórica. Física Estadística (Segunda ed., Vol. 5). (S. Velayos, Ed., & E. L. Vázquez, Trad.) Barcelona: Reverté, S.A.
Lesne, A. (1998). Renormalization Methods. Critical Phenomena, Chaos, Fractal Structures. Baffins Lane, Chichester, West Sussex, England: John Wiley & Sons Ltd.
Lesne, A., & Laguës, M. (2012). Scale Invariance. From Phase Transitions to Turbulence (Primera edición, traducida del francés (que cuenta con dos ediciones) ed.). New York: Springer.
Linder, J., Kohar, V., Kia, B., Hippke, M., Learned, J., & Ditto, W. (4 de Febrero de 2015). Strange nonchaotic stars. Recuperado el 16 de Abril de 2020, de Nonlinear Sciences > Chaotic Dynamics: https://arxiv.org/pdf/1501.01747.pdf
Lorenz, E. (1963). Deterministic Nonperiodic Flow. JOURNAL OF THE ATMOSPHERIC SCIENCES, 20, 130-141.
Mandelbrot, B. (1983). THE FRACTAL GEOMETRY OF NATURE. New York: W.H. Freeman and Company.
Pezard, L., & Nandrino, J. (2001). Paradigme dynamique en psychopathologie: la “Théorie du chaos”, de la physique à la psychiatrie [Dynamic paradigm in psychopathology: “chaos theory”, from physics to psychiatry]. Encephale, 27(3), 260-268. Obtenido de https://pubmed.ncbi.nlm.nih.gov/11488256/
Sharma, V. (2003). Deterministic Chaos and Fractal Complexity in the Dynamics of Cardiovascular Behavior: Perspectives on a New Frontier. The Open Cardiovascular Medicine Journal(3), 110-123.
Valdebenito, E. (1 de Julio de 2019). Fractales: La Geometría del Caos. Recuperado el 11 de Agosto de 2020, de viXra: https://vixra.org/pdf/1901.0152v1.pdf
Werndl, C. (2013). What Are the New Implications of Chaos for Unpredictability? The British Journal for the Philosophy of Science, 60(1), 1-25. doi:10.1093/bjps/axn053
Bellman, R. (1972). Dynamic Programming (Sexta Impresión ed.). New Jersey: Princeton University Press.
Dunn, K. G. (3 de Marzo de 2021). Process Improvement Using Data. Hamilton, Ontario, Canadá: Learning Chemical Engineering. Obtenido de 6.5. Principal Component Analysis (PCA) | 6. Latent Variable Modelling: https://learnche.org/pid/PID.pdf?60da13
Jollife, I. (2002). Principal Component Analysis. New York: Springer-Verlag.
Como es ampliamente conocido, la matriz insumo-producto (de ahora en adelante, MIP) es un cuadro estadístico de naturaleza macroeconómica y de presentación desagregada, el cual cristaliza la totalidad de la actividad económica anual de forma desagregada, que a su vez representa una especie de radiografía del sistema de economía política capitalista. En este sentido, la MIP es de importancia fundamental para estudiar el desempeño del sistema, sea en un período anual o a largo plazo. En el análisis de los fenómenos económicos, el abordaje estadístico-matemático[1] de las MIP es característico de la escuela marxista conocida como Nueva Interpretación, muy poco usado es en otras escuelas marxistas y en la ortodoxia, i.e., la escuela neomarginalista (mal llamada “neoclásica”), el análisis insumo-producto no es de especial interés desde más o menos la prehistoria de la síntesis neomarginalista, que data de la época de Paul Samuelson y Robert Solow suscitada alrededor del punto medio del epílogo del siglo pasado.
Existen investigaciones teóricas, como la de (Kuroki, 1985), en las que se afirma que existe en el largo plazo un proceso de ecualización de las tasas de ganancia industriales si y solo si los sectores del sistema de economía política están altamente interrelacionados. Al respecto, señala Kuroki que “Entonces podríamos concluir que solo el sistema en el que ambos sectores usan relativamente mucho la producción del otro como su propio insumo y, por lo tanto, el grado de interdependencia técnica es grande, tiene la tasa uniforme de ganancia estable (es decir, por ejemplo, la economía donde se necesita mucho trigo para hacer hierro y al mismo tiempo se usa mucho hierro para producir trigo).” (Kuroki, 1985, págs. 48-49). En esta investigación, se desea demostrar empíricamente que ese supuesto siempre se cumple, al menos para el caso de la economía política hegemónica a nivel planetario de las últimas décadas, puesto que se asume que es el caso representativo. Por ello, se estudiará el caso de Estados Unidos, así como en su momento por los mismos motivos metodológicos Marx estudió a Inglaterra.
Debido a lo anterior, la MIP se erige, por consiguiente, en el recurso estadístico idóneo por antonomasia para semejante tarea. Como es sabido, la MIP está compuesta en sus filas por los diferentes sectores que componen la producción de una economía, mientras que en sus columnas está compuesta por el consumo productivo (consumo intermedio) intersectorial (incluyendo el autoconsumo sectorial), i.e., por el desglose del consumo intermedio que cada sector realiza de los otros sectores y de sí mismo, necesario para un determinado nivel de producto final. En el SCN de U.S., la MIP se presenta seccionada en dos partes, por un lado, los conocidos cuadros de producción y, por otro lado, los cuadros de usos. Los cuadros de producción contienen en las filas los sectores del sistema económico y en las columnas la producción desagregada (por el tipo de mercancía -según industria a la que pertenece- que compone su producción); estos cuadros no deben confundirse con los cuadros de oferta y los cuadros de utilización conocidos como COU.
Sin embargo, como se puede verificar en las diversas investigaciones que representan en este sentido el estado del arte [(Kliman, The law of value and laws of statistics: sectoral values and prices in the US economy, 1977-97, 2002), (Cockshott & Cottrell, Robust correlations between prices and labor values, 2005), (Kliman, Reply to Cockshott and Cottrell, 2005), (Zachariah, 2006), (Sánchez & Ferràndez, Valores, precios de producción y precios de mercado a partir de los datos de la economía española, 2010), (Cockshott, Cottrell, & Valle Baeza, The Empirics of the Labour Theory of Value: Reply to Nitzan and Bichler, 2014), (Sánchez & Montibeler, La teoría del valor trabajo y los precios en China, 2015) y (Cockshott, Cottrell, & Zachariah, Against the Kliman theory, 2019)], únicamente en el estudio de Zachariah en 2006 se realiza una investigación multi regional, mientras que en las demás únicamente se analiza la MIP de algún año en particular, no se han realizado previamente estudios econométricos a largo plazo y esa es otra novedad de esta metodología.
Como se verifica en (NABI, 2021), en el SCN de U.S. las tablas (tanto de producción como de usos) son construidas bajo un enfoque metodológico híbrido de dos pasos, en el cual en el primer paso se obtienen las tablas empíricas (que son las que interesan en esta investigación) y en el segundo su derivación matemática, en donde al proceso que genera las tablas obtenidas en el primer paso se le conoce como proceso de redefinición y reasignación. Así, como se verifica en la fuente citada, así como la MIP permite un estudio más en profundidad de un sistema de economía política capitalista, la redefinición y reasignación permiten un estudio más profundo de la MIP como resultado de lograr al interior de esta estructura estadística un mayor grado de homogeneidad entre sus componentes o, desde una concepción más general sobre los sistemas, un menor grado de heterogeneidad.
Econométricamente hablando, es válido concebir la interrelación entre dos variables como el grado de asociación entre las mismas (independientemente de la orientación de tal asociación) y en ese sentido, es válido entonces pensar que un coeficiente de correlación entre los productos y sus insumos [puesto que tales insumos son provistos por las demás industrias (y en función de ellas son colocados dentro de la MIP)], es un indicador estadístico válido para inferir la magnitud de la interrelación industrial existente (que es una noción cualitativa como tal -la de interrelación industrial-), considerando además que la forma que toma la MIP es lineal (no por ello su forma revela su esencia, pero ese es el instrumento estadístico diseñado que existe y es posible utilizar en investigación empírica, uno de concepción lineal) y que todas las investigaciones antes referidas apuntan hacia la misma dirección.
La metodología empírica aquí planteada busca construir series temporales con la ayuda del programa estadístico R que permitan medir la interrelación entre las industrias mediante la correlación entre los productos y los insumos (los empleados para producirlos) según industria.
El sistema de cuentas nacionales (de ahora en adelante, SCN) de los Estados Unidos (de ahora en adelante, U.S.) es presentado a través de los cuadros de producción y los cuadros de usos (por separado), bajo la etiqueta de “Supply Table” para el caso del cuadro que contiene la producción de mercancías desglosada según sector industrial y “Use Table” para el caso del cuadro que contiene los datos de los insumos consumidos por cada sector industrial j-ésimo en la producción de cada mercancía correspondiente a cada sector industrial i-ésima, en donde i denota las filas y j las columnas.
El objetivo de este documento es proveer una metodología empírica para que sea posible construir una serie temporal del período 1997-2019 de la producción total de cada una de las 71 industrias que conforman el sistema de economía política estadounidense (ese es el máximo nivel de desagregación para el que se disponen estadísticas macroeconómicas para ese período), así como también de los insumos que cada una de esas industrias consume y autoconsume para generar el nivel de producto reportado en la MIP. Así, antes de proceder a explicar la metodología empírica aquí planteada, es conveniente recordar al lector que los datos obtenidos de la base de datos original son matrices insumo-producto (descompuestas en un cuadro de producción y en cuadro de usos), que por definición son datos de sección cruzada. Este tipo de estructura de datos requiere, al no existir de forma armónica y continua las estadísticas intertemporales (a lo largo del tiempo) de la MIP, una construcción tal que les proporcione una continuidad armónica de manera que puedan ser transformadas exitosamente en datos de panel (que son secciones cruzadas estudiadas analizadas en términos de series temporales, en este caso diferentes MIP a lo largo del período 1997-2019) y esa es precisamente la necesidad que la metodología empírica aquí planteada resuelve de forma automatizada mediante el uso del programa estadístico R (creando para ello una función personalizada en R, ad hoc para esta necesidad de investigación particular).
A continuación, se presentan dos imágenes. Una imagen muestra en la proporción mínima suficiente la estructura del cuadro de producción, mientras que la otra hace lo propio con el cuadro de usos.
Fuente: (U.S. Bureau of Economic Analysis, 2021).
Fuente: (U.S. Bureau of Economic Analysis, 2021).
Así, partiendo de los cuadros de producción (tablas de producción) desde 1997 hasta 2019, así como también las los cuadros de usos (tablas de consumo intermedio o consumo productivo), se deben realizar los siguientes pasos.
Se extrae del cuadro de producción su última fila, la cual contiene el total de la producción de cada una de las industrias que conforman el sistema económico (para el caso de Estados Unidos en el período analizado, son 23 cuadros de producción, una por año, desde 1997 hasta 2019) desagregada a nivel de los sectores industriales que la producen. Así, cada uno de los veintitrés cuadros de producción que contienen los datos anuales sobre 71 industrias, tendrá un vector fila, por consiguiente, compuesto por 71 elementos.
Se toma el cuadro de usos y se transpone, es decir, se intercambia la localización del contenido de sus filas por el de sus columnas y viceversa. Lo anterior se hace con la finalidad de que el consumo intermedio o consumo productivo que originalmente está en las columnas del cuadro de usos se localice ahora en las filas del cuadro de producción transpuesto al cuadro de producción original. Esto resultará útil para facilitar la automatización de la construcción del cuadro que contendrá la serie temporal deseada.
Combinando el vector fila extraído del cuadro de producción y el cuadro de usos transpuesto, se generan 71 nuevas tablas. Cada una de estas tablas estará compuesta en su primera columna por el período temporal en cuestión (desde 1997 hasta 2019), en su segunda columna se localizarán cada uno de los sectores industriales que proveen insumos a otros y a sí mismos para la producción, en la tercera columna se indicará el número del sector industrial según su posición en los cuadros de producción-usos (puesto que son veintitrés años de estudio para las industrias en general y para cada una en particular, el número que indica la posición de cada sector industrial se repetirá en veintitrés ocasiones), en la cuarta columna se localizará la producción total de cada sector y, finalmente, en las n-4 (para este caso serán 71 columnas restantes) se localizarán cada uno de los sectores industriales que generan la producción social global. Así, se conformarán 71 tablas con la configuración antes descrita (una por sector industrial) y de esa tabla se obtienen las correlaciones producto-insumo, que es lo que se ejecutará en el siguiente paso.
La tabla construida en el paso 3, que contiene los datos de panel de los 71 sectores industriales que conforman la economía estadounidense para el período 1997-2019, puede ser separada en 71 partes, en donde cada parte contiene los datos de panel de cada uno de los 71 sectores industriales de forma individual. Así, sobre cada uno de estos 71 paneles de datos generados se realiza el cálculo de correlación (el vector columna de la producción total de cada industria correlacionado en el tiempo con cada uno de los n-ésimos vectores columna que representan el aporte a nivel de insumos intermedios que cada uno de los sectores industriales proveyeron al producto en cuestión), guardándolo en el programa estadístico R dentro de una estructura de datos vectorial-fila y, finalmente, “apilando” los vectores fila para conformar la matriz de correlaciones de Pearson.
Posteriormente se calcula un promedio ponderado de los coeficientes de correlación de Pearson de cada uno de los 71 sectores industriales (que expresa el coeficiente de correlación promedio ponderado de cada sector industrial), en donde el factor de ponderación es la participación relativa de cada insumo en el consumo intermedio total.
Finalmente, cada uno de estos coeficientes intrasectoriales promedio ponderado (pertenecientes a cada sector) se vuelven a promediar ponderadamente para obtener el coeficiente de correlación promedio ponderado de todos los sectores industriales, i.e., el coeficiente de correlación que resume la interrelación entre todos los sectores industriales del sistema de economía política estadounidense. Aquí, el factor de ponderación es la participación relativa de cada sector industrial en el sistema económico.
Es evidente que como en esta investigación lo que interesa es conocer la magnitud de la interrelación sectorial y no el sentido de esa interrelación (expresado en el signo del coeficiente de correlación obtenido), a la hora de estimar los promedios se realizan los cálculos con los valores absolutos de estos coeficientes. A continuación, se presentan imágenes que contienen ordinalmente y de forma mínima y suficiente los cuadros estadísticos resultantes de los procedimientos descritos en los pasos comprendidos del 3 al 6.
Fuente: Elaboración propia, bajo la metodología descrita en el paso 3.
Fuente: Elaboración propia, bajo la metodología descrita en el paso 4.
Fuente: Elaboración propia, con los datos de la imagen anterior y la metodología descrita en el paso 4.
Fuente: Elaboración propia, bajo la metodología descrita en el paso 5.
Fuente: Elaboración propia, con los datos de la imagen anterior y la metodología descrita en el paso 5.
Fuente: Elaboración propia, bajo la metodología descrita en el paso 6.
Fuente: Elaboración propia, con los datos de la imagen anterior y la metodología descrita en el paso 6.
Como puede observarse, el promedio de las correlaciones incrementó de aproximadamente 0.68 antes de la primera ronda de ponderaciones hasta aproximadamente 0.78 tras la segunda ronda de ponderaciones. Así, es necesario plantear que, aún cuando tal o cual lector pueda tener desavenencias con la doble ponderación realizada, ya con la primera ponderación el coeficiente de correlación de Pearson alcanzaba una magnitud de 0.735, recordando que 0.70 es el estándar usual para determinar si una correlación es alta o no, específicamente si la correlación es superior al 0.70 se considera fuerte; además, incluso en el escenario poco racional en el que alguien pudiese cuestionar la validez metodológica de la primera ronda de ponderaciones, el coeficiente de determinación de Pearson era de 0.683, lo que lo separa en apenas 0.027 (o 2.7%, que es lo mismo, i.e., es lo que le faltaría para ser, en este ejemplo, 0.71) de ser una correlación fuerte. Lo anterior se expresa en el cuadro presentado a continuación.
Fuente: (Mindrila & Balentyne, 2021, pág. 9).
En conclusión, lo planteado por (Kuroki, 1985) no debe considerarse una condición a verificar sino un supuesto fundamental de todo modelo teórico sobre los sistemas de economía política capitalista lo suficientemente evolucionados. Al lector interesado en replicar o aplicar esta metodología empírica, puede serle de interés el código o “script” en R mediante el que se diseñó la función personalizada empleada para realizar los pasos descritos por la metodología planteada, así como también la base de datos original y las transformaciones más importantes sobre la misma[2].
REFERENCIAS
Cockshott, P., & Cottrell, A. (2005). Robust correlations between prices and labor values. Cambridge Journal of Economics, 309-316.
Cockshott, P., Cottrell, A., & Valle Baeza, A. (2014). The Empirics of the Labour Theory of Value: Reply to Nitzan and Bichler. Investigación Económica, 115-134.
Kliman, A. (2002). The law of value and laws of statistics: sectoral values and prices in the US economy, 1977-97. Cambridge Journal of Economics, 299-311.
Kliman, A. (2005). Reply to Cockshott and Cottrell. Cambridge Journal of Economics, 317-323.
Kliman, A. (2014). What is spurious correlation? A reply to Díaz and Osuna. Journal of Post Keynesian Economics, 21(2), 345-356.
Kuroki, R. (1985). The Equalizartion of the Rate of Profit Reconsidered. In W. Semmler, Competition, Instability, and Nonlinear Cycles (pp. 35-50). New York: Springer-Velag.
Sánchez, C., & Ferràndez, M. N. (2010, Octubre-diciembre). Valores, precios de producción y precios de mercado a partir de los datos de la economía española. Investigación Económica, 87-118. Retrieved from https://www.jstor.org/stable/42779601?seq=1
Sánchez, C., & Montibeler, E. E. (2015). La teoría del valor trabajo y los precios en China. Economia e Sociedade, 329-354.
U.S. Bureau of Economic Analysis. (2021, Abril 1). The Domestic Supply of Commodities by Industries (Millions of dollars). Retrieved from Input-Output Accounts Data | Supplemental Estimate Tables. After Redefinition Tables. Make Tables/After Redefinitions – Production of commodities by industry after redefinition of secondary production ● 1997-2019: 71 Industries iTable: https://apps.bea.gov/iTable/iTable.cfm?reqid=58&step=102&isuri=1&table_list=5&aggregation=sum
U.S. Bureau of Economic Analysis. (2021, Abril 1). The Use of Commodities by Industries. Retrieved from Input-Output Accounts Data | Supplemental Estimate Tables. After Redefinition Tables. Use Tables/After Redefinitions/Producer Value – Use of commodities by industry after reallocation of inputs ● 1997-2019: 71 Industries iTable: https://apps.bea.gov/iTable/iTable.cfm?reqid=58&step=102&isuri=1&table_list=6&aggregation=sum
Zachariah, D. (2006, Junio). Labour value and equalisation of profit rates: a multi-country study. Indian Development Review, 4, 1-20.
[1] Aquí distinguimos “estadístico-matemático” de “estadístico” en el sentido de que el primer concepto transita por terrenos que versan sobre la aplicación de la Estadística Matemática a problemas concretos de la realidad (i.e., el abordaje científico de los datos), mientras que el segundo puede ser en el sentido antes definido, puede ser en su sentido puramente descriptivo o puede incluso ser lo que se entiende popularmente por ello.
Matemática · Programación en R · Sistemas dinámicos discretos
La conjetura de Collatz como función personalizada en R
Una introducción a funciones, iteración y recursión a partir de una regla matemática extraordinariamente sencilla cuyo comportamiento global continúa resistiéndose a una demostración general.
José Mauricio Gómez Julián · 2021
Un ejemplo particularmente agradable de función personalizada es una función construida para estudiar computacionalmente la célebre conjetura de Collatz. La elección resulta útil porque la regla matemática es muy sencilla, mientras que su comportamiento global no lo es: basta con distinguir entre números pares e impares y repetir siempre la misma transformación. Esa combinación permite concentrarse en la lógica de programación sin perder de vista el objeto matemático que se está programando.
La conjetura establece, en términos elementales, que si se parte de cualquier entero positivo y se divide entre dos cuando el número es par, o bien se multiplica por tres y se le suma uno cuando es impar, la sucesión obtenida llegará finalmente a la unidad. Es importante formularlo con cuidado: un programa puede comprobar que esto ocurre para un valor inicial concreto —o para una colección finita de valores—, pero esa comprobación computacional no constituye por sí misma una demostración de que ocurra para todos los enteros positivos. Precisamente ahí reside el problema matemático.
1. La regla de Collatz y qué significa comprobarla
Matemáticamente, la regla que genera las sucesivas imágenes puede expresarse mediante la siguiente función definida a trozos:
T(n) =
n/2
si n es par,
3n + 1
si n es impar.
Condición
Operación
Nueva imagen
n es par
Dividir entre 2
T(n) = n/2
n es impar
Multiplicar por 3 y sumar 1
T(n) = 3n + 1
Tabla 1. La regla local de Collatz. Cada paso está completamente determinado por la paridad del estado presente.
Si se parte de un origen o valor semilla n0, la aplicación sucesiva de la función construye una órbita:
n0, n1 = T(n0), n2 = T(n1), … , nk = Tk(n0).
Esta notación permite introducir desde el inicio una distinción que después será importante en R. Si la órbita alcanza la unidad por primera vez tras k aplicaciones de la regla, entonces se han realizado k iteraciones o transiciones, pero el listado completo de estados contiene k + 1 valores, porque también se cuenta el valor inicial.
Distinción útil
Puede llamarse tiempo total de parada al número de aplicaciones de T necesarias para alcanzar 1. Si se denota por τ(n), entonces la conjetura puede escribirse, de manera compacta, como: τ(n) < ∞ para todo entero positivo n.
Por consiguiente, lo que se programará a continuación no es una “prueba” de la conjetura en el sentido matemático de una demostración universal. Será, en cambio, un mecanismo capaz de generar y examinar órbitas particulares, registrar sus estados y contar cuántas transformaciones fueron necesarias para llegar a 1 cuando efectivamente se llegue a ese valor.
· · ·
2. Una primera función personalizada en R
Para construir la regla anterior en R conviene recordar que una función personalizada permite tomar una entrada, someterla a determinadas instrucciones y devolver una salida. En este primer paso todavía no habrá iteración: únicamente se evaluará un número y se producirá su siguiente imagen de Collatz.
La condición fundamental es la paridad. En R, el operador %% devuelve el residuo de una división. Si n %% 2 == 0, el número es divisible entre dos y, por consiguiente, es par. Si el residuo es distinto de cero, es impar.
R · regla de un pasoFuncionDeCollatz <- function(n) {
  if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
    stop("n debe ser un entero positivo.")
  }

  if (n %% 2 == 0) {
    j <- n / 2
  } else {
    j <- 3 * n + 1
  }

  return(j)
}
La función recibe un entero positivo n, determina si es par o impar y guarda el resultado en j. La instrucción return(j) no significa, estrictamente, “imprimir j en la pantalla”; significa que j será el valor devuelto por la función. Cuando la función se ejecuta directamente en la consola interactiva de R, ese valor devuelto suele mostrarse automáticamente, lo que explica por qué ambas ideas pueden confundirse al comenzar a programar.
Return y print no son lo mismo
return(x) termina la función y entrega x como su resultado. print(x), en cambio, pide explícitamente que x sea impreso. Una función puede devolver un valor sin contener ninguna instrucción print().
Obsérvese también que no hace falta impedir que esta función sea evaluada en 1: según la regla estándar, 1 es impar y su siguiente imagen sería 4. Lo que hará el algoritmo que construiremos después será detener la órbita al alcanzar 1, es decir, no volverá a aplicar la regla una vez alcanzado el objetivo.
3. Del paso individual al algoritmo iterativo
La función anterior realiza solamente una transformación. Para obtener una órbita completa es necesario repetirla mientras el valor presente sea diferente de 1. Aquí aparece el bucle del tipo “mientras” —while-loop—, cuya lógica es exactamente la que su nombre indica: ejecutar un determinado bloque de instrucciones durante el tiempo en que una condición siga siendo verdadera.
Esta segunda función es, por tanto, iterativa. No es todavía recursiva, porque no se llama a sí misma; lo que hace es repetir explícitamente un bloque de código mediante while().
R · algoritmo iterativoAlgoritmoIterativoDeCollatz <- function(m, max_iter = 1000000L) {
  if (length(m) != 1L || !is.finite(m) || m < 1 || m != floor(m)) {
    stop("m debe ser un entero positivo.")
  }

  trayectoria <- m
  iteraciones <- 0L

  while (m != 1) {
    if (iteraciones >= max_iter) {
      stop("Se alcanzó max_iter antes de llegar a 1.")
    }

    m <- FuncionDeCollatz(m)
    trayectoria <- c(trayectoria, m)
    iteraciones <- iteraciones + 1L
  }

  return(trayectoria)
}
La lógica es sencilla. El vector trayectoria nace dentro de la propia función y contiene inicialmente el valor semilla. Después, cada vez que se ejecuta el bucle, m se reemplaza por su siguiente imagen y ese nuevo valor se agrega al final del vector. Cuando m llega a 1, la condición m != 1 deja de cumplirse y el bucle termina.
Se utiliza aquí la letra m simplemente para distinguir visualmente el argumento de esta segunda función del n empleado en la primera. No existe una necesidad sintáctica de hacerlo: los argumentos y objetos creados dentro de cada función poseen su propio ámbito local, por lo que dos funciones distintas pueden utilizar sin conflicto un argumento llamado n.
Definir el vector dentro de la función tiene una ventaja importante: cada ejecución conserva su propio estado y no depende de objetos previamente existentes en el entorno global de R. En otras palabras, si se ejecuta la función una vez con 27 y después con 8, la segunda órbita no hereda los valores de la primera.
El argumento max_iter no forma parte de la Matemática de Collatz; es una precaución computacional. Como el enunciado general que se desea demostrar no puede simplemente asumirse al escribir el programa, resulta prudente impedir que un bucle pueda continuar sin límite en caso de que se use con datos inesperados o con una implementación modificada.
Objeto
Tipo
Papel
FuncionDeCollatz
function
Calcula una sola imagen de la regla de Collatz.
AlgoritmoIterativoDeCollatz
function
Repite la regla con while() y construye la trayectoria completa hasta 1.
trayectoria
numeric vector
Existe localmente durante una ejecución y almacena los estados visitados.
Tabla 2. Equivalente conceptual de lo que se observaría en el entorno de R tras definir las funciones. El vector de trayectoria no necesita permanecer en el entorno global.
· · ·
4. La órbita de 27: 112 estados y 111 iteraciones
Puede evaluarse ahora un número cualquiera en el algoritmo construido. Tomemos el ejemplo clásico de 27. La sucesión comienza 27, 82, 41, 124, 62, 31… y continúa con ascensos y descensos hasta alcanzar finalmente 1.
Éste es un buen lugar para precisar el vocabulario. La órbita almacenada contiene 112 estados, porque incluye tanto el punto de partida 27 como el punto de llegada 1. Sin embargo, entre 112 estados existen solamente 111 transiciones. Por consiguiente, el tiempo total de parada de 27, entendido como número de aplicaciones de la regla necesarias para alcanzar la unidad, es 111.
k=027
k=182
k=241
k=3124
k=462
k=531
k=694
k=747
k=8142
k=971
k=10214
k=11107
k=12322
k=13161
k=14484
k=15242
k=16121
k=17364
k=18182
k=1991
k=20274
k=21137
k=22412
k=23206
k=24103
k=25310
k=26155
k=27466
k=28233
k=29700
k=30350
k=31175
k=32526
k=33263
k=34790
k=35395
k=361186
k=37593
k=381780
k=39890
k=40445
k=411336
k=42668
k=43334
k=44167
k=45502
k=46251
k=47754
k=48377
k=491132
k=50566
k=51283
k=52850
k=53425
k=541276
k=55638
k=56319
k=57958
k=58479
k=591438
k=60719
k=612158
k=621079
k=633238
k=641619
k=654858
k=662429
k=677288
k=683644
k=691822
k=70911
k=712734
k=721367
k=734102
k=742051
k=756154
k=763077
k=779232
k=784616
k=792308
k=801154
k=81577
k=821732
k=83866
k=84433
k=851300
k=86650
k=87325
k=88976
k=89488
k=90244
k=91122
k=9261
k=93184
k=9492
k=9546
k=9623
k=9770
k=9835
k=99106
k=10053
k=101160
k=10280
k=10340
k=10420
k=10510
k=1065
k=10716
k=1088
k=1094
k=1102
k=1111
Tabla 3. Órbita completa de 27. La etiqueta k indica cuántas aplicaciones de la regla se han realizado. El máximo, 9232, aparece en k = 77; la unidad aparece en k = 111.
La trayectoria muestra además una propiedad que hace tan sugestivo el problema: una regla determinista extraordinariamente simple no genera necesariamente una evolución visualmente simple. Que el sistema esté perfectamente determinado paso a paso no significa que su comportamiento global sea evidente.
Si se desea conservar el gráfico tradicional en R, puede generarse, por ejemplo, con:
R · visualización opcionalplot(
  orbita_27,
  type = "l",
  xlab = "Iteración k",
  ylab = "n_k"
)
La tabla presenta la órbita completa, de modo que cada estado pueda leerse directamente y seguirse paso a paso.
5. Una segunda solución: recursión
Existe otra forma de diseñar el algoritmo. Puede resultar algo menos intuitiva al imaginarla por primera vez, pero tiene una notable elegancia: en lugar de construir un bucle while(), la propia función vuelve a llamarse a sí misma después de calcular el siguiente valor.
El problema exige ahora una función con dos características principales: su entrada es un entero positivo representable por el sistema numérico que estemos utilizando; su salida contiene, por un lado, la trayectoria seguida y, por otro, el número de transformaciones efectuadas para alcanzar la unidad.
R · versión recursivaCollatzRecursivo <- function(n, v = NULL) {
  if (length(n) != 1L || !is.finite(n) || n < 1 || n != floor(n)) {
    stop("n debe ser un entero positivo.")
  }

  v <- c(v, n)

  if (n == 1) {
    return(list(
      pasos = v,
      iteraciones = length(v) - 1L
    ))
  }

  if (n %% 2 == 0) {
    n <- n / 2
  } else {
    n <- 3 * n + 1
  }

  return(CollatzRecursivo(n, v))
}
Aquí sí se aplica recursión en el sentido preciso de la programación: dentro de la ejecución de CollatzRecursivo() aparece una nueva llamada a CollatzRecursivo(). Esa nueva llamada recibe un valor distinto de n y una copia ampliada del vector v.
La condición n == 1 es el caso base. Sin un caso base alcanzable, una definición recursiva continuaría produciendo llamadas adicionales hasta agotar los recursos disponibles. Cuando se llega a 1 ya no se crea una nueva llamada: se devuelve la lista que contiene la órbita y el número de iteraciones.
Tres funciones estándar utilizadas
c() concatena elementos o vectores. list() construye una lista cuyos componentes pueden tener nombres y tipos distintos. length() devuelve el número de elementos de un objeto como un vector o una lista; no debe confundirse con dim(), que informa las dimensiones de objetos que poseen un atributo dimensional.
La expresión iteraciones = length(v) – 1L merece atención. Si v contiene tanto el valor inicial como la unidad final, su longitud cuenta estados, no transformaciones. Restar uno corrige exactamente esa diferencia.
Semilla
Estados devueltos
Iteraciones
8
8 → 4 → 2 → 1
3
27
112 estados desde 27 hasta 1
111
Tabla 4. La diferencia entre contar estados y contar aplicaciones de la función. En la trayectoria 8 → 4 → 2 → 1 hay cuatro valores, pero solamente tres pasos.
Es necesario agregar una salvedad práctica. La recursión es una excelente herramienta para comprender la estructura lógica del problema, pero no siempre es la forma más robusta de recorrer órbitas largas en R: cada llamada recursiva añade un nuevo marco de ejecución y la profundidad disponible es finita. Para trabajo computacional intensivo, la versión iterativa suele ser preferible; para comprender qué significa que una función se invoque a sí misma, la versión recursiva es particularmente transparente.
· · ·
6. Cómo pensar matemáticamente la recursión
Antes de programar una solución recursiva conviene separar dos cosas que, aunque íntimamente relacionadas, no son idénticas: la dinámica matemática y la estructura de llamadas del programa. La función matemática fundamental sigue siendo T. Lo que cambia es la manera en que el programa organiza el cálculo de sus iteraciones.
El algoritmo puede pensarse de la siguiente manera:
Paso lógico
Acción
1
Ingresar un entero positivo N.
2
Registrar N como un nuevo estado de la trayectoria.
3
Si N = 1, devolver la trayectoria y terminar.
4a
Si N es par, asignar N ← N/2.
4b
Si N es impar, asignar N ← 3N + 1.
5
Ejecutar nuevamente la misma función utilizando el nuevo valor de N.
Tabla 5. Caso de uso de la solución recursiva. La recursión aparece en el último paso: la función vuelve a ejecutarse con una entrada nueva.
Matemáticamente, sin embargo, no hace falta definir una nueva función C(n) cuyo valor sea siempre 1 cuando la recursión termina. Esa escritura ocultaría el objeto que realmente interesa. Resulta más limpio conservar T como el mapa de Collatz y definir la órbita mediante iteraciones sucesivas:
nk+1 = T(nk), k = 0, 1, 2, …
El tiempo total de parada puede escribirse entonces como el primer índice en que la órbita toca la unidad:
τ(n) = min { k ≥ 0 : Tk(n) = 1 }, cuando tal k existe.
Esta formulación hace visible la verdadera dificultad. Conocemos exactamente la regla local que lleva de un estado al siguiente. Lo que no se sigue automáticamente de esa definición es que τ(n) sea finito para todos los enteros positivos.
Tomemos n = 8:
k = 0
k = 1
k = 2
k = 3
8
→
4
→
2
→
1
Tabla 6. Desde 8 hasta 1 existen cuatro estados y tres aplicaciones de T. Por tanto, τ(8) = 3.
La función recursiva reproduce computacionalmente esta misma cadena, pero cada flecha corresponde ahora no sólo a una transformación matemática, sino también a una nueva llamada de función. La sucesión matemática avanza de 8 a 4, de 4 a 2 y de 2 a 1; el programa, mientras tanto, va creando niveles de ejecución hasta encontrar el caso base.
7. La pila de llamadas: por qué es LIFO
Para comprender qué ocurre durante la recursión puede utilizarse un ejemplo deliberadamente sencillo. Supóngase que existe un “Listado X” con estas instrucciones:
Listado X
1. Ejecutar A1.
2. Ejecutar A2.
3. Ejecutar las instrucciones del Listado X.
4. Regresar e imprimir “Hola, Fernanda”.
Al llegar al paso 3 el programa inicia otra ejecución del mismo listado. Esa nueva ejecución llega a su propio paso 3 y crea otra, y así sucesivamente. Como no existe aquí un caso base, el paso 4 nunca llega a ejecutarse: antes se agotarán los recursos que el entorno permite dedicar a llamadas anidadas.
Nivel
A1
A2
Paso 3
Resultado
Listado X₀
ejecuta
ejecuta
llama X₁
queda pendiente
Listado X₁
ejecuta
ejecuta
llama X₂
queda pendiente
Listado X₂
ejecuta
ejecuta
llama X₃
queda pendiente
⋮
⋮
⋮
⋮
⋮
Tabla 7. Estructura de las llamadas recursivas. Cada llamada queda suspendida mientras espera que termine la llamada creada dentro de ella.
Cuando sí existe un caso base, como ocurre en nuestro algoritmo al alcanzar 1, la situación cambia. La llamada más profunda termina primero; después puede terminar la que la creó; después la anterior, y así sucesivamente. Por eso la estructura natural de las llamadas anidadas es una stack o pila, organizada como LIFO: Last In, First Out, es decir, “el último en entrar es el primero en salir”.
TOPE DE LA PILA · llamada con n = 1 · termina primero
llamada con n = 2 · espera el resultado de n = 1
llamada con n = 4 · espera el resultado de n = 2
BASE · llamada con n = 8 · fue creada primero
Tabla 8. La pila de llamadas para 8 → 4 → 2 → 1. La llamada con 1 es la última en entrar y la primera que puede finalizar; después se resuelven las llamadas pendientes en orden inverso.
La analogía con una pila de platos continúa siendo útil: si se apilan varios platos uno sobre otro, el último colocado queda en la parte superior y es el primero que puede retirarse sin desarmar la pila. Sin embargo, conviene precisar la razón técnica: las llamadas recursivas se organizan de esta forma por la estructura anidada del control del programa. La relación con la localidad de memoria o con posibles efectos sobre la caché puede ser relevante en otros contextos de rendimiento, pero no es la causa que explica por qué la pila de llamadas es LIFO.
Una llamada A que invoca a B no puede continuar más allá de ese punto hasta que B haya terminado; y si B invoca a C, B tampoco puede continuar hasta que C termine. De ahí surge naturalmente el orden C → B → A.
· · ·
8. Qué nos enseña Collatz sobre Matemática y Computación
Hay todavía una cuestión conceptual que merece atención. Podría parecer, a primera vista, que la formulación matemática nos ofrece un proceso “continuo” mientras que el programa lo convierte en una colección de pasos discretos. Esa oposición, sin embargo, no describe correctamente este problema. La dinámica de Collatz es discreta desde su propia definición matemática: el tiempo de la iteración está indexado por 0, 1, 2, 3, … y cada estado pertenece, en su formulación usual, al conjunto de los enteros positivos.
Por tanto, la diferencia interesante no está entre una Matemática continua y una Computación discreta. Está en otra parte: entre definir una regla, calcular sus consecuencias para casos particulares y demostrar una propiedad global de todas sus órbitas.
Nivel
Qué sabemos
Qué no se sigue automáticamente
Regla matemática
Para cada estado sabemos exactamente cuál es el siguiente.
No conocemos por esa sola razón el destino global de toda órbita posible.
Cálculo computacional
Podemos seguir paso a paso una órbita particular y comprobar si alcanza 1.
Un número finito de comprobaciones no equivale a una demostración universal.
Demostración matemática
Buscaría establecer una proposición válida para todos los enteros positivos.
No puede reemplazarse simplemente por enumerar más y más casos.
Tabla 9. Tres niveles de conocimiento que Collatz obliga a distinguir: especificación local, experimentación computacional y demostración global.
Esta distinción permite formular de manera más precisa la reflexión epistemológica que hace atractivo al ejemplo. La Matemática no consiste necesariamente en colocar un fenómeno dentro de una forma analítica cuyo comportamiento ya sea conocido. Collatz muestra exactamente lo contrario: podemos poseer una regla perfectamente definida y, aun así, carecer de una caracterización completa de su comportamiento global.
Tampoco la Computación queda reducida a atender “particularidades” que la Matemática habría abstraído. En este caso ambas trabajan sobre el mismo objeto discreto, pero hacen preguntas diferentes. El programa permite ejecutar la regla, inspeccionar órbitas, medir tiempos de parada, descubrir regularidades y someter conjeturas auxiliares a prueba numérica. La demostración matemática pregunta, en cambio, qué puede afirmarse necesariamente para una clase infinita de casos.
Conocer de manera exacta la ley que gobierna cada paso no equivale a conocer de antemano el comportamiento global del sistema.
Ésta es, probablemente, una de las enseñanzas más interesantes que puede extraerse del problema desde la perspectiva conjunta de la Matemática y las Ciencias de la Computación. En Collatz hay determinación local, computabilidad efectiva de cada paso y una enorme cantidad de evidencia para valores particulares; pero esas tres cosas no deben confundirse con una demostración universal.
9. Una precaución: los enteros de la Matemática no son los de la máquina
Finalmente, hay una diferencia adicional entre el objeto matemático y su implementación concreta que conviene hacer explícita. La expresión “cualquier N ∈ ℕ” describe un dominio matemático ilimitado. Una computadora, en cambio, representa números mediante estructuras finitas.
En R base existen, entre otras cosas, valores de tipo integer, cuyo rango es limitado, y valores numeric que normalmente utilizan aritmética de doble precisión. Estos últimos pueden representar exactamente todos los enteros sólo hasta cierto tamaño; por encima de 253, no todos los enteros consecutivos poseen una representación exacta como números de doble precisión.
La cuestión es particularmente relevante en Collatz porque una órbita puede crecer mucho por encima de su valor inicial antes de comenzar a descender. Por consiguiente, una implementación destinada a investigar números muy grandes debe utilizar aritmética entera exacta de mayor capacidad —por ejemplo, enteros de precisión arbitraria— y comprobar cuidadosamente posibles desbordamientos o pérdidas de exactitud.
Matemática frente a implementación
Objeto matemático:T actúa sobre todos los enteros positivos. Programa concreto: sólo puede actuar correctamente sobre los valores que su representación numérica y sus recursos de memoria permiten manipular de manera exacta.
Esto no invalida el uso pedagógico del código anterior. Para semillas pequeñas, como 8 o 27, la implementación es perfectamente adecuada. Lo que evita es atribuirle a una representación computacional finita el mismo dominio ilimitado que posee el objeto matemático abstracto.
· · ·
Consideraciones finales
La conjetura de Collatz constituye un ejemplo extraordinariamente fértil para aprender a programar porque permite pasar, casi sin introducir artificios, desde una regla matemática elemental hasta varias ideas centrales de las Ciencias de la Computación. Primero se construye una función que decide entre dos operaciones; después se convierte esa operación en una iteración; luego se almacena la órbita; finalmente se reconstruye el mismo proceso mediante recursión y se observa cómo las llamadas anidadas quedan organizadas en una pila.
Pero el ejemplo es igualmente fértil por una razón más profunda. Una sucesión puede estar gobernada por una regla completamente determinista y, aun así, plantear enormes dificultades cuando se intenta establecer una propiedad global para todas sus trayectorias. El programa sabe qué hacer en cada paso. La dificultad matemática consiste en justificar qué ocurrirá después de todos los pasos necesarios, para cualquier punto de partida posible.
En este sentido, la programación no reemplaza la demostración ni la demostración vuelve innecesaria a la programación. La primera permite experimentar con el objeto, recorrerlo y producir evidencia concreta; la segunda busca establecer relaciones que no dependan de haber enumerado previamente cada caso. Collatz es un terreno particularmente limpio para observar esa diferencia porque no hay oscuridad alguna en la regla elemental: la dificultad emerge de la dinámica producida al repetirla.
Y justamente por ello una función personalizada en R resulta algo más que un ejercicio de sintaxis. Permite observar, en una escala pequeña y manejable, el tránsito entre definición, algoritmo, ejecución, representación numérica y razonamiento matemático; es decir, entre distintos niveles de una misma actividad científica que conviene mantener relacionados sin confundirlos.
Cuando se estudia cálculo por primera vez, la integral suele aparecer como un procedimiento para acumular cantidades sobre un intervalo. Más adelante, la misma idea se amplía: ya no se integra solamente a lo largo de un eje, sino también sobre curvas, regiones del plano, volúmenes y superficies. Las integrales de línea, las integrales múltiples y las integrales de superficie son precisamente algunas de las formas que adopta esa generalización.
En términos generales, las integrales de línea permiten acumular una cantidad a lo largo de una curva. Las integrales múltiples permiten hacerlo sobre regiones de dos o más dimensiones. Las integrales de superficie, por su parte, permiten integrar sobre una superficie que se encuentra en el espacio. A nivel de cálculo universitario, esta distinción es suficiente para comprender por qué cada una requiere técnicas distintas sin perder de vista que todas pertenecen a una misma idea matemática: sumar infinitesimalmente una magnitud sobre un dominio determinado.
Los principales teoremas asociados a estas integrales también están relacionados. Para las integrales de línea aparece el Teorema Fundamental para Integrales de Línea; al estudiar integrales múltiples aparecen el Teorema de Fubini, los teoremas de Pappus-Guldinus y el Teorema de Green; y en el estudio de campos vectoriales sobre superficies aparecen el Teorema de Stokes y el Teorema de Gauss o Teorema de la Divergencia.
La diferencia fundamental no está en la idea de integrar, sino en el objeto geométrico sobre el cual se realiza la acumulación.
Green, Stokes y Gauss no son literalmente el mismo teorema en el curso elemental, pero expresan una estructura común: relacionan una integral realizada en el interior de una región con otra integral realizada sobre su frontera. En un tratamiento más general, esta unidad se formaliza mediante el teorema generalizado de Stokes; sin embargo, para un curso de grado basta comprenderlos como distintas manifestaciones de un mismo principio.
Integrales de línea
Una integral de línea es una integral cuyo dominio de integración es una curva. En vez de recorrer los puntos de un intervalo en el eje real, se recorren los puntos de una trayectoria que puede estar situada en el plano o en el espacio. Para efectuar el cálculo, lo habitual es parametrizar la curva.
Parametrizar significa describir las coordenadas de cada punto de la curva mediante una variable auxiliar, normalmente \(t\). En el caso de una recta, la parametrización puede adoptar una forma sencilla como \(x=c+kt\). Para una curva general, sin embargo, lo correcto es pensar en expresiones del tipo \(x=x(t)\), \(y=y(t)\) y, cuando sea necesario, \(z=z(t)\). Por ello, el procedimiento no exige que exista un único vector director constante: eso es propio del caso particular de una recta.
FIGURA 1 · Una integral de línea escalar acumula los valores de una función a lo largo de una curva. Fuente original indicada en el artículo: Greg School.
Existen dos casos especialmente importantes. En una integral de línea de una función escalar, se acumula una magnitud a lo largo de la curva. Si un alambre tiene densidad variable, por ejemplo, una integral de línea puede emplearse para obtener su masa total. En una integral de línea de un campo vectorial, en cambio, suele interesar el efecto del campo a lo largo del desplazamiento: el ejemplo clásico es el trabajo realizado por una fuerza a lo largo de una trayectoria.
Integral escalar:   ∫C f ds

Integral vectorial: ∫C F · dr
FIGURA 2 · Distintos tipos de integrales de línea: integración respecto de longitud de arco e integración de campos vectoriales a lo largo de una trayectoria. Fuente original indicada en el artículo: YouTube.
Cuando la curva es cerrada, suele utilizarse el símbolo \(\oint\). El círculo colocado sobre el signo de integral indica precisamente que el recorrido vuelve al punto de partida. Este detalle es particularmente importante cuando se estudia circulación, porque la integral se realiza a lo largo de toda la frontera cerrada.
El Teorema Fundamental para Integrales de Línea
El Teorema Fundamental para Integrales de Línea cumple un papel análogo al Teorema Fundamental del Cálculo en una variable. Si un campo vectorial es conservativo y puede escribirse como el gradiente de una función potencial, la integral entre dos puntos depende únicamente del punto inicial y del punto final, no del camino particular seguido para ir de uno a otro.
Si F = ∇φ, entonces

∫C F · dr = φ(B) − φ(A)
Ésta es una de las primeras señales de una idea que aparecerá repetidamente: ciertas integrales complicadas pueden transformarse en expresiones más sencillas cuando la estructura geométrica del problema permite aplicar un teorema apropiado.
Integrales múltiples
Las integrales múltiples generalizan el proceso de integración a dominios con más de una variable. Una integral doble se realiza sobre una región bidimensional y una integral triple sobre una región tridimensional. Su interpretación geométrica depende de lo que se esté integrando.
Por ejemplo, si se integra la función constante \(1\) sobre una región del plano, la integral doble proporciona el área de esa región. Si se integra una función \(f(x,y)\) no negativa sobre una región \(R\), la integral puede interpretarse como el volumen situado debajo de la superficie \(z=f(x,y)\) y encima de \(R\). Del mismo modo, una integral triple de \(1\) sobre una región del espacio proporciona su volumen. Por ello, no debe identificarse mecánicamente “integral doble” con “volumen” ni “integral triple” con “hipervolumen”: el significado depende del integrando y del dominio.
FIGURA 3 · Interpretación de una integral doble como acumulación de secciones infinitesimales sobre una región. Fuente original indicada en el artículo: AlgebraHD.
El Teorema de Fubini
El Teorema de Fubini es fundamental porque, bajo las condiciones habituales que se estudian en cálculo, permite calcular una integral múltiple mediante integrales iteradas. En términos prácticos, esto significa integrar primero respecto de una variable y después respecto de otra. En integrales triples existen hasta seis órdenes posibles de integración, y escoger un orden adecuado puede simplificar considerablemente el cálculo.
∬R f(x,y) dA
puede calcularse, según la región, como

∫ [ ∫ f(x,y) dy ] dx

o bien

∫ [ ∫ f(x,y) dx ] dy
El principio de Fubini no se limita conceptualmente a integrales triples. Es un resultado general sobre integración en espacios producto. Sin embargo, en un curso universitario de cálculo suele aplicarse sobre todo a integrales dobles y triples, que son las que pueden representarse geométricamente con mayor facilidad.
FIGURA 4 · Una integral triple puede plantearse con distintos órdenes de integración. La geometría de la región determina cuál resulta más conveniente. Fuente original indicada en el artículo: SlidePlayer.
Los teoremas de Pappus-Guldinus
Los dos teoremas de Pappus-Guldinus relacionan los centroides con objetos obtenidos mediante revolución. En términos intuitivos, ambos dicen que una figura que gira alrededor de un eje genera una magnitud geométrica que puede calcularse multiplicando la magnitud original por la distancia recorrida por su centroide.
El primer teorema relaciona la longitud de una curva plana con el área de la superficie de revolución que ésta genera. El segundo teorema relaciona el área de una región plana con el volumen del sólido de revolución generado al hacerla girar alrededor de un eje que no la atraviesa. Ésta es la formulación pertinente de los dos teoremas clásicos en cálculo.
El Teorema de Green
El Teorema de Green establece una relación entre una integral doble sobre una región plana y una integral de línea sobre la curva cerrada que constituye su frontera. Si \(C\) es la frontera orientada positivamente de una región \(R\), entonces, bajo las hipótesis habituales:
∮C P dx + Q dy
=
∬R (∂Q/∂x − ∂P/∂y) dA
La importancia conceptual del teorema es mayor que la fórmula misma. Green permite sustituir una acumulación realizada alrededor de una frontera por otra realizada en todo el interior, o viceversa. Por eso constituye un puente natural entre las integrales de línea y las integrales dobles.
Integrales de superficie
Una integral de superficie es una integral realizada sobre una superficie situada en el espacio. Aquí conviene distinguir dos casos, de manera análoga a lo que ocurría con las integrales de línea.
En una integral escalar de superficie, una función escalar se acumula sobre la superficie. Si una lámina curva posee una densidad superficial variable, por ejemplo, una integral de este tipo puede proporcionar su masa. En cambio, cuando se integra un campo vectorial mediante el producto punto con el vector normal, se calcula el flujo del campo a través de la superficie.
Integral escalar de superficie:
∬S f dS

Flujo de un campo vectorial:
∬S F · n dS
FIGURA 5 · Integral de superficie de una función escalar. La superficie puede describirse mediante una parametrización y el elemento de área debe ajustarse a su geometría. Fuente original indicada en el artículo: SlidePlayer.
Si una superficie puede escribirse como \(z=g(x,y)\), puede parametrizarse mediante \((x,y,g(x,y))\). El elemento diferencial de superficie no es simplemente \(dx\,dy\), porque debe tener en cuenta la inclinación local de la superficie. Para el caso de una gráfica \(z=g(x,y)\), aparece el factor:
dS = √(1 + (∂g/∂x)² + (∂g/∂y)²) dA
Este factor corrige el área proyectada sobre el plano \(xy\) para obtener el área real sobre la superficie inclinada. Si la superficie se describe de otra manera —por ejemplo, mediante \(x=g(y,z)\)— se utiliza la parametrización correspondiente.
El Teorema de Gauss o de la Divergencia
Cuando \(S\) es una superficie cerrada que encierra un volumen \(V\), el Teorema de Gauss permite relacionar el flujo total de un campo vectorial a través de la superficie con la divergencia del campo en todo el volumen interior. Si \(\mathbf F=(P,Q,R)\), su divergencia es:
div F = ∂P/∂x + ∂Q/∂y + ∂R/∂z
y el teorema establece:
∯S F · n dS
=
∭V div(F) dV
El símbolo \(\oiint\) —o, tipográficamente, una doble integral con círculo— indica que la superficie es cerrada. Conceptualmente, Gauss dice que el flujo neto que sale por la frontera de un volumen está determinado por la suma de las “fuentes” y “sumideros” del campo existentes en su interior.
Green, Stokes y Gauss: una misma idea
En este punto se puede volver a la observación inicial y formularla con mayor precisión. Los teoremas de Green, Stokes y Gauss no deben tratarse como resultados aislados. Los tres conectan lo que ocurre en una región con lo que ocurre en su frontera, aunque cada uno lo hace en una situación geométrica diferente.
Green trabaja en el plano: relaciona una integral doble sobre una región con una integral de línea sobre su contorno. Stokes trabaja con una superficie orientada en el espacio: relaciona la circulación de un campo alrededor de la curva que constituye su borde con una integral del rotacional sobre la superficie. Gauss trabaja con un volumen: relaciona el flujo a través de la superficie cerrada que lo envuelve con la divergencia dentro del volumen.
Esquema conceptual
Green: región plana ↔ curva frontera.
Stokes: superficie ↔ curva frontera.
Gauss: volumen ↔ superficie frontera.
Esta semejanza no es accidental. En cursos más avanzados, el teorema generalizado de Stokes permite reunir estos resultados en una sola estructura matemática. Pero incluso sin recurrir a formas diferenciales, la intuición importante ya puede verse a nivel de grado: una integral sobre el interior puede transformarse, bajo determinadas condiciones, en una integral sobre la frontera, y viceversa.
En ese sentido, la progresión desde integrales de línea hacia integrales múltiples y de superficie no es una colección arbitraria de técnicas. Es una ampliación progresiva de la misma idea de acumulación y, al mismo tiempo, una introducción a una de las relaciones más profundas del cálculo vectorial: la relación entre una región y su borde.
Resumen comparativo
Tipo de integral
Dominio
Interpretaciones típicas
Teoremas relacionados
Integral de línea
Curva
Masa de un alambre, trabajo, circulación
Teorema Fundamental para Integrales de Línea; Green
Integral doble
Región del plano
Área, volumen bajo una superficie, masa de una lámina
Fubini; Green
Integral triple
Región del espacio
Volumen, masa, acumulación volumétrica
Fubini; Gauss
Integral de superficie
Superficie en el espacio
Área ponderada, masa superficial, flujo
Stokes; Gauss
La diferencia entre estas integrales puede resumirse, por tanto, de una forma sencilla. La integral de línea acumula sobre una trayectoria; la integral múltiple acumula sobre una región; y la integral de superficie acumula sobre una superficie. Lo que cambia es la geometría del dominio y, con ella, el diferencial que debe emplearse. La idea fundamental de integración, sin embargo, permanece.
Integrar es acumular. Lo que cambia de una integral a otra es dónde se acumula y qué magnitud se está acumulando.
Filosofía de las matemáticas · Topología · Dialéctica
¿Qué permanece cuando todo cambia de forma?
Una lectura de Hacia una interpretación dialéctica-materialista de la topología, de José Mauricio Gómez Julián
Lectura guiada · Historia de las matemáticas · Filosofía de la ciencia
· · ·
Imagine una taza de café hecha de goma. Podemos estirarla, comprimirla,
retorcerla y deformarla hasta transformarla, poco a poco, en algo que se
parezca a una rosquilla. Para la geometría cotidiana, la taza y la
rosquilla son objetos muy distintos: tienen curvaturas, longitudes y
proporciones diferentes. Para la topología, sin embargo, hay una pregunta
más profunda: ¿cambió realmente su estructura esencial o simplemente
modificamos su apariencia métrica?
Esa pregunta —qué puede variar sin que un objeto deje de pertenecer a la
misma clase estructural— constituye el centro conceptual de la topología.
Pero el ensayo de Gómez Julián quiere ir un paso más allá. En lugar de
limitarse a presentar sus definiciones matemáticas, reconstruye la
historia de la disciplina para preguntarse qué significado filosófico
tiene estudiar precisamente aquello que permanece en medio de
determinadas transformaciones.
El recorrido pasa por Leibniz, Euler, Cantor, Dedekind, Poincaré, Peano,
Brouwer y Hausdorff; por los puentes de Königsberg, las paradojas de la
dimensión, la teoría de conjuntos, la continuidad y los homeomorfismos.
Al final, todos esos hilos son reunidos en una propuesta: leer la
estructura topológica desde una filosofía dialéctico-materialista, como
una manera matemática especialmente apropiada para pensar la relación
entre transformación, invariancia, estructura y cambio cualitativo.
01 · El problema fundamental
De medir objetos a estudiar relaciones
Durante siglos, pensar geométricamente significó ante todo pensar en
magnitudes: longitudes, áreas, ángulos, distancias y proporciones. La
topología introduce un cambio de perspectiva. Lo importante deja de ser
exclusivamente cuánto mide algo y pasa a ser también
cómo están relacionadas sus partes.
El ensayo encuentra un antecedente decisivo en Gottfried Wilhelm
Leibniz. En el siglo XVII, Leibniz imaginó una
geometria situs, una «geometría de la posición»: una disciplina
en la que la disposición relativa de los elementos tendría prioridad
sobre su magnitud. La intuición era extraordinariamente moderna. Dos
configuraciones podían diferir en sus dimensiones métricas y, sin
embargo, compartir algo más profundo en su organización.
La topología pregunta menos por cuánto mide un objeto que por qué
relaciones sobreviven cuando su forma cambia.
Ésta es también la primera clave para lectores provenientes de la
economía o de las ciencias sociales. Una red económica puede cambiar
enormemente en el volumen de sus transacciones sin que necesariamente
cambie su patrón básico de conexiones; una institución puede crecer o
reducirse manteniendo determinadas relaciones internas; una estructura
política puede experimentar modificaciones cuantitativas sin que todavía
haya ocurrido una transformación cualitativa de su organización.
Esto no convierte automáticamente tales problemas en problemas de
topología matemática. Sí ayuda, en cambio, a comprender la intuición que
interesa al artículo: distinguir entre modificaciones de magnitud o
apariencia y modificaciones de estructura.
02 · Königsberg, 1736
Euler y el nacimiento de una nueva mirada
Uno de los episodios fundacionales de esta historia ocurre en la ciudad
prusiana de Königsberg. La ciudad estaba dividida por el río Pregel y
conectada mediante siete puentes. El problema era sencillo de formular:
¿era posible realizar un paseo continuo cruzando cada puente exactamente
una vez?
Leonhard Euler comprendió que las distancias, los tamaños de las islas y
la longitud de los puentes eran irrelevantes. Podía reemplazar cada masa
de tierra por un punto y cada puente por una conexión entre puntos. El
problema físico se transformaba así en una estructura abstracta.
La idea matemática
Lo que hoy llamaríamos un grafo conserva únicamente
la información relevante para el problema: qué vértices están
conectados por qué aristas. El problema de Königsberg es un problema
de recorrido euleriano: se pregunta si es posible
recorrer cada arista exactamente una vez.
Euler mostró que no era posible hacerlo. Todos los vértices relevantes
tenían grado impar y un recorrido que atraviese cada arista una sola vez
sólo puede tener cero o dos vértices de grado impar.
Pero para el argumento histórico del ensayo lo decisivo no es sólo la
solución. Es el método de abstracción: Euler eliminó deliberadamente
información acerca de la magnitud para conservar una estructura de
relaciones. Una ciudad real, con agua, puentes y distancias, se
convirtió en un objeto matemático cuya organización podía analizarse
independientemente de su escala.
03 · Una crisis productiva
Cantor y el extraño problema de la dimensión
El siguiente gran salto aparece en el siglo XIX con Georg Cantor y la
teoría de conjuntos. Cantor descubrió que los puntos de un segmento y
los puntos de un cuadrado pueden ponerse en correspondencia uno a uno:
ambos conjuntos tienen la misma cardinalidad.
Éste fue un resultado profundamente contraintuitivo. Un segmento parece
unidimensional y un cuadrado bidimensional. ¿Cómo podían contener, en un
sentido preciso, «la misma cantidad» de puntos?
Una distinción esencial
Tener la misma cardinalidad no significa tener la
misma dimensión topológica. Precisamente ahí estaba el problema:
contar puntos no basta para capturar aquello que intuitivamente
distingue una línea de una superficie.
En términos filosóficos, la contradicción entre intuición geométrica y
resultado conjuntista obligó a reformular la pregunta. Si la dimensión
no podía reducirse simplemente al número de coordenadas ni a la
cardinalidad de los puntos, había que descubrir una propiedad más
estructural.
El ensayo enfatiza justamente este tipo de episodios: las
contradicciones no aparecen simplemente como accidentes desagradables
de la ciencia, sino como motores del desarrollo conceptual. Un concepto
que parecía evidente —«dimensión»— se vuelve problemático, y al volverse
problemático obliga a producir una teoría más profunda.
1676 · Leibniz
Imagina una geometría basada en posición antes que magnitud.
1736 · Euler
Reduce el problema de Königsberg a una estructura de vértices y
conexiones.
1877 · Cantor
La correspondencia entre conjuntos de distinta apariencia
dimensional desestabiliza la antigua intuición geométrica.
Finales del siglo XIX
Dedekind, Peano y otros obligan a distinguir cardinalidad,
continuidad y dimensión.
Comienzos del siglo XX
Poincaré, Brouwer y Hausdorff consolidan los problemas que darán
forma a la topología moderna.
04 · Cuando una definición también pregunta por el mundo
Poincaré: continuidad, cortes y significado
Henri Poincaré ocupa un lugar especial en el relato porque sus preguntas
sobre dimensión no nacían únicamente de dificultades técnicas. Le
interesaba también comprender por qué experimentamos el espacio como
tridimensional, cuál es la relación entre las geometrías matemáticas y
el espacio físico, y de dónde surgen nuestras intuiciones geométricas.
Su idea fue pensar la dimensión mediante cortes. En
términos intuitivos, la dimensión de un continuo podía estudiarse
preguntando qué tipo de objeto era necesario retirar para dividirlo.
Una línea puede desconectarse retirando un punto; separar una superficie
exige, en general, algo de mayor dimensión.
El ensayo concede a esta idea una importancia filosófica particular. Una
dimensión deja de aparecer simplemente como una coordenada dibujada
sobre un eje y comienza a relacionarse con la manera en que las partes
de un espacio están conectadas.
Una estructura no se define solamente por sus componentes, sino por el
sistema de relaciones que hace de esos componentes un todo.
Poincaré no proporcionó con ello la última palabra matemática sobre la
dimensión. Su propuesta encontró dificultades y sería sustituida por
formulaciones más robustas. Pero para la lectura histórica del artículo,
ése es precisamente el punto: una formulación puede ser matemáticamente
superada y conservar, sin embargo, una intuición filosófica fértil.
05 · La consolidación de la disciplina
Brouwer, Hausdorff y la topología moderna
L. E. J. Brouwer llevó el problema de la dimensión a un nuevo nivel de
rigor. Entre sus aportes fundamentales se encuentra la invariancia de la
dimensión: espacios euclidianos de distinta dimensión no pueden ser
equivalentes mediante un homeomorfismo. Una línea y un plano no se
vuelven estructuralmente idénticos por más ingeniosa que sea nuestra
correspondencia entre sus puntos.
El resultado es importante porque permite separar dos ideas que Cantor
había obligado a confrontar: dos conjuntos pueden tener la misma
cardinalidad y, aun así, poseer estructuras topológicas diferentes.
Felix Hausdorff, por su parte, contribuyó a convertir la topología y la
teoría de conjuntos en disciplinas progresivamente más abstractas y
sistemáticas. A principios del siglo XX, el «espacio» matemático ya no
tenía por qué ser una habitación imaginaria llena de puntos físicos. Sus
elementos podían ser funciones, secuencias u otros objetos abstractos.
Esta generalización es decisiva. La topología deja de ser solamente una
geometría extraña de superficies deformables. Se convierte en un
lenguaje para hablar de continuidad, vecindades, convergencia,
conectividad y estructura en clases enormemente amplias de objetos
matemáticos.
06 · El corazón matemático
¿Qué es realmente una topología?
Podemos ahora expresar la idea con precisión. Sea un conjunto
X. Una topología sobre X es una colección
τ de subconjuntos de X —llamados conjuntos abiertos—
que satisface ciertas reglas.
∅, X ∈ τ
las uniones arbitrarias de elementos de τ pertenecen a τ
las intersecciones finitas de elementos de τ pertenecen a τ
El par (X, τ) se denomina
espacio topológico. Lo importante es que τ determina
qué significa estar «cerca», qué significa continuidad y cómo se
organiza el espacio sin necesidad de introducir una distancia
numérica.
Una métrica puede decirnos que dos puntos están separados por 3,7
unidades. Una topología puede estudiar relaciones de proximidad y
continuidad sin que exista siquiera una función distancia.
Concepto
Intuición
Métrica
Permite cuantificar distancias entre puntos.
Topología
Describe una estructura de vecindades, continuidad y relaciones
espaciales más generales.
Homeomorfismo
Correspondencia continua, biyectiva y con inversa continua entre
dos espacios topológicos.
Invariante topológico
Propiedad que permanece igual bajo homeomorfismos.
La famosa «geometría de la goma»
De ahí surge la metáfora clásica. Podemos estirar, comprimir o retorcer
un objeto siempre que no lo cortemos ni peguemos partes que antes
estaban separadas. Una circunferencia puede deformarse hasta obtener una
elipse sin abandonar su clase topológica.
Una esfera puede deformarse hasta convertirse en un elipsoide. En
cambio, crear un agujero en la esfera para transformarla en un toro
exige una modificación topológicamente radical: ya no estamos
simplemente cambiando distancias y curvaturas, sino la estructura del
objeto.
El punto central
En topología, «conservar la estructura» no quiere decir conservar la
apariencia visual ni las distancias. Significa preservar aquellas
relaciones codificadas por la estructura topológica. Matemáticamente,
la equivalencia pertinente es el homeomorfismo.
07 · Del formalismo al significado
La lectura dialéctico-materialista
Hasta aquí tenemos topología. El movimiento específicamente filosófico
del ensayo comienza al preguntar qué nos dice este tipo de matemática
acerca de la relación entre estructura, transformación y
permanencia.
La propuesta del autor parte de distinguir entre cambios que afectan
ciertas propiedades de un sistema sin destruir su estructura fundamental
y cambios que sí alteran esa estructura. La distinción recuerda
inmediatamente una categoría central de la dialéctica: no toda
modificación cuantitativa constituye todavía un cambio cualitativo.
Un objeto topológico puede ser estirado, torcido o deformado dentro de
ciertos límites y mantener sus invariantes. Pero al rasgarlo, crear una
nueva conexión o eliminar una conexión esencial, aparece otra clase de
estructura.
El ensayo interpreta esta diferencia mediante la relación dialéctica
entre forma y esencia. La forma puede
variar considerablemente mientras ciertas relaciones internas
permanecen estables; cuando las transformaciones alcanzan la propia
organización constitutiva del sistema, el cambio deja de ser meramente
formal y pasa a ser cualitativo.
La invariancia no significa inmovilidad: algo puede transformarse
profundamente en su apariencia y conservar, durante esas
transformaciones, una estructura determinada.
Éste es probablemente el puente conceptual más interesante que propone
el texto. «Permanecer» y «cambiar» dejan de ser absolutos mutuamente
excluyentes. Un sistema puede cambiar precisamente porque posee una
estructura dentro de la cual ciertos cambios son posibles. Y esa misma
estructura determina también qué transformaciones dejarían de ser
modificaciones internas para convertirse en una ruptura.
Homeomorfismo y estructura
El homeomorfismo adquiere así una relevancia filosófica especial para el
autor. Técnicamente, dos espacios son homeomorfos cuando existe entre
ellos una función biyectiva y continua cuya inversa también es continua.
Filosóficamente, el artículo lo interpreta como una formalización de la
idea de que configuraciones externamente diferentes pueden compartir una
misma organización estructural.
No porque una taza y un toro «sean la misma cosa» en todos los sentidos,
sino porque un determinado nivel de abstracción permite tratarlos como
equivalentes respecto de las propiedades que ese nivel estudia.
Esto enlaza con otra tesis epistemológica importante del ensayo: toda
ciencia abstrae. La física, la química, la biología, la economía y las
matemáticas aíslan determinadas relaciones para poder investigarlas.
Abstraer no significa necesariamente negar el resto de la realidad; es
seleccionar provisionalmente qué relaciones serán consideradas
esenciales para un determinado problema.
08 · Una incursión fuera de las matemáticas
Del espacio abstracto al ADN
Para mostrar que el lenguaje topológico no se limita a ejercicios
geométricos, el ensayo recurre a un ejemplo particularmente sugerente:
la estructura del ADN.
Las moléculas de ADN pueden formar estructuras enrolladas, anudadas y
entrelazadas. Durante procesos biológicos reales, las enzimas conocidas
como topoisomerasas pueden cortar temporalmente una
hebra, permitir cambios en el entrelazamiento de la molécula y volver a
unirla. La teoría de nudos y otros instrumentos topológicos son útiles
precisamente para describir aspectos de estas configuraciones.
Aquí la vieja metáfora de «cortar y pegar» deja de ser solamente una
imagen pedagógica. La conectividad de una estructura molecular puede
sufrir modificaciones físicamente reales.
Por qué importa el ejemplo
El artículo utiliza el ADN como una ilustración epistemológica:
modificar una cantidad —longitud, torsión, distancia— no es lo mismo
que modificar las relaciones constitutivas de una estructura. Cuando
se rompe y recompone una conexión, el tipo de transformación es
cualitativamente diferente.
Desde la perspectiva dialéctica desarrollada por el autor, este caso
sirve para ilustrar una idea más general: los sistemas poseen
propiedades relativamente estables, pero esa estabilidad existe dentro
de procesos de transformación. Y algunas transformaciones pueden
acumularse o alcanzar un punto en el que emerge una organización
cualitativamente diferente.
09 · La tesis en perspectiva
Qué propone —y qué no propone— el ensayo
Conviene distinguir cuidadosamente dos niveles. El primero es
estrictamente matemático: espacios topológicos, continuidad,
homeomorfismos, invariantes y dimensión poseen definiciones formales y
resultados que no dependen de aceptar una filosofía marxista.
El segundo nivel es interpretativo. El artículo sostiene que la historia
y la estructura conceptual de la topología pueden comprenderse de forma
particularmente fértil mediante categorías dialéctico-materialistas:
estructura, relación, transformación, invariancia, esencia, forma y
cambio cualitativo.
En otras palabras, el argumento no consiste en derivar un teorema de
topología a partir de Marx. Tampoco en afirmar que un homeomorfismo y una
contradicción dialéctica sean literalmente el mismo concepto. El
proyecto consiste en buscar una correspondencia
estructural: mostrar que determinadas relaciones descubiertas
formalmente por las matemáticas pueden adquirir un significado
epistemológico cuando se las coloca dentro de una concepción más general
del cambio y de la estructura.
Vista así, la reconstrucción histórica no es decorativa. Cantor desafía
una intuición recibida sobre la dimensión; Peano muestra que la
continuidad puede producir fenómenos que esa intuición no anticipaba;
Poincaré intenta redefinir el problema; Brouwer introduce nuevas
demostraciones y nuevas abstracciones; Hausdorff contribuye a
sistematizar el lenguaje. El concepto moderno emerge de conflictos,
reformulaciones y superaciones sucesivas.
Ese movimiento histórico es precisamente lo que hace atractiva la
lectura dialéctica del artículo: una teoría científica no aparece ya
terminada desde el principio. Sus categorías se desarrollan mediante
contradicciones concretas que obligan a revisar conceptos anteriores,
conservar algunos de sus elementos y abandonar otros.
La pregunta que queda
Quizá la intuición más poderosa que puede llevarse un lector no
especializado sea ésta: conocer algo no consiste únicamente en medir
sus propiedades visibles. También podemos preguntar qué relaciones
hacen que ese algo sea la estructura que es, qué modificaciones puede
soportar sin dejar de conservarla y qué clase de transformación
tendría que ocurrir para que emerja una estructura diferente.
La topología proporciona un lenguaje matemático extraordinariamente
preciso para una versión de esa pregunta. El ensayo de Gómez Julián propone
que la dialéctica materialista proporciona, a su vez, una forma de
interrogar su significado filosófico.
· · ·
El recorrido que comienza con puentes, puntos y líneas termina así en
una cuestión mucho más amplia. ¿Qué significa decir que una cosa sigue
siendo «la misma» mientras cambia? ¿Qué clase de transformaciones son
accidentales respecto de una estructura y cuáles modifican aquello que
la constituye? ¿Cómo distinguir continuidad de ruptura?
Éstas son preguntas matemáticas cuando hablamos de espacios
topológicos. Pero también son preguntas que reaparecen, bajo formas
diferentes, cuando estudiamos sistemas físicos, biológicos, económicos
o sociales. La apuesta filosófica del artículo consiste precisamente en
sostener que esa recurrencia no debería ser tratada como una mera
coincidencia verbal: merece ser investigada como una correspondencia
entre formas de estructura, transformación e invariancia.
Para seguir el desarrollo histórico completo, las definiciones
matemáticas y la argumentación filosófica en su formulación original:
Investigadores de Argonne proponen una forma de eludir localmente la Segunda Ley de la Termodinámica
Durante más de siglo y medio de historia de la física, la Segunda Ley de la Termodinámica, que establece que la entropía siempre aumenta, ha sido tan cercana a lo inviolable como cualquier ley que conozcamos. En este universo, el caos reina. Pero investigadores del Laboratorio Nacional Argonne del Departamento de Energía de Estados Unidos (DOE) anunciaron recientemente que podrían haber descubierto una pequeña laguna en esta famosa máxima. Su investigación, publicada en Nature Scientific Reports, plantea una posible vía hacia una situación en la que la Segunda Ley se viole a escala microscópica.
La Segunda Ley se sustenta en lo que se conoce como el teorema H, según el cual, si se abre una puerta entre dos habitaciones, una caliente y otra fría, ambas acabarán alcanzando un equilibrio templado; la habitación caliente nunca terminará aún más caliente.
Pero incluso en el siglo XX, a medida que avanzaba nuestro conocimiento de la mecánica cuántica, todavía no comprendíamos por completo los orígenes físicos fundamentales del teorema H.
“Lo que hicimos fue formular cómo estas hermosas teorías matemáticas abstractas podían conectarse con nuestra realidad concreta.”
Los avances recientes en un campo denominado teoría cuántica de la información ofrecieron una construcción matemática en la que la entropía aumenta.
«Lo que hicimos fue formular cómo estas hermosas teorías matemáticas abstractas podían conectarse con nuestra realidad concreta», dijo Valerii Vinokur, investigador distinguido de Argonne y autor de correspondencia del estudio.
Los científicos tomaron la teoría cuántica de la información, basada en sistemas matemáticos abstractos, y la aplicaron a la física de la materia condensada, un campo ampliamente estudiado que cuenta con numerosas leyes y experimentos bien conocidos.
«Esto nos permitió formular el teorema H cuántico en relación con cosas que podían observarse físicamente», dijo Ivan Sadovskyy, investigador con nombramiento conjunto en la División de Ciencia de Materiales de Argonne y en el Computation Institute, y otro de los autores del artículo. «Establece una conexión entre procesos bien documentados de la física cuántica y los canales cuánticos teóricos que conforman la teoría cuántica de la información».
El trabajo predice determinadas condiciones bajo las cuales el teorema H podría ser violado y la entropía —a corto plazo— podría, de hecho, disminuir.
Ya en 1867, el físico James Clerk Maxwell describió una forma hipotética de violar la Segunda Ley: si un pequeño ser teórico se sentara junto a la puerta entre las habitaciones caliente y fría y dejara pasar únicamente las partículas que viajaran a determinada velocidad. Este ser hipotético recibe el nombre de «demonio de Maxwell».
«Aunque la violación ocurre únicamente a escala local, las implicaciones son de gran alcance», dijo Vinokur. «Esto nos proporciona una plataforma para la realización práctica de un demonio de Maxwell cuántico, que podría hacer posible una máquina cuántica de movimiento perpetuo a escala local».
Por ejemplo, señaló, el principio podría incorporarse al diseño de un «refrigerador» que pudiera enfriarse de manera remota; es decir, la energía empleada para enfriarlo podría consumirse en cualquier otro lugar.
Los autores señalaron que tienen previsto trabajar estrechamente con un equipo de investigadores experimentales para diseñar un sistema de prueba de concepto.
El estudio, «H-theorem in quantum physics», fue publicado el 12 de septiembre en Nature Scientific Reports. Los otros autores del estudio fueron G. B. Lesovik, del Instituto L. D. Landau de Física Teórica de Rusia y de Theoretische Physik, Suiza; A. V. Lebedev, de Theoretische Physik; y M. V. Suslov, del Instituto de Física y Tecnología de Moscú.
El estudio contó con el apoyo de la Oficina de Ciencia del Departamento de Energía de Estados Unidos, la Fundación Nacional Suiza, el Pauli Center for Theoretical Studies de la ETH Zurich y la Fundación Rusa para la Investigación Básica.
Argonne National Laboratorybusca soluciones a problemas nacionales urgentes en ciencia y tecnología. Como primer laboratorio nacional del país, Argonne lleva a cabo investigación científica básica y aplicada de vanguardia en prácticamente todas las disciplinas científicas. Los investigadores de Argonne trabajan estrechamente con investigadores de cientos de empresas, universidades y organismos federales, estatales y municipales para ayudarlos a resolver sus problemas específicos, impulsar el liderazgo científico de Estados Unidos y preparar al país para un futuro mejor. Con empleados procedentes de más de 60 países, Argonne es administrado porUChicago Argonne, LLCpara laOficina de Ciencia del Departamento de Energía de Estados Unidos.
La Oficina de Ciencia del Departamento de Energía de Estados Unidoses la principal fuente individual de apoyo a la investigación básica en ciencias físicas en Estados Unidos y trabaja para abordar algunos de los desafíos más urgentes de nuestro tiempo. Para obtener más información, visite elsitio web de la Oficina de Ciencia.
2. Información Adicional, Parte II
La segunda ley de la termodinámica afirma que la entropía no puede decrecer. En física clásica es consecuencia del teorema H de Boltzmann que se aplica a las soluciones de su ecuación cinética de transporte. No hay ningún análogo cuántico a esta ecuación que permita demostrar un teorema H cuántico. Físicos del Argonne National Laboratory han publicado en Scientific Reports una versión cuántica del teorema H para sistemas cuya evolución viene dada por un canal cuántico unital (los canales se usan en la teoría cuántica de la información).
Hay canales cuánticos que no son unitales. Por ello estos físicos, y muchos medios que se hacen eco de esta noticia, sugieren que se pueden observar violaciones locales de la segunda ley de la termodinámica (que estarían mediadas por demonios de Maxwell cuánticos). Sin embargo, el artículo no presenta ningún ejemplo concreto; más aún, los dos ejemplos de canales no unitales que se presentan cumplen con la segunda ley. Futuros estudios tendrán que dilucidar si estas violaciones locales son posibles en sistemas físicos reales, así como encontrar algún ejemplo real de demonio de Maxwell cuántico.
El artículo es G. B. Lesovik, A. V. Lebedev, …, V. M. Vinokur, «H-theorem in quantum physics,» Scientific Reports 6: 32815 (12 Sep 2016), doi: 10.1038/srep32815, arXiv:1407.4437 [quant-ph]. Me he enterado gracias a Menéame, que se hace eco del artículo de Louise Lerner, «Argonne researchers posit way to locally circumvent Second Law of Thermodynamics,» Argonne National Laboratory, News, 19 Oct 2016. Hay que tener mucho cuidado con estas notas de prensa de instituciones, porque a veces están escritas por comunicadores científicos que no se han leído el artículo científico.
El teorema H de Ludwig Boltzmann (1872, 1896) es el fundamento estadístico de la segunda ley de la termodinámica. Este teorema afirma que si es la distribución espaciotemporal de la densidad de las moléculas de un gas ideal en el instante , en la posición y con velocidad , entonces la entropía dada por no puede disminuir, es decir, . Para demostrarlo se usa la ecuación de Boltzmann para la función bajo la hipótesis de que las partículas que colisionan en el gas tienen velocidades independientes de su posición (la llamada hipótesis del caos molecular). Pero la mecánica cuántica relaciona las posiciones y velocidades gracias a las relaciones de indeterminación de Heisenberg.
John von Neumann propuso en 1929 una explicación cuántica del origen del crecimiento de la entropía. La entropía se define a partir de la matriz densidad de la mecánica cuántica como . Se demuestra que esta función no decrece, incluso sin recurrir a una ecuación cinética de transporte, usando el procedimiento de medida en la mecánica cuántica. Desde entonces muchos físicos han tratado de obtener una versión cuántica del teorema H de Boltzmann (un buen resumen en el libro de Jochen Gemmer, Mathias Michel, Günter Mahler, «Quantum Thermodynamics. Emergence of Thermodynamic Behavior Within Composite Quantum Systems,» Lecture Notes in Physics, Springer, 2009).
El nuevo artículo se inspira en la teoría cuántica de la información (QIT) y propone describir la dinámica cuántica de un sistema mediante un canal cuántico (QC); en teoría de la información un canal (de datos) es el modelo teórico de un medio de transmisión por el que viajan las señales portadoras de información entre un emisor y un receptor. Todo sistema cuántico se puede interpretar como un canal (cuántico) por que el fluye información. Usando canales cuánticos permite obtener una formulación cuántica del teorema H: La entropía no decrece si la evolución del sistema se describe mediante un canal cuántico unital. La demostración obtenida en el nuevo artículo sólo se aplica a canales unitales y no afirma nada sobre los canales no unitales.
Un canal cuántico es una función positiva de la matriz densidad que preserva la traza, sea ; se dice unital si . En general, un canal cuántico no es unital; véase, por ejemplo, G. G. Amosov, «Estimating the output entropy of a tensor product of two quantum channels,» Theoretical and Mathematical Physics 182: 397–406 (2015), doi: 10.1007/s11232-015-0270-6. El nuevo teorema H cuántico nos habla de canales unitales, pero no concluye nada sobre los que no son unitales. Los autores de este trabajo sugieren que en un sistema cuántico cuya evolución esté descrita por un canal cuántico que no sea unital podría ocurrir que la entropía decrezca localmente y no se cumpla la segunda ley de la termodinámica.
Además de la demostración matemática del teorema H cuántico, el artículo ofrece tres ejemplos concretos de sistemas cuánticas modelados por canales cuánticos. Las tres figuras de esta entrada corresponden a cada uno de ellos. Uno es unital y los otros dos no lo son. Sin embargo, en ambos sistemas no unitales se cumple la segunda ley. Como has leído, el artículo no presenta ningún ejemplo de canal no unital en el que se viole (localmente) dicha ley. Los autores sugieren que es posible. Pero no hay demostración de su afirmación. Este detalle parece haber sido omitido por algunos medios que se han hecho eco de esta noticia.
En resumen, un artículo muy interesante, pero cuya interpretación debe ser realizada con sumo cuidado. Afirmar a la ligera que pueden existir violaciones locales de la segunda ley de la termodinámica en sistemas cuánticos no es lo mismo que presentar un ejemplo concreto. La física cuántica es sutil y la teoría cuántica de la información mucho más. Cuidado con las afirmaciones a la ligera.







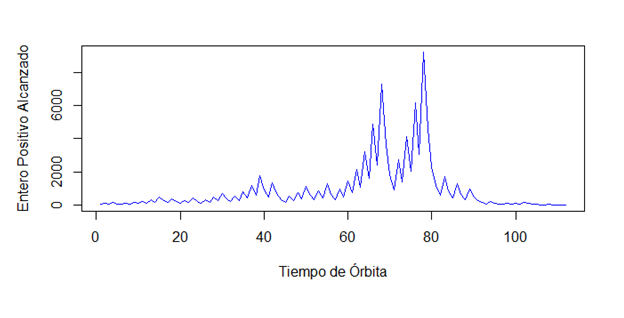


 bajo la hipótesis de que las partículas que colisionan en el gas tienen velocidades independientes de su posición (la llamada hipótesis del caos molecular). Pero la mecánica cuántica relaciona las posiciones y velocidades gracias a las relaciones de indeterminación de Heisenberg.
